وضعت DeepSeek أوزان DeepSeek-V4.1-Flash على Hugging Face بموجب ترخيص MIT في 10 سبتمبر 2026، وهو نفس اليوم الذي أطلق فيه النموذج عامةً على واجهة برمجة التطبيقات (API). هذا توقيت غير معتاد. فمعظم المختبرات تشحن نقطة النهاية المستضافة أولاً وتطلق الأوزان بعد أسابيع، إن حدث ذلك على الإطلاق.
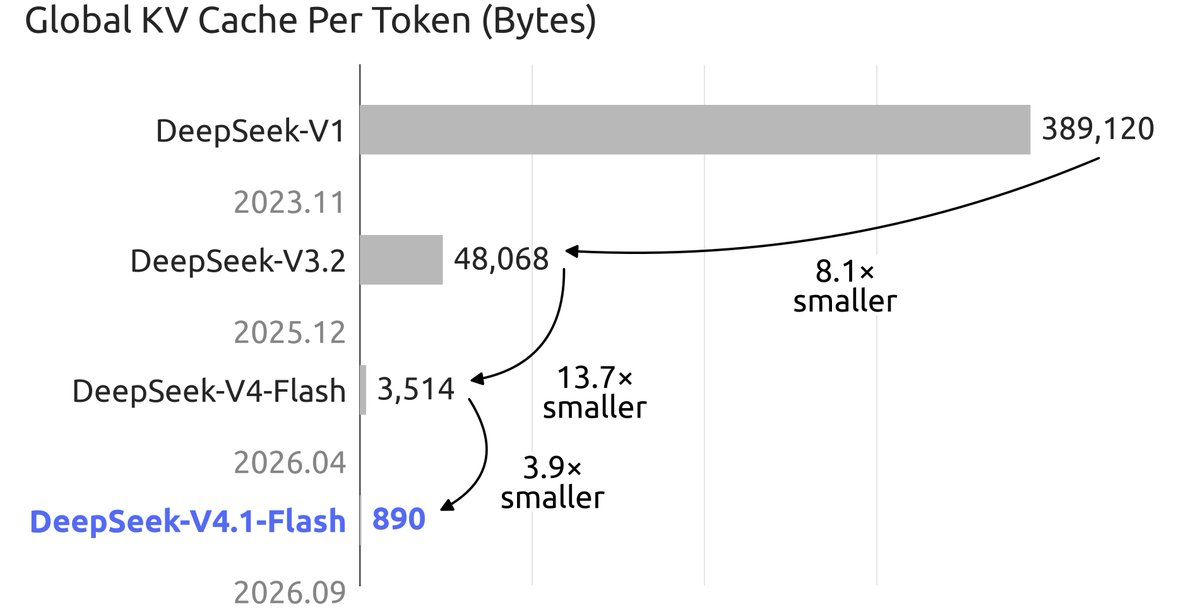
الرقم الرئيسي سيخيف معظم القراء: 552 مليار معلمة في العمود الفقري، و763 مليار مع مشفر الرؤية. لكن التصميم الأساسي أكثر ملاءمة للاستضافة الذاتية مما يوحي به الحجم. فقط 8 مليارات معلمة تكون نشطة أثناء التعبئة المسبقة و16 مليار أثناء فك التشفير، وتكلفة ذاكرة التخزين المؤقت FP4 KV الجديدة هي 890 بايت لكل رمز، أي حوالي ربع ما احتاجه V4-Flash. الحوسبة رخيصة. الذاكرة هي العقبة.
سيحاول الناس على أي حال. يقدم لك هذا الدليل حسابات الذاكرة، والمسارات الواقعية لكل مستوى من مستويات الأجهزة، وأوامر الإعداد العامة، وطريقة لاختبار نقطة نهاية محلية متوافقة مع OpenAI مقابل واجهة برمجة التطبيقات المستضافة في Apidog. إذا كنت تريد نظرة عامة على النموذج أولاً، فاقرأ ما هو DeepSeek-V4.1-Flash؟ ثم عد.
TL;DR (ملخص سريع)
- الأوزان: 552 مليار معلمة للعمود الفقري بنظام MoE، ترخيص MIT. حوالي 552 جيجابايت بتقنية 8 بت، وحوالي 280 جيجابايت بتقنية 4 بت، للعمود الفقري فقط.
- ذاكرة التخزين المؤقت KV: 890 بايت لكل رمز. يحتاج سياق كامل بحجم 1 مليون رمز إلى حوالي 0.9 جيجابايت. تم حل هذا الجزء.
- يتطلب التشغيل الفعلي بتقنية 4 بت من 4 إلى 8 وحدات معالجة رسومات (GPUs) من فئة 80 جيجابايت. أي شيء أقل من ذلك يعتمد على تفريغ الحمولة إلى وحدة المعالجة المركزية (CPU) أو محرك الأقراص الصلبة (SSD)، وسيكون بطيئًا.
- تفرض واجهة برمجة التطبيقات المستضافة 0.15 دولار لكل مليون رمز إدخال مفقود من ذاكرة التخزين المؤقت (cache-miss) خارج أوقات الذروة. بالنسبة لمعظم الفرق، هذا أقل تكلفة من فاتورة الكهرباء وحدها.
ما الذي تقوم بتنزيله
تصف بطاقة النموذج عمودًا فقريًا بنظام Mixture-of-Experts (MoE) مكونًا من 552 مليار معلمة مع تخطيط جديد لمشفر/فك تشفير سببي (Causal Encoder-Decoder): 40 طبقة، مقسمة إلى 20 مشفرًا و20 فك تشفير. كل طبقة توجه عبر 384 خبيرًا بالإضافة إلى خبير مشترك واحد. يدفع مشفر الرؤية DeepSeek-ViT نقطة الفحص الكاملة إلى 763 مليار معلمة، وتقوم بتنزيل كل شيء حتى لو كنت تحتاج النص فقط.
ثلاثة تفاصيل مهمة للاستدلال المحلي:
- المعلمات النشطة صغيرة. 8 مليارات نشطة أثناء التعبئة المسبقة، و16 مليار أثناء فك التشفير. تبدو عمليات FLOPs لكل رمز وكأنها نموذج كثيف متوسط الحجم. المشكلة هي أن كل معلمة من أصل 552 مليار معلمة يجب أن تكون موجودة في مكان يمكن أن تصل إليه عملية التمرير الأمامي.
- ذاكرة التخزين المؤقت KV هي FP4. تشير ملاحظة الإصدار إلى أن ذاكرة التخزين المؤقت تستخدم ربع ذاكرة HBM وثمن مساحة تخزين SSD للجيل السابق. عند 890 بايت لكل رمز، لم يعد السياق الطويل يمثل مشكلة الذاكرة التي كانت عليه من قبل.
- الانتباه متفرق بطبيعته. تم تدريب الانتباه المتفرق المضغوط 2 (Compressed Sparse Attention 2) بثلاثة أوضاع ثابتة على سياق 64 ألف، وتم تمديده إلى مليون في وقت متأخر من تشغيل 45 تريليون رمز. وهذا هو السبب في بقاء أرقام KV صغيرة عند 1 مليون.
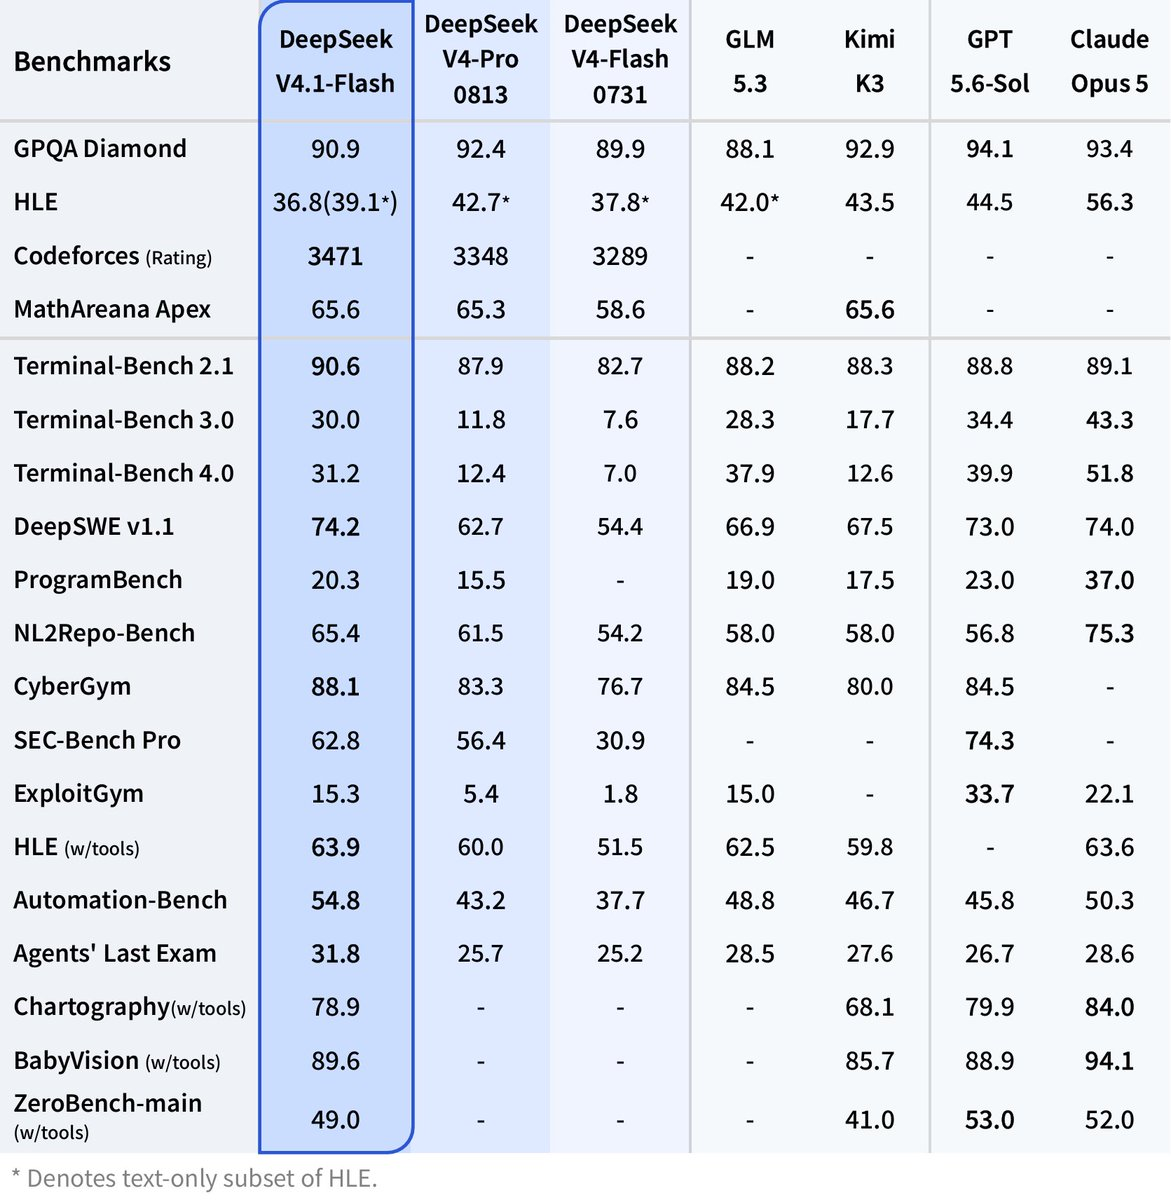
يغطي التقرير الفني الهندسة المعمارية بالكامل. كل رقم معيار على البطاقة هو تقرير DeepSeek؛ تعامل معها على أنها ادعاءات.
حسابات الذاكرة
الأرقام أدناه هي عمليات ضرب مباشرة، وليست قياسات، وهي تستثني النفقات العامة للمحرك، والتنشيطات، ومشفر الرؤية.
| المكون | الحجم | طريقة الحساب |
|---|---|---|
| أوزان العمود الفقري، 8 بت | ~552 جيجابايت | 552 مليار معلمة × 1 بايت |
| أوزان العمود الفقري، 4 بت | ~280 جيجابايت | 552 مليار معلمة × 0.5 بايت |
| ذاكرة التخزين المؤقت KV، لكل رمز | 890 بايت | من بطاقة النموذج |
| ذاكرة التخزين المؤقت KV عند سياق 128 ألف | ~0.11 جيجابايت | 890 × 128,000 |
| ذاكرة التخزين المؤقت KV عند سياق 1 مليون | ~0.89 جيجابايت | 890 × 1,000,000 |
يبرز أمران. أولاً، ذاكرة التخزين المؤقت KV لا تكاد تذكر. تتسع جلسة سياق 1 مليون رمز في أقل من جيجابايت، لذا يمكنك الاحتفاظ بعشرات الجلسات الطويلة المقيمة دون المساس بميزانية الأوزان. ثانيًا، الأوزان هي المشكلة بأكملها. لا توجد حيلة تكميم تجعل 552 مليار معلمة تتسع على وحدة معالجة رسومات استهلاكية واحدة، وتصميم الـ 8 مليارات معلمة نشطة لا يساعد، لأن توجيه MoE لا يزال يتطلب تحميل كل خبير وإمكانية الوصول إليه.
ولهذا السبب أيضًا تبدو الإعدادات ذات التفريغ غير متوازنة. تقوم التعبئة المسبقة بمعالجة دفعات عبر المطالبة بأكملها وتبقى مقيدة بالحساب. بينما يقوم فك التشفير بتحميل 16 مليار معلمة نشطة من ذاكرة الوصول العشوائي (RAM) أو محرك الأقراص الثابتة (SSD) لكل رمز. عرض النطاق الترددي، وليس عمليات FLOPs، هو ما يحدد عدد الرموز في الثانية لديك.
مستويات الأجهزة الواقعية
لا توجد أرقام إنتاجية هنا. لم يحصل أحد خارج DeepSeek على الأوزان لفترة كافية لنشر معايير موثوقة.
المستوى الأول: خادم متعدد وحدات معالجة الرسوميات (GPU)، من 4 إلى 8 بطاقات من فئة 80 جيجابايت. توفر لك أربع بطاقات بحجم 80 جيجابايت 320 جيجابايت، وهو ما يكفي للأوزان ذات 4 بت مع هامش بسيط لذاكرة التخزين المؤقت KV والنفقات العامة للمحرك. توفر لك ثماني بطاقات 640 جيجابايت، وهو ما يكفي لنقطة الفحص ذات 8 بت أو لتطبيق مريح بحجم 4 بت مع دفعات كبيرة. هذا هو المستوى الوحيد الذي يعني فيه "تشغيلها محليًا" خدمة جاهزة للإنتاج مع توازي الموترات، وهو يتطلب شراء بخمسة أو ستة أرقام أو استئجار سحابة متعددة الدولارات في الساعة.
المستوى الثاني: محطة عمل واحدة بذاكرة عالية مع تفريغ الحمولة إلى وحدة المعالجة المركزية (CPU). يمكن لجهاز يحتوي على 512 جيجابايت أو أكثر من ذاكرة الوصول العشوائي (RAM) ونوحدة أو وحدتي معالجة رسوميات (GPUs) الاحتفاظ بأوزان 4 بت في ذاكرة الوصول العشوائي (RAM) وبث طبقات الخبراء إلى وحدة معالجة الرسوميات عند الطلب. إنه يعمل، ولكنه بطيء، لأن عرض نطاق فك التشفير هو ناقل DDR5 بدلاً من HBM. استخدمه للمهام الدفعية والتقييمات الليلية، وليس للمحادثات التفاعلية.
المستوى الثالث: Apple Silicon مع تدفق من محرك أقراص الحالة الثابتة (SSD). مسار الهواة. يحمل جهاز Mac Studio بسعة 512 جيجابايت أوزان 4 بت في الذاكرة الموحدة، وهو خيار حقيقي إذا كنت تملك واحدًا بالفعل. أقل من ذلك، فأنت في منطقة موضوع Kimi K3 HN: الأوزان مقسمة عبر محركات أقراص الحالة الثابتة الخارجية، وmmap يقوم بالعمل الشاق، حوالي رمز واحد في الثانية. يثبت هذا أن النموذج يعمل، وليس أنه مفيد على تلك الآلة. يغطي دليلنا لتشغيل Kimi K3 محليًا نفس المقايضات على نموذج أكبر، ويغطي كيفية تشغيل DeepSeek V4 محليًا الجيل السابق.
مسار الإعداد
مع توفر الأجهزة، يكون المسار كالتالي: تنزيل، خدمة خلف نقطة نهاية متوافقة مع OpenAI، اختبار.
pip3 install -U "huggingface_hub[cli]"
huggingface-cli download deepseek-ai/DeepSeek-V4.1-Flash \
  --local-dir ./models/deepseek-v4.1-flash \
  --max-workers 8
على خط بسرعة 1 جيجابت في الثانية، يستغرق كل 100 جيجابايت حوالي 15 دقيقة بأقصى سرعة. خصص ساعة أو أكثر.
الخدمة هي حيث تكمن الملاحظة الهامة. الدعم في اليوم الأول في vLLM و SGLang و llama.cpp و Ollama لهندسة CED وانتباه CSA2 هو [تحقق]؛ عادةً ما يتطلب نوع الطبقة الجديد تصحيحًا للمحرك قبل تحميل الأوزان، ولا تذكر ملاحظة الإصدار محركات معينة. ابحث في سجل تغييرات كل مشروع عن "DeepSeek-V4.1" قبل الالتزام بالتنزيل. بمجرد توفر الدعم، تبدو الخدمة باستخدام vLLM عبر 8 وحدات معالجة رسوميات كما يلي:
vllm serve ./models/deepseek-v4.1-flash \
  --tensor-parallel-size 8 \
  --max-model-len 131072 \
  --served-model-name deepseek-flash \
  --port 8000
يعرض `llama-server` الخاص بـ llama.cpp أو نموذج Ollama نفس نقطة النهاية بنمط `http://localhost:8000/v1` بمجرد وجود تحويل GGUF، لذا يعمل أي عميل OpenAI SDK بتغيير سطر واحد:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="local")

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Summarize this incident report and list the three root causes."}],
    temperature=1.0,
    top_p=0.95,
)
print(response.choices[0].message.content)
تطابق قيم `temperature=1.0` و `top_p=0.95` الإعدادات الموصى بها في بطاقة النموذج. بالنسبة لـ Ollama، يغطي دليل Ollama الخاص بنا تدفق Modelfile، ويغطي دليل vLLM أعلام وحدات معالجة الرسوميات المتعددة بتعمق.
البديل العملي: واجهة برمجة التطبيقات المستضافة
خارج أوقات الذروة، تسرد صفحة الأسعار `deepseek-flash` بسعر 0.15 دولار لكل مليون رمز إدخال مفقود من ذاكرة التخزين المؤقت، و 0.003 دولار لكل مليون رمز إدخال موجود في ذاكرة التخزين المؤقت، و 0.60 دولار لكل مليون رمز إخراج. تتضاعف هذه الأسعار في ساعات الذروة. لذا، فإن مليار رمز إدخال بالإضافة إلى 200 مليون رمز إخراج شهريًا يكلف حوالي 270 دولارًا خارج أوقات الذروة و 540 دولارًا في أوقات الذروة، قبل أن تقلل مرات الوصول إلى ذاكرة التخزين المؤقت الجانب المدخلات بشكل أكبر. يكلف خادم بثماني وحدات معالجة رسوميات من فئة 80 جيجابايت أكثر من ذلك شهريًا في الكهرباء والتبريد وحده تحت الحمل المستمر، قبل أن تستهلك تكلفة الأجهزة أو تدفع لشخص ما للعناية بها. ما لم يكن لديك قاعدة إقامة بيانات أو أجهزة غير مستخدمة بالفعل، فإن واجهة برمجة التطبيقات تفوز من حيث التكلفة. التبديل هو تغيير `base_url` واحد؛ يوضح دليل DeepSeek-V4.1-Flash API الخاص بنا ذلك.
يفوز الحل المحلي عندما لا يكون القيد هو المال: البيئات المعزولة، بيانات المطالبات التي لا يمكنك إرسالها إلى أي مكان، أو الأبحاث التي تحتاج إلى تعديل الأوزان.
اختبر نقطة نهاية محلية مقابل واجهة برمجة التطبيقات المستضافة في Apidog
أيًا كان المسار الذي تختاره، اثبت أن الخادم المحلي يتصرف كالمرجع قبل توجيه حركة المرور إليه. انحراف التكميم، أو قالب الدردشة الخاطئ، أو رمز التوقف المفقود، كل ذلك يظهر كاختلافات دقيقة في الإخراج. إليك سير العمل في Apidog:
- أنشئ بيئتين. واحدة باسم
localمع تعيينbase_urlإلىhttp://localhost:8000/v1، وواحدة باسمhostedمع تعيينbase_urlإلىhttps://api.deepseek.comومفتاحك الحقيقي. يستخدم كل طلب{{base_url}}/chat/completionsوBearer {{api_key}}. - احفظ مجموعة صغيرة من المطالبات كطلبات. من خمس إلى عشر مطالبات تمثل عبء عملك: استخراج JSON، إصلاح رمز، ملخص سياق طويل. اضبط
modelعلىdeepseek-flashفي جميعها؛ فهو يعمل على كلا الخادمين. - أضف تأكيدات. لمهمة JSON، تأكد من تحليل الاستجابة ووجود مفتاح مطلوب. لكل طلب، تأكد من أن
finish_reasonيساويstop، مما يكشف عن الاقتطاع من إعداد سياق سيء. - شغل المجموعة مقابل كلتا البيئتين. قم بتبديل القائمة المنسدلة للبيئة من
hostedإلىlocalوأعد تشغيل سيناريو الاختبار نفسه. الفشل الذي يظهر فقط علىlocalهو مشكلة التكميم أو القالب لديك، ويمكن عزله بنقرة واحدة. - راقب البث. اضبط
stream: trueواستخدم عرض SSE لرؤية الأحداث تصل واحدة تلو الأخرى. الخادم المحلي الذي يخزن الاستجابة بأكملها مؤقتًا قبل الإرسال يبدو جيدًا في مكالمة غير بثية وخاطئًا هنا. - ضعه في CI. شغل السيناريو باستخدام
apidog-cliعند كل ترقية للمحرك، بحيث يتسبب قالب الدردشة المعطل في فشل خط أنابيب بدلاً من المستخدم.
قم بتنزيل Apidog وستتمكن من تشغيل سير العمل بالكامل من مشروع واحد.
الأسئلة الشائعة
هل يمكنني تشغيل DeepSeek-V4.1-Flash على جهاز كمبيوتر محمول (لابتوب)؟ ليس بشكل مفيد. العمود الفقري بتقنية 4 بت يبلغ حوالي 280 جيجابايت. يمكن لجهاز الكمبيوتر المحمول بثه من SSD بالطريقة التي استخدمتها تجربة Kimi K3، بمعدل حوالي رمز واحد في الثانية، وهو مجرد عرض توضيحي وليس سير عمل. استخدم واجهة برمجة التطبيقات (API) أو أحد الخيارات المتاحة في كيفية استخدام DeepSeek-V4.1-Flash مجانًا.
هل تعني 8 مليارات معلمة نشطة أنني أحتاج فقط إلى 8 جيجابايت من VRAM؟ لا. تحدد المعلمات النشطة الحوسبة لكل رمز، وليس الذاكرة. يمكن لتوجيه MoE اختيار أي من الخبراء الـ 384 لكل طبقة لأي رمز، لذا يجب تحميل جميع المعلمات الـ 552 مليار وجعلها قابلة للوصول.
كم تحتاج ذاكرة السياق بحجم 1 مليون؟ حوالي 0.89 جيجابايت من ذاكرة التخزين المؤقت KV عند 890 بايت لكل رمز. هذا هو الجزء الرخيص من هذا النموذج. الأوزان هي الجزء المكلف.
هل الترخيص آمن للاستخدام التجاري؟ نعم. الأوزان بموجب ترخيص MIT، وفقًا لبطاقة نموذج Hugging Face.
الخلاصة
DeepSeek-V4.1-Flash مفتوح بالطريقة التي تهم قانونيًا وتقنيًا: أوزان MIT، تقرير فني عام، وتصميم ذاكرة تخزين مؤقت KV يجعل جلسات 1 مليون رمز مجانية تقريبًا من حيث الذاكرة. إنه ليس مفتوحًا بالطريقة التي تسمح لك بتشغيله على الجهاز تحت مكتبك. بالنسبة لمعظم الفرق، الخطوة الصحيحة هي استخدام واجهة برمجة التطبيقات المستضافة بسعر 0.15 دولار لكل مليون رمز إدخال خارج أوقات الذروة، مع تخصيص النشر المحلي للبيانات التي لا يمكن أن تغادر المبنى.
في كلتا الحالتين، اختبر قبل أن تثق. وجه Apidog إلى كلتا نقطتي النهاية، وشغل نفس الطلبات المحفوظة، ودع التأكيدات تخبرك ما إذا كان إصدارك المحلي يطابق المرجع.