
وصل Grok 4.6 في 12 أغسطس بادعاء يعيد تشكيل قرار النموذج الرائد: ذكاء يربط GPT-5.6 Sol على مؤشر التحليل الاصطناعي، بسعر 6 دولارات لكل مليون رمز إخراج بدلاً من 30 دولارًا. لا تزال معظم مقالات المقارنة التي ستجدها تقارن Grok 4.5، والذي تخلف عن النموذج الرائد بشكل سيء لدرجة أن السعر لم يكن مهمًا. لم يعد هذا هو الوضع، لذا تبدأ هذه المقارنة من جديد بأرقام 4.6.
الجواب المختصر: يبقى GPT-5.6 Sol الخيار الأقوى لوكلاء الترميز على نطاق المستودعات، ويتصدر Claude Fable 5 العمل المستقل طويل الأفق بفارق ضئيل، وأصبح Grok 4.6 الآن الخيار ذو القيمة الذي يقترب بما فيه الكفاية من حيث القدرة لجعل النموذجين الآخرين يبرران سعرهما. يعتمد الاختيار الصحيح على عبء عملك، لذا إليك الأرقام واعتبارات API وطريقة قابلة للتكرار لاختبار الثلاثة جميعًا على مكدسك الخاص. إذا كنت ترغب في إجراء هذا الاختبار اليوم، فإن Apidog يتيح لك الوصول إلى جميع واجهات برمجة التطبيقات الثلاثة جنبًا إلى جنب من مساحة عمل واحدة، مجانًا.
ملخص سريع (TL;DR)
- مؤشر الذكاء: Claude Fable 5 يتصدر بـ 62؛ Grok 4.6 وGPT-5.6 Sol متعادلان بـ 61.
- الأسعار (الإخراج، لكل مليون رمز): Grok 4.6 بسعر 6 دولارات، Claude Opus 4.8 بسعر 25 دولارًا، GPT-5.6 Sol بسعر 30 دولارًا، بانتشار 5 أضعاف.
- السياق: GPT-5.6 Sol 1.05 مليون رمز، Claude Fable 5 1 مليون، Grok 4.6 500 ألف.
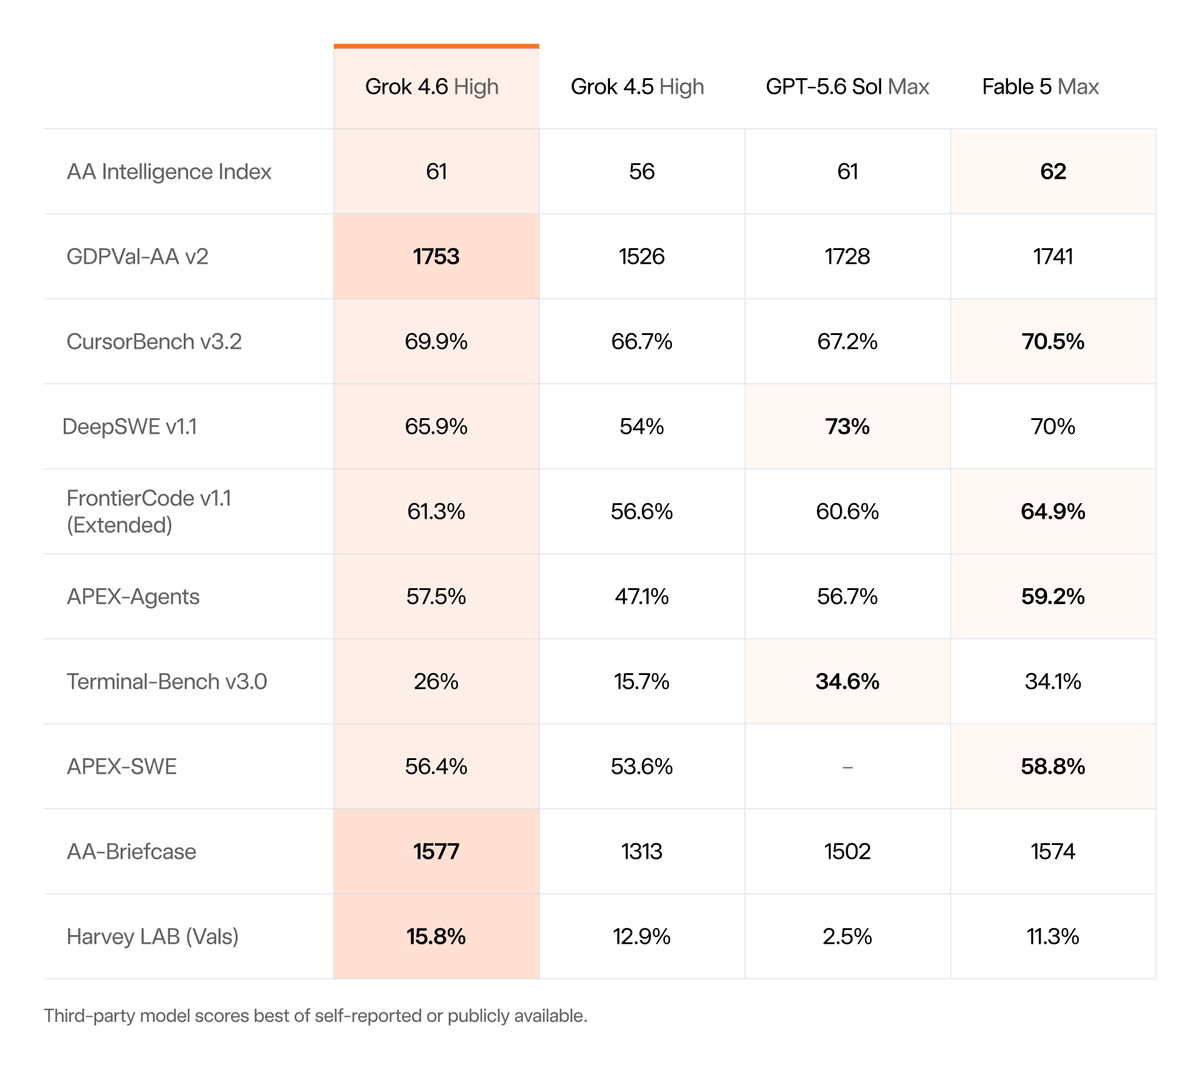
- الترميز: Sol Max يتصدر DeepSWE (73.0% مقابل 65.9% لـ Grok)؛ Fable 5 Max يتصدر FrontierCode (63.6% مقابل 61.3%).
- الوكلاء: Fable 5 Max يتصدر APEX-Agents بنسبة 59.2%؛ Grok 4.6 (57.5%) يتفوق على Sol Max (56.7%).
- التكلفة لكل مهمة مكتملة: Grok 4.6 تم قياسه بـ 0.84 دولار بواسطة Artificial Analysis، وهو الأقل بين النماذج الرائدة.
- لا تعتمد على المعايير وحدها: قم بإجراء اختبار لـ 20 مطالبة على عبء عملك الخاص (الطريقة أدناه).
المواصفات والأسعار جنبًا إلى جنب
| Grok 4.6 | GPT-5.6 Sol | Claude Fable 5 | |
|---|---|---|---|
| المطور | xAI | OpenAI | Anthropic |
| مؤشر الذكاء | 61 | 61 | 62 |
| نافذة السياق | 500 ألف | 1.05 مليون | 1 مليون |
| سعر الإدخال / 1 مليون | 2 دولار | 12 دولار | 10 دولار |
| سعر الإخراج / 1 مليون | 6 دولار | 30 دولار | 25 دولار* |
| النسخة السريعة/الممتازة | سعر 2x | مستوى Sol Max | مستوى Fable 5 Max |
| نمط API | متوافق مع OpenAI | OpenAI أصلي | رسائل Anthropic |
| حد المعرفة | فبراير 2026 |
*سعر Claude المعروض لـ Opus 4.8؛ تسعير مستوى Fable 5 يختلف حسب إعداد الجهد. راجع دليل تسعير GPT-5.6 و تحليل خفض تكاليف Claude للحصول على المصفوفات الكاملة.
عدم التماثل في الأسعار هو القصة. في جانب الإدخال، يفرض Grok سدس ما تفرضه OpenAI؛ وفي جانب الإخراج، الخمس. لأعباء عمل الدردشة، هذا جيد؛ لأعباء عمل الوكلاء، حيث يمكن لمهمة واحدة أن تولد عشرات من استدعاءات النماذج ونسخ استخدام الأدوات الطويلة، يتراكم هذا ليصبح الفارق بين وكيل يكلف 50 دولارًا في اليوم ووكيل يكلف 250 دولارًا في اليوم.
معايير الترميز: Sol للعمق، Grok للقيمة
بناءً على أرقام الإطلاق، يمتلك كل نموذج نطاقه الخاص:
| المعيار | Grok 4.6 | GPT-5.6 Sol Max | Claude Fable 5 Max |
|---|---|---|---|
| DeepSWE v1.1 (إصلاحات على مستوى المستودع) | 65.9% | 73.0% | |
| FrontierCode v1.1 Extended | 61.3% | 60.6% | 63.6% |
| CursorBench v3.2 | 69.9% | ||
| APEX-Agents | 57.5% | 56.7% | 59.2% |
| Terminal-Bench v2.1 | 88.4% |
اقرأها بهذه الطريقة:
- فارق DeepSWE البالغ 7 نقاط لـ GPT-5.6 Sol Max حقيقي ومهم. إصلاح الأخطاء على نطاق المستودعات هو أصعب معيار ترميز وأكثرها قيمة اقتصادية. إذا كان وكيلك يعمل عبر قواعد بيانات كبيرة موجودة بحد أدنى من الإشراف، فإن Sol لا يزال الرهان الأكثر أمانًا. تغطي مقارنتنا بين GPT-5.6 Sol وClaude Fable 5 هذه المواجهة بعمق.
- يفوز Claude Fable 5 بالثبات. يتصدر المؤشر المركب، FrontierCode، وAPEX-Agents. لا شيء مفاجئ، فهو ببساطة نادرًا ما يكون أسوأ من المركز الثاني. يناسب هذا الملف الشخصي العمل المستقل طويل الأفق حيث خطوة واحدة خاطئة تعرقل ساعة من التقدم.
- Grok 4.6 ليس متأخرًا أبدًا، وأحيانًا يتصدر. تصدر CursorBench وTerminal-Bench مع البقاء في متناول اليد في أماكن أخرى، بجزء بسيط من التكلفة، هو بالضبط ملف تعريف نموذج توجه إليه معظم حركة المرور الخاصة بك، وترفع فقط الحالات الصعبة.
ملاحظة صادقة: هذه الأرقام هي أرقام الأسبوع الأول للإطلاق، ومعظمها مبلغ عنها من قبل البائع. تطلبت معايير إطلاق Grok 4.5 قراءة دقيقة، وينطبق نفس الحذر على كل بائع هنا.
التكلفة لكل مهمة، وليس التكلفة لكل رمز
أسعار الرموز مضللة عندما تختلف النماذج في الإسهاب ومعدلات إعادة المحاولة. نموذج رخيص يفشل في تشغيل نهائي يخلق عمل مراجعة وإصلاح يكلف أكثر من الرموز التي تم توفيرها. المقياس الأفضل هو التكلفة لكل مهمة مكتملة، وهنا يكون القياس المستقل لـ Artificial Analysis مذهلاً: بلغ متوسط Grok 4.6 0.84 دولارًا لكل مهمة عبر تقييماته الوكيلية، وهو الأقل بين النماذج الرائدة، مدعومًا باستخدام رمزي منضبط نسبيًا بدلاً من مجرد أسعار منخفضة.
مثال عملي. لنقل أن وكيل الترميز الخاص بك يبلغ متوسطه 500 ألف رمز إدخال و 100 ألف رمز إخراج لكل مهمة مكتملة:
| النموذج | تكلفة الإدخال | تكلفة الإخراج | لكل مهمة |
|---|---|---|---|
| Grok 4.6 | 1.00 دولار | 0.60 دولار | 1.60 دولار |
| Claude Opus 4.8 | 5.00 دولار | 2.50 دولار | 7.50 دولار |
| GPT-5.6 Sol | 6.00 دولار | 3.00 دولار | 9.00 دولار |
عند 1000 مهمة شهريًا، يوفر Grok ما يقرب من 6000 إلى 7400 دولار مقارنة بالبدائل، إذا حافظ على معدل نجاحه في عبء عملك. هذا الشرط هو كل اللعبة، ولهذا السبب تختبر قبل أن تلتزم.
بيئة عمل API: ما هي تكلفة التكامل الفعلية بالنسبة لك
- Grok 4.6 متوافق مع OpenAI. إذا كان لديك أي عميل بنمط OpenAI، يمكنك توجيه `base_url` إلى `https://api.x.ai/v1` وستبدأ العمل. وهو متاح أيضًا على OpenRouter وVercel وCloudflare لمستخدمي البوابات.
- يمتلك GPT-5.6 Sol أعمق نظام بيئي: Responses API، استدعاء الأدوات البرمجية، وحزم SDK من الطرف الأول في كل مكان. راجع كيفية استخدام GPT-5.6 API لهيكل المستويات.
- يستخدم Claude Fable 5 واجهة برمجة تطبيقات رسائل Anthropic (Messages API)، وشكل طلب مختلف، وموثوقية ممتازة في استخدام الأدوات، ومعامل جهد يوازن التكلفة مقابل القدرة داخل نموذج واحد.
احتكاك الهجرة هو الأقل بين Grok وOpenAI (تنسيق مشترك)، والأعلى عند الانتقال من أو إلى Anthropic. إذا كنت تتوقع التبديل أو التوجيه بين النماذج، فإن عدم التماثل هذا ينتمي إلى قرار تصميمك المعماري.
نوافذ السياق: متى تكون 500 ألف كافية
على الورق، نافذة GPT-5.6 Sol البالغة 1.05 مليون رمز تضاعف نافذة Grok 4.6 البالغة 500 ألف، مع اقتراب Claude Fable 5 بمليون رمز. عمليًا، السؤال هو ما الذي يحتويه عبء عملك بالفعل في السياق.
تتسع نافذة 500 ألف لحوالي 350 ألف كلمة: قاعدة بيانات كاملة لخدمة متوسطة الحجم، عام من نصوص الدعم، أو عدة مئات من الصفحات من المستندات القانونية. معظم مهام الوكلاء لا تقترب منها أبدًا. أعباء العمل التي تحتاج حقًا إلى مستوى المليون رمز ضيقة: تحليل المستودعات المتجانسة بالكامل، نصوص وكلاء الجلسات المتعددة الطويلة جدًا التي ترفض تلخيصها، والمعالجة الفردية لمجموعات ضخمة من المستندات.
ملاحظتان عمليتان تتعارضان مع الاختيار بناءً على حجم النافذة فقط. أولاً، يتدهور أداء كل نموذج مع امتلاء السياق؛ جودة الاسترجاع عند سعة 80% أسوأ منها عند 20% في النماذج الثلاثة، لذا فإن البنى التي تحشو النافذة نادرًا ما تتفوق على البنى التي تسترجع بشكل انتقائي. ثانيًا، رموز الإدخال هي حيث تضيع الميزانيات: ملء نافذة Sol بالكامل يكلف حوالي 12.60 دولارًا لكل طلب بالسعر المعلن، بينما يكلف ملء نافذة Grok دولارًا واحدًا. إذا كانت مطالباتك تتجاوز 400 ألف رمز بشكل روتيني، فأنت لا تحتاج فقط إلى نافذة أكبر، بل تحتاج إلى استراتيجية تخزين مؤقت واسترجاع، بغض النظر عن البائع الذي تختاره.
حدود المعرفة ونضج النظام البيئي
يأتي Grok 4.6 بحد معرفي يمتد حتى 1 فبراير 2026، وهو الأحدث من بين الثلاثة، مما يهم وكلاء الترميز الذين يشيرون إلى الأطر سريعة التطور. إنها ميزة حقيقية ولكنها بسيطة: أي حزمة وكيل جادة تعتمد على أدوات الاسترجاع والتوثيق بدلاً من الثقة بالمعرفة البارامترية.
النظام البيئي هو القصة المعاكسة. تمتلك OpenAI أعمق سطح تكامل للطرف الثالث، بينما تمتلك Anthropic أكبر حصة في سوق أطر عمل الوكلاء، وxAI هي الوافد الجديد الذي يعتمد على توافق OpenAI للاستعارة من كليهما. هذا الرهان ينجح في الغالب: أي شيء يتحدث تنسيق إكمال الدردشة يعمل مع Grok اليوم، وتوفر البوابة من خلال OpenRouter وVercel وCloudflare يعني أنه يمكنك اعتماده دون لمس بنيتك التحتية. ما تتنازل عنه هو الصقل الخاص بالطرف الأول، واجهات برمجة تطبيقات الدفعات (batch APIs)، ومستويات التخزين المؤقت، وضوابط الاستخدام الدقيقة أقل نضجًا من تلك الموجودة لدى الشركات الكبرى.
أي نموذج لأي وظيفة
- وكيل ترميز مستقل على نطاق المستودعات، الجودة أولاً: GPT-5.6 Sol. يؤدي تفوق DeepSWE إلى عدد أقل من العمليات الفاشلة على قواعد بيانات كبيرة.
- عمل معرفي طويل الأمد وجلسات وكلاء متعددة الساعات: Claude Fable 5. أفضل درجة مركبة، أفضل معيار للوكلاء، أقوى سجل في البقاء على المسار الصحيح.
- حركة وكلاء عالية الحجم، منتجات حساسة للتكلفة، أو نموذج افتراضي للموجه: Grok 4.6. مخرجات على مستوى النماذج الرائدة بأسعار على مستوى السلع الأساسية؛ تصعيد أصعب 10% من المهام إلى Sol أو Fable.
- الترميز التفاعلي في بيئة التطوير المتكاملة (IDE): تفوق Grok 4.6 في CursorBench بالإضافة إلى نسخته السريعة 2x يجعله منافسًا جادًا؛ لقد تم بناؤه بفعالية لهذا الغرض بعد التدريب على جلسات Cursor حقيقية.
اختبر النماذج الثلاثة على مكدسك في فترة ما بعد الظهر
تتنبأ المعايير بالمتوسطات، وليس عبء عملك. إليك اختبار قابل للتكرار باستخدام Apidog:
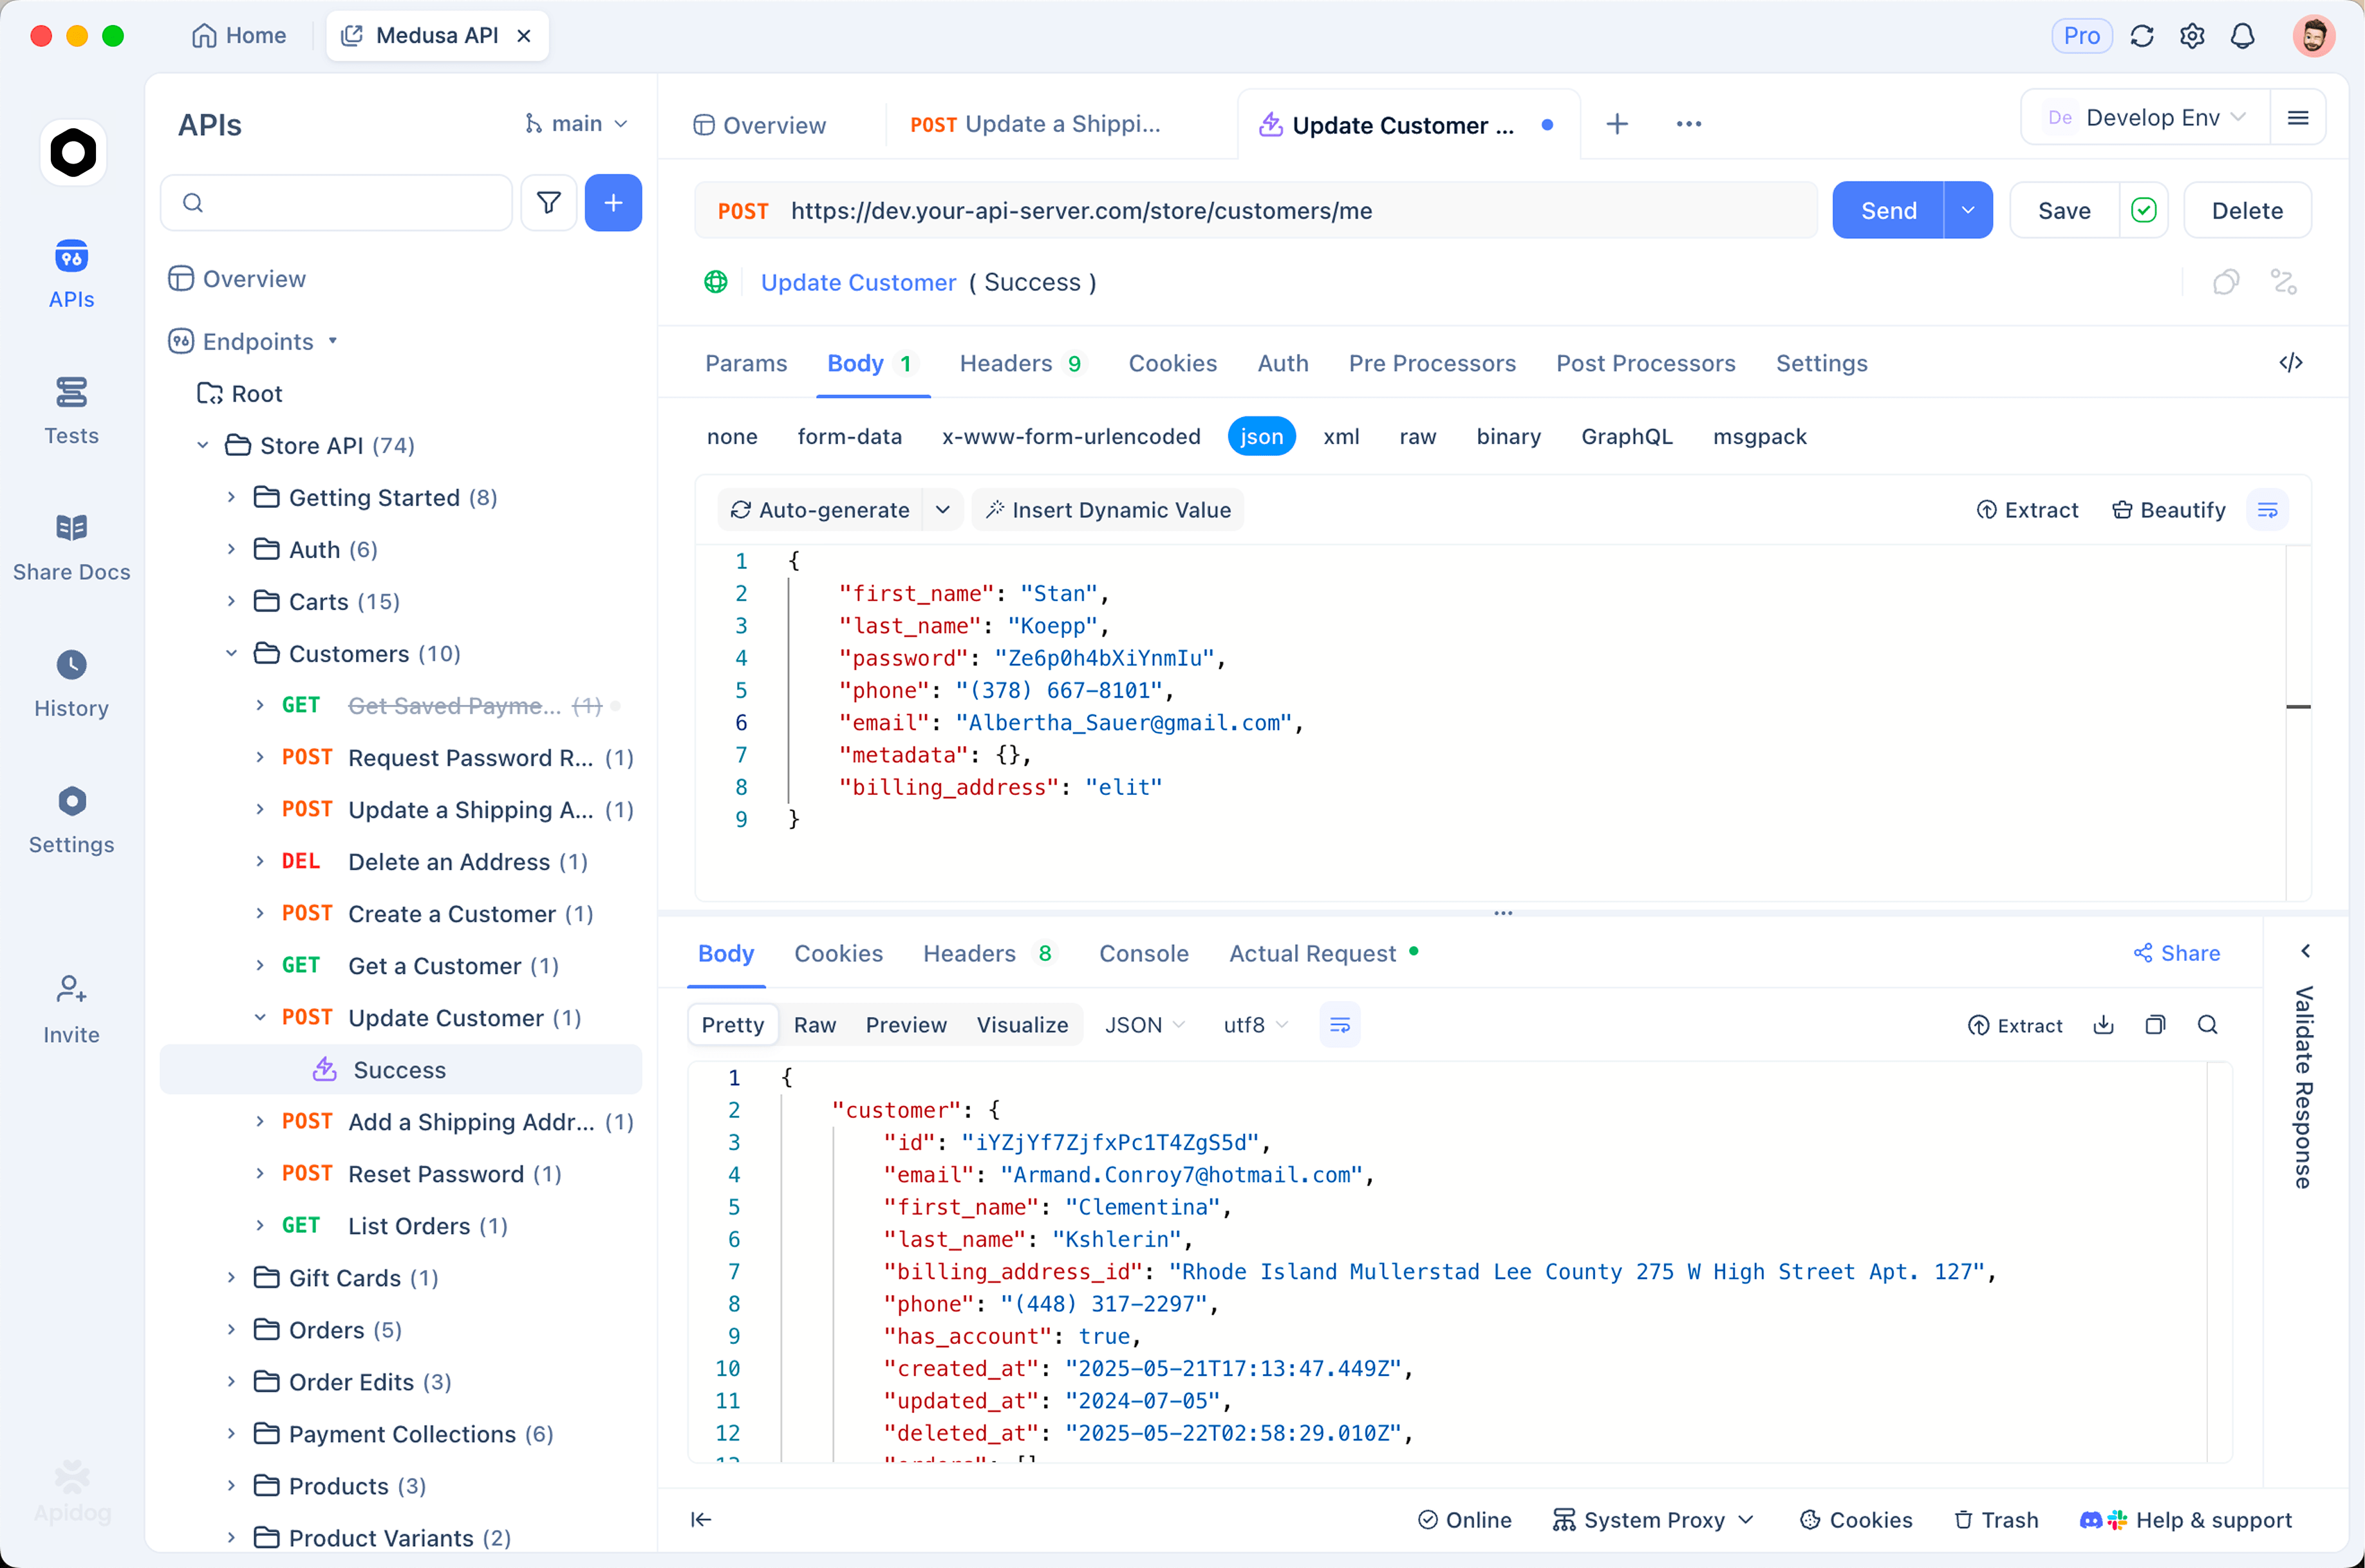
- مشروع واحد، ثلاث بيئات. أنشئ بيئات لـ xAI (`api.x.ai/v1`) وOpenAI وAnthropic، كل منها يحمل مصادقته الخاصة. نفس الطلب يبدل المزودين بقائمة منسدلة واحدة.
- اجمع 20 مطالبة حقيقية. اسحب مهامًا فعلية من منتجك، وليس أسئلة لعب. قم بتضمين موجه نظامك، وتعريفات أدواتك إذا كنت تستخدم استدعاء الوظائف، وما لا يقل عن خمس حالات صعبة معروفة.
- أكد ما يهمك. أضف تأكيدات Apidog لصحة الاستجابة، واستخدام الرمز من كائن `usage`، وعتبات الكمون. لأعباء عمل استدعاء الأدوات، تأكد من أن JSON لاستدعاء الأداة يتم تحليله ويتطابق مع مخططك، حيث تفشل النماذج هنا أكثر بكثير مما تفشل في النثر.
- قم بتشغيلها كسيناريو اختبار، ثلاث مرات لكل نموذج. تختلف مخرجات LLM؛ تكشف ثلاث عمليات تشغيل عن التباين الذي تخفيه تجربة واحدة. صدر النتائج وقارن معدل النجاح والتكلفة لكل نجاح، وليس التكلفة لكل رمز.
- احتفظ بالمجموعة. عندما يتم شحن الإصدار التالي من النموذج (بالإيقاع الحالي، في غضون أشهر)، أعد تشغيله. أصبح اختيار النموذج الآن قرارًا ربع سنويًا، وتنتقل الفرق التي لديها نظام تقييم دائم أسابيع أسرع من الفرق التي تعيد اتخاذ القرار بالقصص غير الموثوقة.
الأسئلة الشائعة
هل Grok 4.6 أفضل من GPT-5.6 Sol؟ يتعادلان في المؤشر المركب بـ 61. يتصدر Sol بوضوح ترميز على نطاق المستودعات (DeepSWE 73.0% مقابل 65.9%)؛ يتصدر Grok في CursorBench وTerminal-Bench ويكلف 5 أضعاف أقل في جانب الإخراج. يعتمد "الأفضل" على ما إذا كان عبء عملك يشبه DeepSWE أكثر أو يشبه جلسة IDE أكثر.
هل Grok 4.6 أفضل من Claude Fable 5؟ يتصدر Fable 5 المؤشر (62 مقابل 61)، وFrontierCode، وAPEX-Agents، كلها بفارق ضئيل. ميزة Grok هي السعر. للعمل المستقل الذي يتطلب دقة عالية، Fable 5؛ للحجم الحساس للتكلفة، Grok.
أي نموذج AI هو الأرخص على الحدود في عام 2026؟ Grok 4.6، بسعر 2 دولار / 6 دولارات لكل مليون رمز وبمتوسط تكلفة 0.84 دولار لكل مهمة وكيلية تم قياسها بشكل مستقل. تكلفة رموز الإخراج للمنافس الرائد الأقرب تبلغ حوالي 4 أضعاف.
هل يجب أن أحول وكيلي الإنتاجي إلى Grok 4.6؟ ليس على أساس المعايير وحدها. قم بإجراء الاختبار المذكور أعلاه على عبء عملك الحقيقي أولاً، فالفارق السعري البالغ 5 أضعاف يؤتي ثماره فقط إذا استمر معدل النجاح في مهامك.
هل يمكنني استخدام النماذج الثلاثة جميعًا خلف تنسيق API واحد؟ غالبًا. يتحدث Grok 4.6 تنسيق إكمال الدردشة الخاص بـ OpenAI بشكل أصلي، لذا فإنه يشارك رمز العميل مع GPT-5.6. يتطلب Claude واجهة برمجة تطبيقات رسائل Anthropic (Messages API)، أو بوابة مثل OpenRouter التي توحد الثلاثة جميعًا خلف واجهة واحدة بهامش ربح صغير.
هل حجم نافذة السياق الأصغر في Grok 4.6 مهم؟ لمعظم أعباء عمل الوكلاء والدردشة، لا؛ 500 ألف رمز أعلى بكثير من الاستخدام النموذجي، وجميع النماذج الثلاثة تتدهور بالقرب من حدودها على أي حال. يصبح الأمر مهمًا إذا كنت تعالج بشكل روتيني مستودعات متجانسة كاملة أو مجموعات بيانات ضخمة في استدعاء واحد، حيث توفر نافذة Sol البالغة 1.05 مليون مساحة حقيقية للمناورة.