
يعود الفرق بين GPT-Live-1.1 وGPT-Realtime إلى البنية المعمارية. فـ GPT-Live-1.1 هو واجهة صوتية أمامية كاملة الازدواجية (full-duplex) تُحيل مهام الاستدلال والأدوات إلى نموذج خلفي (backend) منفصل، وتُحاسبك بسعر $0.05 لكل دقيقة نشطة. أما GPT-Realtime-2.1 فهو نموذج واحد من الكلام إلى الكلام يسمع ويستنتج ويستدعي الأدوات ويتحدث، وتُحاسبك فيه على أساس الرموز (tokens). اختر GPT-Live-1.1 عندما يكون لديك وكيل نصي (text agent) بالفعل؛ واختر Realtime عندما تريد نموذجًا واحدًا يقوم بكل شيء.
أطلقت OpenAI نموذج GPT-Live-1.1 في واجهة الـ API في 20 نوفمبر 2026، فأصبح لديك الآن حزمتان صوتيتان مختلفتان من حيث نقاط النهاية (endpoints) والفوترة ونماذج الأدوات. قارنت تدوينة يوليو بعنوان GPT-Live vs GPT-Realtime بين ميزة ChatGPT وواجهة الـ API؛ أما هذه التدوينة فهي مقارنة بين واجهة API وأخرى.
GPT-Live-1.1 مقابل GPT-Realtime في لمحة
إليك كيف تتقارن الحزمتان، نقلًا عن صفحة نموذج GPT-Live-1.1، وصفحة نموذج gpt-realtime-2.1، وصفحة أسعار OpenAI في 20 نوفمبر 2026:
| GPT-Live-1.1 | gpt-realtime-2.1 | |
|---|---|---|
| نقطة النهاية (Endpoint) | v1/live/sessions |
v1/realtime |
| التصميم | صوت كامل الازدواجية مع خلفية مُفوَّضة (delegated backend) | نموذج واحد للاستدلال من الكلام إلى الكلام |
| المدخلات | صوت، نص | صوت، نص، صورة |
| المخرجات | صوت، نص | صوت، نص |
| الفوترة | $0.05/دقيقة نشطة، $0.02/دقيقة في وضع الانتظار (standby) | $32 إدخال، $64 إخراج لكل 1M رمز صوتي |
| الاستدلال والأدوات | نموذج خلفي، تُحاسب عليه منفصلًا | داخل النموذج نفسه وضمن السعر ذاته |
| استدعاء الدوال (Function calling) | عبر التفويض (delegation) | session.tools |
| وسائل النقل (Transports) | WebRTC، WebSocket، SIP (وارد وصادر) | WebRTC، WebSocket، SIP (وارد) |
| حدود المعدل (Rate limits) | الجلسات المتزامنة | الطلبات والرموز في الدقيقة |
يجمل دليل وكلاء الصوت من OpenAI هذا الانقسام في جدول البنية المعمارية الخاص به. فـ GPT-Live مخصص لـ«المحادثات كاملة الازدواجية مع خلفية منفصلة». أما Realtime API فمخصص لـ«الكلام والاستدلال واستخدام الأدوات في جلسة واحدة».
البنية المعمارية: التفويض مقابل نموذج واحد
يفصل GPT-Live-1.1 بين التحدث والتفكير. يتولى النموذج الصوتي إدارة المحادثة في الوقت الفعلي ويستمع أثناء تحدثه. وعندما يحتاج طلب ما إلى استدلال أو بحث أو أداة، يُفوّض العمل إلى نموذج خلفي ويواصل المحادثة في أثناء تنفيذه.
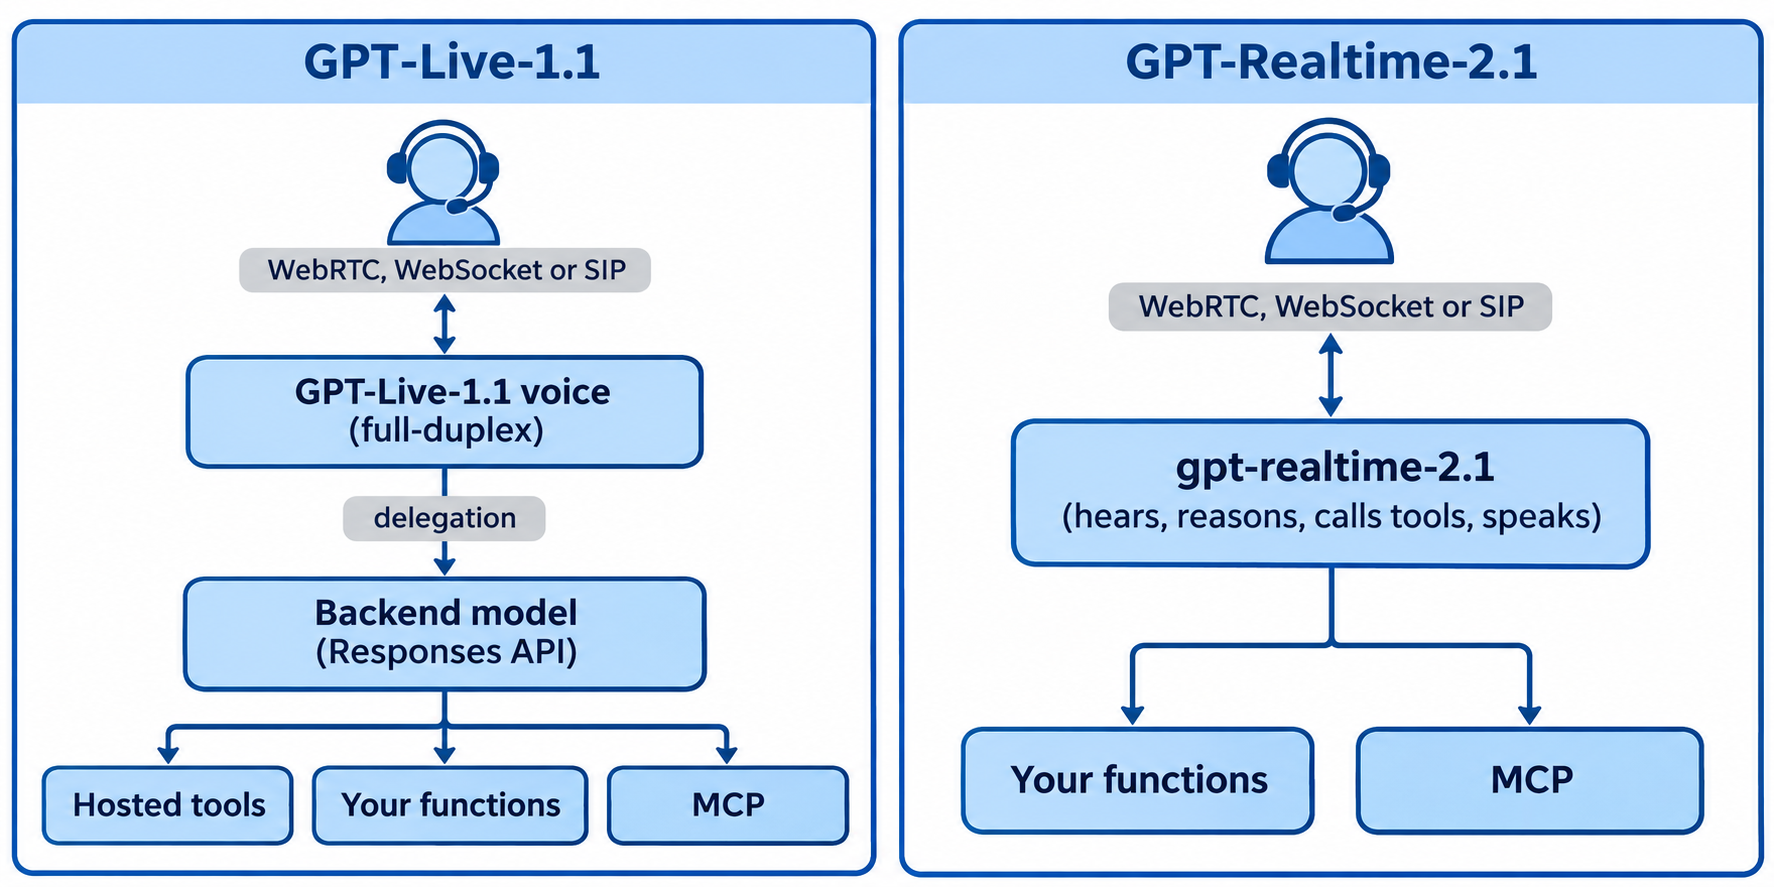
تُضبط التفويض مرة واحدة عند إنشاء الجلسة، وفقًا لـدليل المحادثات المباشرة. وله وضعان:
responses: تدير OpenAI الخلفية عبر Responses API. تختار النموذج فيdelegation.responses.modelوتضيفinstructionsوtoolsوtool_choiceوreasoningوservice_tier. تقترح الوثائق البدء بـgpt-6-lunaوالانتقال إلىgpt-6-solللمهام الأصعب.client: يدير تطبيقك الخلفية. يرسل GPT-Live حدثsession.delegation.created، فتعيد النتائج عبر أحداث مثلsession.instructions.append.
لا يمكن تغيير الوضع في منتصف الجلسة؛ فتبديله يعني جلسة جديدة. أما إعدادات الخلفية داخله فيمكن تغييرها عبر session.update.
يتبع gpt-realtime-2.1 النهج المعاكس: نموذج استدلال واحد يفسّر الصوت ويستدعي الأدوات ويجيب بالكلام. لا نموذج ثانٍ، ولا تسليم مهام، وكامل السياق في مكان واحد.
مع GPT-Live-1.1 يمكنك تبديل الخلفية، أو الاحتفاظ بوكيلك النصي الحالي، دون المساس بطبقة الصوت. أما مع Realtime فالنموذج الصوتي هو الوكيل نفسه.
التسعير: بالدقيقة مقابل بالرمز
يُحاسب GPT-Live-1.1 على أساس الوقت، بينما يُحاسب Realtime على أساس الرموز. وهذا يجعل تكلفتيهما تتصرفان بشكل مختلف جدًا بمجرد أن يتوقف المتصلون أو يسترسلوا في الكلام أو ينتظروا على الخط.
| بند التكلفة | GPT-Live-1.1 | gpt-realtime-2.1 | gpt-realtime-2.1-mini |
|---|---|---|---|
| الصوت | $0.05/دقيقة نشطة، $0.02/دقيقة في وضع الانتظار | $32 إدخال، $64 إخراج لكل 1M رمز | $10 إدخال، $20 إخراج لكل 1M رمز |
| النص | تُحاسب عليه حسب مدة الجلسة | $4 إدخال، $24 إخراج لكل 1M رمز | $0.60 إدخال، $2.40 إخراج لكل 1M رمز |
| الإدخال المخزَّن مؤقتًا (Cached input) | لا ينطبق | $0.40 لكل 1M رمز | $0.30 صوت، $0.06 نص لكل 1M |
| الاستدلال والأدوات | النموذج الخلفي بأسعاره الخاصة | مشمول في سعر الرمز | مشمول في سعر الرمز |
يحاسب GPT-Live بالثانية، لذا فإن مكالمة مدتها 90 ثانية تكلّف $0.075 من وقت الصوت، لا $0.10. وتُحاسب جلسة WebRTC عن 15 ثانية أثناء تهيئتها، وتُضاف كرصيد بمجرد أن تبدأ العمل.
وضع الانتظار (Standby) هو رافعة التكلفة التي يفتقر إليها Realtime. في WebRTC، اضبط wake_policy.type على "speech" وidle_timeout_s على عدد صحيح من 5 إلى 60. بعد هذا العدد من الثواني دون كلام، تنخفض الجلسة إلى $0.02 في الدقيقة حتى يتحدث أحدهم مجددًا. وضع الانتظار موثّق لـ WebRTC فقط، لذا تُحاسب جلسات WebSocket وSIP على كل ثانية متصلة بالسعر النشط.
لمقارنة الاثنين بحسب حجم حركة المرور الخاصة بك، استخدم رقم نقطة التعادل بدلًا من التخمين. إن $0.05 تشتري نحو 1,560 رمز إدخال صوتي أو 780 رمز إخراج صوتي على gpt-realtime-2.1، ونحو 5,000 رمز إدخال أو 2,500 رمز إخراج على 2.1-mini. استخرج أعداد الرموز الصوتية لكل دقيقة من أحداث استخدام Realtime الخاصة بك. إذا كانت الدقيقة النشطة المتوسطة لديك تستهلك أكثر من ذلك، فإن وقت الصوت في GPT-Live أرخص؛ ثم أضف فاتورة رموز النموذج الخلفي لرؤية الصورة الكاملة.
يجمع Realtime الاستدلال ضمن سعر الرمز؛ أما GPT-Live فيضيف فاتورة خلفية لكل مهمة مفوّضة لكنه يقلل تكلفة فترات الصمت عبر وضع الانتظار. لمعرفة الجانب الخاص بالرموز، راجع دليل gpt-realtime-2.1-mini الخاص بنا.
استدعاء الدوال والأدوات
تستدعي كلتا الحزمتين دوالك، لكن من مواقع مختلفة.
في Realtime، تعيش الأدوات على الجلسة. يُظهر دليل أدوات Realtime أداة من نوع "type": "function" في session.tools، تُرسل مع session.update. يشغّل عميلك الدالة ويعيد عنصر function_call_output. تعمل خوادم MCP عن بُعد أيضًا: أضف أداة بـ "type": "mcp" وserver_label وserver_url، وسيستدعي Realtime API الخادم نيابة عنك. يمكنك أيضًا حصر الأدوات بدور واحد عبر response.tools.
في GPT-Live-1.1، تعيش الأدوات على الخلفية. تضع أدوات الدوال وخوادم MCP والأدوات المستضافة مثل البحث على الويب والبحث في الملفات وCode Interpreter في delegation.responses.tools. تصل إليك أحداث الخلفية مغلفة في أغلفة response.event، وتُعاد نتائج دوالك كعناصر function_call_output يتبعها response.create.
الميزة: يبقى الصوت سريع الاستجابة أثناء تشغيل أداة بطيئة في الخلفية. والتكلفة: نموذجان، ومجرّيان للأحداث (event streams)، وفاتورتان.
تبادل الأدوار والمقاطعات ووسائل النقل
هنا يبدو الفرق بين الاثنين أوضح ما يكون للمتصل.
تبادل الأدوار (Turn-taking). GPT-Live-1.1 كامل الازدواجية: يعالج الصوت الوارد أثناء توليد المخرجات، فيمكنه الاستماع والتفاعل الخفيف والتعديل في منتصف الجملة. أما Realtime فيعمل بأدوار يكتشفها عبر نشاط الصوت (VAD). يسرد دليل Realtime VAD وضعين في session.audio.input.turn_detection.type:
server_vad، وهو الافتراضي، ويُضبط بـthresholdوprefix_padding_msوsilence_duration_ms.semantic_vad، ويُضبط بـeagerness(lowأوmediumأوhighأوauto، وهو يعادلmedium).
يتعامل Realtime مع المقاطعة (barge-in) عبر interrupt_response. أما GPT-Live فلا يحتاج إلى هذا الإعداد، لأنه يستمع بالفعل أثناء تحدثه.
وسائل النقل (Transports). كلاهما يدعم WebRTC في المتصفح وWebSocket على الخادم. لكن الاتصال الهاتفي يختلف. وفقًا لـدليل SIP، يدعم GPT-Live بروتوكول SIP الوارد والصادر، والاتصال الصادر «متاح لجميع المؤسسات عبر Live API، وليس عبر نقطة إنشاء المكالمات في Realtime API». تُحدّد مكالمة SIP متصلة عبر GPT-Live بمدة أقصاها ساعتان. ويغطي دليل SIP الخاص بـ Realtime المكالمات الواردة عبر webhook باسم realtime.call.incoming.
الحدود والسياق
| الحد | GPT-Live-1.1 | gpt-realtime-2.1 |
|---|---|---|
| السياق | 128,000 رمز لكل جلسة، يُدار تلقائيًا | 128,000 رمز |
| الحد الأقصى لرموز المخرجات | غير منشور | 32,000 |
| التعليمات (Instructions) | حتى 16,384 رمز | غير منشور |
| حدود المعدل (Rate limits) | الجلسات المتزامنة، لكل نموذج | 400 RPM و200,000 TPM في فئة Build |
يحسب GPT-Live التزامن، لا الرموز. تسرد صفحة GPT-Live-1 50 جلسة متزامنة في فئة Build، و300 في Launch، و500 في Grow، مع عدم توفر الوصول في الفئة المجانية (Free). لـ GPT-Live-1.1 حد منفصل خاص به، وصفحته لا تنشر الأرقام بعد، لذا تحقق من صفحة حدود مؤسستك قبل الإطلاق.
تتوسع حدود Realtime لتصل إلى 10,000 RPM في فئة Launch و20,000 RPM في فئة Grow.
أي واجهة API صوتية من OpenAI يجب أن تستخدم؟
استخدم GPT-Live-1.1 عندما يكون الصوت طبقة فوق وكيل تثق به بالفعل، واستخدم Realtime عندما يجب أن يكون النموذج الصوتي هو الوكيل نفسه.
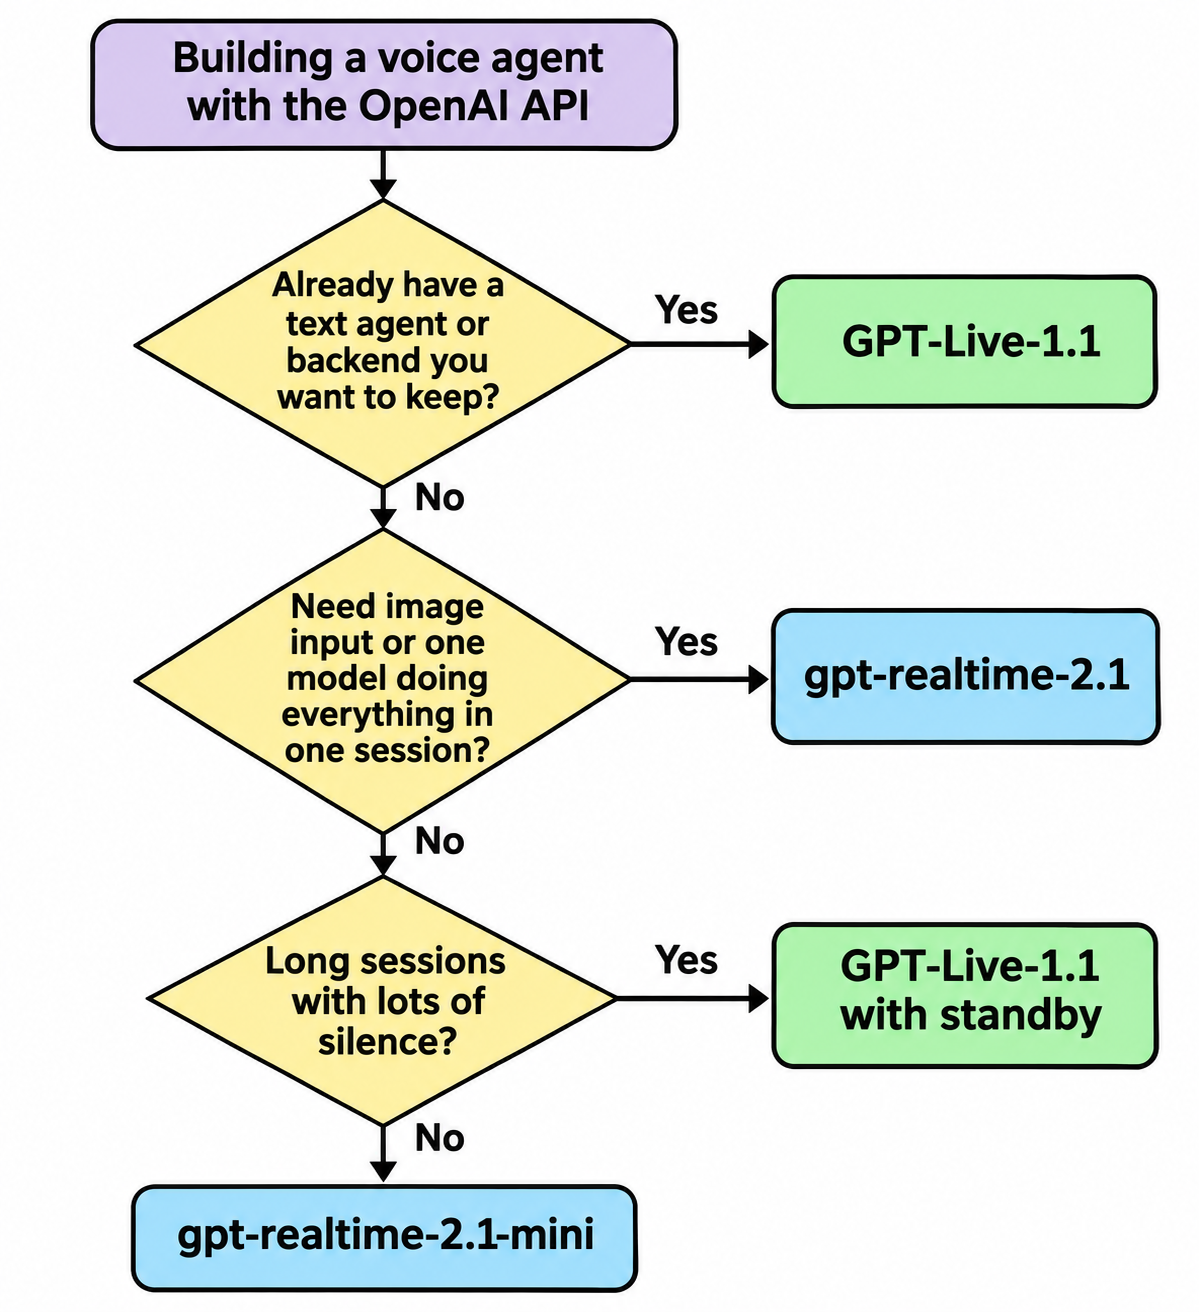
اختر GPT-Live-1.1 من أجل:
- إضافة الصوت إلى وكيل نصي أو روبوت دعم أو سير عمل قائم دون إعادة بنائه.
- الجلسات الطويلة التي تتخللها فترات صمت، مثل التعليم أو التدريب أو المرافقة، حيث يُجدّي وضع الانتظار.
- المكالمات الهاتفية الصادرة، التي يوفرها Live API وحده.
- المحادثات التي تحتاج إلى تداخل طبيعي وتفاعل خفيف (backchanneling).
اختر gpt-realtime-2.1 من أجل:
- وكلاء صوت مكتفين ذاتيًا حيث يجب أن يقوم نموذج واحد بالاستدلال والتصرف.
- التطبيقات التي ترسل صورًا مع الكلام.
- الفرق التي تريد مجرى أحداث واحدًا وفاتورة واحدة.
اختر gpt-realtime-2.1-mini من أجل مهام صوتية قصيرة وعالية الحجم ومنخفضة التكلفة حيث تتفوق أسعار الرموز على أسعار الدقيقة. يغطي دليل GPT-Realtime-2 API الخاص بنا إعداد Realtime بالتفصيل.
دع وكيل البرمجة الخاص بك يختبر واجهة أدوات API باستخدام Apidog CLI
أيًا كانت الحزمة الفائزة، فكلاهما تستدعي الشيء نفسه: واجهة أدوات API الخاصة بك. البحث البطيء يعني صمتًا ميتًا في كلتا الحالتين، لذا اختبر زمن استجابته وعقده (contract) قبل أن يسمعه أي متصل. دع Claude Code أو Codex أو Cursor يفعل ذلك عبر Apidog CLI.
قم بإعداده مرة واحدة:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
ثم أعطِ وكيلك توجيهًا واحدًا:
Import ./voice-tools-openapi.yaml into Apidog project <projectId>. Build a test scenario
that calls GET /orders/{order_id} and GET /customers/{id} in sequence, asserts 200 and
the fields my voice agent reads aloud, and fails any request slower than 800 ms.
Run it 20 times against staging and tell me which step is slowest.
يستورد الوكيل المواصفة (spec)، ويتحقق من شكل الحمولة (payload shape)، ويبني السيناريو ويشغّله:
apidog import --project <projectId> --format openapi --file ./voice-tools-openapi.yaml
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <projectId> --file scenario.json
apidog test-scenario import-steps <scenarioId> --project <projectId> --source endpoint --ids <endpointIds> --sync manual
apidog run -t <scenarioId> --project <projectId> -e <envId> -n 20 --timeout-request 800 -r cli,json
يكرّر -n 20 التشغيل حتى لا تحجب استجابة محظوظة واحدة ذيلًا بطيئًا، ويفشل --timeout-request 800 أي استدعاء بطيء بما يكفي لترك المتصل منتظرًا. استبدل -r cli,json بـ -r junit في CI حتى يحجب أي تراجع (regression) عملية النشر، كما يُظهر دليل Apidog CLI CI/CD الخاص بنا. هل أنت جديد على سير عمل الوكلاء؟ ابدأ بـApidog CLI في Claude Code. تغطي خطة Apidog المجانية ما يصل إلى 4 مستخدمين.
الأسئلة الشائعة
أيهما أرخص، GPT-Live-1.1 أم GPT-Realtime؟ يعتمد ذلك على عدد الرموز الصوتية لكل دقيقة لديك وعلى خلفيتك. يكلّف صوت GPT-Live $0.05 لكل دقيقة نشطة بالإضافة إلى رموز النموذج الخلفي. في gpt-realtime-2.1، تشتري $0.05 نحو 1,560 رمز إدخال صوتي أو 780 رمز إخراج صوتي. قارن ذلك بسجلات الاستخدام الخاصة بك.
هل يمكنني استخدام استدعاء الدوال مع GPT-Live-1.1؟ نعم، عبر التفويض. ضع أدوات الدوال في delegation.responses.tools، أو شغّل الخلفية بنفسك في وضع التفويض من جانب العميل (client delegation). لا يتلقى النموذج الصوتي قائمة أدوات مباشرة كما هو الحال مع session.tools في Realtime.
هل يدعم GPT-Realtime فوترة وضع الانتظار؟ لا. وضع الانتظار بسعر $0.02 في الدقيقة هو ميزة GPT-Live، وهو مخصص فقط لجلسات WebRTC المضبوطة بـ wake_policy وidle_timeout_s. أما Realtime فيحاسب على الرموز التي تستهلكها كل جلسة.
هل يمكن لـ GPT-Live-1.1 إجراء مكالمات هاتفية صادرة؟ نعم. أنشئ جلسة بـ transport.type: "sip" وتفاصيل ترنّك SIP الخاص بك على POST /v1/live/sessions. تقول وثائق OpenAI إن SIP الصادر يعمل عبر Live API، وليس عبر نقطة إنشاء المكالمات في Realtime API.
هل يقبل GPT-Live-1.1 إدخال الصور؟ لا. تسرد صفحة النموذج الصوت والنص إدخالًا وإخراجًا. إذا كان وكيلك الصوتي يحتاج إلى رؤية الصور، فإن gpt-realtime-2.1 يقبل إدخال الصور بسعر $5 لكل 1M رمز.