
تسعير GPT-Live-1.1 يعتمد على الوقت وليس على الرموز (tokens). تفرض OpenAI رسوم جلسة الصوت بمعدل 0.05 دولار لكل دقيقة نشطة و0.02 دولار لكل دقيقة احتياطية، وتُحتسب بالثانية دون تقريب لأقرب دقيقة. أما استدعاءات النموذج الخلفي والأدوات فتُفوتر بشكل منفصل بأسعارها العادية. ساعة من المحادثة المتواصلة تكلف 3.00 دولارات كرسوم صوتية، وساعة في وضع الاستعداد تكلف 1.20 دولار.
جدول الأسعار قصير. الأهم هو سلوكه في تطبيق حقيقي، حيث يتوقف المتصلون ليفكروا، وتستغرق الأنظمة الخلفية وقتًا، وتبقى الجلسات مفتوحة أطول من اللازم. فيما يلي ثلاثة أمثلة عملية والإعدادات التي تُبقي الفاتورة قابلة للتنبؤ.
نظرة سريعة على تسعير GPT-Live-1.1
يحتوي GPT-Live-1.1 على معدلين للصوت وفاتورة منفصلة للنظام الخلفي. هذا ما يذكره صفحة نموذج GPT-Live-1.1 وصفحة تسعير OpenAI حتى 20 نوفمبر 2026:
| الرسوم | المعدل | في الساعة | ملاحظات |
|---|---|---|---|
| وقت الجلسة النشطة | 0.05 دولار لكل دقيقة | 3.00 دولارات | الكلام، الصمت قبل انتهاء مهلة الخمول، انتظار عمل النظام الخلفي |
| وقت الجلسة الاحتياطية | 0.02 دولار لكل دقيقة | 1.20 دولار | WebRTC فقط، أثناء توقف الاستدلال |
| نموذج Responses الخلفي | أسعار الرموز العادية | متغيّرة | النموذج الذي تختاره للتفويض |
| الأدوات المستضافة | أسعار الأدوات العادية | متغيّرة | البحث في الويب، البحث في الملفات، Code Interpreter وغيرها |
ثلاث تفاصيل أهم من المعدلات الرئيسية:
- الفوترة بالثانية. مكالمة مدتها 90 ثانية تكلف 0.075 دولار وليس 0.10 دولار؛ فالمدة لا تُقرَّب لأقرب دقيقة كاملة.
- نفس سعر GPT-Live-1. كلا النموذجين يشتركان في المعدلات نفسها، لذا الترقية لا تغيّر فاتورة الصوت.
- رسوم بدء تشغيل قدرها 15 ثانية. إنشاء جلسة WebRTC يُحتسب لها 15 ثانية أثناء التهيئة، وتُعاد مرة واحدة بعد تشغيل الجلسة. لا تكلفك رسومًا إضافية إلا للجلسات التي تنشئها ثم تتخلى عنها.
للاطلاع على خلفية حول بنيات الصوت، راجع GPT-Live مقابل GPT-Realtime.
ما الفرق بين الدقائق النشطة والدقائق الاحتياطية
الدقائق النشطة هي أي وقت يعمل فيه الاستدلال. أما الدقائق الاحتياطية فهي الوقت الذي تبقى فيه جلسة WebRTC متصلة مع توقف الاستدلال في انتظار الكلام. فارق الـ 0.03 دولار لكل دقيقة بينهما هو ما يحدد معظم فاتورتك الصوتية.
يوضح دليل التكاليف من OpenAI ما يندرج ضمن الفئة النشطة:
- الوقت الذي يتحدث فيه المستخدم أو النموذج.
- الصمت قبل انتهاء مهلة الخمول.
- الوقت المنتظر فيه عمل النظام الخلفي بينما الاستدلال قيد التشغيل.
كتم الميكروفون لا يفعّل وضع الاستعداد؛ فالجلسة تستمر في الفوترة بمعدل 0.05 دولار لكل دقيقة.
يتطلب وضع الاستعداد إعدادين عند إنشاء الجلسة، موثّقين في دليل المحادثات المباشرة:
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 15
  }
}
wake_policy.type: "speech" يخبر الجلسة بانتظار الكلام قبل بدء الاستدلال. أما idle_timeout_s فيأخذ رقمًا صحيحًا من 5 إلى 60 ويعيد الجلسة إلى وضع الاستعداد بعد ذلك العدد من الثواني دون نص مدخل أو مخرج. إذا حذفت المهلة، يبقى الاستدلال نشطًا حتى تنتهي الجلسة، فلن تحصل على سعر الاستعداد أبدًا.
ملاحظتان مهمتان: وضع الاستعداد يعمل عبر WebRTC فقط، لذا تُفوتر جلسات WebSocket وSIP كل ثانية اتصال بالمعدل النشط، كما أن الرد الأول بعد الاستعداد قد يستغرق وقتًا أطول.
أمثلة عملية على التكاليف
معدلات الصوت هي المعلنة رسميًا، أما أعداد رموز النظام الخلفي فهي افتراضات توضيحية. أسعار النظام الخلفي مصدرها صفحة تسعير OpenAI: gpt-6-luna بـ 0.10 دولار للمدخلات و0.50 دولار للمخرجات لكل مليون رمز، وgpt-6-sol بـ 2.00 دولار للمدخلات و10.00 دولار للمخرجات لكل مليون رمز (الفئة القياسية، السياق القصير). يوصي دليل التفويض من OpenAI بالبدء مع gpt-6-luna وتجربة gpt-6-sol للمهام الخلفية الأصعب.
مثال 1: خط دعم عملاء
مكالمة دعم هاتفية أو عبر WebSocket تستغرق 6 دقائق. وضع الاستعداد لا ينطبق هنا، لذا تُحتسب الدقائق الست كلها كمعدل نشط. يفوّض GPT-Live أربعة استعلامات إلى gpt-6-luna، باستخدام كل منها حوالي 6,000 رمز مدخلات و400 رمز مخرجات.
| البند | الحساب | التكلفة |
|---|---|---|
| الصوت | 6 دقائق × 0.05 دولار | 0.30 دولار |
| مدخلات النظام الخلفي | 24,000 رمز × 0.10 دولار / مليون | 0.0024 دولار |
| مخرجات النظام الخلفي | 1,600 رمز × 0.50 دولار / مليون | 0.0008 دولار |
| لكل مكالمة | 0.3032 دولار |
عند 10,000 مكالمة شهريًا، يكون الإجمالي حوالي 3,032 دولارًا، منها 3,000 دولار لوقت الصوت. تقليص 30 ثانية من متوسط مدة المكالمة يوفر أكثر من فاتورة النظام الخلفي بأكملها.
مثال 2: معلم لغة في المتصفح
جلسة تدريس عبر WebRTC مدتها 30 دقيقة مع ضبط idle_timeout_s على 15. يقضي الطالب فترات طويلة في القراءة والتفكير، لذا تعمل الجلسة 18 دقيقة نشطة و12 دقيقة في وضع الاستعداد. يفوّض المعلم 10 شروحات إلى gpt-6-sol بحوالي 8,000 رمز مدخلات و600 رمز مخرجات لكل منها.
| البند | الحساب | التكلفة |
|---|---|---|
| الصوت النشط | 18 دقيقة × 0.05 دولار | 0.90 دولار |
| الصوت الاحتياطي | 12 دقيقة × 0.02 دولار | 0.24 دولار |
| مدخلات النظام الخلفي | 80,000 رمز × 2.00 دولار / مليون | 0.16 دولار |
| مخرجات النظام الخلفي | 6,000 رمز × 10.00 دولارات / مليون | 0.06 دولار |
| لكل جلسة | 1.36 دولار |
بدون وضع الاستعداد، ستكلف الدقائق الثلاثون نفسها من الصوت 1.50 دولار بدلاً من 1.14 دولار، أي أن وضع الاستعداد يخفض فاتورة الصوت بنسبة 24%.
مثال 3: مساعد سطح مكتب يعمل دائمًا
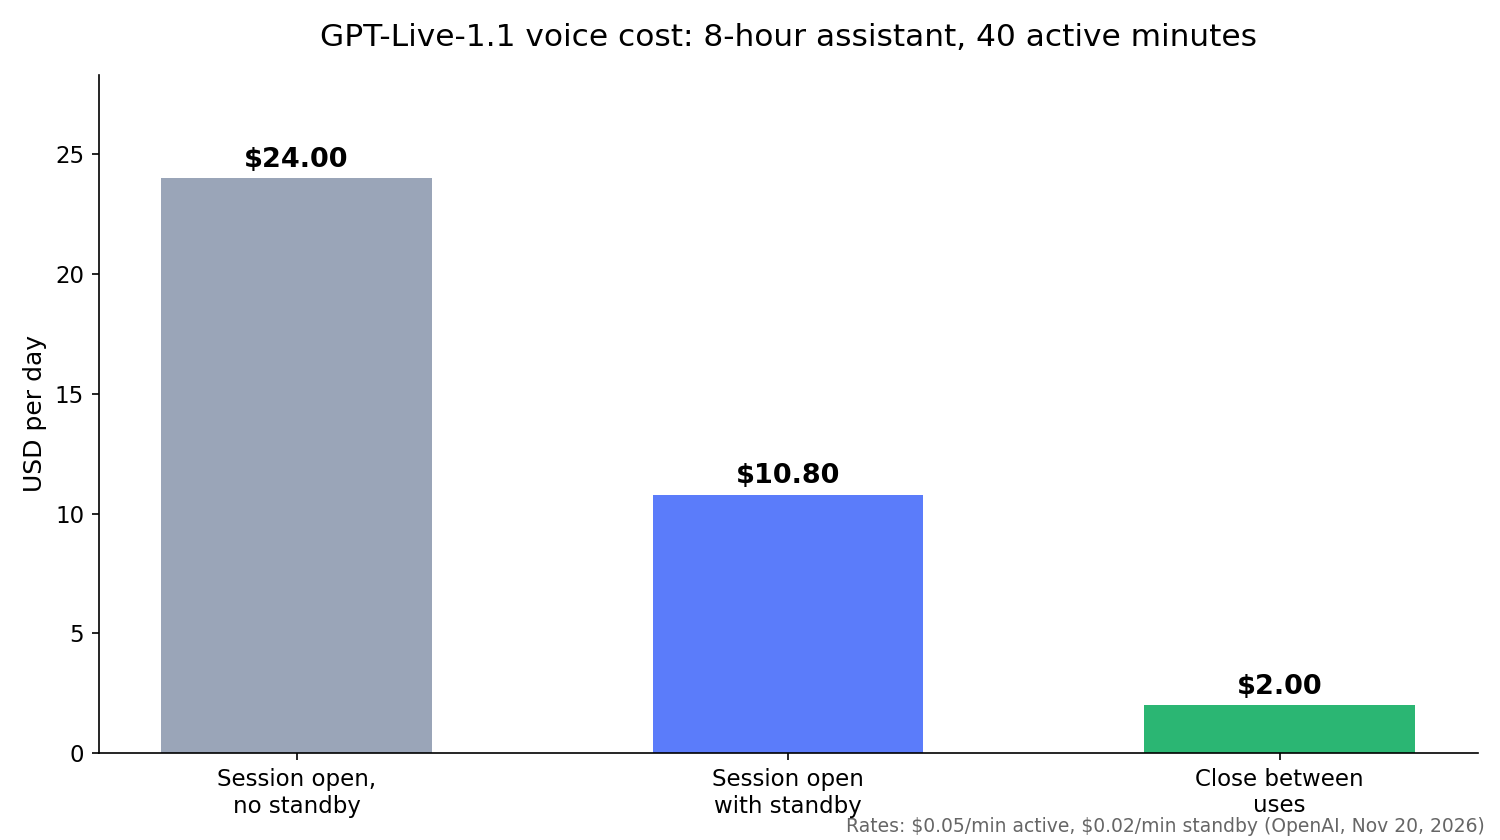
يبقى المساعد مفتوحًا طوال يوم عمل من 8 ساعات، لكن المستخدم يتحدث معه 40 دقيقة فقط على شكل فترات قصيرة. هنا، الاستراتيجية التي تختارها تغيّر الفاتورة بأكثر من 10 أضعاف:
| الاستراتيجية | الحساب | يوميًا | شهريًا (22 يومًا) |
|---|---|---|---|
| جلسة مفتوحة دون استعداد | 480 دقيقة × 0.05 دولار | 24.00 دولار | 528.00 دولار |
| جلسة مفتوحة مع استعداد | 40 × 0.05 دولار + 440 × 0.02 دولار | 10.80 دولار | 237.60 دولار |
| إغلاق الجلسة بين الاستخدامات | 40 دقيقة × 0.05 دولار | 2.00 دولار | 44.00 دولار |
وضع الاستعداد لا يزال يكلف 1.20 دولار لكل ساعة خمول. يوصي دليل OpenAI بإغلاق الجلسة أثناء الفترات الطويلة وبدء جلسة جديدة، مُهيّأة بالسجل المحفوظ، عند عودة المستخدم. رسوم بدء التشغيل البالغة 15 ثانية تُعاد بمجرد تشغيل الجلسة الجديدة، لذا من حيث رسوم الصوت وحدها فإن الإغلاق هو الخيار الأفضل. لكنك تتنازل عن الاستيقاظ الفوري: الجلسة المغلقة لا تسمع المستخدم، لذا تحتاج إلى خاصية الضغط للتحدث أو آلية استيقاظ خاصة بك.
كيف تؤثر مهلة الخمول على فاتورتك
كل توقف يستهلك وقتًا نشطًا حتى تنطلق مهلة الخمول. المهلة الأقصر تصل إلى سعر الاستعداد الأرخص أسرع، لكن ذلك يزيد دورات الإيقاف والاستئناف ويبطئ الرد الأول بعد كل دورة.
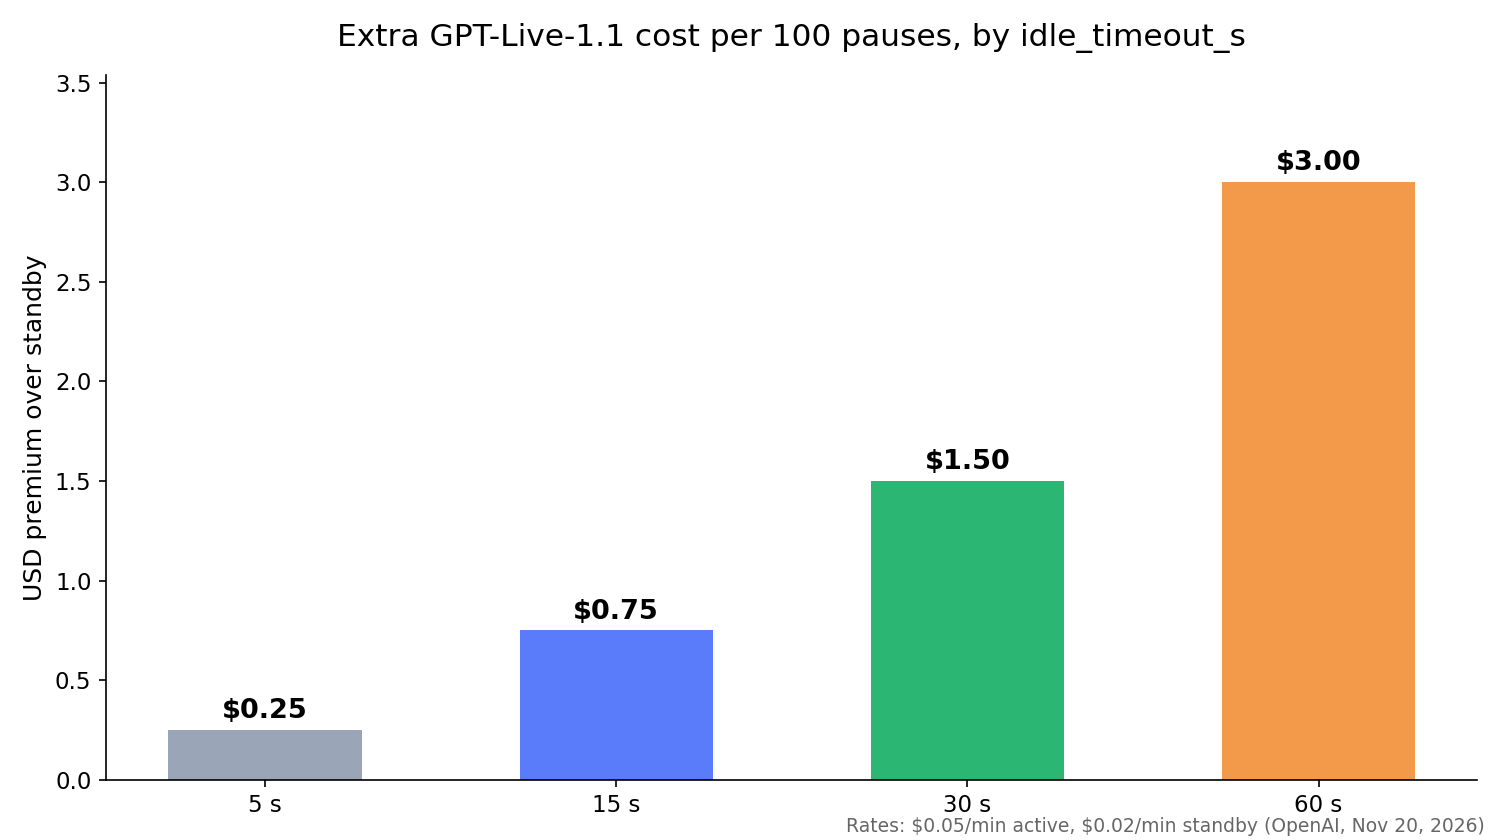
العلاوة لكل توقف هي طول المهلة مُحاسبًا بفارق الـ 0.03 دولار بين المعدلين. على مدى 100 توقف في جلسة واحدة أو في يوم واحد:
idle_timeout_s |
الثواني النشطة لكل توقف | العلاوة على وضع الاستعداد، لكل 100 توقف |
|---|---|---|
| 5 | 5 | 0.25 دولار |
| 15 | 15 | 0.75 دولار |
| 30 | 30 | 1.50 دولار |
| 60 | 60 | 3.00 دولار |
أرقام صغيرة، وهذا هو الغرض: المهلة في جوهرها إعداد متعلق بتجربة المستخدم. اختر قيمة لا تقاطع المستخدمين في منتصف تفكيرهم، ثم دع وضع الاستعداد يغطي الفجوات الطويلة وإغلاق الجلسة يغطي الفجوات الطويلة جدًا.
مقارنة تسعير GPT-Live-1.1 مع GPT-Realtime
يحتسب GPT-Live-1.1 الفوترة بالدقيقة، بينما تُحتسب نماذج GPT-Realtime بالرموز. تدرج صفحة تسعير OpenAI صوت gpt-realtime-2.1 بسعر 32.00 دولار لكل مليون رمز مدخلات و64.00 دولار لكل مليون رمز مخرجات، وصوت gpt-realtime-2.1-mini بسعر 10.00 دولار و20.00 دولار.
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| وحدة الفوترة | ثواني الجلسة | رموز المدخلات والمخرجات |
| معدل الصوت | 0.05 دولار/دقيقة نشطة، 0.02 دولار/دقيقة استعداد | 32 دولار / 64 دولار لكل مليون رمز صوتي |
| الاستدلال والأدوات | نموذج خلفي منفصل | داخل النموذج نفسه |
| منحنى التكلفة | ثابت لكل دقيقة | يرتفع مع كل دورة مع نمو السياق |
يشير دليل التكاليف من OpenAI إلى أن جلسة Realtime ترسل المحادثة بأكملها إلى النموذج عند كل رد، مما يجعل الدورات اللاحقة أغلى. أما دقيقة GPT-Live فتكلف الشيء نفسه في الدقيقة الثانية والدقيقة الأربعين، مما يجعل التنبؤ بالتكاليف أمرًا بسيطًا. يغطي دليل واجهة برمجة GPT-Realtime-2 API لدينا الإعدادات المعتمدة على الرموز.
تتبّع الاستخدام وتجنّب الفواتير المفاجئة
يُبلغ GPT-Live عن الاستخدام الصوتي التراكمي بالثواني عبر أحداث session.usage.updated:
{
  "type": "session.usage.updated",
  "usage": { "seconds": 12 },
  "context_window": { "usage_ratio": 0.42 }
}
كل تحديث يستبدل الإجمالي السابق، لذا لا تجمعها أبدًا. أرسل session.close، وانتظر session.closed، وسجّل قيمة usage.seconds النهائية. وللتفريق بين الوقت النشط والاحتياطي، احسب الفترات بين أحداث session.paused وsession.resumed.
عادات تُبقي التكاليف ثابتة:
- أغلق الجلسات المنتهية. الجلسة المفتوحة المهجورة تستمر في الفوترة.
- تسريع النظام الخلفي. انتظار مهمة مفوّضة هو وقت نشط؛ كل دقيقة تُنجَز فيها المهمة أسرع توفر 0.05 دولار.
- أغلق الجلسة أثناء المهام الطويلة. أغلق الصوت أثناء عمل النظام الخلفي وأعد فتحه عند جاهزية النتيجة.
- خطط للتزامن. تُحتسب الحدود بحسب الجلسات المتزامنة، وGPT-Live-1.1 له حد منفصل عن GPT-Live-1، الذي تبلغ حده المعلن 50 (Build) و300 (Launch) و500 (Grow). لا يدعم الفئة المجانية.
دع Codex يختبر سجل التكاليف لديك عبر Apidog CLI
سجل الاستخدام لديك هو كود تملكه، وأي خطأ فيه يُسعّر كل مكالمة بشكل خاطئ. اختبره عند كل التزام (commit) دون فتح جلسة صوتية، بتكلفة صفرية في وقت الصوت، ودع وكيل البرمجة لديك يشغّل الاختبارات عبر Apidog CLI.
ثبّت واجهة CLI، وسجّل الدخول، وأضف مهارة Apidog إلى وكيلك:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
ثم امنح Codex أمرًا واحدًا:
In Apidog project <projectId>, create a test case for POST /api/voice-usage.
Send {"session_id":"test-1","active_seconds":90,"standby_seconds":30} and assert
the response cost is 0.085 (90 s at $0.05/min plus 30 s at $0.02/min).
Add a second case with standby_seconds 0 that expects 0.075. Run both against
the local environment and summarize any failures.
يقرأ الوكيل المخطط (schema)، ويتحقق من صحة حمولته، وينشئ حالات الاختبار ويشغّلها:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
استبدل -r cli,json بـ -r junit وستُدمج العملية نفسها في خط CI؛ راجع تشغيل Apidog CLI في خط CI/CD. يغطي دليل Apidog CLI في Codex إعداد الوكيل. تغطي الخطة المجانية من Apidog فرقًا تصل إلى 4 مستخدمين.
الأسئلة الشائعة
كم تكلف GPT-Live-1.1 لكل دقيقة؟ 0.05 دولار لكل دقيقة نشطة و0.02 دولار لكل دقيقة استعداد، وتُحتسب بالثانية. استخدام النظام الخلفي يُحسب بشكل إضافي.
هل GPT-Live-1.1 أغلى من GPT-Live-1؟ لا. تُدرج OpenAI كليهما بنفس المعدلات النشطة والاحتياطية.
هل يعمل وضع الاستعداد في المكالمات الهاتفية؟ لا. ينطبق سعر الاستعداد الأدنى فقط على جلسات WebRTC أثناء توقف الاستدلال. تُفوتر جلسات WebSocket وSIP وقت الاتصال بالمعدل النشط.
هل استدعاءات النموذج الخلفي مشمولة في السعر لكل دقيقة؟ لا. تُفوتر استدعاءات Responses المفوّضة بأسعار رموز النموذج المختار، بالإضافة إلى رسوم الأدوات.
ماذا حدث لسؤال واجهة GPT-Live API في يوليو؟ في ذلك الوقت كان GPT-Live ميزة صوتية في ChatGPT دون واجهة API، كما أوضح شرحنا لواجهة GPT-Live API حينها. أما GPT-Live-1.1 فهو نموذج الواجهة، ويُخدم عبر v1/live/sessions.