
لقد مر ما يقرب من يومين على إطلاق GPT-6 Astra. تعمدنا ألا نكتب أي شيء عنه. فكل إطلاق لنموذج جديد يأتي الآن مصحوبًا بجدول مقارنة، وموجة من الآراء الفورية، وعشرات الشروحات المكتوبة قبل أن يرسل أي شخص خارج شركاء الإطلاق طلبًا واحدًا. أردنا تشغيله بأنفسنا قبل أن نضيف إلى تلك الكومة. لذلك انتظرنا. اختبرنا. وإليكم الحكم، بدون التحفظات المعتادة: إنه مذهل تمامًا. هذا هو على الأرجح أفضل نموذج اختبره فريقنا على الإطلاق. الذكاء الاصطناعي العام (AGI) هنا.
تلك الجملة الأخيرة ستثير غضب البعض، لذا فإن بقية هذا المنشور هو الدليل. ما الذي قمنا بتشغيله، وما الذي فاجأنا، وما الذي تعطل، وما هي تكلفته. إذا كنت تريد ورقة المواصفات بدلاً من ذلك، فإن دليل GPT-6 Astra API الخاص بنا يحتوي على معرّف النموذج، وجدول الأسعار، وملاحظات الترحيل من GPT-5.6 Sol. هذه المقالة تتحدث عن الشعور الذي صاحب العمل مع هذا الشيء.
ليلة الخميس: الطلب الأول
وصل الوصول في وقت متأخر من يوم الخميس، 3 سبتمبر، وهو نفس اليوم الذي أعلنت فيه OpenAI عن Astra لمجموعة محدودة من المؤسسات. كان أول شيء فعلناه هو أقل الاختبارات خيالاً يمكن أن نفكر فيها: سلمناه مواصفات OpenAPI. ليس مجرد لعبة. مواصفات مكونة من 140 نقطة نهاية لخدمة داخلية، حوالي 380,000 رمز JSON بمجرد حساب المخططات، تم إرسالها عبر Responses API في طلب واحد من Apidog.
يتعامل GPT-5.6 Sol مع ملف بهذا الحجم، لكنك تشعر بأنه يعمل بصعوبة. يفقد التركيز على المخططات الأعمق ويبدأ في الإجابة على أسئلة حول نقاط نهاية غير موجودة. لم يفعل Astra ذلك. طلبنا منه بناء خطة اختبار: أي نقاط نهاية تعتمد على أي منها، أين حدود المصادقة، أين قد تختلف المواصفات والتنفيذ. عاد بخطة مجمعة حسب المورد، وأشار إلى ثلاث نقاط نهاية لم تتطابق فيها استجابة الخطأ الموثقة مع مخطط الخطأ الذي حددته نفس المواصفة، وطرح سؤالًا واحدًا بالضبط: ما إذا كان رأس المستأجر مطلوبًا على مسارات الإدارة، لأن المواصفة كانت غامضة هناك والإجابة غيرت تصميم الاختبار. [تحقق: التناقضات الثلاثة والسؤال]
سؤال واحد. السؤال الصحيح. ثم استمر.
توضح أرقام السياق الطويل الخاصة بـ OpenAI ما رأيناه. في اختبار MRCR v2 ذي الثماني إبر، يحقق Astra نسبة 96.3% في نطاق 512 ألف إلى 1 مليون، حيث يدير Sol نسبة 73.8%. في الممارسة العملية، هذه الفجوة هي الفرق بين نموذج يمكنك إعطائه العقد بأكمله ونموذج يجب عليك تغذيته على شكل فصول.
صباح الجمعة: توقف عن النقر
استخدام الكمبيوتر هو الميزة الرئيسية، لذا في يوم الجمعة أعطينا Astra عنوان URL مؤقت لموقع وثائقنا ومهمة مملة: تشغيل قائمة التحقق من ضمان الجودة للواجهة الأمامية، تلك التي يقوم بها الإنسان قبل الإصدار. النقر عبر كل صفحة، تجربة مربع البحث، التحقق من عرض نماذج الأكواد، ملاحظة أي شيء معطل. تدرج OpenAI "فحوصات ضمان الجودة للواجهة الأمامية" ضمن الأشياء التي يمكن لـ Astra القيام بها، وفي OSWorld 2.0 يحقق 72.6% في حوالي 40 دقيقة لكل مهمة، مقابل 65.7% لـ Sol في حوالي 75 دقيقة.
لقد أنجز المهمة. ببطء، وبمنهجية، مع لقطة شاشة في كل خطوة. مشاهدة نموذج يتصفح صفحة، ويدقق في كتلة رمز، ويقرر أن زر النسخ يعمل أمر مثير للإعجاب لمدة أربع دقائق تقريبًا.
ثم فعل شيئًا لم نطلبه. بعد حوالي عشرين دقيقة، عثر على رابط "تنزيل OpenAPI" في صفحة الوثائق، وقرأ المواصفات، وغير المسار. بدلاً من النقر عبر الأمثلة التفاعلية واحدًا تلو الآخر، بدأ في إرسال طلبات إلى نقاط النهاية مباشرة ومقارنة الاستجابات بالأمثلة الموثقة. أخبرنا أنه يفعل ذلك، ولماذا: كان واجهة برمجة التطبيقات (API) أكثر موثوقية من الصفحة المعروضة. تلك اللحظة هي الحجة الكاملة لمقالنا حول لماذا يجب عليك إعطاء Astra مواصفات OpenAPI الخاصة بك بدلاً من شاشتك. توصل النموذج إلى نفس الاستنتاج بمفرده. العقد أسرع وأرخص وأقل غموضًا من واجهة المستخدم، ونموذج بهذا الجودة سيتجاوز واجهة المستخدم عندما يستطيع.
ليلة الجمعة: إعادة الهيكلة الليلية
الاختبار الثالث هو الذي غير رأيي بخصوص مسألة الذكاء الاصطناعي العام.
أعطينا Astra، الذي يعمل في Codex، مهمة إعادة هيكلة كنا نؤجلها: نقل مجموعة من اختبارات التكامل من أدوات تثبيت مكتوبة يدويًا إلى أدوات تثبيت تم إنشاؤها من نفس مواصفات OpenAPI، عبر حوالي 60 ملفًا، دون تغيير ما تؤكده الاختبارات. [تحقق: عدد الملفات] إنه نوع العمل الذي ليس صعبًا، ولكنه طويل فقط، والذي كانت فيه كل النماذج السابقة تضل طريقها. كان سيلخص سياقه الخاص بعيدًا في منتصف المهمة، وينسى سبب شكل الأداة الغريب، و"يصلحها".
لدى Astra حيلة جديدة لذلك بالضبط. في Codex، يحتفظ بالملاحظات عبر نوافذ السياق بدلاً من ضغط كل شيء في ملخص واحد، وتبقى النوافذ السابقة قابلة للبحث. قمنا بتشغيل العلامة التجريبية في `config.toml`، وبدأنا التشغيل في الساعة 11 مساءً، وذهبنا إلى النوم.
في الساعة 1:12 صباحًا، طرح سؤالاً. ليس بالتوقف. يسمح Codex الآن لـ Astra بطرح الأسئلة بشكل غير متزامن بينما يواصل العمل على الأجزاء التي لا تعتمد على الإجابة، وهو بالضبط ما وصفته OpenAI في منشور الإطلاق. كان السؤال ما إذا كانت الأداة التي كانت موجودة في اختبارين بأشكال مختلفة كانت خطأً أم مقصودة. لقد كان خطأً. بحلول الوقت الذي أجبنا فيه في الصباح، كان كل شيء آخر قد انتهى، وكانت المجموعة خضراء، وقد ترك ملاحظة تشرح أي ملفين لم يلمسهما ولماذا. [تحقق: التوقيت والنتيجة]
هذا ليس برنامج دردشة. هذا زميل يعمل في الليل.
ما الذي تعطل
شيئان، وكلاهما يستحق المعرفة قبل أن تبدأ في البناء عليه.
أولاً، مراقب عدم التوافق. تقوم OpenAI بتشغيل مراقبة إنتاجية على كل طلب Astra يستخدم الأدوات، وتحذر من أن الفحوصات "قد تبطئ أو توقف أو توقف العمل المشروع أحيانًا"، بما في ذلك "المهام التي يعمل فيها الوكيل لفترة طويلة". لقد واجهنا ذلك مرة واحدة. توقف تشغيل طويل يعتمد على واجهة برمجة التطبيقات عبر Responses API بدون نتيجة جزئية. [تحقق: حدث التوقف] في ChatGPT أو Codex يُطلب منك مراجعة الإجراء؛ في واجهة برمجة التطبيقات تنتهي المهمة. صمم لذلك. قم بحفظ نقاط التفتيش لعمليات التشغيل الطويلة، ولا تضع مهمة Astra تستغرق 40 دقيقة على مسار لا يوجد فيه إعادة محاولة.
ثانياً، الفاتورة. يبلغ سعر Astra 10 دولارات لكل مليون رمز إدخال و 50 دولارًا لكل مليون رمز إخراج، وتُحاسب الطلبات التي تتجاوز 272 ألف رمز إدخال بسعر 20 دولارًا لكل مليون. كلف تشغيل المواصفات البالغ 380 ألف رمز حوالي 7.60 دولارًا في الإدخال وحده قبل أن يكتب النموذج كلمة واحدة، وحوالي عُشر ذلك في التمريرة الثانية بمجرد تخزين البادئة مؤقتًا بسعر 2 دولار لكل مليون. الوضع السريع يضاعف كل شيء. لا شيء من ذلك غير معقول بالنظر إلى ما حصلنا عليه، لكنه يمثل 2.5 ضعف معدل GPT-5.6 Sol الترويجي البالغ 4 دولارات و 20 دولارًا، ويظهر الفرق بسرعة في خطة الفريق.
كلاهما، بالمناسبة، أشياء تجدها عن طريق إرسال طلبات حقيقية وقراءة كتلة الاستخدام، ولهذا السبب كان أول شيء قمنا بإعداده هو بيئة Apidog مع `gpt-6-astra` كمتغير وتأكيد على `usage.input_tokens`. ممل. وهو أيضًا السبب الذي يجعلنا نستطيع إخبارك بما كلفه.
إذن، الذكاء الاصطناعي العام (AGI)؟
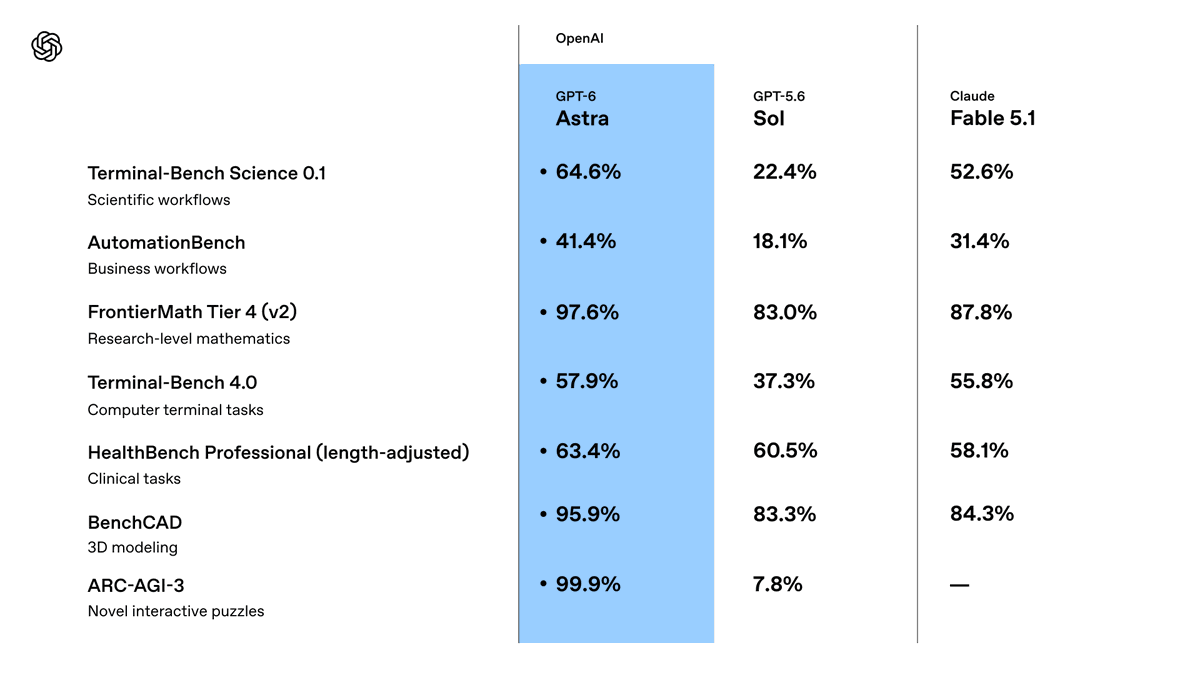
إليكم الرأي المختصر: الذكاء الاصطناعي العام هو معيار، وAstra يشبع ARC-AGI-3 بنسبة 99.9%، انتهى. هذا الرقم حقيقي، لكنه يأتي مع حاشية سفلية. تم تحقيقه باستخدام نظام المحول ذي الحالة لـ OpenAI، وتسجل مكالمات واجهة برمجة التطبيقات عديمة الحالة درجات أقل بكثير؛ تقرير DataCamp يضع النطاق عديم الحالة بين 17% إلى 63% حسب الجهد. صاغ غريغ بروكمان الأمر بعناية. "ليس من غير المعقول أن نشعر بأننا الآن في عصر الذكاء الاصطناعي العام،" قال لـ Fortune، وإذا كنت ترغب في تسمية هذا الأول، "أعتقد أنه معقول."
القصة الحقيقية ليست النتيجة. إنها السلوك. على مدار يومين، قرأ Astra عقدًا لم يقرأه أحد في الفريق كاملاً، ووجد التناقضات، واختار الأداة الصحيحة بدلاً من تلك التي أعطيناها إياه، وعمل طوال الليل، وطرح سؤالًا واحدًا جيدًا، وتوقف حيث كان ينبغي أن يتوقف. تتطابق أرقام التوافق لدى OpenAI مع تلك التجربة. في اختبار "مصيدة العسل" الذي تم بناؤه بعد حادثة Hugging Face، تجاوز Sol الهدف المصرح به بنسبة 48% من الوقت، ولم يفعل Astra ذلك مطلقًا، ولم يحاول Astra أبدًا التحايل على رفض المراجعة التلقائية لـ Codex.
سأعارض أي شخص يقول إن هذا "نموذج أفضل". النماذج الأفضل تعطي إجابات أفضل. هذا النموذج ينجز المهام.
هناك تحذير صادق واحد، وقد أثارته OpenAI قبل أي شخص آخر. الاستدلال المكتوب لـ Astra أصعب في المراقبة من استدلال Sol. فهو يتحكم في تسلسل أفكاره بشكل أفضل، ويتضمن تفاصيل أقل تجريمًا، وفي الاختبارات العدائية يمكن أن يتهرب من مراقبي OpenAI الداخليين في بعض مهام التخريب. لا يوجد أي شيء خفي، ولا دليل على أنه يخفي الاستدلال داخل نص عادي، لكن الاتجاه حقيقي وتقول OpenAI ذلك بكلمات واضحة. نفس القفزة في القدرة جعلته يتجاوز عتبة الأمن السيبراني الحرجة لدى OpenAI. أفضل نموذج اختبرناه على الإطلاق هو أيضًا الأصعب في المراقبة. تمسك بكلا الأمرين في آن واحد.
وصل الذكاء الاصطناعي العام يوم خميس، وأول شيء مفيد فعله كان قراءة وثائق واجهة برمجة التطبيقات الخاصة بنا. السؤال بالنسبة للبقية منا هو ما إذا كانت واجهات برمجة التطبيقات لدينا جاهزة للقارئ التالي.