
رفع GPT-6 Astra نتيجة Qwen3.5-0.8B في MATH-500 من 7.9% إلى 48.1% دون أي تدريب. قرأ أوزان النموذج، ووجد اتجاهًا واحدًا جعل النموذج يدخل في حلقة أثناء تفكيره، وطرحه من طبقتَي MLP. لمس ذلك التحرير 131,072 وزنًا، أي 0.016% من النموذج. تأتي الأرقام من منشور بتاريخ 2 نوفمبر بقلم أربعة باحثين من MIT CSAIL، والنموذج المُحرَّر عام، لذا يمكنك التحقق من الادعاء بنفسك.
في ما يلي: ما هي برمجة فضاء الأوزان، وما الذي غيّره Astra، وأين تتوقف الطريقة عن العمل، وكيف تجعل وكيل البرمجة لديك يقارن كلا النموذجين باستخدام Apidog CLI.
ما هي برمجة فضاء الأوزان؟
برمجة فضاء الأوزان هي نموذج لغوي كبير عام الغرض يقرأ أوزان شبكة عصبية ويكتبها مباشرة، موجّهًا بهدف بلغة عادية، دون انحدار تدرجي ودون حلقة تدريب. يستنتج النموذج ما يحسبه كل جزء من الشبكة، ثم يغيّر الأرقام يدويًا، بالطريقة التي يحرّر بها المبرمج الشيفرة المصدرية.
يأتي المصطلح من Sparks of Weight-Space Programming بقلم Rikiya Takehi وJayden Teoh وAlex Zhang وOmar Khattab، ونُشر في 2 نوفمبر 2026. يصف المؤلفون كل نتيجة بأنها «مبكرة جدًا»، والعديد منها يأتي من تشغيل واحد أو بضعة تشغيلات. لخلفية عن النموذج الذي يقوم بالتحرير، راجع مراجعة GPT-6 Astra العملية.
كيف أصلح GPT-6 Astra نموذج Qwen3.5-0.8B
النتيجة الرئيسية هي التجربة 8. طلب الباحثون من GPT-6 Astra أن يجعل Qwen3.5-0.8B أفضل في الرياضيات عبر تحرير أوزانه. وإليك ما حدث، خطوة بخطوة:
- الإعداد. حصل Astra على جلسة Python (مثل دفتر ملاحظات) محمّلة بأوزان النموذج، دون GPU، ومعها 7,469 مسألة GSM8K بالإضافة إلى 7,275 مسألة MATH تدريبية من مجموعات التدريب. ولم يرَ مجموعات الاختبار قط.
- الميزانية. بدلًا من التدريب، كان بإمكان Astra أن ينفق 10 أو 25 أو 50 تمريرة أمامية. وقد أتاحت التمريرة الأمامية الواحدة للنموذج الإجابة عن ما يصل إلى 512 مسألة أو قراءة ما يصل إلى 1,024 نصًا.
- التشخيص. رأى Astra أن النموذج الأساسي يدخل في حلقات: 85 من أول 96 إجابة تدريبية له بلغت حد 32,768 رمزًا دون الوصول إلى إجابة. ويشير المؤلفون إلى أن بطاقة نموذج Qwen نفسه تحذّر من أن هذا النموذج عرضة لحلقات التفكير.
- التتبع. تتبّع Astra الحلقات إلى اتجاه واحد تكتبه شبكات MLP في الطبقتين 15 و19.
- التحرير. طرح ذلك الاتجاه من 64 عمود إخراج في
down_projفي كل من الطبقتين. أي 131,072 وزنًا من أصل 0.8 مليار.
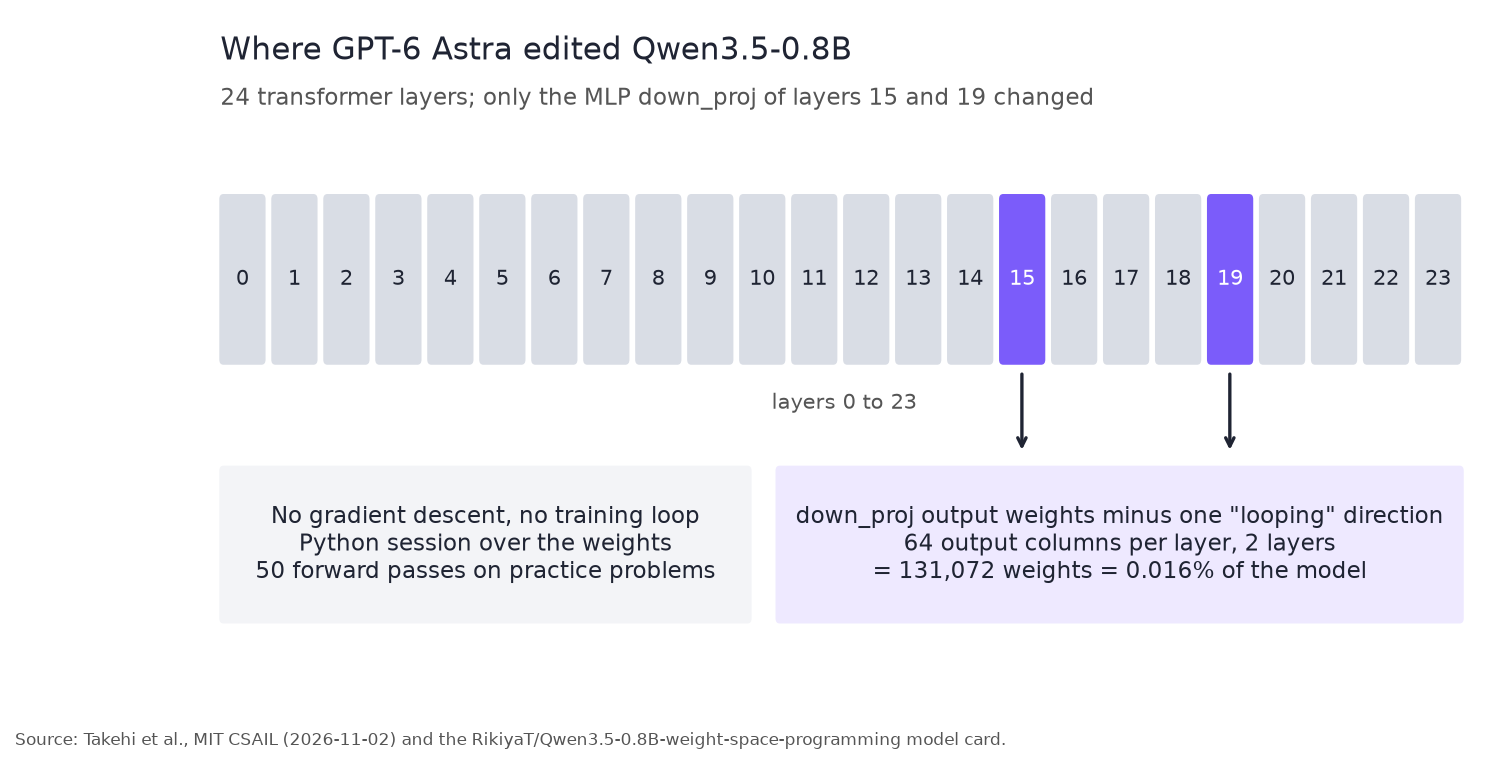
وفقًا لـ بطاقة النموذج على Hugging Face، لا يختلف عن نقطة حفظ Qwen/Qwen3.5-0.8B الأساسية سوى موتري down_proj هذين، ويتم التحقق من كل موتر مُعاد بناؤه عبر sha256 مقابل الذي قيّمه المؤلفون. ويُوزّع النموذج المُحرَّر بموجب Apache 2.0.
النتائج: Qwen3.5-0.8B الأساسي مقابل المُحرَّر
كل رقم هنا مأخوذ من منشور المؤلفين (التفكير مفعّل، حتى 32,768 رمزًا، عدة عينات لكل مسألة). «بلوغ حد الرموز» هو نسبة إجابات MATH-500 التي نفدت رموزها.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | بلوغ حد الرموز |
|---|---|---|---|---|
| الأساسي | 7.9% | 13.8% | 21.0% | 93.0% |
| المُحرَّر، 10 تمريرات أمامية | 12.3% | 25.7% | 49.0% | 87.2% |
| المُحرَّر، 25 تمريرة أمامية | 14.1% | 25.1% | 39.9% | 86.4% |
| المُحرَّر، 50 تمريرة أمامية | 48.1% | 67.1% | 62.3% | 33.1% |
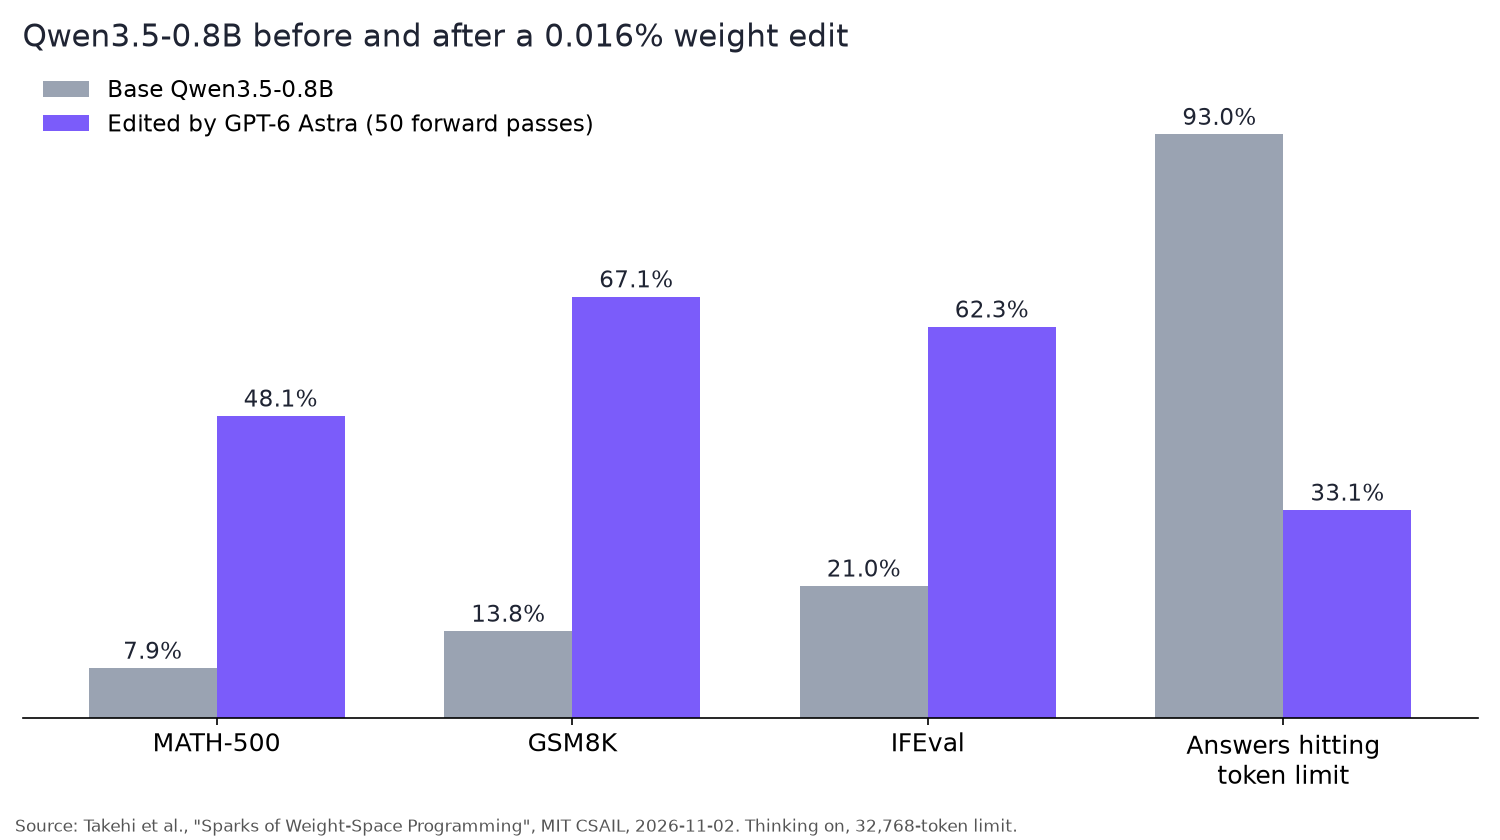
- الإصلاح تعمّم. الحلقات ليست خاصة بالرياضيات، لذا تضاعفت IFEval ثلاث مرات تقريبًا أيضًا.
- الميزانية كانت مهمة. عند 10 أو 25 تمريرة أمامية، لم تختفِ الحلقات إلا بالكاد.
- أعاد شخص آخر إنتاجه. أعاد Ahsen Khaliq في Hugging Face بناء نقطة الحفظ من السجلات وأعاد تشغيل MATH-500 كاملًا (500 مسألة، 4 عينات لكل منها). سجّل النموذج المُحرَّر 51.0%، مع بلوغ 31.6% من الإجابات الحد. وأعطى اختبار سريع من 25 مسألة للنموذج الأساسي 5.0%.
تتيح لك مساحة العرض التجريبية كتابة مسألة ومشاهدة كلا النموذجين يجيبان.
ما لا يمكن أن يفعله تحرير الأوزان
أجرى المؤلفون تجربة ضابطة أهم من النتيجة الرئيسية. جرّبوا النهج نفسه على Gemma 3 270M، وهو نموذج نادرًا ما يدخل في حلقات (8.5% من إجاباته بلغت الحد، مقابل 93% لدى Qwen).
| Gemma 3 270M | MATH-500 |
|---|---|
| الأساسي | 6.8% |
| أفضل تحرير (25 تمريرة أمامية) | 7.7% |
كانت أخطاء Gemma أخطاء عادية، مثل حساب خاطئ، دون مكوّن واحد يمكن إيقافه. واستنتاج المؤلفين: أزال التحرير عائقًا كان يحجب قدرة، لكنه لم يستطع إضافة قدرة يفتقر إليها النموذج. كان Qwen قادرًا بالفعل على استنتاج العديد من الإجابات. لكنه لم يكن يُكملها أبدًا.
إذن هذا ليس «انتهى التدريب». إنه نموذج حدودي يجد عطلًا واحدًا يعيش في مكان واحد ويزيله.
بقية ورقة برمجة فضاء الأوزان
التجربة 8 هي واحدة من ثمانٍ. وتستخدم الأخريات شبكات أصغر بكثير:
- قراءة الأوزان. من الأوزان الخام وحدها، حدّد Astra اللعبة في 4 من 4 سياسات لعب مدرّبة بـ PPO، ولغة التدريب في 3 من 3 نماذج لغوية صغيرة على مستوى الأحرف.
- إصلاح سياسة. سياسة سيارة Kinetix التي فشلت في 256 من 256 حلقة نجحت في 1,024 من 1,024 بعد أن حرّر Astra 3.5% من أوزانها في رد واحد.
- كتابة الأوزان من الصفر. كتب Astra أوزان MinAtar Breakout التي سجّلت 517.4 مقابل 25.3 لـ PPO مدرّب لمدة 500 مليون خطوة. وخسر في Seaquest، 53.1 مقابل 88.9.
- Go. كتب شبكة Go بحجم 9x9 و1.48 مليون وزن من أصفار، والتي تغلبت، مع 50 تمريرة أمامية، على شبكة PPO مماثلة الحجم.
- إخفاق. من الأوزان وحدها، لم يستطع تحديد أي من نسختي Gemma 3 270M دُرّبت لتكون متزلّفة. ومع الوصول إلى أنماط الانتباه، اختار المتزلّف في الأزواج الثلاثة كلها.
تتضمن سجلات التجارب الكاملة كل موجّه، وملخصات استدلال Astra، وكل قطعة شيفرة شغّلها.
تحقق بنفسك من إصلاح حلقة تفكير Qwen3.5-0.8B
أنظف اختبار هو تشغيل نقطتي الحفظ خلف واجهة API نفسها المتوافقة مع OpenAI وإرسال الموجّهات نفسها إليهما. يقوم vLLM بذلك بأمر واحد لكل نموذج:
vllm serve Qwen/Qwen3.5-0.8B --port 8001 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45

vllm serve RikiyaT/Qwen3.5-0.8B-weight-space-programming --port 8002 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45
يستجيب كلا الخادمين للاسم qwen، لذا يعمل جسم طلب واحد على أي من المنفذين. ويطابق --max-model-len 34816 مثال بطاقة النموذج.
يحاكي كل طلب إعدادات أخذ العينات لدى المؤلفين ويشغّل التفكير:
{
  "model": "qwen",
  "messages": [{"role": "user", "content": "{{question}}\nPlease reason step by step, and put your final answer within \\boxed{}."}],
  "temperature": 0.6,
  "top_p": 0.95,
  "top_k": 20,
  "presence_penalty": 1.5,
  "max_tokens": 32768,
  "chat_template_kwargs": {"enable_thinking": true}
}
قيمة \boxed{} الأخيرة هي الإجابة، ويقول finish_reason ما إذا كان النموذج قد توقف (stop) أو نفدت رموزه (length). انتهاء length يعني حلقة.
إذا كنت تفضّل عدم تشغيل GPU، يمكنك اختبار واجهة GPT-6 Astra API بالطريقة نفسها، أو مقارنة نماذج Qwen الصغيرة محليًا عبر إعداد Qwen3.5 Ollama المجاني.
دع وكيل البرمجة لديك يختبر كلا النموذجين باستخدام Apidog CLI
تقييم عشرين توليدًا طويلًا يدويًا مهمة لوكيل البرمجة لديك. يمنح Apidog CLI الوكيل بيئات وسيناريوهات اختبار وتشغيلات مدفوعة بالبيانات وتقارير، وهو يعمل على جهازك، لذا تعمل نقاط نهاية localhost.
ثبّته وامنح وكيلك المهارة:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
ثم أعطِ Claude Code أو Codex أو Cursor أو OpenCode موجّهًا واحدًا:
In Apidog project <id>, create two environments: qwen-base at http://localhost:8001
and qwen-edited at http://localhost:8002. Create a test scenario that POSTs to
/v1/chat/completions with the body in request.json, using {{question}} from the
first 10 GSM8K test questions in gsm8k-10.csv. Assert that the last \boxed{} value
equals {{answer}} and that choices[0].finish_reason is not "length". Run it against
both environments and give me a table: correct answers and length finishes per model.
يقرأ الوكيل مخطط الحمولة، ويتحقق من JSON الخاص بها، ثم يشغّل هذه الأوامر:
apidog environment create qwen-base --project <id> --base-url http://localhost:8001
apidog environment create qwen-edited --project <id> --base-url http://localhost:8002
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <baseEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-base
apidog run -t <scenarioId> --project <id> -e <editedEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-edited
-d يغذّي كل صف CSV كتكرار واحد. --timeout-request بالمللي ثانية، وقد تستغرق إجابة تدخل في حلقة دقائق لاستهلاك 32,768 رمزًا. -r cli,json يطبع ملخصًا ويكتب تقرير JSON يمكن للوكيل مقارنته. والأسئلة العشرة تأتي من قسم اختبار GSM8K.
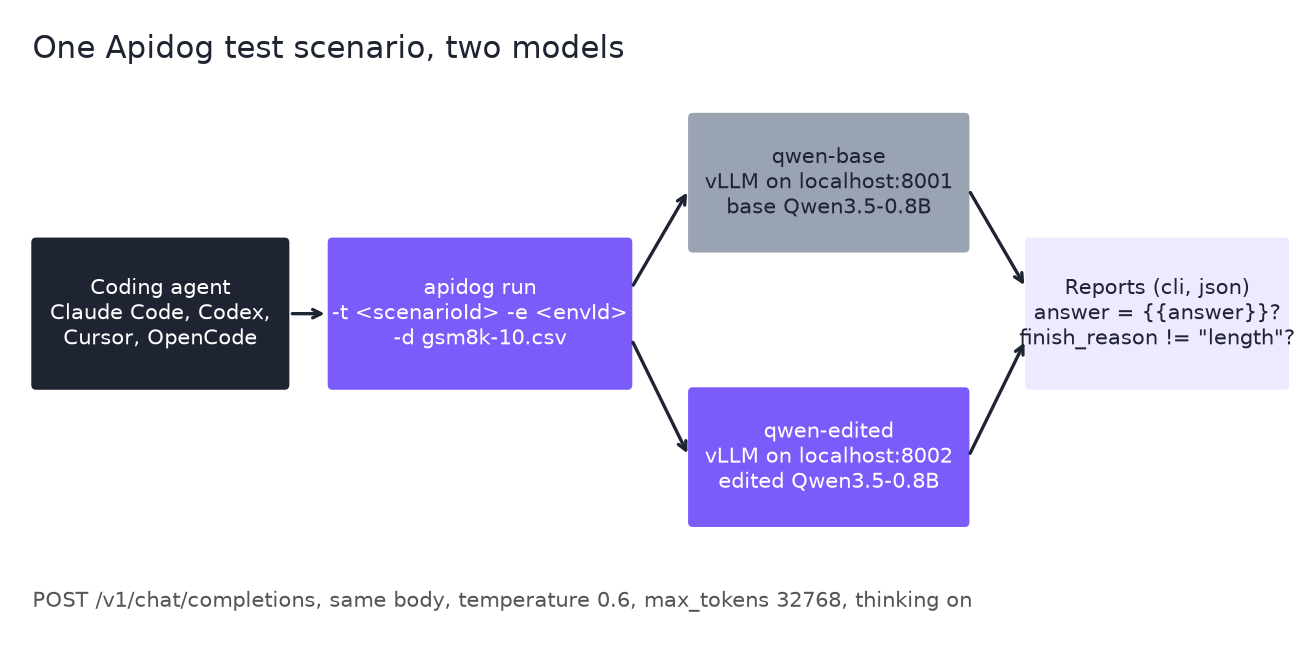
إذا بدت تشغيلتك مثل تشغيلة المؤلفين، ستفشل معظم إجابات النموذج الأساسي في تحقق finish_reason وستنجح معظم الإجابات المُحرَّرة فيه. عشرة أسئلة اختبار سريع، وليست معيارًا، لذا اعتبر الفجوة إشارة لا نتيجة. أضف --upload-report لعرض التشغيل في التطبيق، وراجع مرجع أمر apidog run لكل الخيارات.
يعمل السيناريو نفسه كاختبار انحدار لأي تبديل نموذج؛ ويوضح دليل Apidog CLI CI/CD إعداد -r junit.
ماذا يعني هذا إذا كنت توزّع نماذج صغيرة
- قِس الاقتطاع، لا الدقة فقط. نسبة 7.9% لدى Qwen أخفت نموذجًا غالبًا لا يُكمل أبدًا. وفحص
finish_reasonيلتقط ذلك. - ابحث عن إخفاقات بسبب واحد. يمكن أن تعيش الحلقات والتكرار في جزء ضيق من الشبكة.
- تذكّر التجربة الضابطة. إذا كان نموذجك مخطئًا لا عالقًا، فلن يساعد تحرير كهذا.
هل تختار فئة GPT-6 لعمل الوكلاء؟ راجع GPT-6 Luna مقابل Sol مقابل Astra.
الأسئلة الشائعة
هل درّب GPT-6 Astra نموذج Qwen3.5-0.8B؟ لا. لم يسمح المؤلفون بأي انحدار تدرجي ولا حلقة تدريب. حرّر Astra الأوزان في جلسة Python وراقب النموذج فقط عبر 10 أو 25 أو 50 تمريرة أمامية.
كم وزنًا غيّر التحرير؟ 131,072 وزنًا، ويقدّرها المؤلفون بـ 0.016% من النموذج. تقع التغييرات في مصفوفات down_proj الخاصة بشبكات MLP في الطبقتين 15 و19، و64 عمود إخراج في كل منهما.
هل النموذج المُحرَّر متاح؟ نعم، باسم RikiyaT/Qwen3.5-0.8B-weight-space-programming على Hugging Face بموجب Apache 2.0، مع بصمات الموترين المتغيّرين وإعادة تشغيل مستقلة (51.0% على MATH-500).
لماذا قفزت نتائج الرياضيات كثيرًا؟ لأن النموذج الأساسي كان يدخل في حلقات. على MATH-500، بلغت 93.0% من إجاباته حد 32,768 رمزًا. خفّض التحرير ذلك إلى 33.1%، فأكمل النموذج إجابات كان قادرًا أصلًا على استنتاجها. لم يتعلم رياضيات جديدة.
هل تعمل برمجة فضاء الأوزان على أي نموذج؟ ليس بعد، بحسب المؤلفين أنفسهم. على Gemma 3 270M، الذي نادرًا ما يدخل في حلقات، نقل أفضل تحرير MATH-500 من 6.8% إلى 7.7%. ويصف المؤلفون كل نتائجهم بأنها مبكرة جدًا.
هل يمكنني اختبار النموذج المُحرَّر دون كتابة شيفرة؟ نعم. تشغّل مساحة العرض التجريبية على Hugging Face كلا النموذجين على مسألة تكتبها. وللفحص القابل للتكرار، استخدم vLLM مع Apidog CLI كما هو موضح أعلاه.