
في غضون أسابيع قليلة من بعضهما البعض في صيف عام 2026، أطلقت كل من OpenAI وجوجل نموذجًا متخصصًا في الأمن لا يستطيع معظم المطورين الوصول إليه. وصل نموذج GPT-5.6-Cyber من OpenAI في 10 أغسطس. ووصل نموذج Gemini 3.5 Flash Cyber من جوجل في 21 يوليو. كلاهما يكتشف الثغرات الأمنية في البرمجيات. وكلاهما مقيد بالموافقة. وكلاهما يرفض تزويدك بمفتاح API عادي.
لكنهما ليسا من نفس نوع الأداة. أحدهما يميل إلى الدفاع، والآخر يميل إلى الهجوم، وهما يقعان ضمن فئات نماذج مختلفة تمامًا. إذا كنت تحاول فهمهما، فإليك كيفية مقارنتهما فعليًا، ولماذا لا يمكن إجراء مقارنة مباشرة بينهما.
مقارنة جنباً إلى جنب
| GPT-5.6-Cyber | Gemini 3.5 Flash Cyber | |
|---|---|---|
| المورد | OpenAI | جوجل |
| تاريخ الإطلاق | 10 أغسطس 2026 | 21 يوليو 2026 |
| مبني على | GPT-5.6 Sol (الفئة الرائدة) | Gemini Flash (فئة سريعة ومنخفضة التكلفة) |
| يميل إلى | هجومي: سلاسل الاستغلال، اكتشاف الثغرات غير المعلنة | دفاعي: اكتشاف وإصلاح الثغرات الأمنية |
| الوصول | Daybreak Red (فرق الأمن المعتمدة) | تجريبي محدود (الحكومات، الشركاء الموثوق بهم) |
| واجهة برمجة تطبيقات عامة | لا | لا |
| تسعير عام | لا | لا |
| البرنامج | OpenAI Daybreak | Google CodeMender |
الخلاصة المختصرة: GPT-5.6-Cyber هو نموذج بحث هجومي على مستوى متقدم، و Gemini 3.5 Flash Cyber هو نموذج تصحيح دفاعي من فئة أخف. هذا الاختلاف في التوجه يفسر تقريبًا كل شيء آخر.
مستويات نماذج مختلفة
التقسيم الفني الأوضح هو النموذج الأساسي. يعتمد GPT-5.6-Cyber على GPT-5.6 Sol، وهو نموذج الاستدلال الأكثر قدرة لدى OpenAI. يتطلب البحث عن الثغرات الأمنية في العالم الحقيقي استدلالًا مستمرًا عبر قواعد بيانات برمجية كبيرة وغير مألوفة، وقد وضعت OpenAI نموذجها الأعلى مستوى تحت Cyber لتحقيق ذلك.
بينما يعتمد Gemini 3.5 Flash Cyber على فئة Flash، وهي أداة جوجل سريعة وغير مكلفة، بدلاً من نموذجها الرائد Pro. وهذا يتناسب تمامًا مع وظيفته. برنامج CodeMender من جوجل، الذي يقف وراءه، يدور حول فحص الكود للعثور على العيوب وإصلاحها على نطاق واسع، مما يكافئ السرعة وفعالية التكلفة على أقصى عمق استدلال في لقطة واحدة. لاحظ أيضًا خصوصية الإصدار: النموذج العام Flash انتقل إلى 3.6، لكن Cyber ظل عند 3.5، لأن الاثنين يسيران على مسارات إصدار مختلفة.
توجه مختلف: هجومي مقابل دفاعي
هذا هو التمييز الحقيقي. اقرأ صياغة كل بائع على حدة وستجد الانقسام واضحًا.
دربت OpenAI نموذج GPT-5.6-Cyber على تقليل حالات الرفض في المهام ذات الاستخدام المزدوج والأكثر خطورة، وعلى أن يكون أفضل في اكتشاف الثغرات غير المعلنة وبناء سلاسل الاستغلال، وفقًا لإعلان توسيع Daybreak. يتم تقديمه من خلال Daybreak Red، الفئة المخصصة صراحةً "للبحث المعتمد عن الثغرات الأمنية، والتحقق من الاستغلال، واختبار الأمان." كانت أدلة الإطلاق هجومية: ثغرتان متسلسلتان في V8 في Chrome، تم تعيين CVE-2026-15903 لهما، بالإضافة إلى نتائج مبلغ عنها عبر نظام تشغيل محمول، وقاعدة بيانات، ونواة نظام تشغيل.
صاغت جوجل نموذج Gemini 3.5 Flash Cyber حول الاكتشاف والإصلاح. تم الإعلان عنه في تحديث نماذج Gemini، وهو جزء من CodeMender، وهو جهد يهدف إلى رصد العيوب الأمنية في الكود واقتراح تصحيحات لها. التركيز هو على المعالجة، سد الثغرات، وليس تسليحها.
هذا لا يجعل أحدهما "آمنًا" والآخر "خطيرًا". فكاشف الثغرات القوي ذو استخدام مزدوج بغض النظر عن كيفية صياغته، وهذا هو بالضبط سبب تقييد الوصول لكليهما. ولكن إذا كنت ترسم خريطة للمجال، فقد دفعت OpenAI بقوة أكبر نحو البحث الهجومي، بينما بقيت جوجل أقرب إلى التصحيح الدفاعي.
شفافية مختلفة
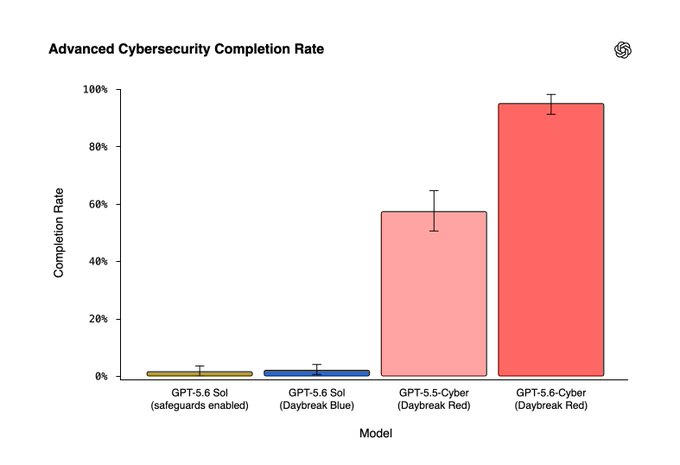
نشرت OpenAI المزيد من الأرقام. كشفت عن مقياس داخلي لمعدل الإنجاز (GPT-5.6-Cyber يجيب على 95.0% من المطالبات السيبرانية المتقدمة مقابل 1.5% لنموذج Sol الأساسي)، وذكرت معايير مثل ExploitGym، وأبلغت عن CVE حقيقي معين، وذكرت تصنيفًا لإطار الاستعداد "مرتفع" ولكنه أقل من "حرج". للاطلاع على التفاصيل الكاملة لمن يحصل على أي نوع من الوصول، راجع Daybreak Blue vs Red.
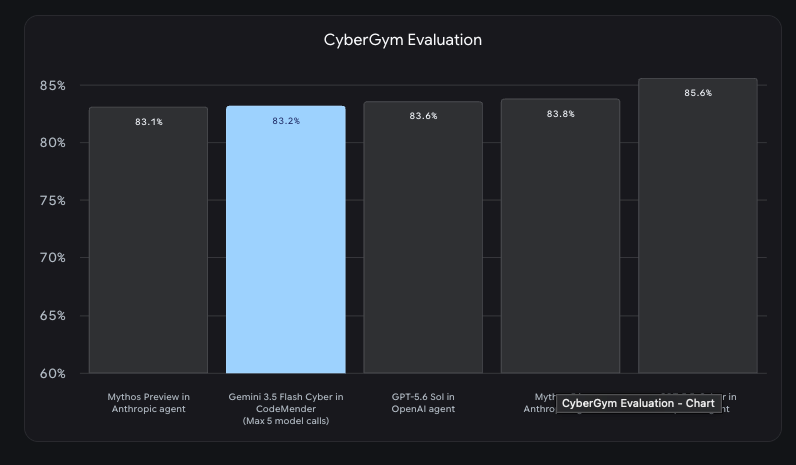
كانت جوجل أكثر غموضًا عند الإطلاق. أكدت وجود النموذج، وغرضه الدفاعي، ووضعه المقيد، دون نشر معدلات إنجاز قابلة للمقارنة لكل مهمة أو جداول معيارية. لذا بينما يمكنك وصف كلا النموذجين، لا يمكنك وضعهما في نفس الرسم البياني. لا يوجد معيار مشترك قام أي من البائعين بتشغيله وجهاً لوجه، ومهامهم المستهدفة (تطوير الاستغلال مقابل توليد التصحيحات) بالكاد تتداخل.
ما يشتركان فيه
تجاهل الاختلافات، ويحكي النموذجان نفس القصة حول اتجاه أدوات الأمن بالذكاء الاصطناعي:
- وصول مقيد، وليس واجهة برمجة تطبيقات مفتوحة. لا يمكن لأي منهما أن يكون ذاتي الخدمة. كلاهما يتطلب موافقة، والوصول محصور على المنظمات المعتمدة.
- لا يوجد تسعير عام. نظرًا لعدم وجود وصول مفتوح، لا يوجد سعر معلن لكل رمز (token) لأي منهما. أي جدول أسعار تجده متداولًا غير موثق.
- نفس منطق الاستخدام المزدوج. يرى كلا البائعين أن النموذج الجيد في اكتشاف الثغرات هو جيد بطبيعته في اكتشاف الثغرات، لذا يبدأون بحدود ضيقة مع شركاء موثوق بهم ويراقبون قبل توسيع نطاق الوصول.
- قصة إصدار مربكة. نموذج OpenAI يقع تحت تسمية Sol/Terra/Luna؛ بينما ظل نموذج جوجل عند 3.5 بينما انتقل نظيره إلى 3.6.
إذا أتيت لأي منهما بحثًا عن مفتاح API، فالإجابة هي نفسها: ليس اليوم، وربما ليس بالشكل الذي تتوقعه.
أيهما يهمك؟ على الأرجح لا شيء منهما، حتى الآن
إليك القراءة العملية. ما لم تكن في بائع أمان معتمد أو شريك حكومي، لا يمكنك استخدام أي من النموذجين في الوقت الحالي. مراقبتهما مفيد لفهم اتجاه التطور، ولكن لا ينتمي أي منهما إلى حزمة أدواتك هذا الربع.
ما ينتمي إلى حزمة أدواتك هو اختبار أمان واجهات برمجة التطبيقات (APIs) التي تملكها بالفعل. يوجد هذان النموذجان لأن الثغرات الأمنية مكلفة؛ وأرخص الثغرات التي يمكن منعها هي الأخطاء الحدودية المملة في خدماتك الخاصة. لست بحاجة إلى نموذج سيبراني متطور لاكتشاف تلك.
باستخدام عميل API مثل Apidog، يمكنك تشغيل الفحوصات التي تكتشف الأكبر قدرًا بأقل جهد:
- حدود المصادقة. أرسل طلبات برموز مفقودة، منتهية الصلاحية، وصالحة وتأكد من أن كل منها يعيد الحالة الصحيحة. ينطبق نفس مبدأ أقل الامتيازات على وكلائك؛ راجع ما يمكن لمفتاح API لوكيل الذكاء الاصطناعي الخاص بك فعله بالفعل.
- أمان النقل. تحقق من أن شهادات العميل و mTLS تعملان بشكل صحيح، وأن الطلبات العادية يتم رفضها.
هذا عمل يمكنك البدء فيه اليوم، باستخدام أدوات يمكنك الوصول إليها فعليًا. قم بتنزيل Apidog وابدأ بحالات المصادقة.
الأسئلة المتكررة
أيهما أفضل، GPT-5.6-Cyber أم Gemini 3.5 Flash Cyber؟ كلاهما مصمم لوظائف مختلفة، لذا "الأفضل" يعتمد على المهمة. GPT-5.6-Cyber هو نموذج متقدم مصمم للبحث الهجومي (تطوير الاستغلال، اكتشاف الثغرات غير المعلنة). Gemini 3.5 Flash Cyber هو نموذج أخف مصمم للتصحيح الدفاعي. لم ينشر أي من البائعين معيارًا مباشرًا للمقارنة، لذا لا تتوفر مقارنة مباشرة بالنقاط.
هل يمكنني استخدام أي منهما عبر واجهة برمجة تطبيقات (API)؟ لا. كلاهما مقيد الوصول. يتطلب GPT-5.6-Cyber موافقة Daybreak Red؛ بينما Gemini 3.5 Flash Cyber هو مشروع تجريبي محدود للحكومات والشركاء الموثوق بهم. لا يقدم أي منهما معرف نموذج API ذاتي الخدمة.
لماذا النموذجان مقيدان؟ الاستخدام المزدوج. النموذج الجيد في اكتشاف الثغرات يساعد المدافعين على التصحيح ويساعد المهاجمين على الاستغلال. يقيد كلا البائعين الوصول إلى الشركاء المعتمدين بينما يراقبون الاستخدام في العالم الحقيقي.
ما الفرق في النماذج الأساسية؟ يعتمد GPT-5.6-Cyber على GPT-5.6 Sol، وهو المستوى الرائد للاستدلال لدى OpenAI. يعتمد Gemini 3.5 Flash Cyber على مستوى Flash الأسرع والأقل تكلفة من جوجل، والذي يتناسب مع غرضه في الفحص والإصلاح.
ماذا يجب أن أستخدم بدلاً من ذلك؟ لتأمين واجهات برمجة تطبيقاتك الخاصة، قم بإجراء اختبارات المصادقة والنقل والعقد باستخدام عميل مثل Apidog. لا يتطلب نموذجًا مقيدًا.