
تضع اختبارات أداء Gemini 4 Neon في المركز الأول على مؤشر Coding Agent Index من Artificial Analysis (58.6)، وعند 65.2% على Terminal-Bench 4.1، وفي المركز الثاني على Vals Index (70.9%). وتقول Google أيضًا إنه يكلّف أقل بنسبة 32% لكل مهمة مقارنةً بـ Gemini 4 Carbon عند مستوى التفكير الافتراضي high. غير أن معظم الصفوف شُغّلت عند xhigh، وبعضها على أداة الاختبار الخاصة بـ Google.
هذه التفصيلة الأخيرة هي محور هذا المقال. تغطي نظرتنا العامة إلى Gemini 4 Neon المواصفات والتسعير. أما هنا فستجد كل نتيجة منشورة، ومن قاسها، وعند أي مستوى تفكير، وكيف تحوّل «التكلفة لكل مهمة» إلى رقم يمكنك مقارنته بفاتورتك.
اختبارات أداء Gemini 4 Neon في لمحة
Gemini 4 Neon هو الطراز الأوسط ضمن عائلة Gemini 4 من Google، صدر في 18 نوفمبر 2026، بسعر 3 دولارات لكل مليون رمز إدخال و15 دولارًا لكل مليون رمز إخراج. أقوى نتائجه المنشورة تأتي في البرمجة الوكيلية والعمل المعرفي، حيث يحتل المركز الأول أو الثاني على أربع لوحات صدارة مستقلة.
هذه هي الصفوف الرئيسية من منشور الإطلاق الذي نشرته Google:
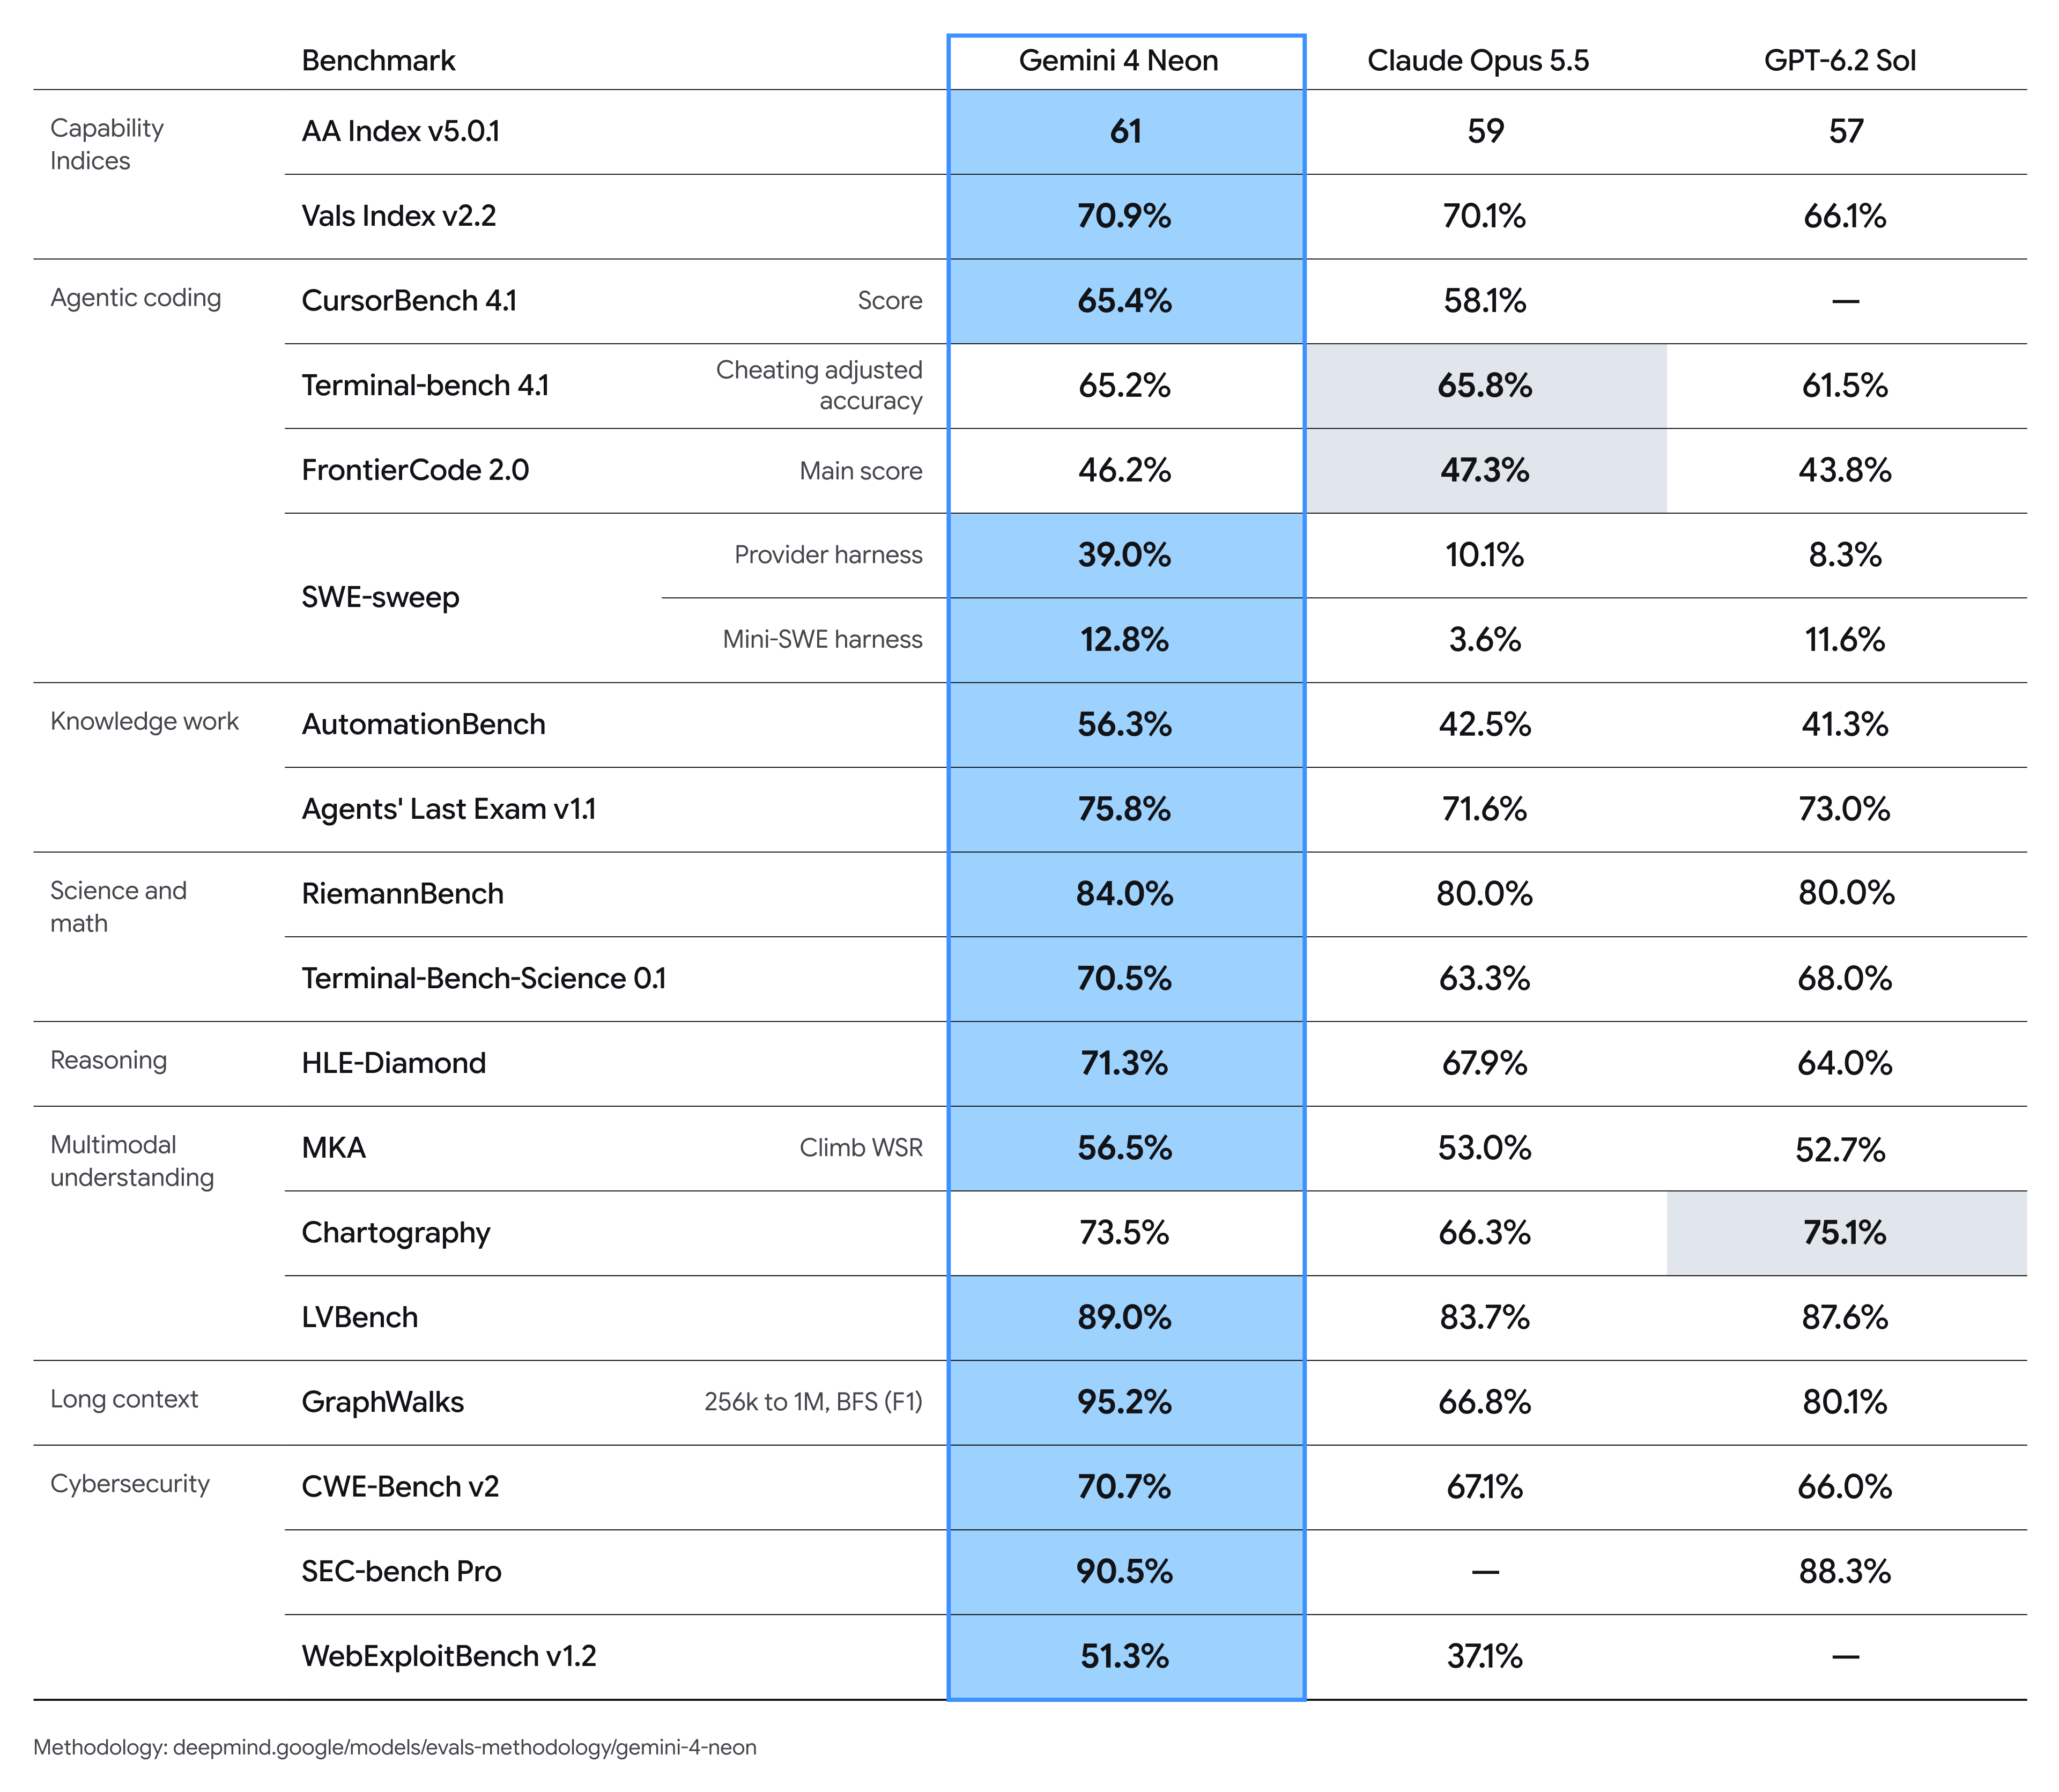
وتُبلِغ Google أيضًا عن المركز الأول في Legal Research Bench وTax Agent Bench التابعين لـ Vals AI.
اختبارات أداء Gemini 4 Neon في البرمجة
البرمجة هي المجال الذي تكون فيه حجة Neon أقوى، وهي أيضًا المجال الذي تكون فيه أداة الاختبار أكثر تأثيرًا. يشرح ملف PDF الخاص بمنهجية التقييم من Google كيف أُنتج كل صف من صفوف البرمجة.
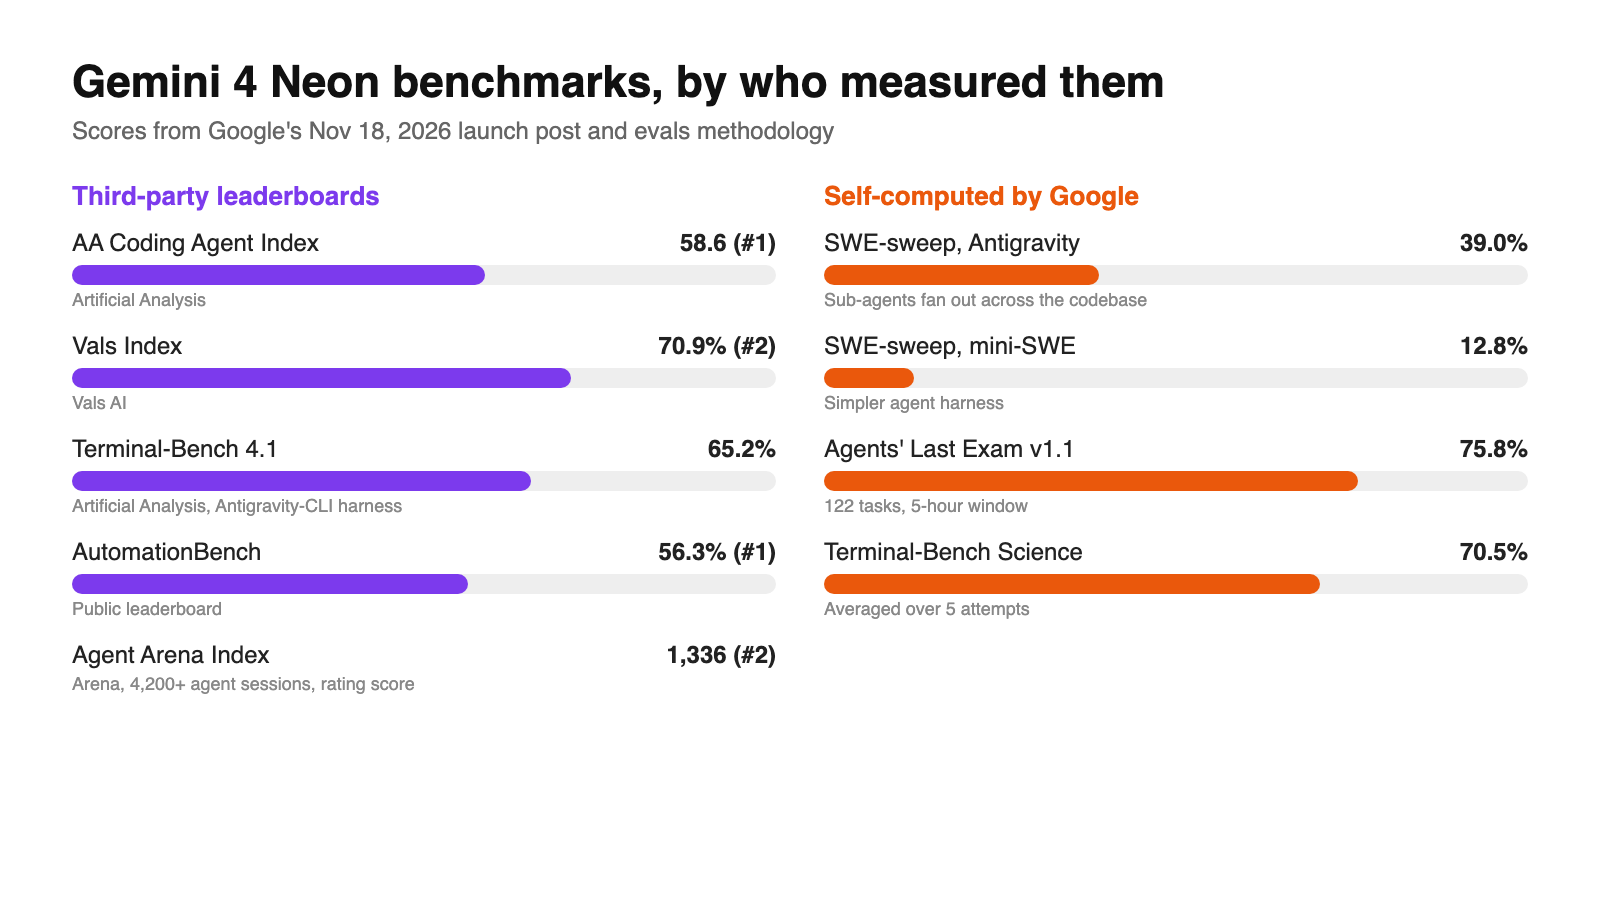
مؤشر Coding Agent Index من Artificial Analysis: 58.6، المركز الأول. هذا مؤشر مركّب مستقل، لذا فهو الصف الأقل تأثرًا بإعدادات Google. يمكنك التحقق من الترتيب الحالي على Artificial Analysis.
Terminal-Bench 4.1: 65.2%. شغّلت Artificial Analysis نموذج Neon باستخدام أداة Antigravity-CLI العامة، الإصدار 1.5.9. تأتي نتائج النماذج الأخرى من لوحة الصدارة الرسمية، وكل نتيجة تستخدم دقة معدّلة لمكافحة الغش. هذا عادل، لكن Neon شُغّل داخل أدوات الوكيل الخاصة بـ Google.
FrontierCode 2.0: 46.2%. هذه النتيجة من لوحة الصدارة العامة وشُغّلت عند high، وهو الافتراضي الذي تحصل عليه في بيئة الإنتاج. إذا كنت ستثق برقم برمجة واحد فقط لحركة الاستخدام اليومية، فثق بهذا.
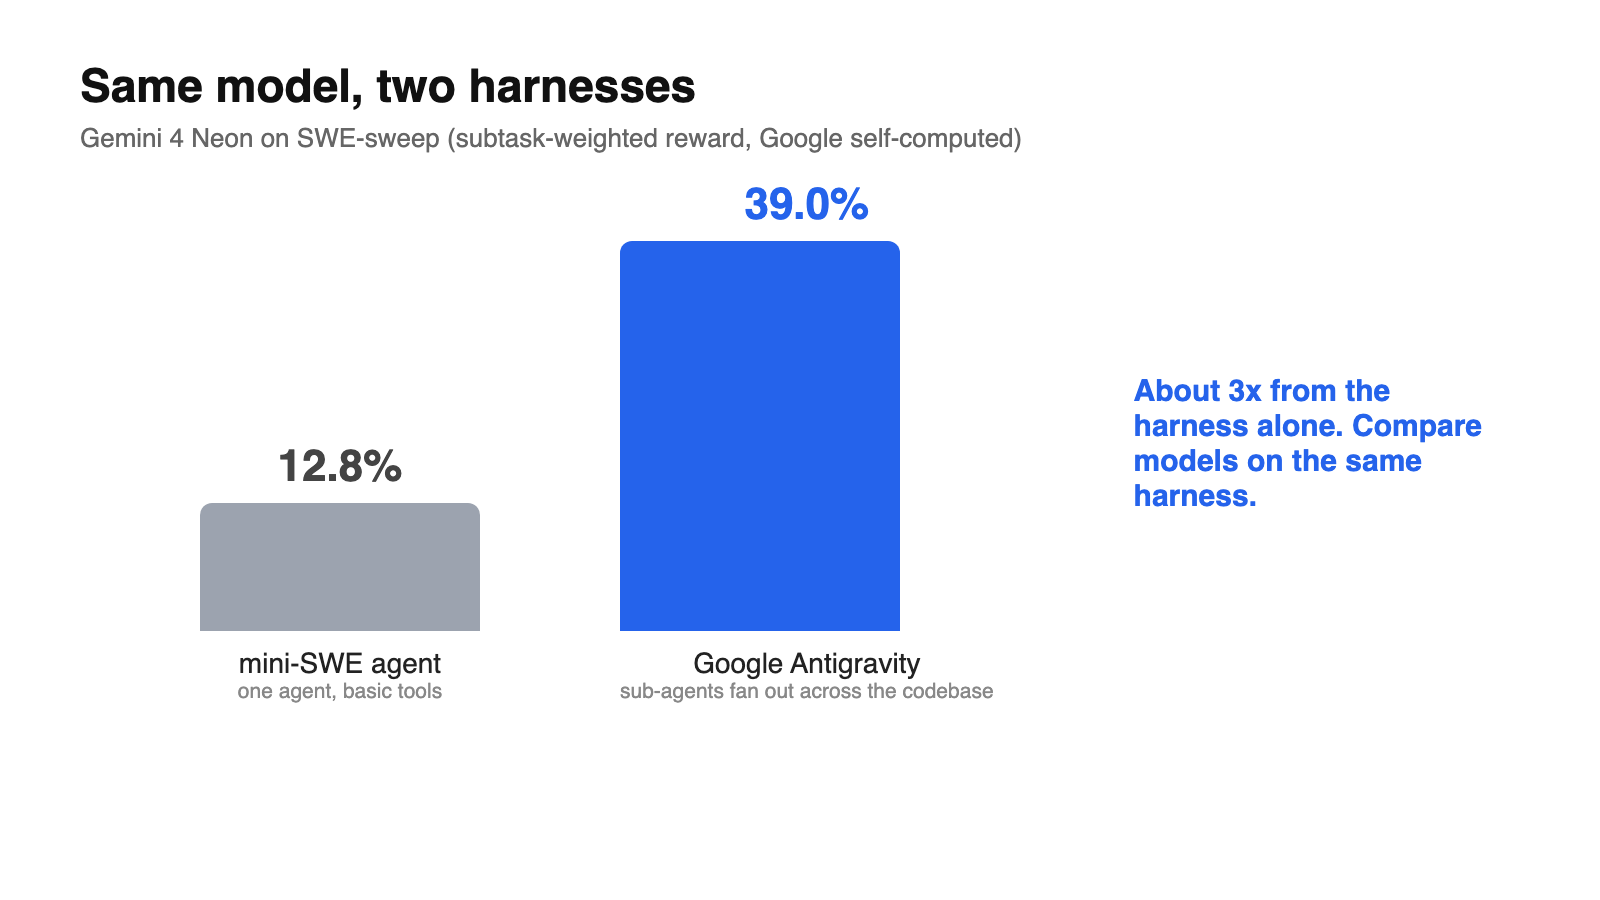
SWE-sweep: 39.0% في Antigravity، و12.8% على mini-SWE. كلا النتيجتين محسوبتان ذاتيًا من Google. قفزة ثلاثة أضعاف تأتي من أداة الاختبار: تشير Google إلى أن Antigravity-CLI يتضمن أداة افتراضية توزّع وكلاء فرعيين عبر قاعدة الشيفرة، وهو ما يناسب مهام العثور على الأخطاء. شُغّل Opus 5.5 في Claude Code وGPT-6.2 Sol في Codex للمقارنة نفسها. اقرأ 12.8% على أنها النموذج، و39.0% على أنها النموذج مع أفضل أدواته.
اختبارات أداء الوكلاء والعمل المعرفي
تلك الصفوف مهمة إذا كنت تخطط لتشغيل Neon دون إشراف عبر خطوات كثيرة.
- مؤشر Agent Arena: 1,336، المركز الثاني. مبني على أكثر من 4,200 جلسة وكيل من العالم الحقيقي. وتقول Google أيضًا إن Neon يحتل المركز الثاني هناك في قابلية التوجيه، أي إنه يتكيف بسلاسة عندما يصحّحه المستخدم أثناء المهمة.
- AutomationBench: 56.3%، المركز الأول. اختبار Zapier لأتمتة الأعمال، من لوحة الصدارة العامة.
- Vending-Bench 2: 16,843 دولارًا، المركز الأول. محاكاة Andon Labs طويلة الأفق لإدارة نشاط تجاري. النتيجة هي المال المكتسب، وليست نسبة مئوية.
- Agents’ Last Exam v1.1: 75.8%. محسوبة ذاتيًا على مجموعة من 122 مهمة داخل Antigravity-CLI 1.4.8 بنافذة 5 ساعات لكل تشغيل. نتيجة Opus 5.5 تأتي من لوحة الصدارة العامة، ونتيجة GPT-6.2 Sol من بطاقة النظام الخاصة به، لذا تختلف الإعدادات.
- Chartography: 73.5%. قراءة مخططات احترافية كثيفة، محسوبة ذاتيًا بدون أدوات.
بالنسبة للعلوم والرياضيات، يسجل Neon 70.5% على Terminal-Bench Science (محسوبة ذاتيًا، بمتوسط 5 محاولات)، و84.0% على RiemannBench، و71.3% على HLE-Diamond (من لوحة صدارة Artificial Analysis).
كيف شغّلت Google الأرقام
أربع قواعد من المنهجية تغيّر طريقة قراءتك للجدول:
- أعلى مستوى تفكير افتراضيًا. «تُشغّل جميع النتائج عبر Gemini API بأعلى إعدادات التفكير ما لم يُذكر خلاف ذلك». هذا هو
xhigh. فقط FrontierCode 2.0 موسوم صراحةً بـhigh. نداءات الإنتاج تعود افتراضيًا إلىhigh، لذا توقّع رموز تفكير أقل وربما نتائج أدنى مما يعرضه الجدول. - Pass@1، محاولة واحدة. لا تصويت بالأغلبية ولا حوسبة متوازية وقت الاختبار، باستثناء ما هو مذكور (Terminal-Bench Science يحتسب متوسط 5 محاولات).
- أرقام المنافسين مُبلّغ عنها ذاتيًا. نتائج النماذج غير التابعة لـ Gemini تأتي من كل مزوّد ما لم يُذكر خلاف ذلك. يستخدم Opus 5.5 وGPT-6.2 Sol أقصى إعداد استدلال متاح لديهما.
- مرشحات الأمان مفعّلة، باستثناء الأمن السيبراني. شُغّلت صفوف الأمن السيبراني مع تعطيل المرشحات.
يغطي دليل مستويات التفكير لدينا متى يستحق xhigh رموزه الإضافية.
التكلفة لكل مهمة: ماذا يعني ادعاء 32%
التكلفة لكل مهمة هي إجمالي الإنفاق لإكمال مهمة اختبار واحدة، وليست سعر الرمز. قد يكلّف نموذج بسعر رمز أعلى تكلفة أقل لكل مهمة إذا وصل إلى الإجابة بخطوات أقل ورموز تفكير أقل.
تقدم Google ثلاثة ادعاءات بشأن التكلفة:
| الادعاء | مستوى التفكير | مقارنةً بـ |
|---|---|---|
| تكلفة أقل بنسبة 32% لكل مهمة، مع درجة عالية في AA Intelligence Index | high |
Gemini 4 Carbon |
| تكلفة أقل بنحو 50% إلى 80% لكل مهمة على Vals Index وAgent Arena | high |
أفضل النماذج الرائدة المنافسة |
| تكلفة أقل بنسبة 36% أو أكثر لكل مهمة | xhigh |
النماذج المنافسة عند أعلى إعداد لها |
لاحظ عدم التطابق: صفوف الدقة تستخدم xhigh في الغالب، بينما التوفير الرئيسي البالغ 32% يكون عند high. كلا الأمرين صحيح، لكن ليس في الوقت نفسه. تحصل على توفير التكلفة أو على أعلى نتيجة، والفجوة بينهما عليك قياسها.
إليك كيفية تقدير تكلفتك الخاصة لكل مهمة. تُحتسب رموز التفكير ضمن الإخراج.
$$\text{cost} = \frac{\text{input} \times 3 + \text{cached input} \times 0.15 + \text{output} \times 15}{1{,}000{,}000}$$
مهمة برمجة بـ20,000 رمز إدخال و4,000 رمز إخراج تكلّف $0.06 + $0.06 = $0.12. إذا أصاب 15,000 من رموز الإدخال تلك ذاكرة التخزين المؤقت، تنخفض إلى $0.015 + $0.00225 + $0.06 = نحو $0.077. شغّل المهمة نفسها عند xhigh، فسيكون عدد الإخراج هو المتغير، لذا سجّل الرموز لكل مستوى، وليس مجرد النجاح أو الفشل. يغطي تفصيل تسعير Gemini 4 Neon لدينا أسعار Batch وFlex وPriority.
صفوف الأمن السيبراني والسلامة
تأتي درجات الأمن السيبراني من «Gemini 4 Neon for cyber»، الذي يُتاح للمدافعين الموثوقين عبر Fairwind Program بدلًا من واجهة API العامة.
| الاختبار | النتيجة | ملاحظة |
|---|---|---|
| SEC-bench Pro | 90.5% | الأفضل في فئته، بنحو نصف التكلفة لكل تحدٍ |
| WebExploitBench v1.2 | 51.26% | الأفضل في فئته، بنصف تكلفة النماذج الكبيرة |
| AutoBaxBench (hard tier) | 76% | الأفضل في فئته، شيفرة أكثر أمانًا من Carbon في كل المستويات |
| CWE-bench v2 | 70.7% | تحسّن بنسبة 3.4% عن Carbon |
| ExploitGym | غير مذكورة | بمستوى النماذج الرائدة باستخدام نصف رموز Carbon |
أرقام السلامة من المنشور نفسه: رفض Neon 1.98% من مهام Terminal-Bench 4.0، وسجل 0.0% في الغش على Terminal-Bench 4.0، واستخدم اختصارات في 2.45% من تقييم الغش البرمجي لدى Google، واجتاز 99.2% من تقييم أمانة الوكيل الخاص به. ومع ضمانات الوقت الفعلي عند أعلى مستوى تفكير، قاوم كل هجوم في اختبار حقن المطالبات غير المباشر من Gray Swan.
أين لا يتصدر Neon
لا يتصدر Neon في كل المجالات، وتقر Google بذلك:
- مؤشر الذكاء من Artificial Analysis: المركز الثالث إجمالًا، «خلف النماذج الأكبر والأبطأ بقليل».
- Vals Index: المركز الثاني، وليس الأول.
- مؤشر Agent Arena: المركز الثاني.
ولا تزال Google توجّهك إلى Carbon لأصعب مشاريعك طويلة الأفق. إذا كنت تختار بين نماذج Gemini 4 الثلاثة، فإن مقارنتنا بين Neon وCarbon وHydrogen ترسم المقايضات، ويعرض منشور اختبارات أداء Gemini 4 Argon كيف كانت جدول النموذج الأسبق يُقرأ.
اختبر Gemini 4 Neon بنفسك باستخدام Apidog CLI
تصف لوحات الصدارة أداة اختبار Google، وليس منتجك. أسرع طريقة لمعرفة ما إذا كان Neon يستحق سعره هي أن تدع وكيل البرمجة لديك يشغّل المطالبات نفسها عند high وxhigh ويسجل الرموز وزمن الاستجابة لكل منهما.
لا توجد طبقة API مجانية لـ Neon، لذا تحتاج إلى مفتاح Gemini API مدفوع. يتبع هذا الطلب تنسيق Interactions API الموثق من Google؛ ولم نشغّله مباشرةً لهذا المقال:
curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gemini-4-neon", "input": "Find the race condition in this retry queue.", "generation_config": {"thinking_level": "high"}}'
يتيح Apidog CLI لـ Claude Code أو Codex أو Cursor أو OpenCode إنشاء اختبارات API وتشغيلها من الطرفية. اضبطه مرة واحدة:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
ثم أعطِ وكيلك مطالبة واحدة:
In Apidog project <id>, create a Gemini API environment with GEMINI_API_KEY
and THINKING variables. Add a test case for POST /v1beta/interactions on
gemini-4-neon that sends my 10 eval prompts from prompts.csv, asserts HTTP 200
and a non-empty output, and records token usage and response time. Run it at
THINKING=high and THINKING=xhigh and compare cost per task at $3/$15 per 1M.
ينشئ الوكيل البيئة، ويتحقق من حمولة حالة الاختبار مقابل مخططها، ثم يشغّلها مرة واحدة لكل مستوى تفكير:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=high" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=xhigh" -r cli,json
أضف --timeout-request 900000 إذا كانت مطالباتك طويلة، لأن تشغيلات xhigh الصعبة قد تستغرق دقائق. لإعادة تشغيل المقارنة عند كل تغيير في المطالبات، ضع الأمر نفسه apidog run ... -r junit في CI مع دليل Apidog CLI لـ CI/CD، أو ابدأ من Apidog CLI داخل Claude Code. تغطي خطة Apidog المجانية حتى 4 مستخدمين.
الأسئلة الشائعة
ما أفضل نتيجة اختبار أداء حققها Gemini 4 Neon؟ المركز الأول في مؤشر Coding Agent Index من Artificial Analysis عند 58.6، إضافة إلى المركز الأول في AutomationBench (56.3%) وVending-Bench 2 (16,843 دولارًا).
عند أي مستوى تفكير شُغّلت اختبارات الأداء؟ في الغالب عند xhigh، وهو أعلى إعداد. تقول منهجية Google إن النتائج تستخدم أعلى إعدادات التفكير ما لم يُذكر خلاف ذلك؛ وقد وُسم FrontierCode 2.0 (46.2%) بأنه عند high الافتراضي.
هل Gemini 4 Neon أرخص من Carbon لكل مهمة؟ تقول Google إن التكلفة أقل بنسبة 32% لكل مهمة عند high. هذا رقم لكل مهمة مستمد من تشغيلات اختبار الأداء، لذا تحقق منه على مطالباتك قبل نقل حركة الاستخدام.
لماذا يسجل Neon 39.0% و12.8% على SWE-sweep؟ لاختلاف أدوات الاختبار. نسبة 39.0% داخل Google Antigravity، الذي يوزّع وكلاء فرعيين عبر قاعدة الشيفرة؛ و12.8% مع وكيل mini-SWE الأبسط.
هل اختبارات أداء Gemini 4 Neon مستقلة؟ جزئيًا. صفوف Artificial Analysis وVals وArena وAutomationBench وFrontierCode تأتي من أطراف ثالثة. أما SWE-sweep وAgents’ Last Exam وTerminal-Bench Science فهي محسوبة ذاتيًا من Google.