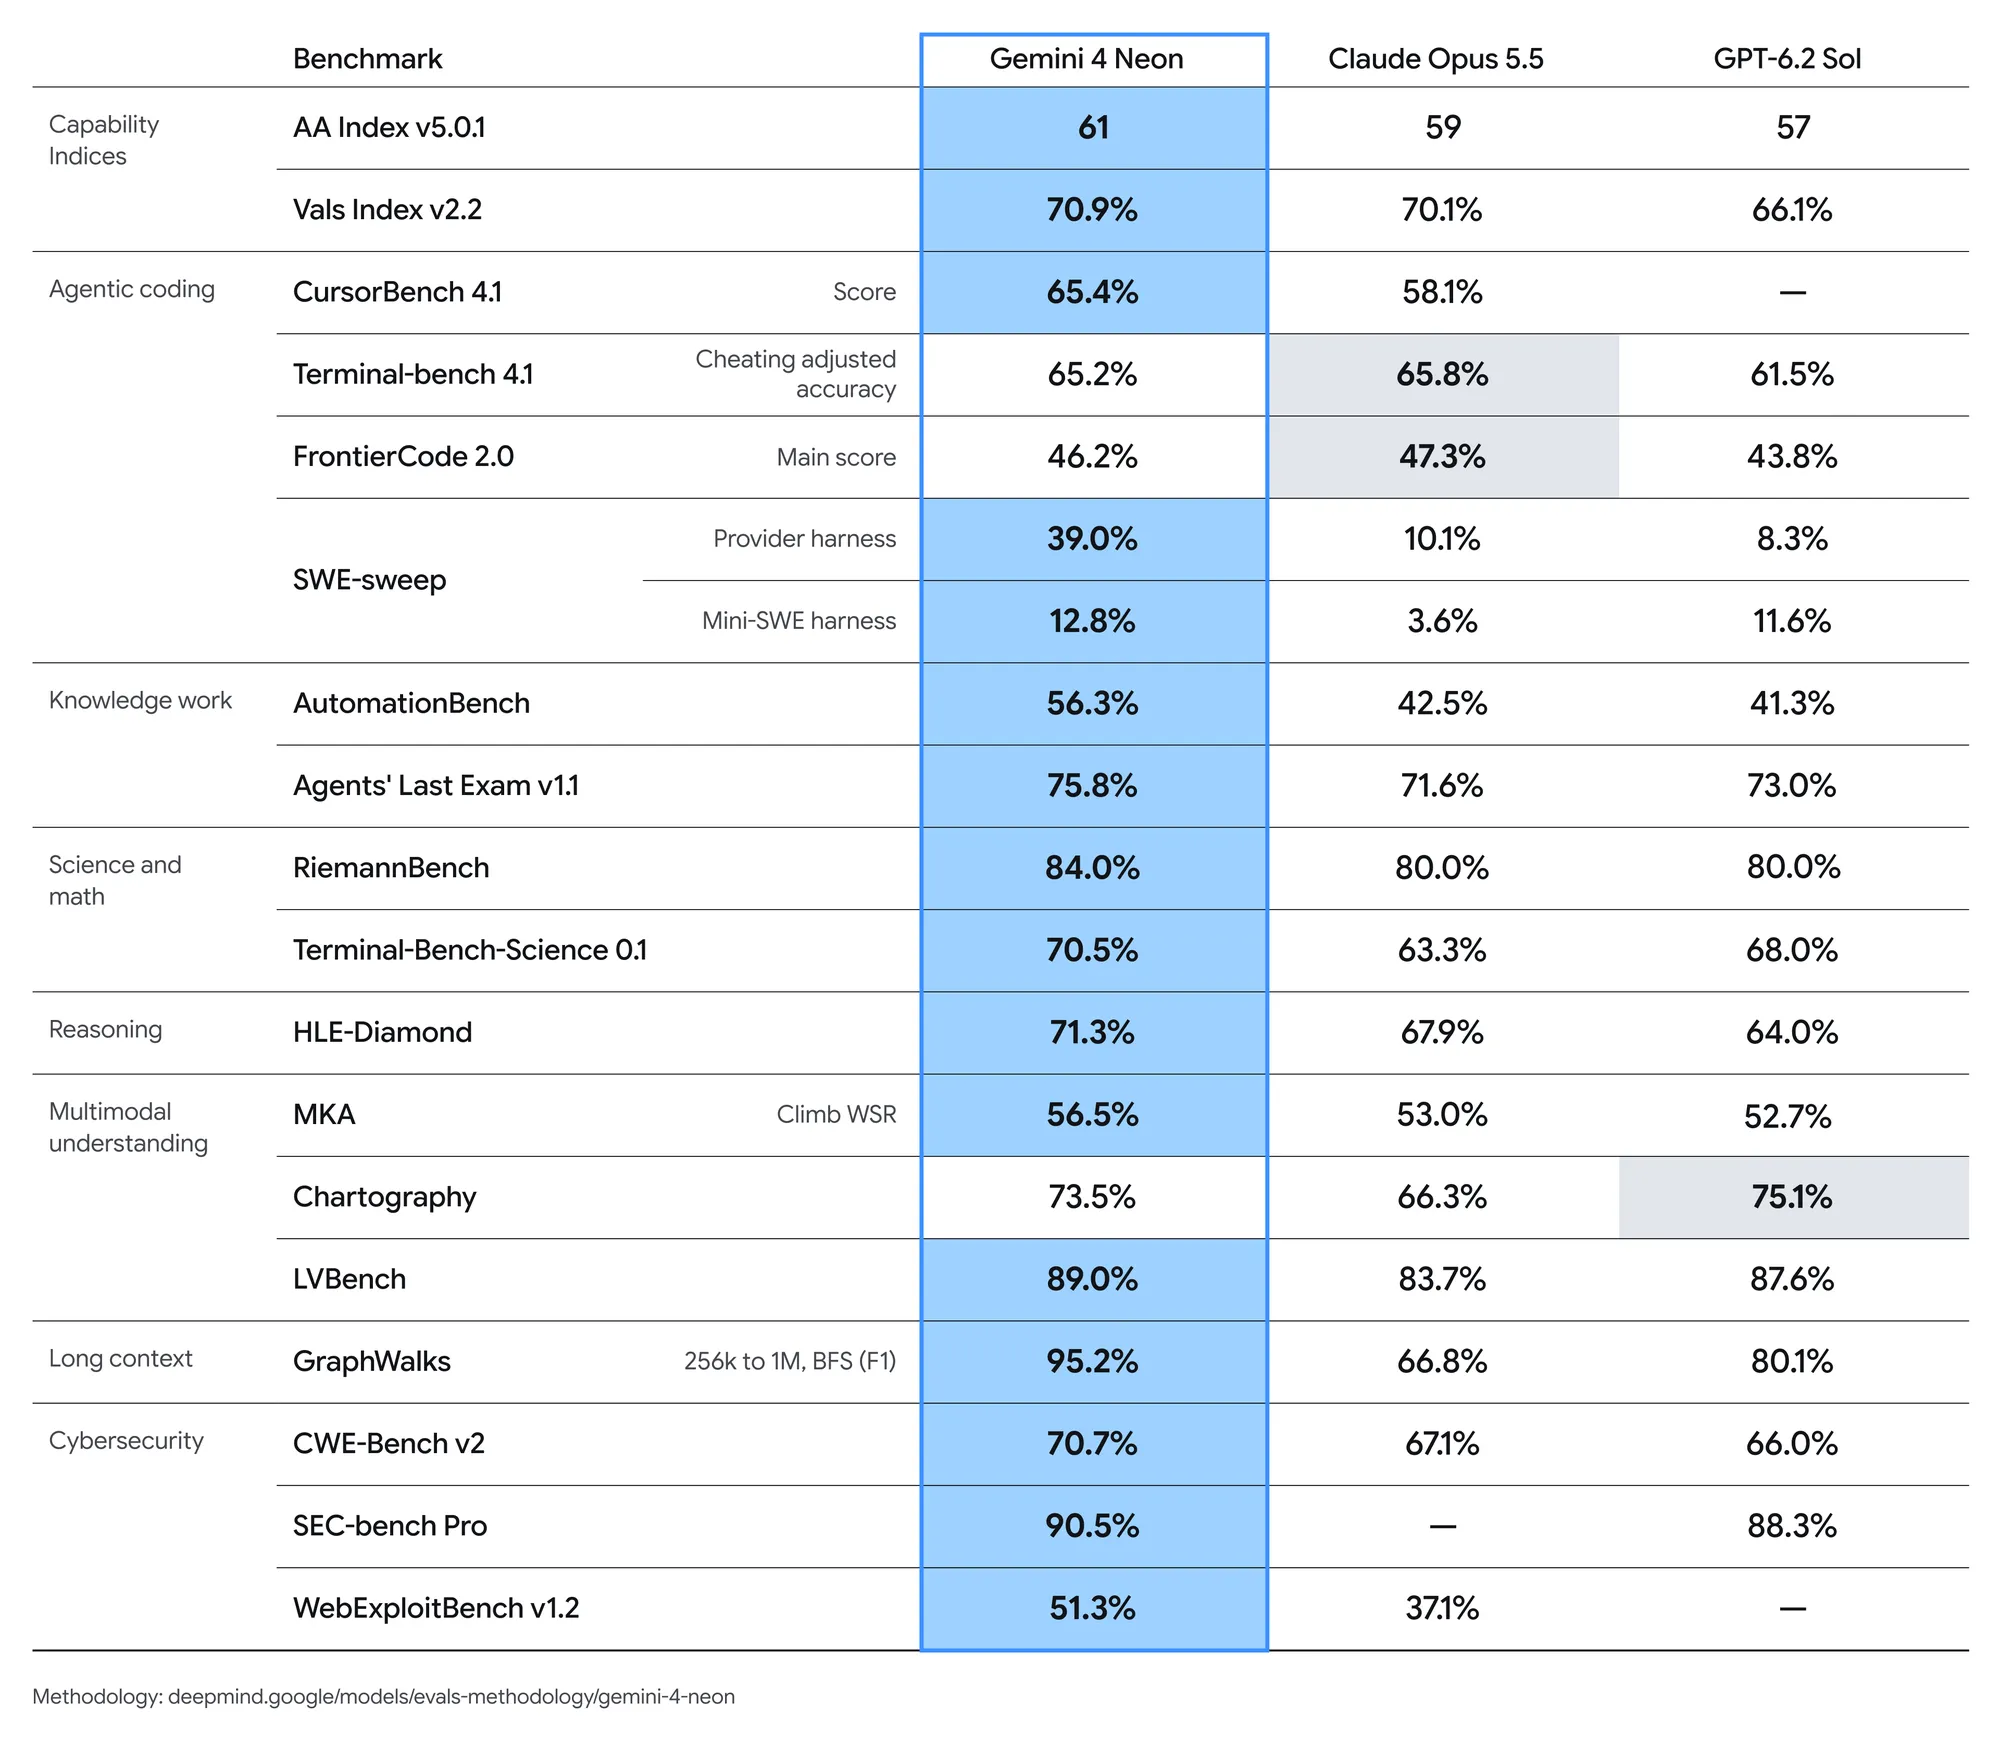
تستخدم واجهة Gemini 4 Neon API معرّف النموذج gemini-4-neon`. تستدعيها بطلب `POST` إلى `https://generativelanguage.googleapis.com/v1beta/interactions`، مع مفتاحك في الترويسة `x-goog-api-key`، وحقلَي `model` و`input` في جسم طلب JSON. تعمل النموذج على الفئة المدفوعة فقط، بسعر 3 دولارات لكل مليون رمز إدخال و15 دولارًا لكل مليون رمز إخراج، وهو يعتمد افتراضيًا على مستوى التفكير `high`.
يغطي هذا الدليل ما يميز Neon: الإعداد المطلوب للفئة المدفوعة، والانتقال من نموذج آخر من عائلة Gemini 4، والمخرجات التي تتجاوز 64 ألف رمز، والدمج بين Neon وHydrogen، وكيفية التحكم في الفاتورة. جميع أسماء الحقول مأخوذة من وثائق Google.
ماذا تحتاج قبل أول استدعاء لواجهة Gemini 4 Neon API؟
تحتاج إلى مفتاح Gemini API مرتبط بمشروع مفعَّل فيه نظام الفوترة، ومعرّف النموذج `gemini-4-neon`، ونقطة نهاية Interactions. أصدرت Google نموذج Neon في 18 نوفمبر 2026 ليكون النموذج المتوسط في عائلة Gemini 4، بين Hydrogen وCarbon.
| العنصر | القيمة |
|---|---|
| معرّف النموذج | gemini-4-neon |
| نقطة النهاية | POST /v1beta/interactions على generativelanguage.googleapis.com |
| ترويسة المصادقة | x-goog-api-key: $GEMINI_API_KEY |
| الواجهات البرمجية | Interactions API وgenerateContent |
| مستويات التفكير | low وmedium وhigh (الافتراضي) وxhigh |
| نافذة السياق | 1,048,576 رمزًا، مشتركة بين الإدخال والتفكير والإخراج |
| الإخراج لكل استدعاء متزامن | 65,536 رمزًا |
| التفكيك الطويل | حتى 1,048,576 رمزًا مطروحًا منها حجم الإدخال |
| الفئة المجانية | غير متاح |
| السعر المدفوع | 3.00 دولارات / مليون رمز إدخال، 15.00 دولار / مليون رمز إخراج (شاملًا التفكير) |
| الإدخال المخزَّن مؤقتًا | 0.15 دولار / مليون عبر التخزين المؤقت الضمني |
بالنسبة لملفات PDF واستدعاء الدوال والبث المتدفق، تتطابق أشكال الطلبات مع دليل Gemini 4 Hydrogen API لدينا؛ ما عليك سوى تغيير معرّف النموذج.
كيف تحصل على مفتاح Gemini API يعمل مع Neon؟
النموذج Neon غير متاح على الفئة المجانية، لذا لا يكفي المفتاح وحده؛ يجب أن يكون المشروع المرتبط به مفعَّلًا فيه نظام الفوترة.
افتحصفحة مفاتيح APIفي Google AI Studio وأنشئ مفتاحًا، أو استخدم مفتاحًا تملكه بالفعل.تأكد من أن مشروع المفتاح على الفئة المدفوعة. تنص وثائق Google بوضوح: «متاح Neon على الفئة المدفوعة فقط (وليس على الفئة المجانية)».صدِّر المفتاح: `export GEMINI_API_KEY="YOUR_API_KEY"`. تقرأ حزم Google GenAI SDK المفتاح تلقائيًا.راجع حدود المعدل للفئة المدفوعة علىصفحة حدود المعدلقبل التخطيط لدُفعة كبيرة. [VERIFY: أرقام RPM وTPM لكل فئة للنموذج Neon]
كيف ترسل أول طلب لواجهة Gemini 4 Neon API؟
أرسل `model` و`input` إلى نقطة نهاية Interactions. هذا هو الشكل الوارد في الدليل السريع من Google:
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Review this Go handler for missing error checks and suggest fixes."
  }'
نفس الاستدعاء باستخدام حزمة Python SDK (`pip install -U google-genai`):
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Review this Go handler for missing error checks and suggest fixes.",
)

print(interaction.output_text)
print(interaction.usage)
اقرأ حقل `usage` في كل استجابة أثناء الاختبار: تُحتسب رموز التفكير بسعر الإخراج البالغ 15 دولارًا، لذا فإن عدد رموز التفكير هو ما يحدد تكلفتك.
تتبع هذه المقتطفات دليل Google. لم نجرّبها عند إعداد هذه التدوينة، لذا تحقق من شكل الاستجابة مقابل أول استدعاء تجريه بنفسك.
ما الذي يتغير عند الانتقال من Hydrogen أو Carbon؟
إذا كنت تستخدم بالفعل نموذجًا آخر من عائلة Gemini 4، فالانتقال إلى Neon لا يتطلب أي تغييرات في مخطط الطلب. غيِّر سلسلة `model` فقط وتحقق من ثلاثة أمور:
| التحقق | Neon | Hydrogen | Carbon وArgon |
|---|---|---|---|
| مستوى التفكير الافتراضي | high |
high |
medium |
| أعلى مستوى | xhigh |
xhigh |
high |
| الإدخال / الإخراج لكل مليون | 3 / 15 دولارات | 1.50 / 7.50 دولارات | راجع تسعير Carbon |
إذا كنت قادمًا من Carbon أو Argon، فإن الانتقال الافتراضي من `medium` إلى `high` يعني المزيد من رموز التفكير على نفس الموجّه. حدِّد `thinking_level` صراحةً إذا كنت تريد السلوك القديم:
interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Audit this payment retry queue for race conditions.",
    generation_config={"thinking_level": "medium"},
)
أما إذا كنت قادمًا من Gemini 3.8 Flash أو إصدار أقدم، فالقائمة أطول. وفقًا لقائمة انتقال Google:
ارفع حدود الإخراج المنخفضة. يشمل `max_output_tokens` رموز التفكير والإجابة معًا. احذف الحدود الثابتة مثل 8,192 أو ارفعها إلى 65,536، وخفِّض مستوى التفكير إذا احتجت إلى إنفاق أقل.احذف `minimal`. يرفض النموذج Neon هذه القيمة ويُرجع خطأ.احذف معاملات أخذ العينات. يتجاهل الخادم القيم في النطاق من `temperature` و`top_p` و`top_k`، ويُرجع الخطأ `400` للقيم خارج النطاق.تخلَّ عن التخزين المؤقت الصريح. لا يدعم النموذج Neon `cachedContents` أو `caches.create`، لذا احذف حقول `cached_content`.صرِّح بالأدوات بشكل أصلي. قد يؤدي توجيه النموذج لتوليد استدعاءات أدوات بصيغة JSON خام دون تصريح بالأدوات إلى إرجاع الخطأ `MALFORMED_FUNCTION_CALL`. استخدم استدعاء الدوال أو المخرجات المهيكلة.
كيف تحصل على أكثر من 64 ألف رمز من النموذج Neon؟
يتوقف الطلب المتزامن عند 65,536 رمزًا، سواء كان ببث متدفق أو بدونه. للحصول على مخرجات أطول، مثل مواصفات انتقال كاملة مع مجموعة اختباراتها، اضبط `background` على `true` وارفع `max_output_tokens` فوق 65,536. يواصل خادم Google عندها التوليد على دفعات من 64 ألف رمز حتى الوصول إلى الحد الذي حددته.
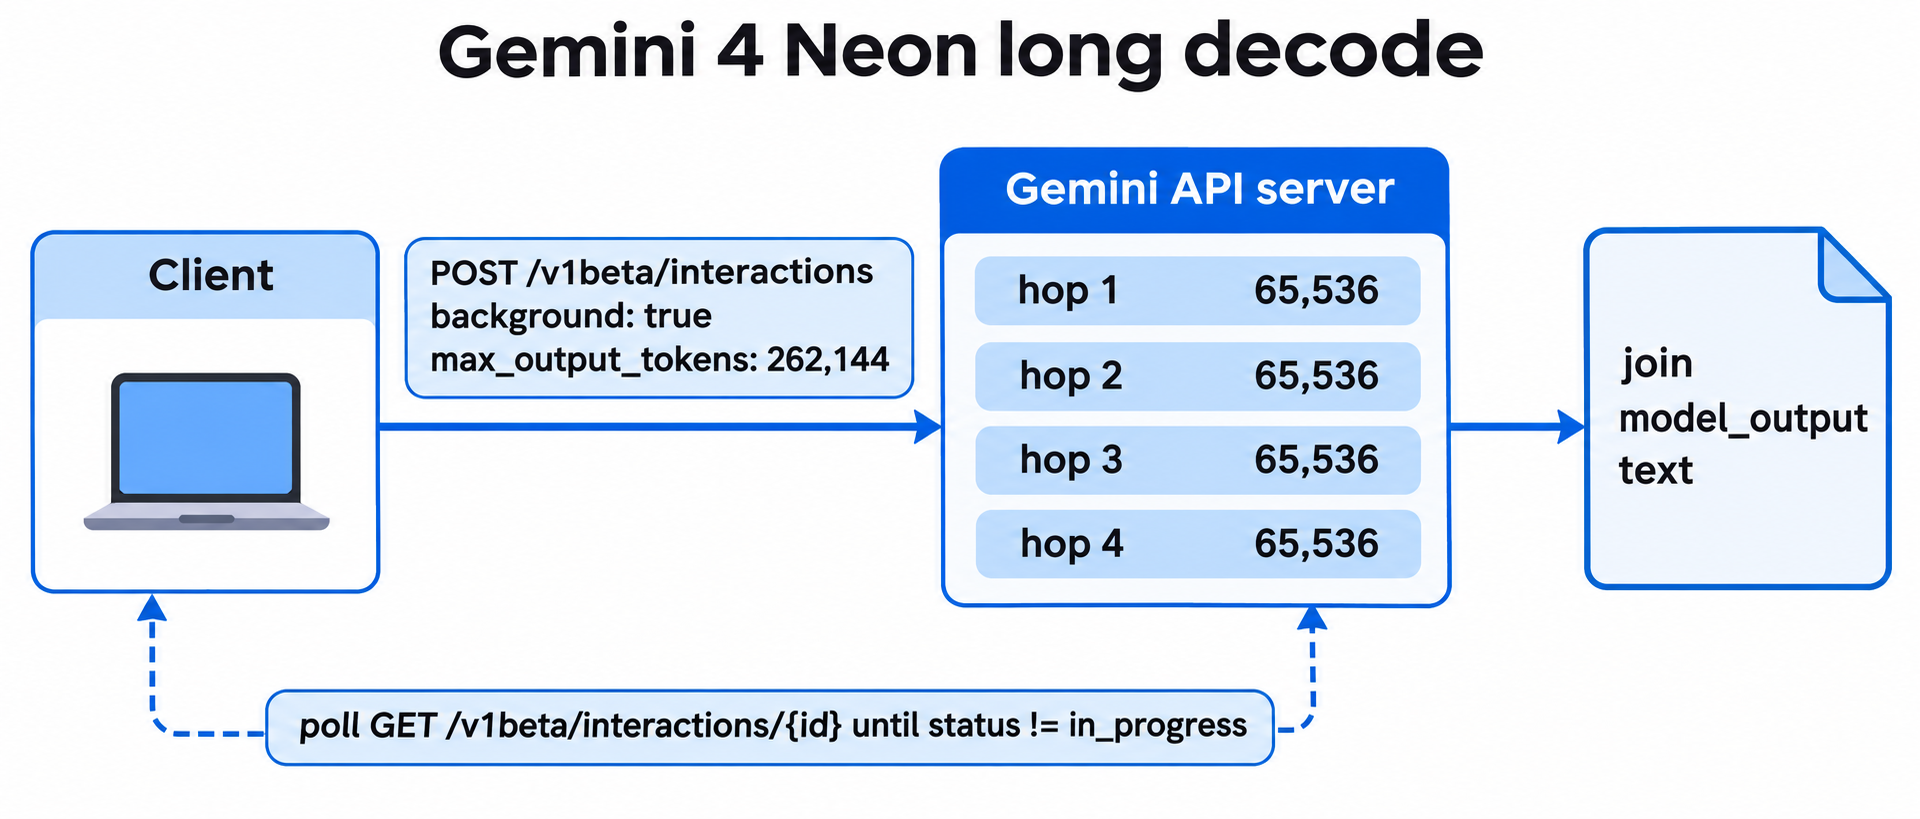
ابدأ المهمة واحتفظ بقيمة `id` الخاصة بها:
export ID=$(curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-4-neon",
    "input": "Generate a complete multi-module migration specification and test suite for this service.",
    "background": true,
    "generation_config": {
      "max_output_tokens": 262144,
      "thinking_level": "high"
    }
  }' | jq -r '.id')
ثم استخدم الاستقصاء حتى تنتهي المهمة وادمج النص من كل دفعة (بـ Python، باستخدام `ID` الذي صدّرته):
import os, time

interaction = client.interactions.get(id=os.environ["ID"])
while interaction.status in ("in_progress", "queued"):
    time.sleep(5)
    interaction = client.interactions.get(id=interaction.id)

text = "".join(
    c.text
    for step in interaction.steps if step.type == "model_output"
    for c in step.content if c.type == "text"
)
ثلاث قواعد من دليل Google تمنع حدوث مشكلات هنا:
إذا ضبطت `background` دون تحديد `max_output_tokens`، يتوقف الخادم عند 65,536 رمزًا.يمكن أن يصل الحد الأقصى إلى 1,048,576 مطروحًا منها رموز الإدخال. تنصح Google باستخدام 131,072 أو 262,144 للأعمال الطويلة متعددة الخطوات.قد تستغرق الموجّهات المعقدة عدة دقائق. استخدم وضع الخلفية، أو اضبط مهلات عميل HTTP على 15 دقيقة على الأقل.
إذا كنت تفضّل عدم تخزين التفاعلات على خوادم Google، فإن دليل التفكيك الطويل يوثّق أيضًا أسلوب المتابعة من جهة العميل في أحدث حزم SDK.
كيف تدمج النموذج Neon مع Hydrogen؟
استخدم Neon للتقدير والحكم، وHydrogen للحجم الكبير. يخطط Neon لسير عمل أو يراجعه، ثم تمرّر `id` التفاعل الخاص به كقيمة `previous_interaction_id` إلى استدعاء بنموذج `gemini-4-hydrogen` ينفذ خطوة واحدة. يعرض دليل مطوّري Cloud من Google هذا النمط:
plan = client.interactions.create(
    model="gemini-4-neon",
    input="Design a 3-step plan to migrate our REST order service to gRPC in Go.",
    store=True,
)

step = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Implement step 1 (.proto service definition) from the plan.",
    previous_interaction_id=plan.id,
)
print(step.output_text)
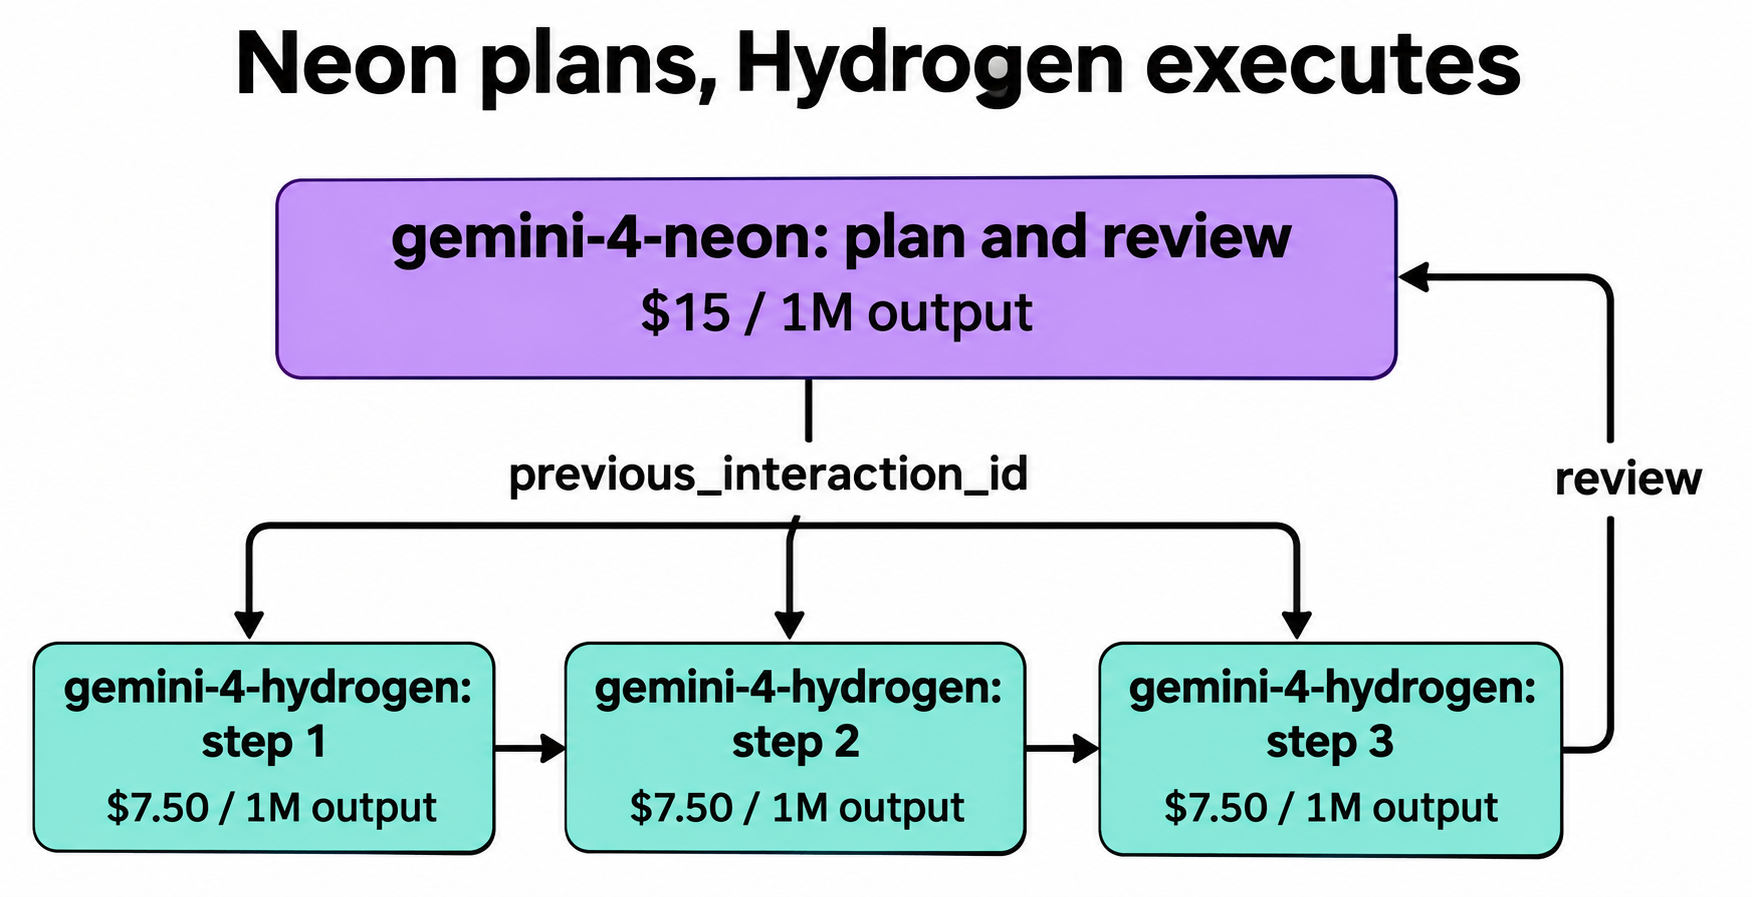
كل رمز إخراج تكتبه Hydrogen بدلًا من Neon يكلّف نصف السعر. يشرح دليل منسّق Gemini 4 Hydrogen لدينا الحلقة نفسها مع Carbon كمنسّق.
كيف تُبقي تكاليف واجهة Gemini 4 Neon API منخفضة؟
أربع رافعات، مرتّبة حسب ما يحقق عائدًا عادةً:
اختر أدنى مستوى تفكير يجتاز اختباراتك. تنصح Google بتشغيل تقييماتك على المستويات الأربعة جميعها مع قيمة مرتفعة من `max_output_tokens`، ثم اختيار أدنى `thinking_level` يستوفي معيار الجودة لديك.أعد استخدام الموجّهات الطويلة. يعمل التخزين المؤقت الضمني افتراضيًا على الموجّهات التي تبلغ 4,096 رمزًا على الأقل، ويخفض تكلفة الإدخال المخزَّن مؤقتًا بنسبة 95%، من 3.00 إلى 0.15 دولار لكل مليون. ضَع الجزء الطويل والثابت من موجّهك (نص النظام، الوثائق، المخططات) في المقدمة.سلِّم التنفيذ إلى Hydrogen. راجع نمط الدمج أعلاه.احسب كل شيء. تُحتسب فاتورة Google على كل رمز يعالجه النموذج، بما في ذلك رموز التفكير والتعليمات الداخلية المضافة عند استخدام الترسيخ (grounding). كما يُحتسب الترسيخ عبر Google Search لكل استعلام على حدة.
تحقق سريع من الواقع: استدعاء بـ 20,000 رمز إدخال و8,000 رمز إخراج (شاملًا التفكير) يكلف 0.06 دولار للإدخال و0.12 دولار للإخراج، أي 0.18 دولار بالسعر المعلن.
دع وكيل البرمجة لديك يقارن بين Neon وHydrogen باستخدام Apidog CLI
هل يستحق Neon ضِعف سعر Hydrogen على موجّهاتك؟ دع وكيل البرمجة لديك (Claude Code أو Codex أو Cursor) يبني حالة اختبار واحدة ويشغّلها على النموذجين باستخدام Apidog CLI.
أجرِ الإعداد مرة واحدة:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
ثم أعطِ الوكيل موجّهًا واحدًا:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY,
MODEL (default "gemini-4-hydrogen") and THINKING (default "high"). Add an
endpoint for POST /v1beta/interactions with the x-goog-api-key header from
GEMINI_API_KEY. Create a test case that sends model {{MODEL}}, our code-review
prompt and generation_config.thinking_level {{THINKING}}, and asserts: HTTP 200,
status is "completed", a non-empty model_output step, and usage.total_tokens
exists. Run it for gemini-4-hydrogen and gemini-4-neon, then compare
usage.total_thought_tokens and usage.total_output_tokens.
يقرأ الوكيل مخطط كل حمولة ويتحقق من صحة JSON قبل كتابة أي شيء:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "MODEL=gemini-4-hydrogen" -r cli,json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "MODEL=gemini-4-neon" -r cli,json
اضرب رموز كل تشغيل في سعر النموذج وستحصل على تكلفة حقيقية لكل مهمة على موجّهك تحديدًا، لا متوسطًا من إعلان الإطلاق. أضف `--upload-report` لعرض التشغيل في تطبيق Apidog، أو استبدل `-r cli,json` بـ `-r junit` لتضمين التحقق نفسه في CI. يعرض دليل Apidog CLI لخطوط CI/CD بنية المسار، ويغطي Apidog CLI في Claude Code إعداد الوكيل. تغطي الخطة المجانية من Apidog حتى 4 مستخدمين.
الأسئلة الشائعة
ما هو معرّف نموذج Gemini 4 Neon؟ `gemini-4-neon`. ويعمل مع كل من واجهة Interactions API و`generateContent`.
هل واجهة Gemini 4 Neon API مجانية؟ لا. متاح Neon على الفئة المدفوعة من Gemini API فقط، بسعر 3 دولارات لكل مليون رمز إدخال و15 دولارًا لكل مليون رمز إخراج. ويمكن لمشتركي Google AI Pro وUltra تجربته في محادثة AI Studio.
هل يعمل كود Hydrogen لديّ مع Neon؟ نعم. تقول Google إن الانتقال بين نماذج Gemini 4 لا يتطلب أي تغييرات في مخطط الطلب. حدِّث سلسلة `model`، ثم قرر ما إذا كنت تريد مستوى التفكير الافتراضي `high`.
ما الحد الأقصى للمخرجات في واجهة Gemini 4 Neon API؟ 65,536 رمزًا لكل طلب متزامن. وبتعيين `background` على `true` مع قيمة أعلى من `max_output_tokens`، يمكن للنموذج Neon توليد ما يصل إلى نافذة 1,048,576 رمزًا مطروحًا منها حجم الإدخال.
هل يدعم Gemini 4 Neon معامل temperature؟ لا. يتجاهل الخادم القيم في النطاق من `temperature` و`top_p` و`top_k`، ويُرجع الخطأ `400` للقيم خارج النطاق. استخدم `thinking_level` للموازنة بين الجودة من جهة والسرعة والتكلفة من جهة أخرى.
هل يدعم النموذج Neon التخزين المؤقت الصريح للسياق؟ لا. احذف `cached_content` من طلباتك. ويبقى التخزين المؤقت الضمني مطبَّقًا تلقائيًا على الموجّهات التي تبلغ 4,096 رمزًا أو أكثر، بخصم 95% على الإدخال المخزَّن مؤقتًا.