
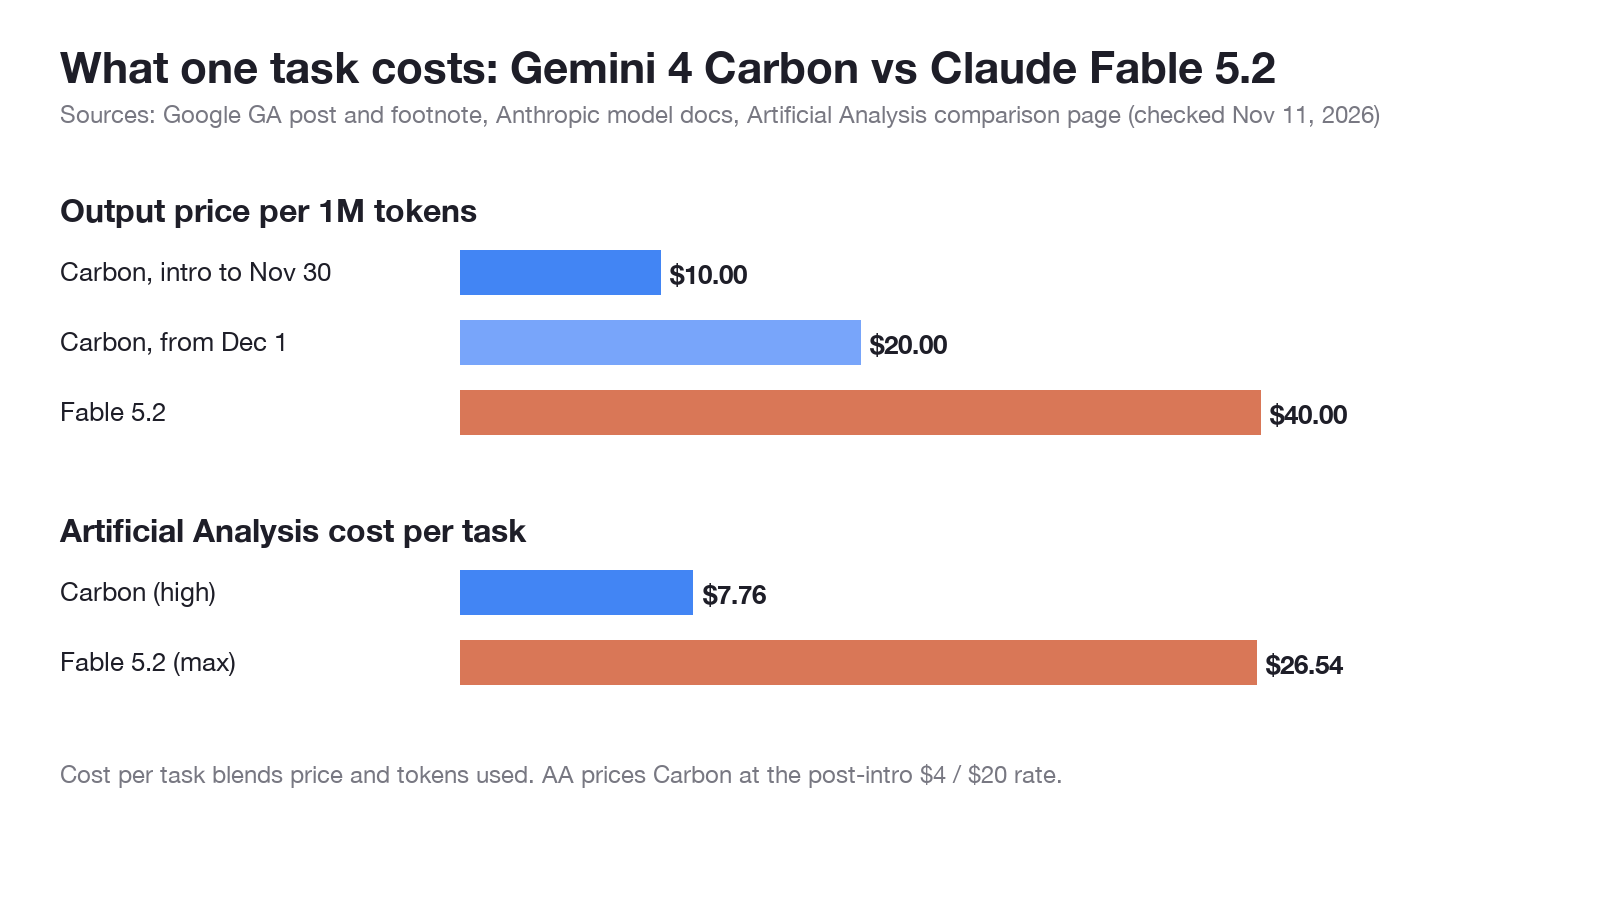
اعتبارًا من 11 نوفمبر 2026، يُعد Gemini 4 Carbon من Google النموذج الأرخص، بينما يُعد Claude Fable 5.2 الأقوى في أغلب معايير البرمجة والوكلاء المنشورة. سعر Carbon المعلن هو 2 دولار / 10 دولارات لكل مليون رمز إدخال/إخراج حتى 30 نوفمبر (ثم 4 دولارات / 20 دولارًا)، وFable 5.2 بسعر 8 دولارات / 40 دولارًا، وتقدّر Artificial Analysis تكلفة المهمة الواحدة بـ 7.76 دولار مقابل 26.54 دولار.
النموذجان أُطلقا بيوم واحد فارق (Fable 5.2 في 9 نوفمبر، والإتاحة العامة لـ Carbon في 10 نوفمبر)، وجدول كل شركة يفضّل نموذجها الخاص. يقسّم هذا الدليل كل رقم حسب جهة القياس، ثم يوضح كيفية إجراء اختبار A/B لكليهما على طلباتك الخاصة.
Gemini 4 Carbon مقابل Claude Fable 5.2: الخلاصة السريعة
اختر Gemini 4 Carbon عندما تكون التكلفة لكل مهمة هي الأهم، أو لتدفقات أتمتة الأعمال، أو لأعمال الأمن السيبراني. واختر Claude Fable 5.2 عندما تحتاج أعلى نتيجة في مهام البرمجة الصعبة ومهام الطرفية واستخدام الحاسوب، ويمكنك دفع حوالي 3.4 أضعاف التكلفة لكل مهمة. أما للهندسة اليومية، فكلا الشركتين يوجّهانك أولًا إلى خيار افتراضي أرخص.
تقول مشاركة الإتاحة العامة من Google إن "Argon يظل الخيار الأمثل لغالبية أعمال هندسة البرمجيات والمعرفة"، وتضع Carbon لمهام أصعب حيث ينفق رموزًا أكثر للاستكشاف والتحقق. وتقول وثائق نماذج Anthropic الشيء نفسه بصياغتها: ابدأ بـ Claude Opus 5.5 لمعظم أحمال العمل، وانتقل إلى Fable 5.2 للمهام الاستدلالية المتطلبة وأعمال الوكلاء طويلة المدى.
إذن تلجأ إلى أيٍّ منهما بعدما يعجز خيارك الافتراضي. ما زلت تختار خيارًا افتراضيًا؟ اقرأ أولًا Gemini 4 Carbon مقابل Argon.
كيف يقارن Gemini 4 Carbon وClaude Fable 5.2 من حيث السعر والمواصفات؟
إليك الحقائق التي تنشرها كل شركة، مع مصدر كل صف.
| المواصفة | Gemini 4 Carbon | Claude Fable 5.2 | المصدر |
|---|---|---|---|
| معرّف النموذج | gemini-4-carbon |
claude-fable-5-2 |
Google، Anthropic |
| الإصدار | الإتاحة العامة 10 نوفمبر 2026 | 9 نوفمبر 2026 | Google، Anthropic |
| سعر الإدخال لكل مليون رمز | 2 دولار حتى 30 نوفمبر، ثم 4 دولارات | 8 دولارات (16 دولارًا في الوضع السريع) | حاشية Google، وثائق Anthropic |
| سعر الإخراج لكل مليون رمز | 10 دولارات حتى 30 نوفمبر، ثم 20 دولارًا | 40 دولارًا (80 دولارًا في الوضع السريع) | حاشية Google، وثائق Anthropic |
| نافذة السياق | مليون رمز | مليون رمز | بطاقة نموذج AI Studio، وثائق Anthropic |
| الحد الأقصى للإخراج | 65 ألف / مليون مُدرَج [VERIFY] | 128 ألف رمز | بطاقة نموذج AI Studio، وثائق Anthropic |
| التفكير | مستوى تفكير قابل للضبط | تكيفي، يعمل دائمًا، الجهد الافتراضي high |
الدليل السريع لـ Google، وثائق Anthropic |
| أين تحصل عليه | الفئة المدفوعة من Gemini API، وAI Studio، وAndroid Studio، وGemini للأعمال، وAntigravity، وCodeMender، وGoogle AI Ultra | منصة Claude، وAmazon Web Services، وGoogle Cloud، وMicrosoft Azure | Google، Anthropic |
| فئة API المجانية | لا شيء مذكور | لا شيء مذكور | Google، Anthropic |
مشاركة الإتاحة العامة من Google لا تذكر Vertex AI ولا Gemini CLI ولا GitHub Copilot، فلا تخطط بالاستناد إليها بعد. سعر Carbon التمهيدي يطابق سعر Argon، ما يجعل نوفمبر أرخص شهر لإجراء تقييمك.
للاطلاع على قوائم الأسعار الكاملة، راجع تسعير Claude Fable 5.2 وإعلان Gemini 4 Carbon من Google.
أي نموذج يتفوق في المعايير المرجعية؟
يعتمد ذلك على الجدول الذي تقرؤه، لذا إليك ثلاثة جداول منفصلة.
جدول Anthropic (منشور مع Fable 5.2)
يتضمن منشور إطلاق Fable 5.2 من Anthropic عمودًا لـ Gemini 4 Carbon. الصفحة لا توضح من أجرى أرقام Carbon، فتعامل معها كأرقام مبلّغ عنها من الشركة المصنّعة.
| المعيار المرجعي (جدول Anthropic) | Fable 5.2 | Gemini 4 Carbon |
|---|---|---|
| FrontierSWE v2 | 69.9% | 61.2% |
| FrontierCode 2.0 | 49.1% (جهد xhigh) | 41.1% (جهد medium) |
| Terminal-Bench-Science 0.1 | 74.6% | 64.8% |
| OSWorld 2.1 (مجموعة دون اتصال، جزئي) | 89.3% | 81.5% |
| AA-Briefcase v1.1 (سلم تقييم) | 66.1% | 61.8% |
| Chartography (بدون أدوات) | 73.4% | 72.5% |
| AutomationBench | 51.4% | 53.9% |
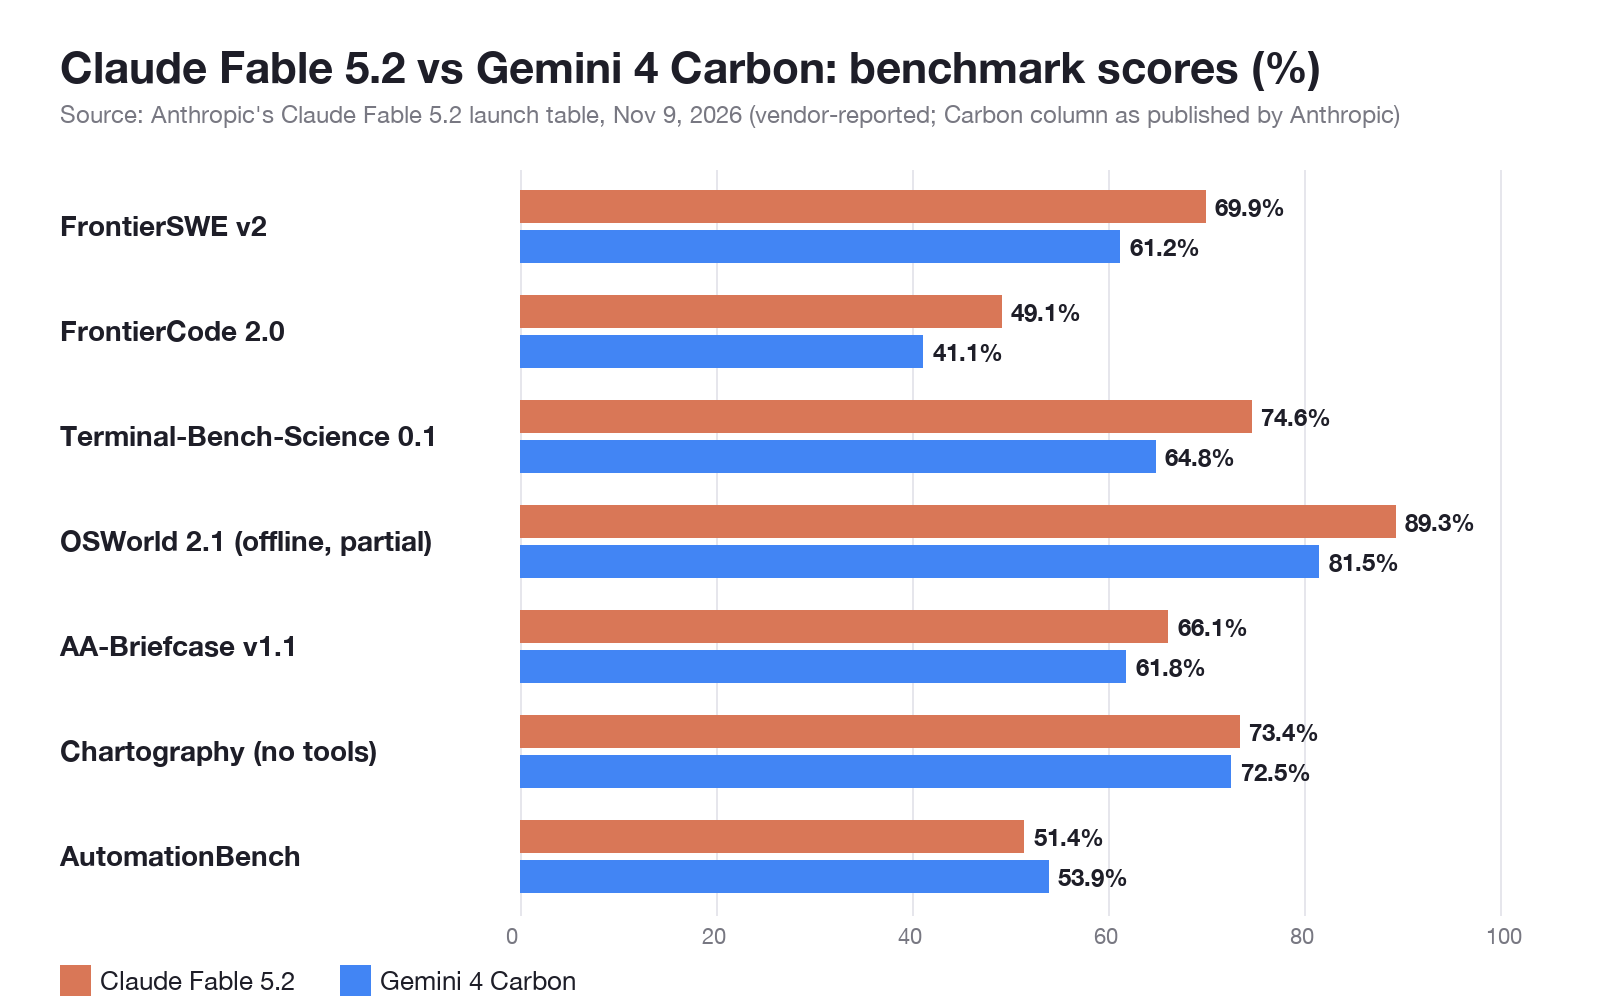
لاحظ صف FrontierCode: شُغّل Fable بجهد xhigh وCarbon بجهد medium. هذه الفجوة في الإعدادات لا تقل أهمية عن الفجوة في النتائج.
جدول Google (منشور مع الإتاحة العامة لـ Carbon)
لا تنشر Google مقارنة مباشرة مع Fable 5.2. بل تعرض بدلًا من ذلك لوحات صدارة الشركاء: يحتل Carbon المرتبة الأولى في CursorBench 4.0 وWANDR من Perplexity وAutomationBench من Zapier "بتكلفة أقل لكل مهمة بأكثر من ضعفين مقارنة بأفضل نموذج خارجي تالٍ". ويحتل المرتبة الثانية في معيار Multimodal Knowledge Agent بمتوسط تكلفة لكل مهمة أقل بأكثر من 6 أضعاف من النموذج الأعلى. لا تسمّي Google النماذج المنافسة في هذه الادعاءات.
Artificial Analysis (مستقل)
تُشغّل صفحة المقارنة من Artificial Analysis كلا النموذجين عبر نفس Intelligence Index v5.0.1:
| المقياس (Artificial Analysis) | Fable 5.2 (max) | Gemini 4 Carbon (high) |
|---|---|---|
| مؤشر الذكاء | 65 | 60 |
| التكلفة لكل مهمة | 26.54 دولار | 7.76 دولار |
| تكلفة تشغيل المؤشر كاملًا | 22,191 دولار | 8,240 دولار |
| سرعة الإخراج | 103 رمز/ث | 82 رمز/ث |
يحتفظ Fable 5.2 (max) اليوم بالصدارة في هذا المؤشر. سجّل Carbon أقل بخمس نقاط وبنحو 29% من التكلفة لكل مهمة. تسعّر Artificial Analysis نموذج Carbon بـ 4 دولارات / 20 دولارًا، أي السعر بعد نوفمبر، لذا تعكس أرقام تكلفته بالفعل سعر ديسمبر.
أين يتفوق Claude Fable 5.2؟
يتفوق Fable 5.2 في أصعب مهام البرمجة واستخدام الحاسوب، وفق أرقام Anthropic:
- البرمجة على مستوى المستودعات: 69.9% مقابل 61.2% في FrontierSWE v2.
- أعمال الطرفية والبحث: 74.6% مقابل 64.8% في Terminal-Bench-Science 0.1.
- استخدام الحاسوب: 89.3% مقابل 81.5% في OSWorld 2.1.
- المؤشر المستقل: 65 مقابل 60 في Artificial Analysis، النتيجة الوحيدة التي لم تُجرِها أي من الشركتين.
- طول الإخراج: حد أقصى موثّق قدره 128 ألف رمز لكل طلب.
إذا كانت كل مهمة فاشلة تكلّف مهندسًا عصرًا كاملًا، فقد يفوق تحسّن بمقدار 8 نقاط في FrontierSWE فاتورة الرموز. للإعداد، راجع دليل Claude Fable 5.2 API.
أين يتفوق Gemini 4 Carbon؟
يتفوق Carbon في التكلفة لكل مهمة وفي أحمال العمل التي بُني من أجلها:
- التكلفة لكل مهمة: 7.76 دولار مقابل 26.54 دولار في Artificial Analysis، أي أرخص بنحو 3.4 أضعاف.
- أتمتة الأعمال: 53.9% مقابل 51.4% في AutomationBench، وفق جدول Anthropic نفسه.
- الأمن السيبراني: يتصدّر SEC-bench Pro وExploitGym وCWE-bench v1 وفق Google، مع نموذج Carbon for cyber محميّ للأمدادات عبر برنامج Fairwind.
- السعر في نوفمبر: 2 دولار / 10 دولارات حتى 30 نوفمبر، أي ربع سعر Fable على الإدخال والإخراج معًا.
- فرق الوكلاء: تحوّل معاينة /swarm في Google Antigravity مطالبة واحدة إلى فريق منسّق، يتخطط فيه ويدقّق Carbon بينما تعمل النماذج الأخف بالتوازي.
جديد على النموذج؟ ابدأ بـ ما هو Gemini 4 Carbon.
كم تكلّف المهمة الواحدة فعلًا؟
السعر المعلن يخبرك بالتعرفة، لا بالفاتورة. تكلفة المهمة هي السعر مضروبًا في الرموز التي يختار النموذج إنفاقها، وتقول Google إن Carbon ينفق رموزًا أكثر للاستكشاف والتحقق.
خذ طلبًا واحدًا بـ 50,000 رمز إدخال و10,000 رمز إخراج:
- Carbon، التعرفة التمهيدية: (0.05 × 2 دولار) + (0.01 × 10 دولارات) = 0.20 دولار
- Carbon، اعتبارًا من 1 ديسمبر: (0.05 × 4 دولارات) + (0.01 × 20 دولارًا) = 0.40 دولار
- Fable 5.2: (0.05 × 8 دولارات) + (0.01 × 40 دولارًا) = 0.80 دولار
هذا يفترض أن كليهما يُصدر 10,000 رمز. لكن ذلك لن يحدث. إذا كتب Carbon 30,000 رمز من التفكير حيث يكتب Fable 10,000، ترتفع تكلفة Carbon في ديسمبر إلى 0.80 دولار وتُغلق الفجوة. قاست Artificial Analysis الواقع عبر مجموعتها كاملة وما زالت وجدت Carbon أرخص بنحو 3.4 أضعاف لكل مهمة، وهذا أقوى إشارة متاحة لك حتى تقيس بنفسك.
كيف تُجري اختبار A/B لنموذجي Gemini 4 Carbon وClaude Fable 5.2 على طلباتك الخاصة؟
المعايير المرجعية هي مهام أشخاص آخرين. أما الاختبار العادل فيرسل المطالبة نفسها إلى كلا الواجهتين ويسجّل الرموز وزمن الاستجابة جنبًا إلى جنب.
كلا الاستدعاءين عبارة عن HTTP عادي. إليك طلب Carbon، المبني من الدليل السريع لـ Google لواجهة Interactions API، مع اسم النموذج في متغير:
MODEL="gemini-4-carbon"
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Api-Revision: 2026-05-20" \
  -d "{\"model\": \"$MODEL\", \"input\": \"Review this diff and list the bugs.\"}"
ويمرّ Fable 5.2 عبر واجهة Messages API من Anthropic مع claude-fable-5-2 كاسم للنموذج.
دع وكيل البرمجة لديك يُجري اختبار A/B عبر Apidog CLI
تشغيل أزواج الطلبات يدويًا يصبح مملًا سريعًا. دع Claude Code أو Codex أو Cursor يقود Apidog CLI بدلًا من ذلك. الإعداد يستغرق ثلاثة أوامر:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
ثم أعطِ وكيلك مطالبة واحدة:
In Apidog project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gemini-4-carbon through the Gemini API, and
one that sends the same prompt to claude-fable-5-2 through the Claude
Messages API. Keep both API keys in private environment variables.
Assert a 200 status and a non-empty answer, record token usage and
response time, run each case 5 times and summarize cost per run.
Validate every payload before you write it.
يتحقق الوكيل من المخطط، ويكتب الحالات، ويشغّلها. والرايات أدناه مأخوذة من apidog run --help في الإصدار CLI 2.2.12:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <CARBON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apidog run --test-case <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
الراية -n 5 تكرر كل حالة خمس مرات، فلا تحسم استجابة بطيئة واحدة النتيجة. أضف --upload-report لعرض التشغيلات في تطبيق Apidog. هذا قالب لسير عمل؛ لم نشغّله ضد Carbon من هذا الجهاز. يغطي دليل Apidog CLI في Claude Code إعداد الوكيل، ويغطي دليل Gemini 4 Argon API جانب طلب Gemini.
تغطي الخطة المجانية من Apidog حتى 4 مستخدمين، وهو ما يكفي لإجراء هذه المقارنة.
الأسئلة الشائعة
هل Gemini 4 Carbon أفضل من Claude Fable 5.2؟
ليس بشكل شامل. سجّل Fable 5.2 نتائج أعلى في معظم معايير Anthropic وفي مؤشر Artificial Analysis (65 مقابل 60). بينما يتفوق Carbon في التكلفة لكل مهمة (7.76 دولار مقابل 26.54 دولار) وفي AutomationBench.
كم هو Gemini 4 Carbon أرخص من Claude Fable 5.2؟
عند السعر المعلن، يكون Carbon أرخص بأربعة أضعاف حتى 30 نوفمبر 2026 (2 دولار / 10 دولارات مقابل 8 دولارات / 40 دولارًا لكل مليون رمز) وأرخص بضعفين اعتبارًا من 1 ديسمبر (4 دولارات / 20 دولارًا). وبالقياس لكل مهمة من Artificial Analysis، فهو أرخص بنحو 3.4 أضعاف.
هل لكلا النموذجين نافذة سياق بمليون رمز؟
نعم. تدرج بطاقة نموذج AI Studio من Google مليون رمز لـ Carbon، وتدرج وثائق Anthropic مليون رمز لـ Fable 5.2. الحد الأقصى لإخراج Fable هو 128 ألف رمز؛ وتحقق من دليل المطوّرين لدى Google للحد الدقيق لإخراج Carbon.
هل توجد فئة مجانية لـ Gemini 4 Carbon أو Claude Fable 5.2 عبر API؟
لا تعلن أي من الشركتين عن ذلك. يعمل Carbon ضمن الفئة المدفوعة من Gemini API وفي تطبيقات Google AI Ultra؛ ويُفوتر Fable 5.2 لكل رمز.
هل ينبغي أن أستبدل نموذجي الافتراضي بأيٍّ منهما؟
على الأرجح لا. تقول Google إن Argon يبقى الخيار الصحيح لمعظم أعمال هندسة البرمجيات والمعرفة، وتوصي Anthropic بـ Opus 5.5 لمعظم أحمال العمل. وجّه فقط المهام التي يعجز نموذجك الافتراضي عنها إلى Carbon أو Fable، ثم قارن النتائج على طلباتك الخاصة.