
لا يوجد واجهة برمجة تطبيقات (API) عامة لـ Gemini 4 Argon حتى الآن، ولم تنشر Google معرف نموذج له. أعلنت Google عن Argon في 30 سبتمبر 2026، وهو متاح اليوم فقط للمدافعين المشاركين في برنامج Fairwind: مجموعة من شركاء Fairwind يستخدمونه كنموذج مُدار على Gemini Enterprise. تدرج Artificial Analysis "استوديو Google AI" كمزود واجهة برمجة التطبيقات الوحيد لـ Argon، ولكن بدون بيانات عن السرعة أو زمن الاستجابة، وهو ما يتناسب مع الوصول المسبق المسموح به (allowlisted) بدلاً من نقطة نهاية يمكنك التسجيل فيها. عندما يبدأ الانتشار الأوسع، تقول Google إنه سيبدأ "مع عملاء واجهة برمجة التطبيقات المدفوعين ومشتركي Google AI Ultra"، لذا فإن مفتاح API مدفوع لـ Gemini يضعك في طليعة المنتظرين.
هذه الفجوة بين الإعلان والإتاحة هي وقت يمكنك استغلاله. يفصل هذا الدليل ما أكدته Google حول واجهة برمجة تطبيقات Argon عما لم تؤكده، ثم يستعرض شيفرة يمكنك تشغيلها اليوم على Gemini 3.8 Flash بحيث يصبح التبديل إلى Argon مجرد تغيير لمتغير واحد. ستبني الطلب، وتعد تنبيهًا للانطلاق، وتحاكي الاستجابة في Apidog، وتضيف حدًا أقصى للتكلفة بأسعار Argon. للنموذج نفسه، ابدأ بـ ما هو Gemini 4 Argon؛ ولمراحل الإطلاق، راجع دليل تاريخ إصدار Gemini 4 Argon.
ما تم تأكيده حول واجهة برمجة تطبيقات Gemini 4 Argon، وما لم يتم تأكيده
يعطي منشور إطلاق Google الأسعار وحدود الإخراج. كل شيء تقريبًا آخر تحتاجه عملية الدمج لا يزال غير منشور.
| البند | الحالة | التفاصيل |
|---|---|---|
| سعر الإدخال | مؤكد | 2 دولار لكل مليون توكن (مقدمة)، 4 دولارات بعد فترة المقدمة |
| سعر الإخراج | مؤكد | 10 دولارات لكل مليون توكن (مقدمة)، 20 دولارًا بعد ذلك |
| الإدخال المخبأ (Cached input) | مؤكد | خصم 95% على الإدخال: 0.10 دولار مقدمة، 0.20 دولار عادي |
| حد الإخراج | مؤكد | مليون توكن، زيادة من 64 ألف |
| سطح API | تم الإشارة إليه | تقول وثائق Google أن جميع النماذج الجديدة تُطلق على Interactions API |
| معرف النموذج (Model ID) | غير منشور | غائب عن صفحة النماذج، صفحة التسعير، وسجل التغييرات |
| نافذة سياق الإدخال | غير منشور | استخدمت تقييمات Google للسياق الطويل مطالبات تصل إلى مليون توكن، لكن هذا ليس مواصفة |
| مستويات التفكير | غير منشور | تم تشغيل التقييمات على "أعلى إعدادات التفكير"؛ الأسماء والافتراضيات غير معروفة |
| حدود المعدل (Rate limits) | غير منشور | لم يتم الإعلان عن أي مستويات |
| دعم الدفعات (Batch support) | غير منشور | لا يوجد تسعير للدفعات أو المرونة (Flex) |
| مستوى المطالبات الطويلة | غير منشور | 3.1 Pro يفرض رسومًا أكثر فوق 200 ألف؛ قاعدة Argon غير مصرح بها |
| طول الفترة التمهيدية | غير منشور | لا يوجد تاريخ انتهاء لأسعار 2 دولار / 10 دولارات |
يستحق صفان نظرة فاحصة. يأتي صف سطح واجهة برمجة التطبيقات من وثائق Interactions API، والتي تقول إن النماذج الجديدة "ستُطلق على Interactions API". Argon نموذج جديد، لذا توقع أن يكون هناك أولاً؛ لم تقل Google ما إذا كانت `generateContent` ستخدمه. صف الإخراج هو الحد المعلن من Google للنموذج، لكن Vals AI تدرج حد إخراج أقصى 262 ألف للتكوين الذي اختبرته، لذا لا تفترض أن كل نقطة نهاية ستخدم المليون توكن بالكامل في اليوم الأول. يغطي دليل توكنات الإخراج بمليون ما يفعله هذا الحد بالتدفق، والمهلات، والتخزين.
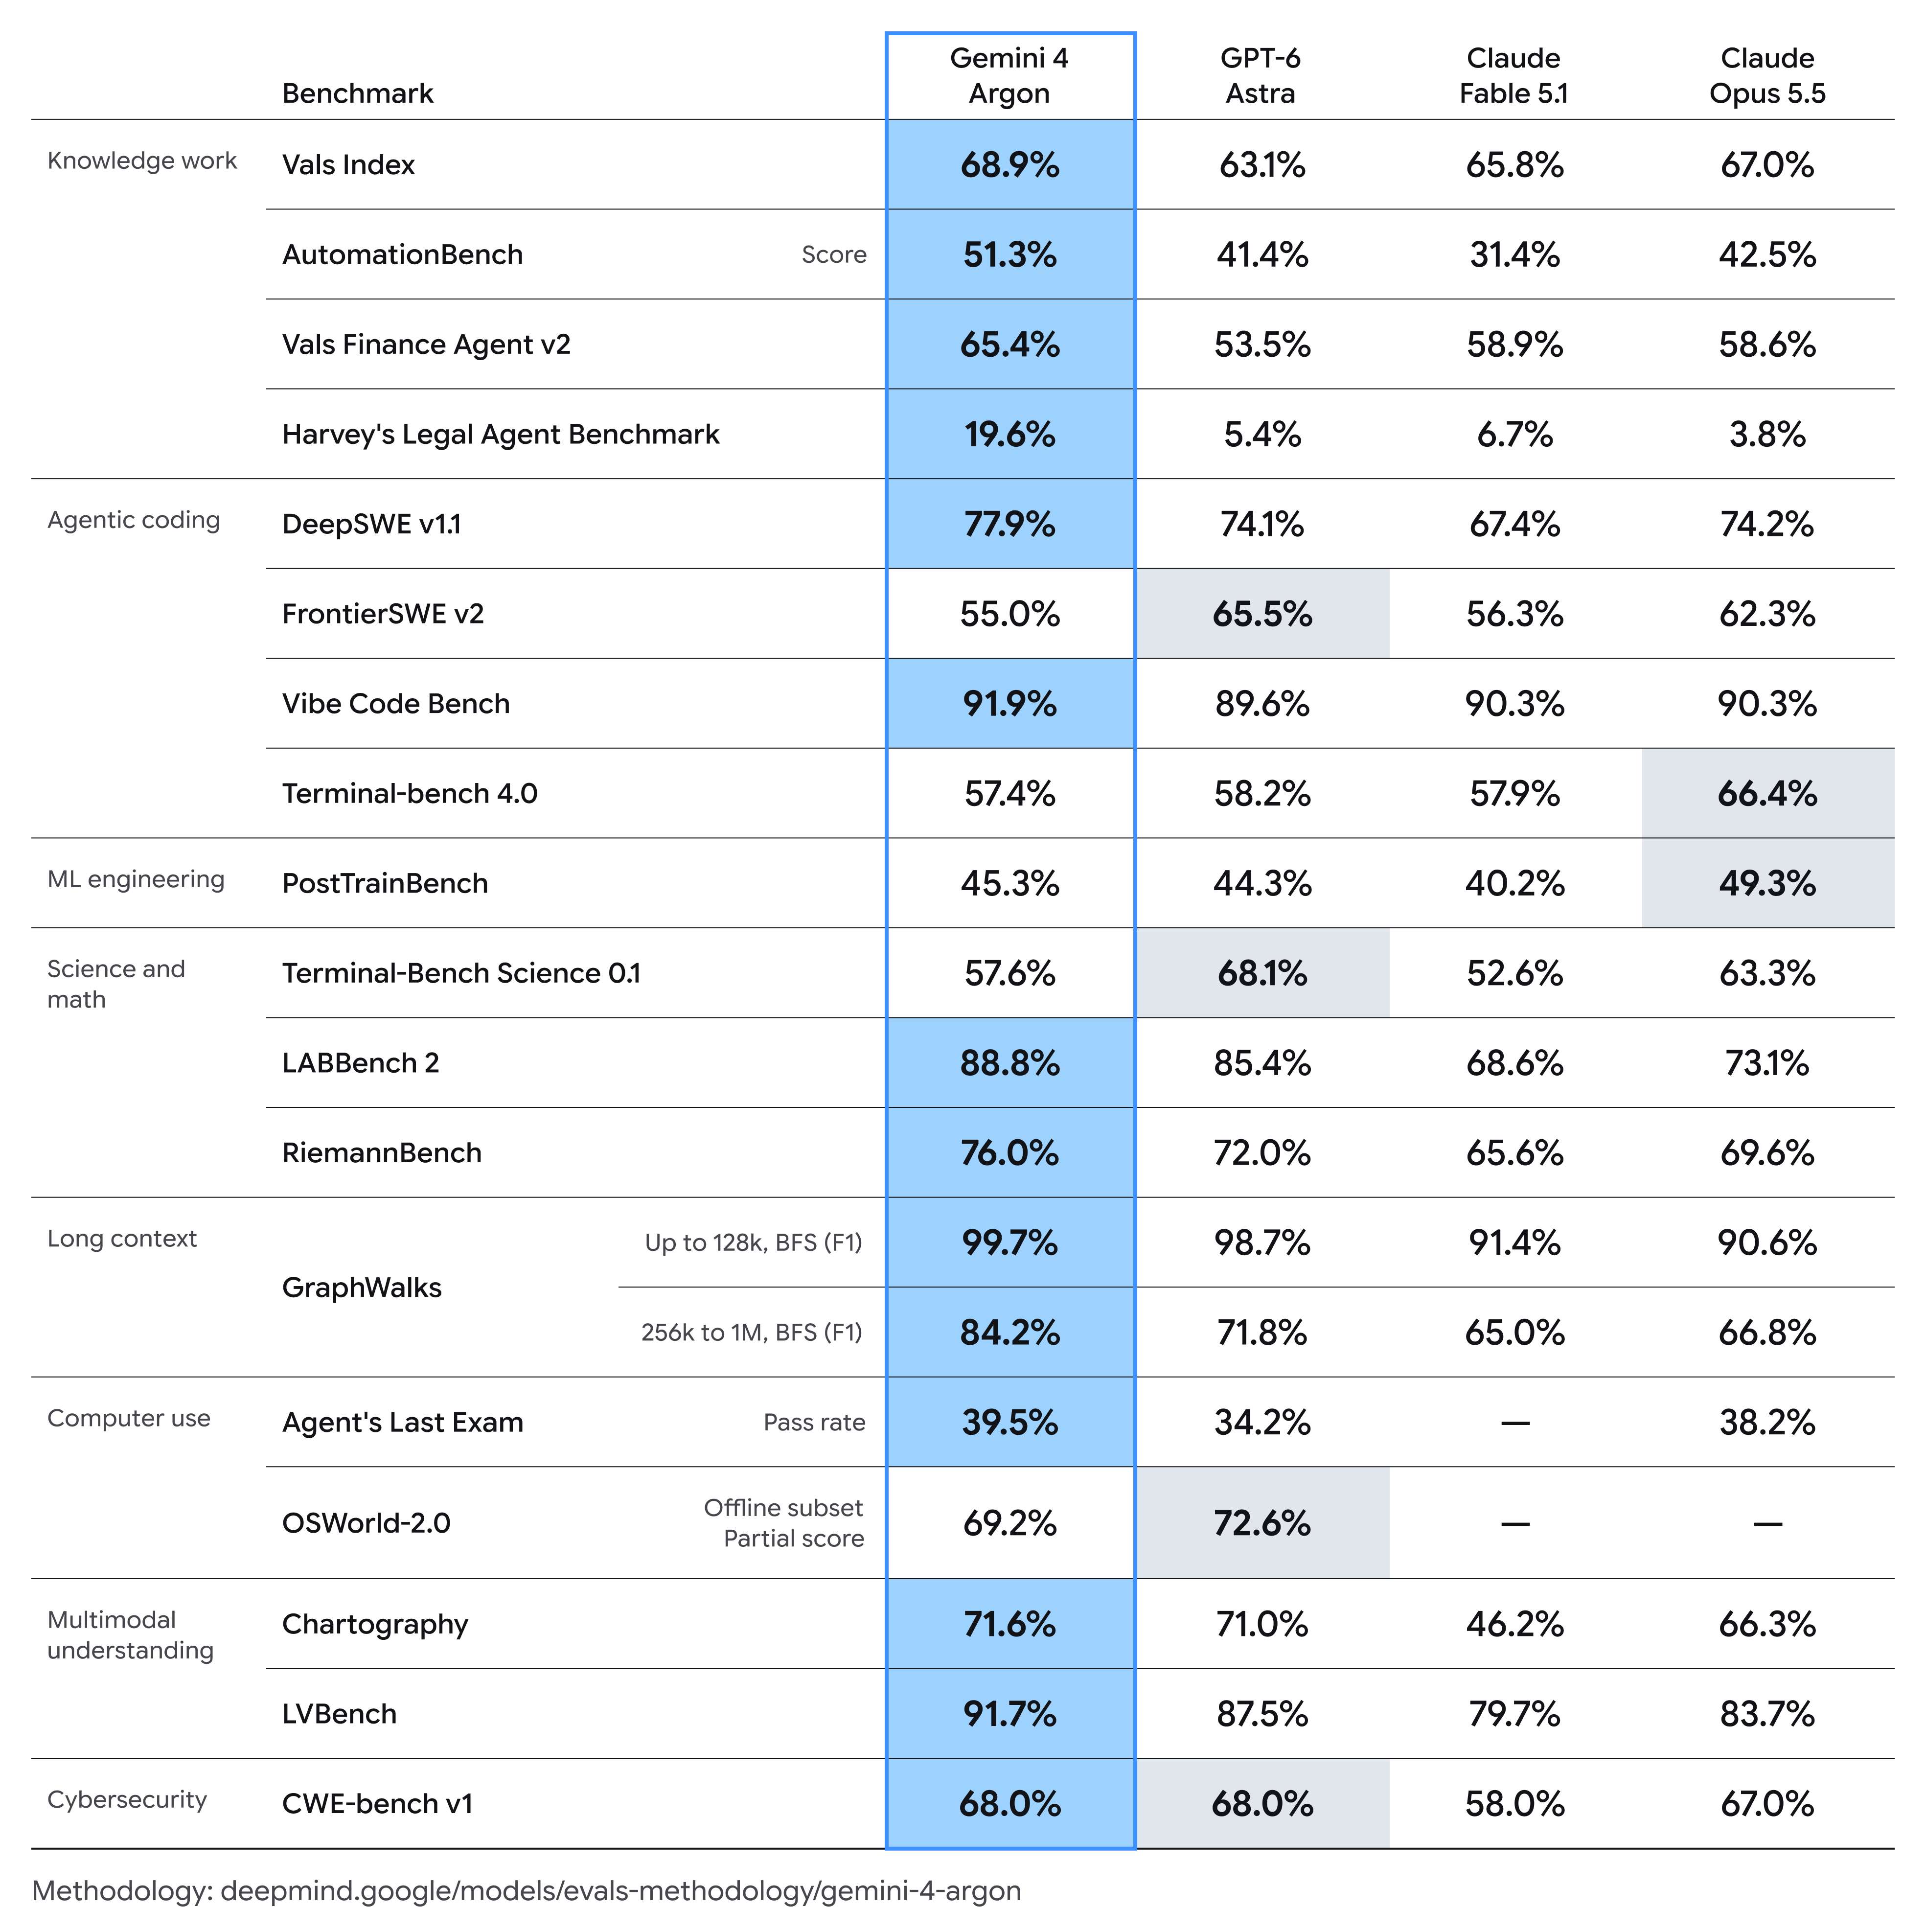
فيما يتعلق بالسعر، تكفي فقرة واحدة هنا. يكلف طلب بمطالبة 20,000 توكن و 5,000 توكن إخراج 20,000 × 2 دولار/مليون + 5,000 × 10 دولارات/مليون = 0.04 دولار + 0.05 دولار = 0.09 دولار بأسعار المقدمة، و 0.18 دولار بالأسعار القياسية 4 دولارات/20 دولارًا. سعر إخراج Argon التمهيدي (10 دولارات) يقع دون سعر Gemini 3.1 Pro Preview البالغ 12 دولارًا، وسعره القياسي يطابق Claude Opus 5.5 تمامًا. يعرض تحليل أسعار Gemini 4 Argon السيناريوهات الكاملة، بما في ذلك الإدخال المخبأ واستجابة بحد أقصى مليون توكن.
لا تبرمج معرف نموذج وجدته عبر الإنترنت بشكل ثابت
ابحث عن معرف نموذج Argon وستجد سلاسل نصية في مواقع الاختبار، والمجمعات، وطلبات السحب مفتوحة المصدر. هذه مجرد عناصر نائبة. تستخدم Vals AI معرفًا خاصًا بها لصفحة النموذج، ويضيف طلب سحب واحد في GitHub معرفًا "مؤقتًا"، ويؤدي المسار الشبيه بـ OpenRouter إلى صفحة غير موجودة. لم تؤكد Google أيًا منها، وتحذر عدة منافذ صراحةً من برمجة أي تخمين بشكل ثابت.
يفشل المعرف المخمن بأقل طريقة مفيدة: خطأ 404 في الإنتاج في يوم النشر، أو تراجع صامت إذا كان غلافك (wrapper) يلتقط الأخطاء بشكل واسع جدًا. احتفظ باسم النموذج في التكوين بدلاً من ذلك. في كل مثال أدناه، يأتي النموذج من متغير بيئة `GEMINI_MODEL` الذي يُعين افتراضيًا إلى `gemini-3.8-flash`، وهو نموذج مستقر يمكنك استدعاؤه اليوم. عندما تنشر Google معرف Argon، ستقوم بتغيير قيمة واحدة.
جهز شيفرتك على Gemini 3.8 Flash
يعمل Gemini 3.8 Flash (`gemini-3.8-flash`) على نفس نقاط النهاية والرؤوس وأشكال الاستجابة المتوقع أن يستخدمها Argon، بسعر 0.75 دولار / 3.75 دولار لكل مليون توكن حتى 31 ديسمبر 2026. يوجد مفتاحك في `GEMINI_API_KEY`؛ لا تلصقه أبدًا في الشيفرة. الإعداد الكامل موجود في دليل واجهة برمجة تطبيقات Gemini 3.8 Flash.
الخطوة 1: إرسال طلب Interactions API
Interactions API هي واجهة برمجة التطبيقات الأساسية لـ Google، وهي متاحة بشكل عام منذ يونيو 2026. احتفظ بكل من النموذج ومستوى التفكير في المتغيرات، لأن أسماء مستويات Argon لم يتم نشرها.
MODEL="${GEMINI_MODEL:-gemini-3.8-flash}"
THINKING="${GEMINI_THINKING:-medium}"

curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"model\": \"${MODEL}\",
    \"input\": \"List the retry rules a REST client should follow for HTTP 429.\",
    \"generation_config\": {\"thinking_level\": \"${THINKING}\"}
  }"
يتطلب حزمة Python SDK الإصدار `google-genai` 2.3.0 أو أحدث لـ Interactions API:
# pip install "google-genai>=2.3.0"
import os
from google import genai

MODEL = os.environ.get("GEMINI_MODEL", "gemini-3.8-flash")
THINKING = os.environ.get("GEMINI_THINKING", "medium")

client = genai.Client()  # reads GEMINI_API_KEY from the environment
interaction = client.interactions.create(
    model=MODEL,
    input="List the retry rules a REST client should follow for HTTP 429.",
    generation_config={"thinking_level": THINKING},
)
print(interaction.output_text)
في 3.8 Flash، المستويات الصالحة هي `low` و `medium` (الافتراضي) و `high`؛ يعيد `minimal` خطأ HTTP 400. يشرح دليل مستويات التفكير لدينا المقايضات. للعمل متعدد الأدوار، مرر معرف الاستجابة السابقة كـ `previous_interaction_id`، وأرسل `store: false` للانسحاب من التخزين على جانب الخادم.
الخطوة 2: الحفاظ على مسار generateContent يعمل
تستدعي معظم الشيفرات الموجودة نقطة نهاية `generateContent` القديمة، والتي تقول Google إنها لا تزال مدعومة بالكامل. إليك نفس الطلب:
curl -s "https://generativelanguage.googleapis.com/v1beta/models/${MODEL}:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"contents\": [{\"parts\": [{\"text\": \"List the retry rules a REST client should follow for HTTP 429.\"}]}],
    \"generationConfig\": {\"thinkingConfig\": {\"thinkingLevel\": \"${THINKING}\"}}
  }"
لاحظ مكان وجود التفكير: `generation_config.thinking_level` في Interactions، و `generationConfig.thinkingConfig.thinkingLevel` هنا. إذا كان عميلك يغلف كليهما، فوجه النماذج الجديدة عبر Interactions افتراضيًا. تحتاج تعريفات الأدوات نفس العناية؛ راجع استدعاء دوال Gemini 3.8 Flash.
الخطوة 3: جدولة فحص الانطلاق باستخدام models.list
لا تحدث سجل التغييرات يدويًا. اسأل واجهة برمجة التطبيقات. تعيد نقطة نهاية `models` النماذج المتاحة مع حدود التوكن الخاصة بها والطرق المدعومة:
import os, sys, requests

resp = requests.get(
    "https://generativelanguage.googleapis.com/v1beta/models",
    params={"pageSize": 1000},
    headers={"x-goog-api-key": os.environ["GEMINI_API_KEY"]},
    timeout=30,
)
resp.raise_for_status()
hits = [m for m in resp.json().get("models", []) if "argon" in m["name"].lower()]
for m in hits:
    print(m["name"], "in:", m.get("inputTokenLimit"),
          "out:", m.get("outputTokenLimit"), m.get("supportedGenerationMethods"))
sys.exit(1 if hits else 0)  # a failed run is the alert
قم بتشغيلها كل ساعة من cron أو جدول CI، باستخدام المفتاح الذي يستخدمه تطبيقك الإنتاجي. عندما قمنا بتشغيل هذا الاستدعاء في 1 أكتوبر 2026، باستخدام مفتاح مشروع مدفوع، أعاد 61 نموذجًا، لا يوجد `nextPageToken`، ولا اسم يحتوي على "argon". في اليوم الذي يتطابق فيه، يخبرك الإدخال بثلاثة أشياء في وقت واحد: اسم النموذج الحقيقي، وما إذا كان `outputTokenLimit` هو مليون كامل، وما هي الطرق المدرجة.
الخطوة 4: محاكاة الاستجابة لبناء العميل قبل الوصول
لا تحتاج إلى Argon لبناء الشيفرة التي تستهلك Argon. احفظ طلب الخطوة 2 في Apidog مع `GEMINI_API_KEY` و `GEMINI_MODEL` كمتغيرات بيئة، أرسله مرة واحدة مقابل 3.8 Flash، واستخرج الاستجابة الحقيقية إلى نقطة النهاية كمثال استجابة. ينشئ Smart Mock الافتراضي في Apidog البيانات من المخطط، لذا اضبط طريقة المحاكاة الافتراضية للمشروع على "استجابة المثال أولاً" (إعدادات المشروع، إعدادات الميزة، إعدادات المحاكاة). يعيد عنوان URL للمحاكاة بعد ذلك استجابتك المحفوظة، بحيث يمكن لواجهتك الأمامية، وعمال قائمة الانتظار، والمحللين أن يعملوا عليها دون إنفاق توكنات.
كن واضحًا بشأن ما هي هذه المحاكاة: هي مخطط استجابة Gemini الحالي، وليست مخططًا خاصًا بـ Argon، لأن Google لم تنشر واحدًا. لا يزال هذا هو الرهان الصحيح، حيث من المتوقع أن يكون Argon على نفس واجهة برمجة التطبيقات. لتجربة رد Argon ثقيل، قم بتحرير `usageMetadata` للمثال لإضافة أعداد كبيرة وتأكد من أن كود الفوترة والتنبيه يتفاعل.
الخطوة 5: التحقق من usageMetadata والحد الأقصى للتكلفة
يتضمن كل رد لـ `generateContent` بيانات `usageMetadata`. أضف سكربت معالجة لاحق في Apidog يقوم بتسعير كل رد بأسعار Argon القياسية، بحيث يفشل الاختبار قبل أن تحدث فاتورة:
// Apidog post-processor: price this response at Gemini 4 Argon's standard rates
const u = pm.response.json().usageMetadata;
const IN = 4 / 1e6;   // USD per input token after the intro period
const OUT = 20 / 1e6; // USD per output token; thinking bills as output on current Gemini models
const out = (u.candidatesTokenCount || 0) + (u.thoughtsTokenCount || 0);
const cost = u.promptTokenCount * IN + out * OUT;
pm.test("usageMetadata is present", () => pm.expect(u).to.be.an("object"));
pm.test("cost under $0.10 at Argon rates", () => pm.expect(cost).to.be.below(0.10));
اختر الحد الأقصى لكل طلب؛ 0.10 دولار يناسب مطالبة قصيرة مثل هذه. لم توضح Google كيفية فوترة توكنات التفكير في Argon، لذا يفترض السكربت القاعدة الحالية لـ Gemini. احتفظ بنفس الطلب المحفوظ وقم بتشغيله مقابل 3.8 Flash الآن و Argon لاحقًا: الفرق في عدد التوكنات والتكلفة هو مقارنة الانحدار الخاصة بك.
الأسئلة الشائعة
هل واجهة برمجة تطبيقات Gemini 4 Argon متاحة؟ ليست متاحة للعامة. يتم طرح Argon فقط لمجموعة من شركاء برنامج Fairwind، الذين يستخدمونه من خلال Gemini Enterprise. يأتي بعد ذلك عملاء API المدفوعين ومشتركي Google AI Ultra، بدون تاريخ محدد.
ما هو معرف نموذج Gemini 4 Argon؟ لم تنشر Google واحدًا. السلاسل النصية في مواقع الطرف الثالث هي مجرد عناصر نائبة، لذا احتفظ بالنموذج في متغير بيئة وراقب `models.list`.
كم ستبلغ تكلفة واجهة برمجة تطبيقات Gemini 4 Argon؟ 2 دولار للإدخال و 10 دولارات للإخراج لكل مليون توكن خلال فترة تمهيدية غير محددة المدة، ثم 4 دولارات و 20 دولارًا. الإدخال المخزن مؤقتًا بخصم 95%. راجع تسعير Gemini 4 Argon.
هل سيعمل Argon مع generateContent؟ لم تقل Google. تقول وثائقها إن جميع النماذج الجديدة تُطلق على Interactions API، لذا قم بالبناء على Interactions وتعامل مع `generateContent` كحل بديل.
هل يمنحني Google AI Ultra وصولاً إلى API؟ لا. AI Ultra هو اشتراك استهلاكي، وليس مفتاح API. تقول Google إن الوصول إلى API يبدأ مع عملاء API المدفوعين.
خطوتك التالية
عيّن `GEMINI_MODEL` في كل بيئة، وجدول فحص `models.list`، واحفظ طلبات Interactions و `generateContent` مع تأكيد التكلفة المرفق. قم بتنزيل Apidog للاحتفاظ بهذه الطلبات، والمحاكيات، والاختبارات في مساحة عمل واحدة، ثم قم بتغيير متغير واحد عندما تنشر Google المعرف.