
بالنسبة للمقارنة بين Claude Fable 5.2 و Opus 5.5، ابدأ بـ Opus 5.5 في أعمال البرمجة والمعرفة اليومية. جرّب Fable 5.2 عندما تتجاوز مهام الاستدلال الصعبة، أو عمليات الترحيل الغامضة، أو مشاريع الوكلاء الطويلة قدرات Opus الأساسية لديك. قارن بين إعدادات الجهد (effort) والتكلفة لكل نتيجة مقبولة قبل تحويل عبء عملك بالكامل.
تستند هذه التوصية إلى إعلان Anthropic عن Fable 5.2، الذي تم التحقق منه في 10 نوفمبر 2026. هذه مقارنة قائمة على المصادر؛ ولم نُجرِ اختبار مقارنة مستقلاً مباشراً بين النموذجين. أما مقارنتنا السابقة بين Opus 5 و Fable 5 فتغطي الجيل الأقدم. أما الأسعار والإعدادات الافتراضية والأدلة الواردة أدناه فتنطبق على هذه الإصدارات الأحدث.
مقارنة سريعة بين Claude Fable 5.2 و Opus 5.5
| نقطة القرار | Claude Fable 5.2 | Claude Opus 5.5 |
|---|---|---|
| الدور الافتراضي | مهام الاستدلال الصعبة وأعمال الوكلاء الطويلة | الخيار الافتراضي لمعظم أحمال العمل |
| معرّف النموذج في Claude API | claude-fable-5-2 |
claude-opus-5-5 |
| الإدخال القياسي، لكل مليون رمز (token) | 8 دولارات | 4 دولارات |
| الإخراج القياسي، لكل مليون رمز | 40 دولاراً | 20 دولاراً |
| الجهد الافتراضي في API | مرتفع (High) | متوسط (Medium) |
| نافذة السياق | مليون رمز | مليون رمز |
| الحد الأقصى للإخراج | 128 ألف رمز | 128 ألف رمز |
| تصنيف زمن الاستجابة المقارن | متوسط | متوسط |
المصدر: نظرة عامة الحالية على نماذج Claude. كلا النموذجين يقبل النصوص والصور، ويولّد نصوصاً، ويدعم الأدوات، ويستخدم التفكير التكيّفي الدائم. لذا فإن حجم نافذة السياق لا يميّز بينهما؛ بل قدرتهما على إنجاز مهمتك المحددة هي ما يهم.
أسعار الرموز القياسية لـ Fable تبلغ ضعف أسعار Opus. هذا يجعل Opus نقطة البداية المنطقية عندما يحقّق كلا النموذجين معايير القبول لديك بحجم رموز متقارب. لكنه لا يحدد أيهما يكلّف أقل عندما يختلف عمق الاستدلال وعدد المحاولات ونداءات الأدوات.
ما مهام البرمجة التي تبرّر التحوّل إلى Fable 5.2؟
استخدم Opus للتغييرات المحدودة الواضحة والمزوّدة بفحوصات واضحة. جرّب Fable عندما يتعيّن على الوكيل اكتشاف المشكلة بنفسه، أو تنسيق عدة تغييرات مترابطة، أو التعافي من نهجٍ فاشل. هذه توصيات لأحمال عمل مستنتجة من توجيهات Anthropic ونتائجها، وليست ضمانات مُقاسة لمستودعك البرمجي.
| مهمتك | الخيار الابتدائي | الدليل الذي يبرّر التصعيد |
|---|---|---|
| إضافة نقطة نهاية موثّقة | Opus 5.5 | تكرار إخفاقات العقود أو التكامل |
| تحديث الاختبارات بعد إعادة هيكلة صغيرة | Opus 5.5 | عجز الوكيل عن تحديد الثابت (invariant) المتغيّر |
| تصحيح خلل متقطّع عبر خدمات متعددة | Opus أولاً، ثم Fable | يكرّر Opus الإصلاحات دون اختبار الأسباب البديلة |
| ترحيل خدمة ذات تبعيات غير واضحة | قارن بين الاثنين | ينجز Fable تغييرات مقبولة أكثر ضمن الميزانية |
| تنسيق مشروع تقني طويل | جرّب Fable تجريبياً | تخطيط أفضل يصمد أمام التنفيذ والمراجعة |
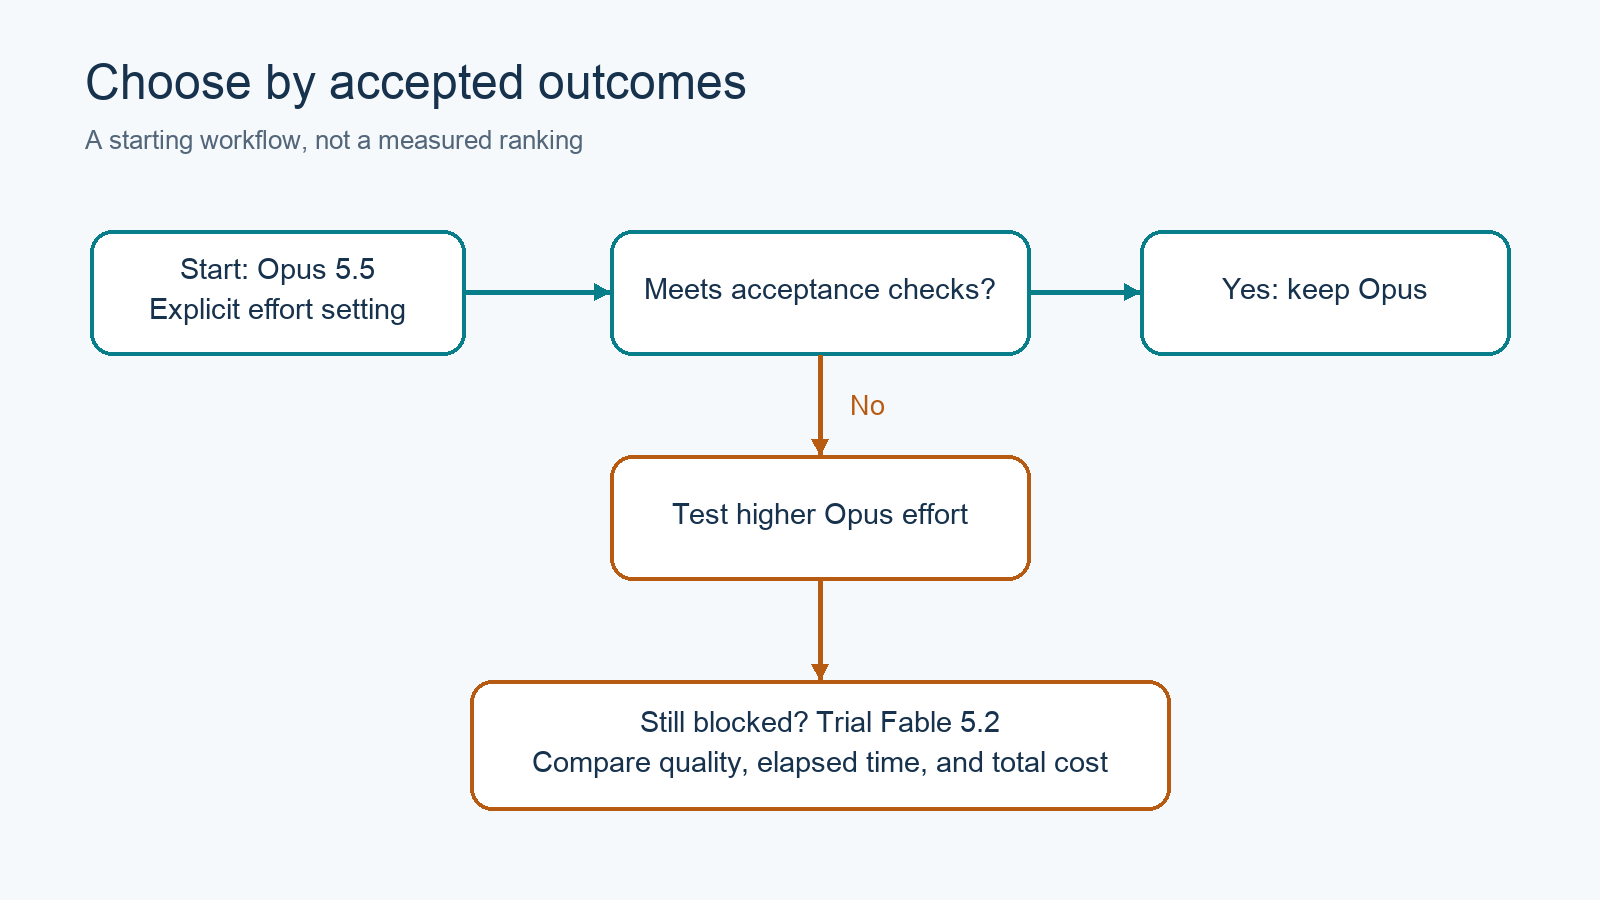
تصعيد انتقائي: أبقِ المهام الروتينية على خط الأساس لديك، وأرسل المهام الصعبة إلى النموذج الذي يجتاز فحوصاتك.
خذ بعين الاعتبار webhook للدفع يعالج حدثاً معيناً مرتين بشكل متقطّع. إذا كان الإصلاح المطلوب محدّداً مسبقاً، فالمهمة أمام Opus مهمة برمجية محدودة النطاق. أما إذا اضطُر الوكيل إلى إعادة بناء سلوك التزامن عبر المحاولات المتكررة والتخزين والخدمات اللاحقة، فالتحقيق مرشّح أقوى لتجربة Fable.
امنح كلا النموذجين أدلة الحادث والقيود نفسها. فالنموذج الأغلى لا يعوّض غياب السجلات، أو التبعيات غير المتاحة، أو اختبار قبولٍ يكافئ السلوك الخاطئ.
ماذا تُظهر معايير Anthropic القياسية؟
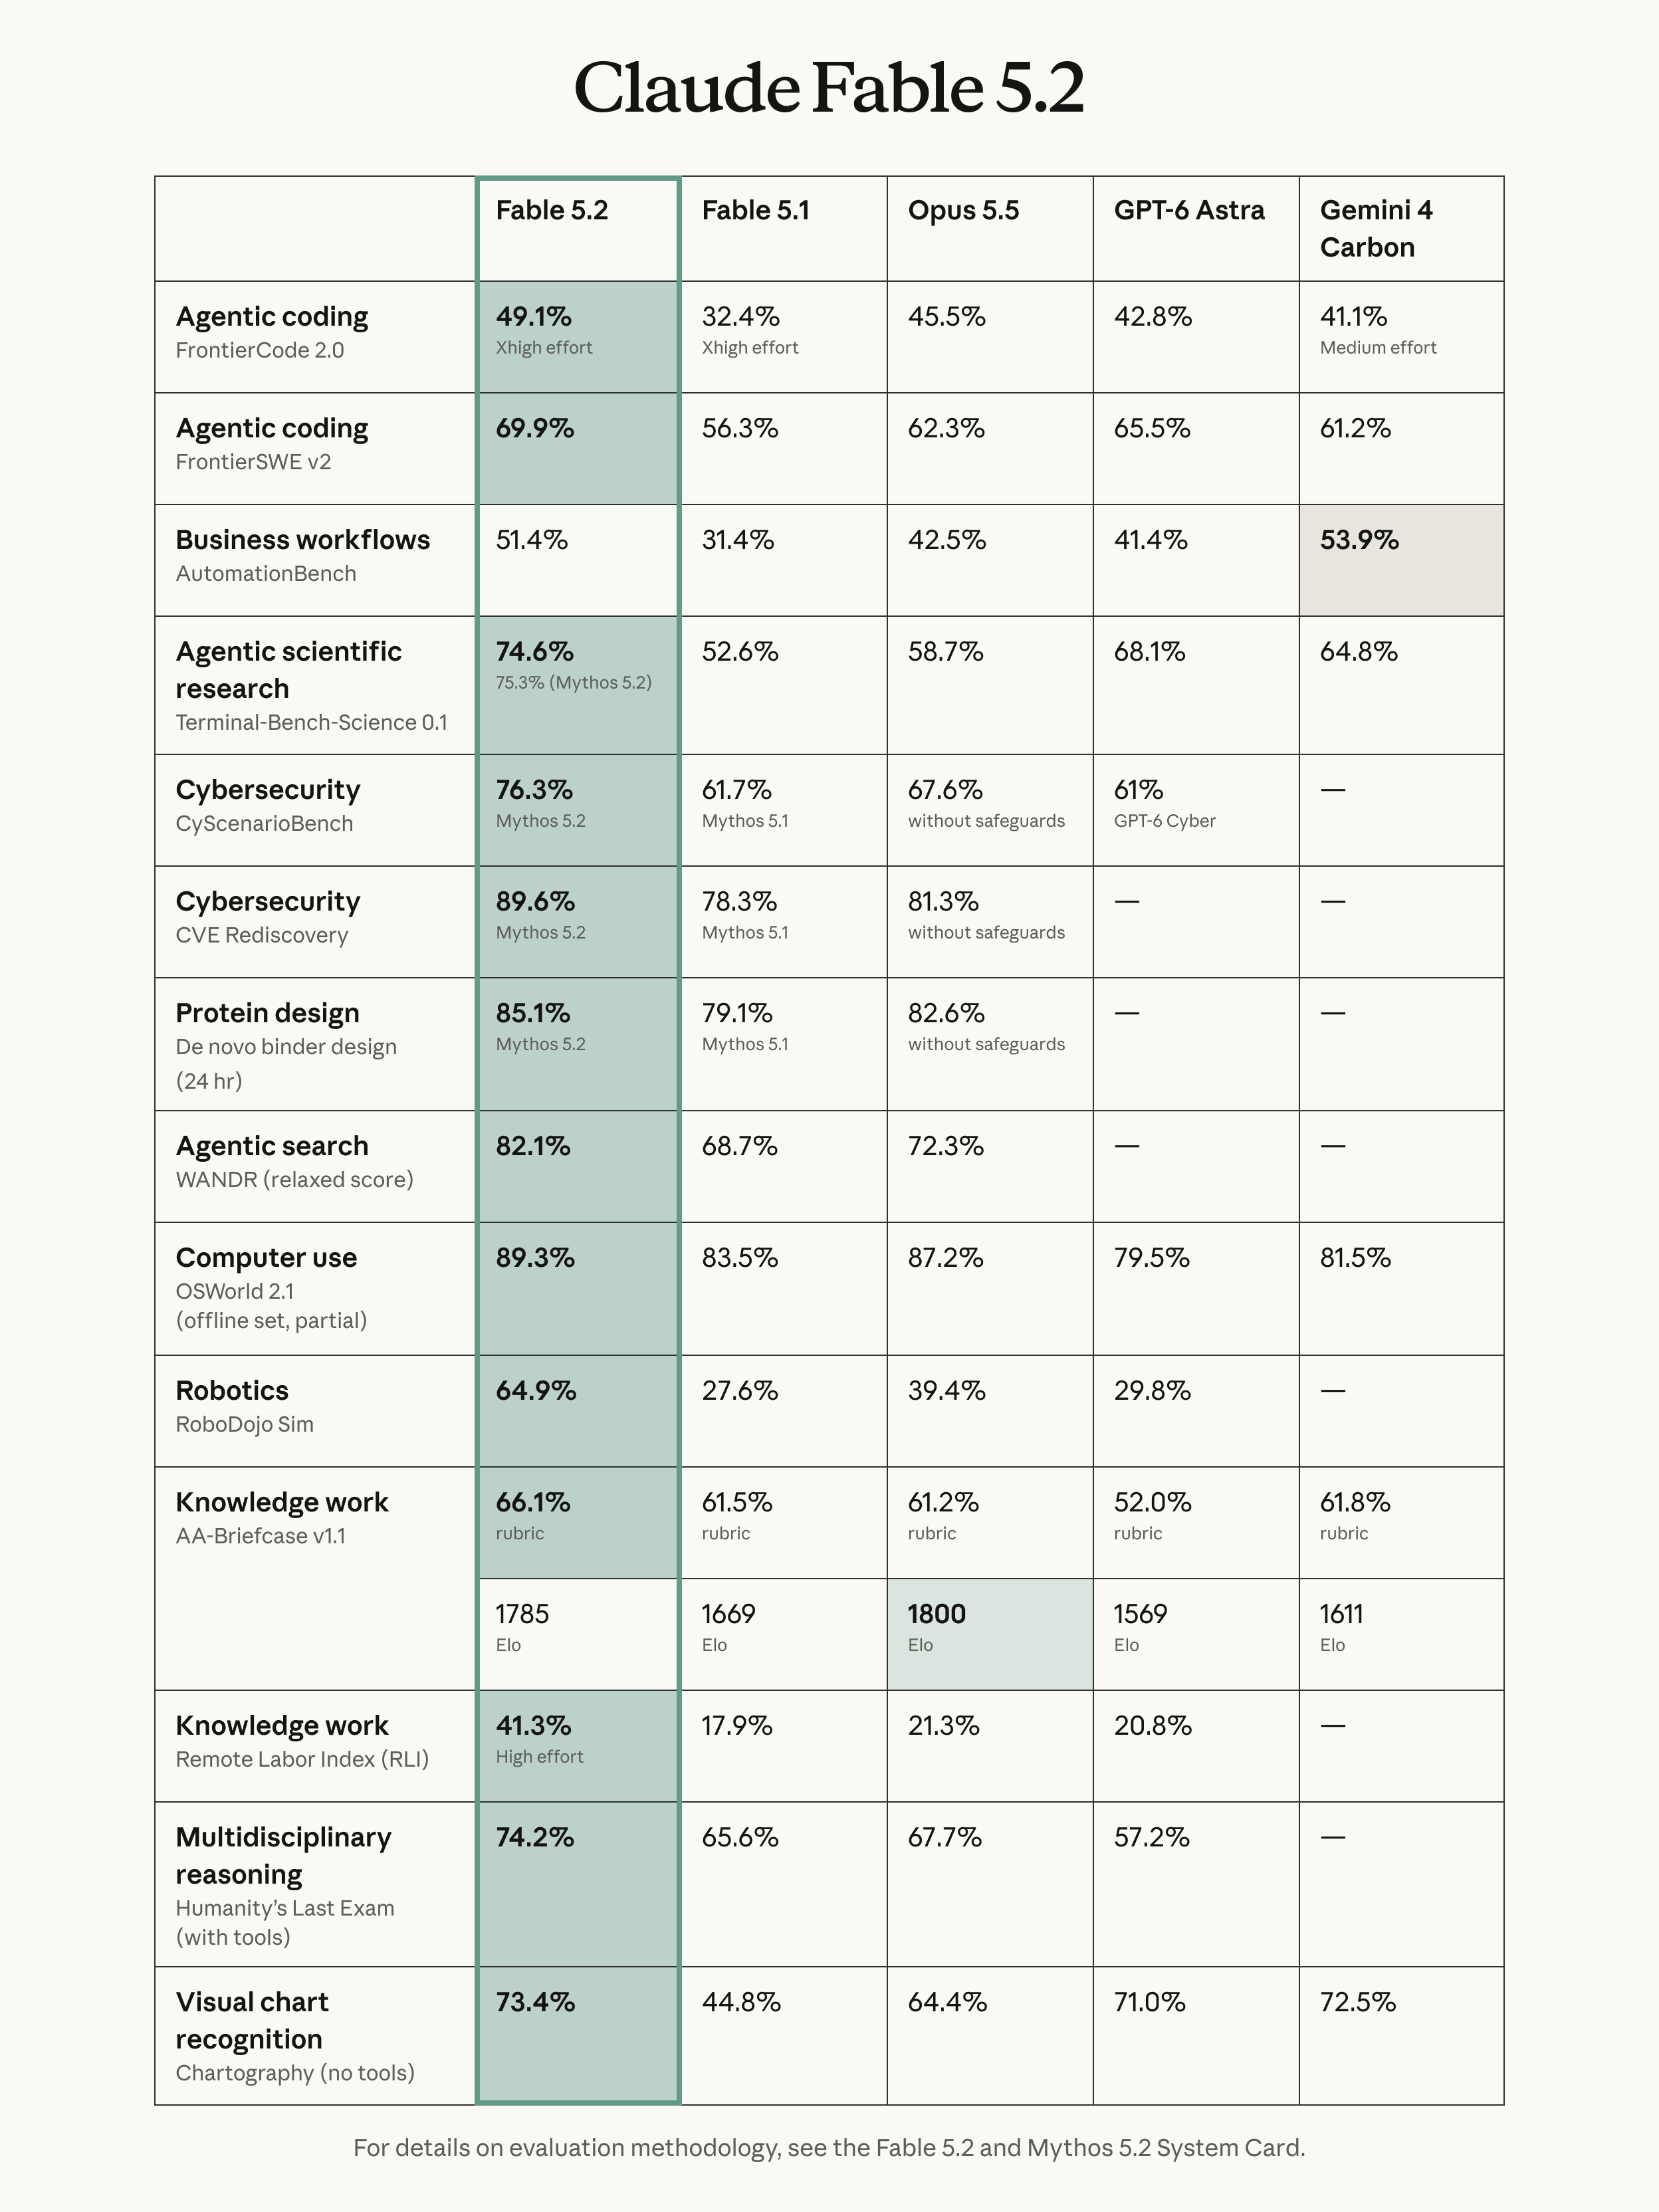
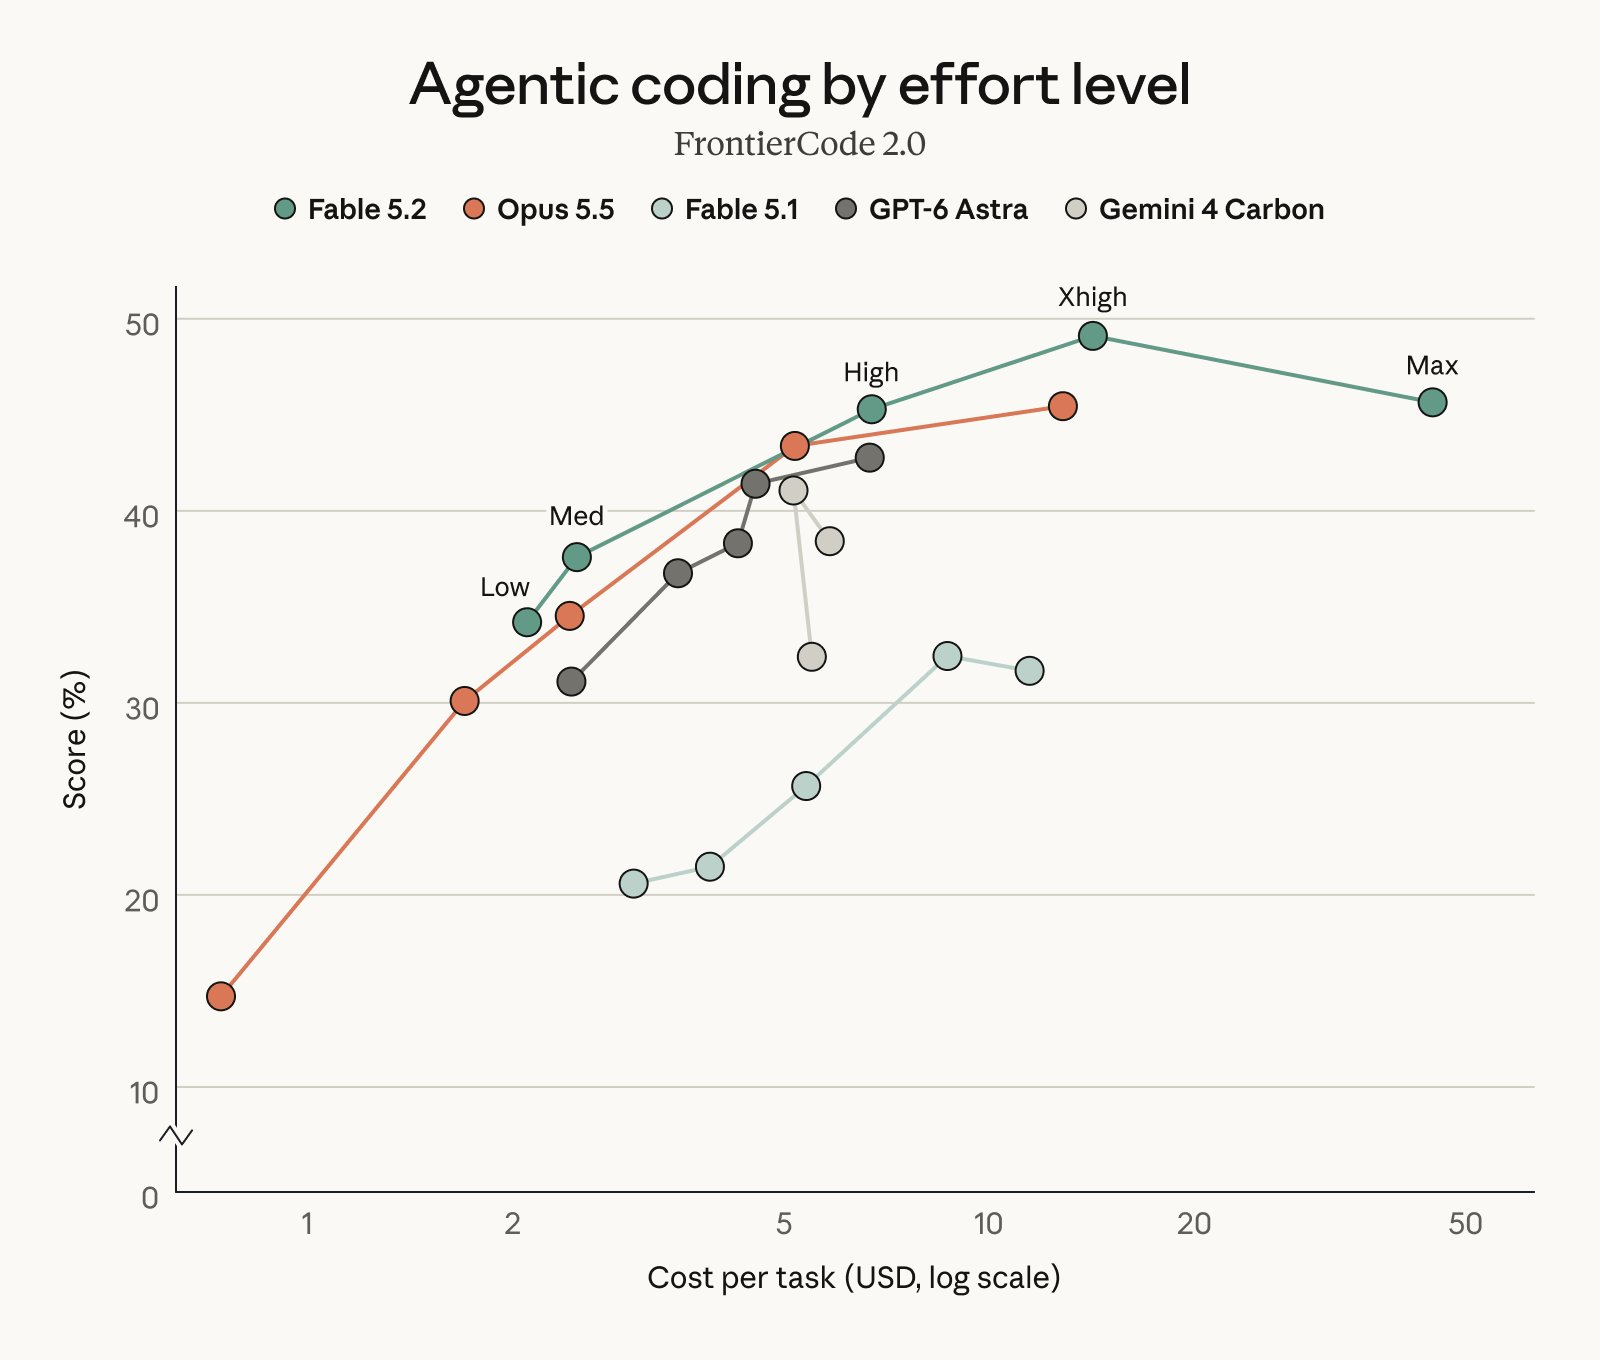
تعلن Anthropic عن نتائج أعلى لـ Fable 5.2 في عدة تقييمات للبرمجة والاستدلال. الإشارة العملية الأقوى هي نتيجة الجهد مقابل التكلفة: Fable عند مستوى High يكاد يوازي Opus عند مستوى Max على FrontierCode 2.0 بتكلفة لكل مهمة تقارب النصف، وفق الاختبارات المبكرة من Anthropic.
| التقييم المُعلن من الشركة | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0، برمجة بالوكلاء | 49.1% عند Xhigh | 45.5% |
| FrontierSWE v2، برمجة بالوكلاء | 69.9% | 62.3% |
| WANDR، بحث بالوكلاء، النتيجة الموسّعة | 82.1% | 72.3% |
| OSWorld 2.1، مجموعة جزئية دون اتصال | 89.3% | 87.2% |
هذه الأرقام واردة في الإعلان، الذي يوضح أن النتائج تُحتسب بأعلى مستوى جهد متاح ما لم يُذكر خلاف ذلك. وهي تصف ظروف تقييم Anthropic، لا الإعدادات الافتراضية ولا معدل النجاح المتوقع في مهامك.
مقارنة التكلفة أضيق نطاقاً. Fable عند High يحقق 45.3%، مقابل 45.5% وهي أفضل نتيجة لـ Opus. هذا يدعم اختبار الإعدادات الأرخص لهذا التقييم تحديداً، لكنه لا يعني أن كل سير عمل في Fable يكلّف نصف تكلفته في Opus.
تجنّب تحويل نسبة معيار قياسي إلى توقع للإنتاجية. فدرجة برمجية لا تقيس قائمة المراجعات لديك، ولا مخاطر النشر، ولا الوقت المستغرق في إصلاح عملية ترحيل خاطئة. واحرص أيضاً على إبقاء نتائج الأمن السيبراني والأحياء الخاصة بنموذج Mythos خارج حصيلة Fable: فالإعلان يشير إلى نموذج أساس مشترك لكن مع ضوابط ووصول مختلفين.
إعدادات الجهد تغيّر شكل المقارنة
اضبط مستوى الجهد صراحةً عند مقارنة النماذج. الإعدادات الافتراضية في API هي High لـ Fable 5.2 و Medium لـ Opus 5.5. ويذكر إعلان Anthropic على حدة أن Medium هو الافتراضي في تطبيقات Claude و Claude Code. سجّل المنتج والإعداد بدل افتراض أن إعداداً افتراضياً واحداً ينطبق على كل مكان.
تُعرّف وثائق الجهد المستويات low و medium و high و xhigh و max لكلا النموذجين. يؤثر الجهد في نص الاستجابة ومعاملات الأدوات والتفكير، وهو إشارة سلوكية وليس حدّ إنفاق صارماً.
ابدأ بإعداد Opus العامل لديك. إذا لم يكن كافياً، قارن مستوى جهد أعلى لـ Opus مع Fable عند Medium أو High. واحفظ تجارب Xhigh و Max للمهام التي يكون فيها للاستدلال الإضافي فائدة محتملة، وتستطيع تحمّل تكلفته.
المقارنة عند جهد متكافئ تجيب عن سؤال واحد: كيف يتصرف هذان النموذجان تحت الإعداد المسمّى نفسه؟ أما المقارنة بتكلفة متكافئة فتجيب عن سؤال آخر: أي إعداد ينتج أقوى نتيجة مقبولة ضمن ميزانيتك؟ ولا تغني إحداهما عن الأخرى.
زمن الاستجابة: قِس المهمة بأكملها
يحمل كلا النموذجين تصنيف "متوسط" لزمن الاستجابة المقارن في نظرة Anthropic العامة. لا يوجد فائز شامل بناءً على هذا التصنيف. قِس الوقت اللازم للوصول إلى نتيجة مُراجَعة، بما يشمل الأدوات والمحاولات المتكررة، بدل اعتبار سرعة الإخراج هي سرعة سير عمل التطوير كاملاً.
تقول Anthropic إن Fable 5.2 يولّد الإخراج أسرع بنسبة تصل إلى 30% من Fable 5.1. وهذه مقارنة بسابقه، لا بـ Opus 5.5. كما أن وضع السرعة الاختياري (fast mode) يوفر سرعة توليد رموز أعلى تصل إلى 2.5 مرة، وهي أيضاً ادعاء من الشركة وليس قياساً فعلياً لتقصير مدة مهمتك.
فالمهمة التي يهيمن عليها التجميع أو قاعدة بيانات بطيئة لن تتسارع بمقدار تسارع توليد الرموز. وعلى النقيض، وكيلٌ يتجنّب نهجين فاشلين قد ينتهي أسرع رغم توليده للرموز ببطء أكبر. تتبّع هذين الجانبين بشكل منفصل قبل دفع علاوة السرعة.
قارن التكلفة لكل نتيجة مقبولة
اجعل مقياس قرارك هو إجمالي إنفاق سير العمل مقسوماً على النتائج المقبولة. فأسعار الرموز تحدد المعدل، لكن حجم الرموز والتخزين المؤقت والمحاولات الفاشلة والأدوات والمراجعة هي التي تحدد ما تشتريه فعلياً. الحساب التالي توضيحي، وليس قياساً لسلوك أي من النموذجين.
افترض أن طلباً واحداً يستهلك 100,000 رمز إدخال غير مُخزّن مؤقتاً و10,000 رمز إخراج، مع توجيه عالمي قياسي وبدون رسوم أدوات إضافية:
| الإعداد | تكلفة الإدخال | تكلفة الإخراج | الإجمالي |
|---|---|---|---|
| Opus 5.5 قياسي | 0.40 دولار | 0.20 دولار | 0.60 دولار |
| Fable 5.2 قياسي | 0.80 دولار | 0.40 دولار | 1.20 دولار |
| Opus 5.5 سريع | 0.80 دولار | 0.40 دولار | 1.20 دولار |
| Fable 5.2 سريع | 1.60 دولار | 0.80 دولار | 2.40 دولار |
تم التحقق من الأسعار عبر وثائق أسعار Anthropic في 10 نوفمبر 2026. أما حدود الاشتراكات فمنفصلة عن أسعار API هذه. وقد تغيّر الفاتورة بناءً على مزوّدي الخدمات السحابية والتخزين المؤقت وخيارات توطين البيانات وميزات أخرى.
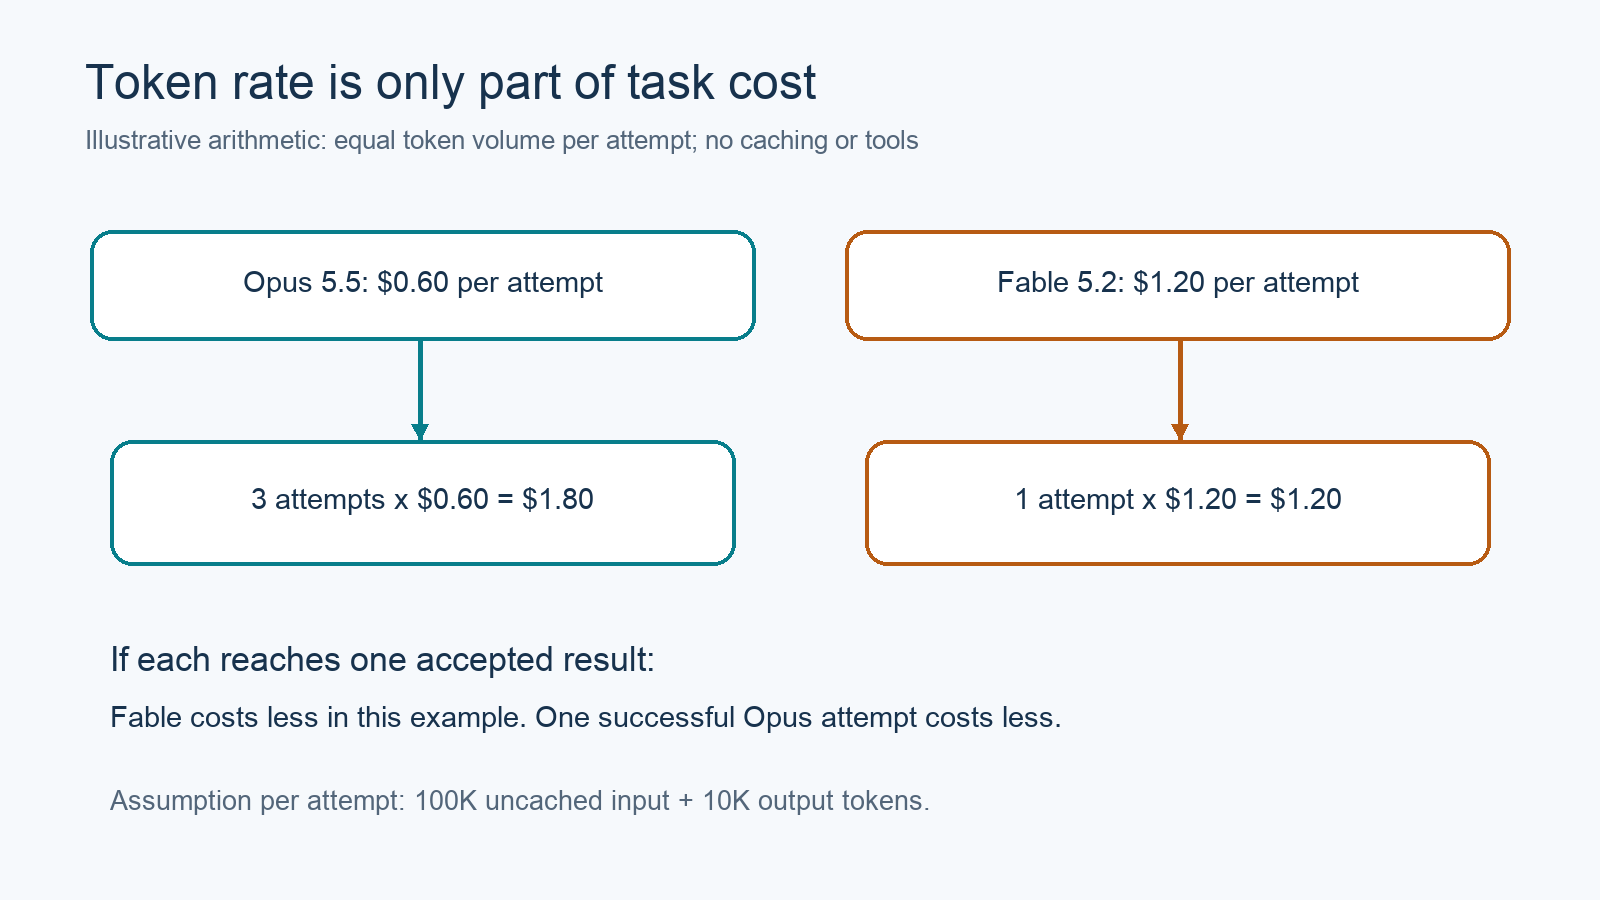
قارن جميع المحاولات اللازمة للوصول إلى نتيجة ناجحة، بما فيها المحاولات المتكررة والمراجعة.
في هذا المثال المبسّط، تكلف ثلاث محاولات متطابقة الحجم من Opus ما قيمته 1.80 دولار، بينما تكلف محاولة واحدة من Fable 1.20 دولار. ذلك يجعل Fable أرخص فقط إذا وصل إلى النتيجة المقبولة في تلك المحاولة الواحدة؛ فمحاولة Opus الناجحة الواحدة تبقى أرخص. أما في الواقع، فالمحاولات المتكررة غالباً ما تستهلك أحجاماً مختلفة، لذا اعتمد على الاستهلاك المسجّل بدل ضرب متوسطٍ متخمّص في عدد المحاولات.
ضع وقت المراجعة الهندسية بجانب إنفاق API. فترقيعٌ يجتاز الاختبارات لكنه يتطلب تصحيحاً كبيراً لم يجتز المعيار نفسه الذي يجتزه ترقيعٌ جاهز للمراجعة.
دع وكيل البرمجة لديك يفحص الـ API عبر Apidog CLI
استخدم Apidog CLI ليقوم وكيل البرمجة لديك بإنشاء وتشغيل فحوصات API قابلة للتكرار. يمكن لهذه الفحوصات الكشف عن تراجعات في الطلبات أو الاستجابات عند تبديل النماذج. لكنها لا تثبت صحة تغييرات الوكيل في المستودع؛ حافظ على اختبارات المستودع والمراجعة البشرية إلى جانبها.
ثبّت CLI، ثم دع وكيلك يقرأ دليل التثبيت الرسمي:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
امنح Claude Code أو وكيلك المفضل هذا الأمر (prompt):
Read https://apidog.com/apidog-cli-installation-guide.md.
In project <PROJECT_ID>, create a test case for our Claude Messages
request. Compare claude-opus-5-5 and claude-fable-5-2 using the same
prompt and explicit medium effort. Keep API credentials in private
variables. Assert the expected status and response structure, record
usage and elapsed time, and summarize failures. Don't claim these
checks measure coding quality. Validate every write payload first.
يتحقق الوكيل من المخطط (schema)، ويختار فئة صالحة لحالة الاختبار، وينشئ ملف case.json، ثم يشغّل أوامر مثل هذه. تم التحقق من الخيارات (flags) مقابل مساعدة الإصدار المثبّت CLI 2.2.12:
apidog test-case category --project <PROJECT_ID>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <PROJECT_ID> --file case.json
apidog run --test-case <CASE_ID> --project <PROJECT_ID> \
  -e <ENVIRONMENT_ID> -r cli,json
استبدل العناصر النائبة بموارد مشروعك. هذا قالب لسير عمل، وليس مقارنة نماذج منفّذة فعلياً. راجع دليل استخدام Apidog CLI في Claude Code أو دليل التكامل مع Codex لإعداد الوكيل.
الأسئلة الشائعة
هل Fable 5.2 أفضل من Opus 5.5 في جميع مهام البرمجة؟
لا. توصي Anthropic باستخدام Opus 5.5 لمعظم مهام البرمجة والمعرفة. أما Fable فيستحق التجربة عندما تتجاوز المهام الصعبة خط الأساس هذا. ودرجاته الأعلى في معايير الشركة القياسية لا تضمن نتيجة أفضل في كل مهمة.
هل تكلفة Fable 5.2 ضعف التكلفة؟
أسعار الرموز القياسية للإدخال والإخراج لديه ضعف أسعار Opus 5.5. لكن التكلفة الإجمالية للمهمة قد تختلف، لأن الإعدادات المختلفة تستهلك أحجام رموز مختلفة وتتطلب أعداد محاولات مختلفة.
هل يجب دائماً استخدام أقصى جهد؟
لا. قارن الإعدادات مقابل فحوصات القبول والميزانية لديك. فالجهد الأعلى يسمح بإنفاق رموز أكبر، لكنه لا يضمن تحسناً مفيداً في مهمة محدودة النطاق.
هل Fable 5.2 أسرع من Opus 5.5؟
المصادر المراجَعة هنا لا تثبت وجود فائز شامل في زمن الاستجابة بين النموذجين. كلاهما يحمل تصنيف زمن استجابة "متوسط". قِس سير عملك الفعلي، وتعامل مع وضع السرعة كإعداد منفصل.
هل يمكن لـ Apidog تحديد أي نموذج يكتب كوداً أفضل؟
يمكن لـ Apidog CLI مساعدة وكيلك في تشغيل فحوصات API وجمع أدلة من الاستجابات. أما جودة الكود فما زالت تتطلب اختبارات المستودع والمراجعة. استخدم تلك النتائج المقبولة لتقرير أي نموذج ومستوى جهد يستحقان تكلفتَهما.