
تبيع Cerebras رقمًا واحدًا: السرعة. الفكرة الترويجية هي أن رقائقها بحجم الرقاقة الكاملة (wafer-scale) تُخرج الرموز (tokens) أسرع مما تستطيع أي مجموعة من وحدات معالجة الرسوميات (GPU cluster) أن تفعل، والطبقة المجانية هي وسيلة الشركة لجعلك تلاحظ ذلك. لكن "السرعة" ليست شيئًا ينبغي أن تأخذه بكلمة بائع. إنها شيء تقيسه، على اتصالك الخاص، وبالموجّه (prompt) الخاص بك، ثم تحفظه كسجل يمكنك إعادة تشغيله في كل مرة تُطلق فيها Cerebras نموذجًا جديدًا أو تغيّر حدًا من الحدود.
هذا الدليل يقوم بهذا القياس معك. ستحصل على مفتاح Cerebras API، وتُجري استدعاء إكمال محادثة (chat completion) حقيقيًا على نقطة النهاية المتوافقة مع OpenAI، وتقيس زمن أول رمز والاستجابة الكاملة، وتجعل وكيل البرمجة الخاص بك يحوّل الطلب بأكمله إلى اختبار عبر Apidog CLI بحيث يصمد أمام تبديل النموذج القادم.
باختصار
تمنح Cerebras الحسابات الجديدة طبقة "التجربة المجانية" (Free Trial): رصيد بقيمة 5 دولارات تنتهي صلاحيته بعد 30 يومًا من منحه، ومقصور على نموذجين (gpt-oss-120b وqwen-3.8-27b) بمعدل 5 طلبات في الدقيقة و30 ألف رمز غير مُخزَّن مؤقتًا (uncached) في الدقيقة لكل نموذج، وفقًا لحدود المعدل المنشورة من Cerebras. واجهة API متوافقة مع OpenAI على https://api.cerebras.ai/v1، لذا يمكنك توجيه عميل OpenAI الحالي إليها بتغيير ثلاثة أسطر. أدناه، ستبني طلبًا يقيس زمن الوصول إلى أول رمز (time-to-first-token) والرموز في الثانية بنفسك، بدلًا من الثقة بصفحة تسويقية.
ما توثّقه الطبقة المجانية، وما لا توثّقه
تعرض صفحة أسعار Cerebras أرقامها من جهة العميل (client-side)، ما يعني أن سعر المليون رمز بالدولار للاستخدام المدفوع ليس شيئًا يمكنك استخراجه من جلب ثابت (static fetch) للصفحة. لا تخمّن هذا الرقم. عندما تحتاجه، افتح تبويب الفوترة في لوحة تحكم Cerebras Cloud بنفسك، لأنها المكان الوحيد المضمون دقته لمعرفة السعر الحالي.
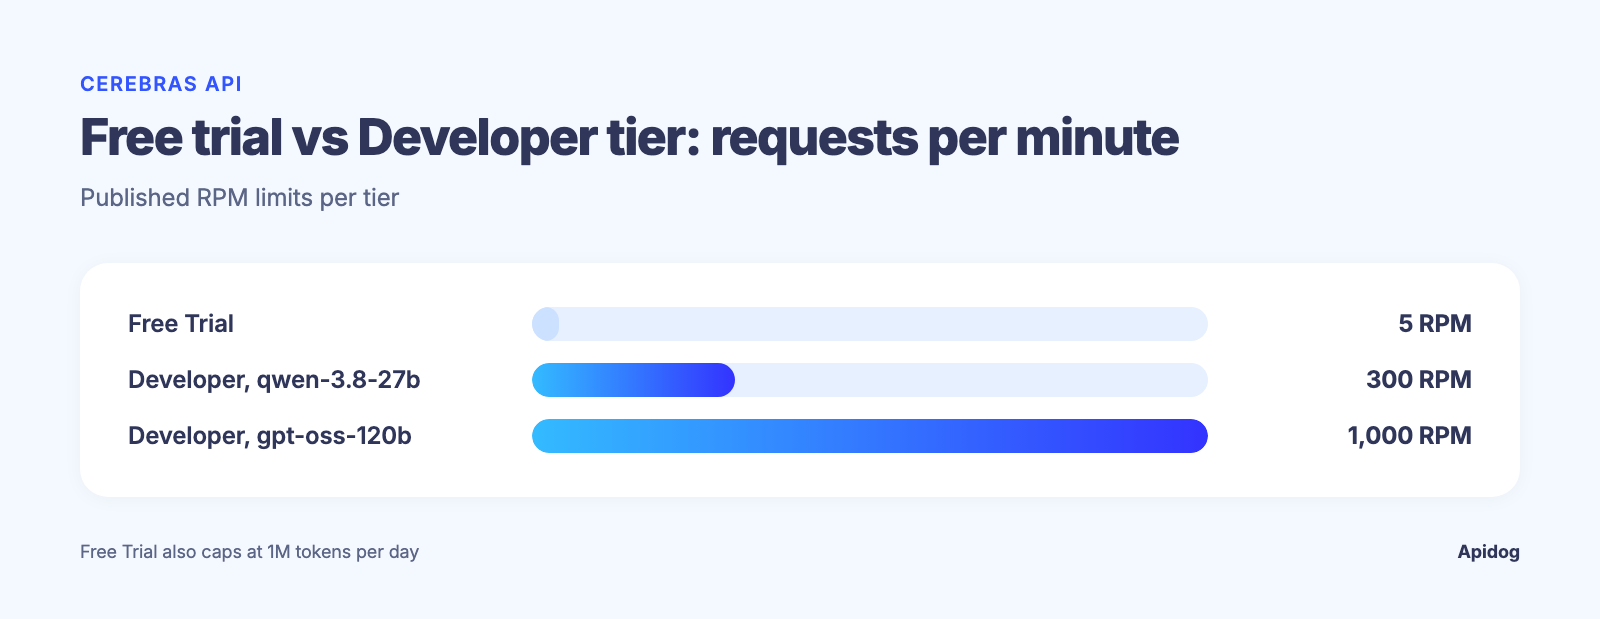
ما تذكره الوثائق بوضوح، في صفحة حدود المعدل في الدعم، هو شكل طبقة التجربة المجانية:
| الطبقة | النماذج | RPM | TPM غير المُخزَّن | إجمالي TPM | TPH | TPD |
|---|---|---|---|---|---|---|
| التجربة المجانية | gpt-oss-120b, qwen-3.8-27b |
5 | 30K | 90K | 1M | 1M |
المطوّر (gpt-oss-120b) |
الدفع حسب الاستخدام | 1,000 | 1M | 3M | لا يوجد | لا يوجد |
المطوّر (qwen-3.8-27b) |
الدفع حسب الاستخدام | 300 | 150K | 450K | لا يوجد | لا يوجد |
هناك أمران مهمان هنا. أولًا، "TPM غير المُخزَّن" هو السقف الحقيقي: إنها الرموز التي تحتاج حسابًا كاملًا، وبدل رموزك الإجمالي في الدقيقة يساوي نحو ثلاثة أضعاف هذا الرقم بعد احتساب إصابات الذاكرة المؤقتة (cache hits). ثانيًا، حساب التجربة المجانية محدود بالرصيد والوقت، وليس بالطلبات إلى الأبد: بمجرد نفاد الـ5 دولارات أو مرور 30 يومًا، تهبط إلى ما تسمح به طبقة حسابك حتى تضيف وسيلة دفع. كل ما هو أبعد من هذا الجدول (التسعير لكل رمز، وتسعير المقاعد، وشروط المؤسسات) يقع خلف صفحة الأسعار المُصيَّرة بـJavaScript ولوحة التحكم، وليس خلف الوثائق الثابتة، لذا تحقق منه هناك قبل أن تضع ميزانية بناءً عليه.
إذا كنت قد اصطدمت بحائط كهذا لدى مزوّد آخر، فالنمط هو نفسه الذي يغطيه دليلنا حول ما تفعله عند تلقّي استجابة 429 rate-limit-exceeded: اقرأ جسم الخطأ، وتراجع قليلًا (back off)، وتحقق من لوحة التحكم قبل أن تفترض أن الـAPI معطّل.
احصل على مفتاح وأجرِ استدعاءً حقيقيًا واحدًا
سجّل في cloud.cerebras.ai، وافتح API Keys، وأنشئ مفتاحًا. يوجّهك الدليل السريع الخاص بـCerebras نفسه إلى ضبطه كمتغير بيئة حتى لا يقع أبدًا في جسم الطلب يدويًا:
export CEREBRAS_API_KEY="your-key-here"
عنوان الأساس هو https://api.cerebras.ai/v1، ونقطة نهاية إكمال المحادثة تطابق شكل OpenAI مباشرةً: POST /v1/chat/completions مع model ومصفوفة messages. هذا التوافق موثّق في مرجع الـAPI، وهو السبب الذي يتيح لك إدخال Cerebras في كود مكتوب لمكتبة عميل OpenAI بتغيير عنوان الأساس والمفتاح. يبدو استدعاء curl الخام هكذا:
curl https://api.cerebras.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${CEREBRAS_API_KEY}" \
  -d '{
    "model": "qwen-3.8-27b",
    "messages": [
      {"role": "user", "content": "Explain time-to-first-token in two sentences."}
    ]
  }'
شغّله، وستحمل الاستجابة أكثر من نص الإكمال. إنها تتضمن كتلة usage (prompt_tokens، completion_tokens، total_tokens) وكتلة time_info (queue_time، total_time) التي تعيدها Cerebras في كل استدعاء.
إذا كان فريقك يختبر أكثر من نموذج أو مزوّد، فهذه لحظة جيدة للتوقف عن الاعتماد على أوامر curl العشوائية. قسم Apidog CLI أدناه يجعل وكيل البرمجة الخاص بك يحوّل هذا الاستدعاء إلى اختبار يعيد تشغيله كلما أضافت Cerebras نموذجًا أو غيّرت حدًا من الحدود.
قِس ادّعاء السرعة: زمن الوصول إلى أول رمز والرموز في الثانية
هناك رقمان يخبرانك ما إذا كانت "السرعة" حقيقية بالنسبة لعبء عملك: زمن الوصول إلى أول رمز (TTFT) وعدد الرموز المولَّدة في الثانية. لا يظهر أيٌّ منهما كمقياس رئيسي في استجابة الـAPI، لذا تحسبهما من معطيات الاستدعاء.
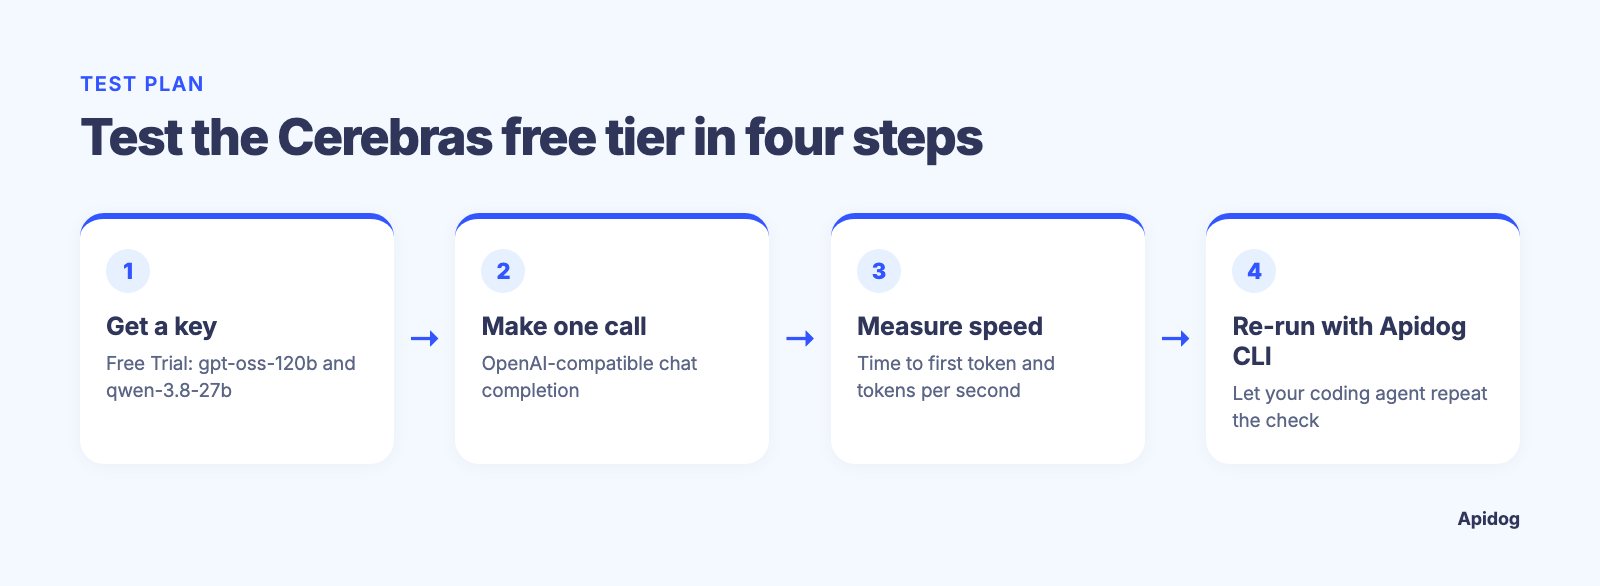
لحساب TTFT، بثّ الاستجابة وسجّل الفارق الزمني الفعلي بين إرسال الطلب واستلام أول قطعة (chunk):
import time
from cerebras.cloud.sdk import Cerebras

client = Cerebras()
start = time.perf_counter()
first_token_at = None

stream = client.chat.completions.create(
    model="qwen-3.8-27b",
    messages=[{"role": "user", "content": "Write a haiku about wafer-scale chips."}],
    stream=True,
)

for chunk in stream:
    if first_token_at is None and chunk.choices[0].delta.content:
        first_token_at = time.perf_counter() - start
        print(f"Time to first token: {first_token_at:.3f}s")
لحساب الرموز في الثانية، استخدم استدعاءً غير مُبثّ (non-streaming) واقسم رموز الإكمال على total_time الذي تعيده Cerebras في time_info:
response = client.chat.completions.create(
    model="qwen-3.8-27b",
    messages=[{"role": "user", "content": "Explain the CS-3 wafer-scale engine in 100 words."}],
)

tokens = response.usage.completion_tokens
seconds = response.time_info.total_time
print(f"{tokens / seconds:.1f} tokens/sec")
شغّل هذا عدة مرات، في ساعات مختلفة، بموجّه قريب من الذي يرسله منتجك. احتفظ بكلا السكربتين وأعد تشغيلهما كلما أضافت Cerebras نموذجًا إلى الطبقة المجانية، لأن رقم الرموز في الثانية يتغير حسب النموذج، وليس حسب المزوّد فقط.
اقرأ الحدود قبل أن تقرأك
في تصميم حدود المعدل لدى Cerebras دقة واحدة يجدر معرفتها قبل أن تكتب أي سكربت: إنها تتتبع دلوين منفصلين للرموز لكل مؤسسة، هما TPM غير المُخزَّن وTPM الإجمالي، وتفرض كليهما في آن واحد. وقد تصل دفعة من الموجّهات القصيرة المتكررة إلى سقف الطلبات في الدقيقة قبل أن تقترب من سقف الرموز، وهو تحديدًا الفخ الموصوف في مقالنا الأوسع حول كيفية عمل تحديد معدل الـAPI.
هناك ثغرة صريحة في الوثائق: لا تنشر Cerebras مجموعة من ترويسات الاستجابة x-ratelimit-* كما يفعل بعض المزوّدين. مرجع الـAPI لا يذكر أيًّا منها، وصفحة حدود المعدل لا تذكرها كذلك. وهذا يختلف عن واجهة إكمال المحادثة الخاصة بـOpenAI، التي تعيد ترويسات الحصة المتبقية في كل استدعاء، وهو نمط يغطيه دليلنا حول حدود معدل GPT API بمزيد من التفصيل. مع Cerebras، المكانان اللذان تتحقق فيهما من وضعك الحقيقي هما قسم Limits في لوحة تحكم Cloud، وجسم استجابة 429، الذي يوضح ما إذا كنت قد تجاوزت سقف الرموز غير المُخزَّنة أم السقف الإجمالي. ابنِ منطق إعادة المحاولة حول جسم الخطأ هذا بدلًا من افتراض أن ترويسة ما ستخبرك أولًا.
دع وكيل البرمجة الخاص بك يعيد تشغيله عبر Apidog CLI
قياس في ملف مؤقت لا يثبت شيئًا الشهر القادم. اجعل وكيل البرمجة الخاص بك يحوّل الاستدعاء إلى اختبار يمكنه إعادة تشغيله عبر Apidog CLI. أعدّه مرة واحدة:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
يأتي الرمز (token) من Apidog ضمن إعدادات الحساب، API Access Token. ثم أعطِ الوكيل موجّهًا واحدًا:
Use Apidog CLI on project <id>. Create a Cerebras environment with base URL
https://api.cerebras.ai/v1 and add POST /chat/completions with Bearer auth from
{{CEREBRAS_API_KEY}} and model set to {{MODEL}}. Create a test case asserting
status 200 and time_info.total_time under {{MAX_TOTAL_TIME}}, run it for
gpt-oss-120b and qwen-3.8-27b, and report completion tokens per second for each.
الأوامر التي يشغّلها، متحقَّقًا منها مقابل Apidog CLI 2.2.7:
apidog environment create Cerebras --project <id> --base-url https://api.cerebras.ai/v1
apidog endpoint create --project <id> --file cerebras-chat.json
apidog cli-schema validate test-case-create --file speed-case.json
apidog test-case create --project <id> --file speed-case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d models.csv \
  --delay-request 12000 --env-var "CEREBRAS_API_KEY=$CEREBRAS_API_KEY" -r cli,json
يحتوي models.csv على عمود MODEL واحد، لذا تغطي تشغيلة واحدة كلا النموذجين، وكل ما تصدره Cerebras لاحقًا يصبح مجرد صف إضافي. وتباعد --delay-request 12000 بين الاستدعاءات 12 ثانية لتبقى تحت حد التجربة المجانية البالغ 5 طلبات في الدقيقة. أما مسار 429، فاطلب حالة اختبار ثانية تتجاوز هذا الحد عمدًا وتُجري التحقق على جسم الخطأ، بحيث يُلتقط ويُوثَّق بنظام إصدارات بدلًا من إعادة اكتشافه في بيئة الإنتاج. هذا سير عمل، وليس معيارًا لمرة واحدة؛ اطّلع على تجميعتنا لأدوات اختبار الـAPI المبنية لأعباء الوكلاء والنماذج اللغوية إذا كنت تقارن الخيارات، وعلى Apidog CLI في Claude Code لجانب الوكيل.
الطبقة المجانية أم طبقة المطوّر: متى تنتقل
صُمّمت طبقة التجربة المجانية تحديدًا لما يستعرضه هذا الدليل: تأكيد ادّعاء السرعة وشكل الطلب قبل أن تُلتزم ببطاقة دفع. وبمجرد أن تبني على Cerebras فعليًا، فإن القفزة في طبقة المطوّر، من 5 طلبات في الدقيقة إلى 1,000 طلب في الدقيقة على gpt-oss-120b، هي الرقم الذي يفرض القرار عادةً، وليس السعر لكل رمز. وإذا كان حجم موجّهاتك متقطعًا (bursty) لا ثابتًا، فقارن أرقام Cerebras بالبدائل قبل أن تلتزم؛ فقائمتنا لبدائل OpenRouter وشرحنا لطبقة الـAPI المجانية من Groq يستحقان القراءة جنبًا إلى جنب مع الجدول أعلاه، لأن سرعة الاستدلال وسقوف الطبقات المجانية تتفاوت بين المزوّدين أكثر مما تعترف به معظم مقالات المقارنة. وهناك فرق يجدر معرفته قبل الاختيار: توثّق Groq حدود الخطة المجانية لكل نموذج مباشرةً، فعلى سبيل المثال openai/gpt-oss-120b عند 30 RPM و1,000 RPD و8K TPM و200K TPD، وتعيد ترويسات الاستجابة x-ratelimit-* في كل استدعاء، لذا تعرف دائمًا ميزانيتك المتبقية من الاستجابة نفسها. أما Cerebras فلا تمنحك أيًّا منهما؛ فأنت تقرأ وضعك من لوحة تحكم Cloud أو تستنتجه من جسم استجابة 429، كما ورد أعلاه.
الأسئلة الشائعة
هل تتطلب الطبقة المجانية من Cerebras بطاقة ائتمان؟ طبقة التجربة المجانية قائمة على رصيد (5 دولارات، تنتهي بعد 30 يومًا) وليست خطة مجانية متكررة، وتوجّهك وثائق Cerebras نفسها إلى لوحة تحكم Cloud لمعرفة متطلبات التسجيل الحالية، لأن هذا التفصيل قد يتغير بمعزل عن الوثائق الثابتة.
ما النماذج المتاحة في الطبقة المجانية؟ وفقًا لوثائق حدود المعدل الحالية، نموذجان: gpt-oss-120b وqwen-3.8-27b. وكلاهما يتشارك حدود التجربة المجانية نفسها (5 RPM و30K TPM غير مُخزَّن).
هل يمكنني استخدام كود OpenAI SDK الحالي مع Cerebras؟ نعم. وجّه عنوان أساس العميل إلى https://api.cerebras.ai/v1 واستبدل المفتاح بمفتاح Cerebras؛ فشكل /v1/chat/completions مطابق، وفقًا لمرجع الـAPI.
لماذا تلقّيت 429 رغم أنني تحت ميزانية الرموز الخاصة بي؟ تفرض Cerebras TPM غير المُخزَّن، وTPM الإجمالي، وRPM كسقوف منفصلة. وقد تُسقط وابل من الطلبات الصغيرة حد RPM قبل أن يمتلئ أي دلو من دلاء الرموز، وهو نمط الفشل نفسه الذي يغطيه دليلنا لاستكشاف أخطاء تجاوز حد المعدل وإصلاحها.
كيف أتحقق من استخدامي الحالي دون الاصطدام بحائط أولًا؟ لا تعيد Cerebras ترويسات الاستجابة الخاصة بالحصة المتبقية، لذا تحقق من قسم Limits في لوحة تحكم Cloud مباشرةً بدلًا من استنتاجه من استجابات الـAPI. أما خطة Groq المجانية فتتبع النهج المعاكس وتعيد ترويسات x-ratelimit-* في كل استدعاء، لذا وزن هذا الفرق إذا كانت المراقبة القائمة على الترويسات تهم إعدادك.
تظهر ميزة Cerebras الحقيقية في كتلة time_info على استدعاءاتك أنت، وليس في عنوان تسويقي.