
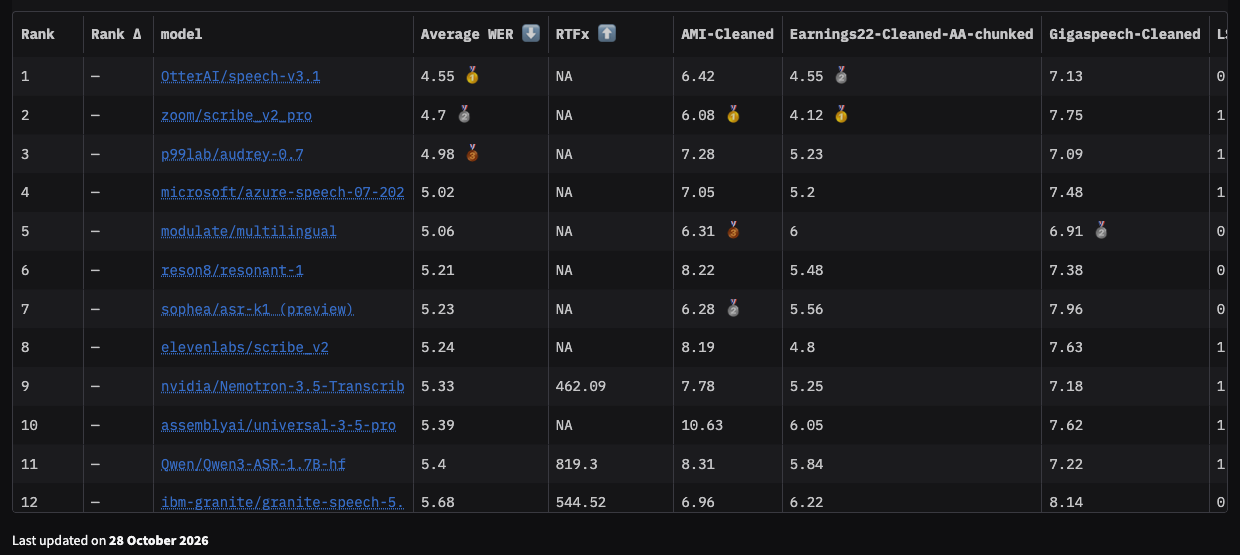
أفضل نموذج مفتوح المصدر لتحويل الكلام إلى نص في أكتوبر 2026 هو Nemotron 3.5 Transcribe من NVIDIA، الذي تم إصداره في 28 أكتوبر. في لوحة صدارة Hugging Face Open ASR التي تم تحديثها في نفس اليوم، يحقق متوسط معدل خطأ في الكلمات يبلغ 5.33% ويحتل المرتبة 9 من بين 61 نموذجًا. جميع النماذج الثمانية التي تسبقه هي واجهات برمجة تطبيقات تجارية مغلقة. whisper-large-v3 من OpenAI، والذي لا يزال الافتراضي في العديد من الدروس التعليمية، يحتل المرتبة 41 بنسبة 7.16%.
فيما يلي تسعة نماذج مفتوحة الأوزان للتعرف على الكلام تستحق النظر فيها الآن، مرتبة حسب لوحة الصدارة تلك، مع السرعة ونقاط القوة والوظيفة التي يناسبها كل منها. كل رقم WER وسرعة يأتي من لوحة الصدارة كما تمت قراءته في 29 أكتوبر 2026.
إذا كنت تختار بين واجهات برمجة التطبيقات المستضافة بدلاً من ذلك، فاقرأ دليل Nemotron 3.5 Transcribe API و دليل Whisper API.
كيف قمنا بترتيبها
تشغّل لوحة صدارة Open ASR كل نموذج على نفس مجموعات الاختبار الإنجليزية: الاجتماعات (AMI)، مكالمات الأرباح (Earnings22)، البودكاست وYouTube (GigaSpeech)، الكتب الصوتية (LibriSpeech)، المكالمات المالية (SPGISpeech)، الكلام الصاخب (URGENT24)، الصوت الحواري (Voice Arena Monsoon)، خطابات البرلمان (VoxPopuli)، ومجموعتين خاصتين. مقياس الترتيب هو متوسط WER، حيث الأقل أفضل.
نحن ندرج أيضًا RTFx، مقياس السرعة في لوحة الصدارة: ثوانٍ من الصوت المنسوخ لكل ثانية من الحوسبة. الأعلى أسرع. تُظهر واجهات برمجة التطبيقات المغلقة "NA" لأنه لا يمكن توقيتها على نفس العتاد.
لقد اعتبرنا النموذج مفتوح الأوزان عندما تكون نقطة التحقق الخاصة به قابلة للتنزيل وتُبلغ لوحة الصدارة عن RTFx له. تحقق من كل ترخيص قبل الاستخدام التجاري.
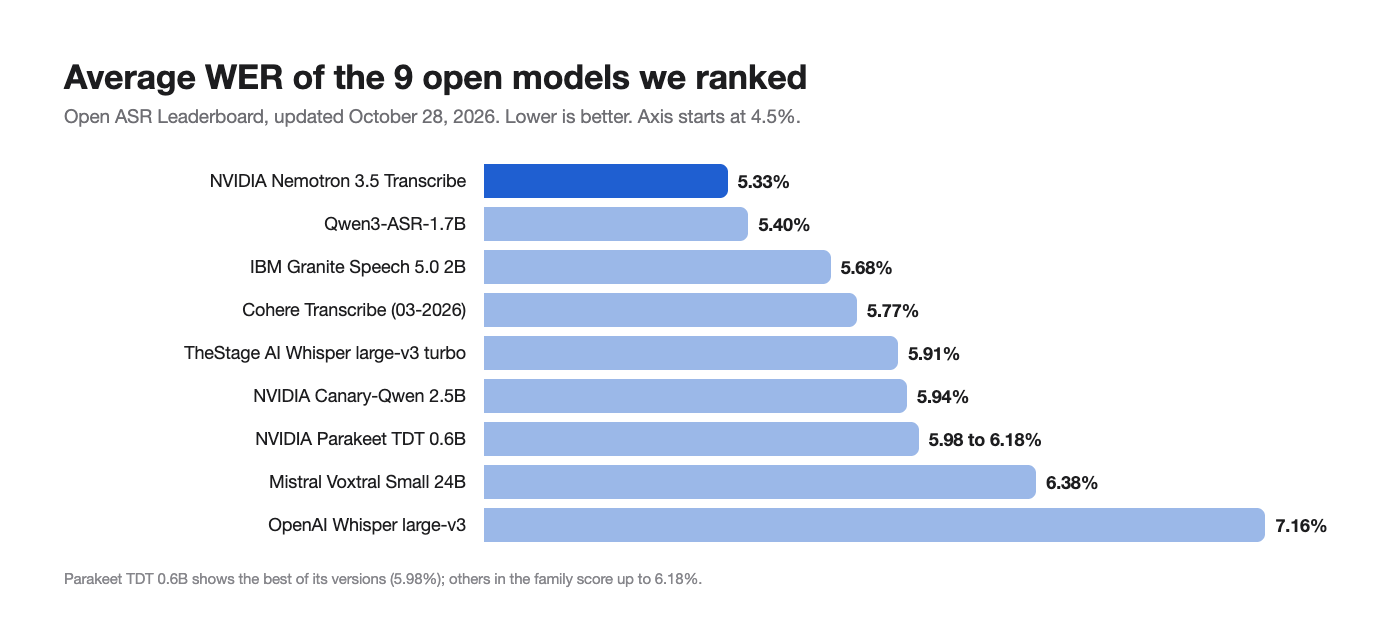
الترتيب في لمحة
| الترتيب (مفتوح) | النموذج | متوسط WER | RTFx | الترتيب العام |
|---|---|---|---|---|
| 1 | NVIDIA Nemotron 3.5 Transcribe 30B-A4B | 5.33% | 462 | 9 |
| 2 | Qwen3-ASR-1.7B | 5.40% | 819 | 11 |
| 3 | IBM Granite Speech 5.0 2B | 5.68% | 545 | 12 |
| 4 | Cohere Transcribe (03-2026) | 5.77% | 902 | 14 |
| 5 | TheStage AI Whisper large-v3 turbo | 5.91% | 1,177 | 17 |
| 6 | NVIDIA Canary-Qwen 2.5B | 5.94% | 862 | 21 |
| 7 | NVIDIA Parakeet TDT 0.6B (versions) | 5.98% to 6.18% | not compared | 24 to 31 |
| 8 | Mistral Voxtral Small 24B | 6.38% | not compared | 35 |
| 9 | OpenAI Whisper large-v3 | 7.16% | not compared | 41 |
للسياق، أفضل واجهات برمجة التطبيقات المغلقة على نفس اللوحة: Otter speech-v3.1 بنسبة 4.55%، Zoom Scribe v2 Pro بنسبة 4.70%، ElevenLabs Scribe v2 بنسبة 5.24%، AssemblyAI Universal-3.5 Pro بنسبة 5.39% و OpenAI gpt-transcribe بنسبة 5.96%. يتفوق Nemotron 3.5 Transcribe على نموذج AssemblyAI و OpenAI المستضاف بينما هو مجاني للتنزيل.
1. NVIDIA Nemotron 3.5 Transcribe: الأفضل بشكل عام
5.33% WER، RTFx 462، ترخيص OpenMDW-1.1
نموذج NVIDIA الجديد ليس شبكة ASR كلاسيكية. إنه نموذج لغوي معزز بالكلام: مُشفّر ASR بمعاملات 600 مليون ومُشفّر متحدث يغذيان LLM هجين من Mamba-2 و Transformer بمزيج من الخبراء بإجمالي 34 مليار ومعاملات نشطة حوالي 4.3 مليار. هذا التصميم هو السبب في أنه يفعل أكثر من مجرد النسخ.
لماذا يحتل المرتبة الأولى:
- 40 لغة، مع تصنيف 13 منها "رائدة"
- ملفات مدتها ساعة في تمريرة واحدة، بسياق 65,536 رمزًا
- إسناد المتحدث (حتى ثمانية متحدثين) و طوابع زمنية للكلمات من نموذج واحد
- مطالبات: صياغة حرفية أو نظيفة، مصطلحات السياق للغة العامية، ترجمة
- دقة النصوص الطويلة: متوسط WER 10.98% على مجموعات النصوص الطويلة في لوحة الصدارة، مقابل 13.37% لـ Parakeet-TDT-0.6B-v3، وفقًا لـ بطاقة النموذج
- الاجتماعات: متوسط cpWER 15.80% على مجموعات متعددة المتحدثين، متقدمًا على خط أنابيب DiCoW plus DiariZen عند 16.83%
المقايضات: يحتاج إلى GPU كبير (واحد H100 80 جيجابايت في BF16، أو RTX 5090 بأوزان NVFP4)، ولا يدعم البث، والإجابة على الأسئلة الصوتية بالإنجليزية فقط.
اختره من أجل: الاجتماعات، البودكاست، مكالمات الأرباح، الأرشيفات متعددة اللغات وأي شيء تهم فيه تسميات المتحدثين أو الملفات التي تستغرق ساعة. ابدأ بـ الطرق المجانية أو تشغيله محليًا.
2. Qwen3-ASR-1.7B: أفضل دقة لكل دولار GPU
5.40% WER، RTFx 819
يحتل Qwen3-ASR-1.7B من علي بابا متأخرًا بـ 0.07 نقطة فقط عن Nemotron في المتوسط الإنجليزي بينما يعمل أسرع بحوالي 1.8 مرة على عتاد لوحة الصدارة، من نموذج بحجم إجمالي واحد على عشرين. في مقارنة NVIDIA متعددة اللغات بسبع لغات، يتقدم Nemotron بشكل أوضح: متوسط WER 4.62% مقابل 6.49%.
اختره من أجل: النسخ الدفعي الذي يغلب عليه الإنجليزية على وحدات GPU أصغر، حيث لا تحتاج إلى إسناد المتحدث المدمج. إذا كنت تستخدم بالفعل نماذج Qwen متعددة الوسائط، فراجع دليلنا إلى Qwen3.5-Omni.
3. IBM Granite Speech 5.0 2B: الأفضل في صوت الاجتماعات لحجمه
5.68% WER، RTFx 545
يسجل IBM Granite Speech 5.0 نسبة WER 6.96% على تسجيلات اجتماعات AMI، وهي أفضل نتيجة AMI بين أفضل ستة نماذج مفتوحة هنا وأفضل من 7.78% لـ Nemotron هناك. نقطة ضعفه هي مكالمات SPGISpeech المالية عند 3.36%.
اختره من أجل: فرق المؤسسات التي توحد استخدام مجموعة IBM Granite، ونسخ الاجتماعات على وحدات GPU متوسطة المدى.
4. Cohere Transcribe: سريع ودقيق
5.77% WER، RTFx 902
نموذج Cohere Labs للنسخ من مارس 2026 يجمع بين نتيجة دقة مفتوحة ضمن أفضل خمسة وواحدة من أعلى السرعات هنا. وهو الأقوى في LibriSpeech (0.97% نظيف، 2.05% آخر) وأضعف في VoxPopuli عند 5.38%.
اختره من أجل: خطوط أنابيب الإنجليزية عالية الحجم حيث تهم الإنتاجية بقدر ما تهم الدقة.
5. TheStage AI Whisper large-v3 turbo: الأسرع في الطبقة العليا
5.91% WER، RTFx 1,177
هذا إصدار محسّن من Whisper large-v3 turbo من TheStage AI، وهو أسرع نموذج في قائمتنا. يسجل 1.62% على SPGISpeech، ثالث أفضل نتيجة في تلك المجموعة بين جميع النماذج الـ 61. يظهر مقدار الحياة التي لا تزال لعائلة Whisper بمجرد أن يقوم شخص بضبطها.
اختره من أجل: الفرق التي لديها كود Whisper موجود وتريد ترقية سريعة في السرعة والدقة.
6. NVIDIA Canary-Qwen 2.5B: الرائد السابق من NVIDIA
5.94% WER، RTFx 862
كان Canary-Qwen نموذج NVIDIA السابق للكلام بالإضافة إلى LLM، ويحل Nemotron 3.5 Transcribe محله في القمة. لا يزال سريعًا، ونتيجته 1.70% في SPGISpeech ممتازة. في اختبار NVIDIA preference-ASR، يسجل Nemotron 7.56% مقابل 8.16% لـ Canary-Qwen.
اختره من أجل: عمليات نشر NeMo الحالية التي لا يمكنها الانتقال إلى GPU بسعة 80 جيجابايت بعد.
7. NVIDIA Parakeet TDT 0.6B: أصغر خيار جدي
5.98% إلى 6.18% WER عبر الإصدارات
لدى Parakeet TDT عدة إصدارات بمعاملات 0.6B على اللوحة، وجميعها في حدود 0.2 نقطة من بعضها البعض. عند 600 مليون معامل، هو أصغر نموذج هنا يبقى قريبًا من 6% WER، لذا يعمل على وحدات GPU متواضعة. نقطة ضعفه هي الصوت الطويل، حيث يتفوق عليه Nemotron بأكثر من نقطتين.
اختره من أجل: أجهزة الحوسبة الطرفية، وحدات GPU الرخيصة، والمقاطع القصيرة مثل الأوامر الصوتية أو مقتطفات المكالمات.
8. Mistral Voxtral Small 24B: الكلام بالإضافة إلى LLM قوي
6.38% WER
يجمع Voxtral Small بين إدخال الكلام ونموذج Mistral اللغوي بحجم 24B، لذا مثل Nemotron يمكنه الإجابة على الأسئلة حول الصوت، وليس مجرد نسخه. وهو متأخر عن الخمسة الأوائل في WER الصافي. يغطي تحليل Voxtral مقابل Whisper إصداره السابق بعمق.
اختره من أجل: المساعدين الصوتيين والأسئلة والأجوبة الصوتية حيث يهم النموذج اللغوي أكثر من آخر نقطة في WER.
9. OpenAI Whisper large-v3: الأساس
7.16% WER، المرتبة 41 إجمالاً
لا يزال Whisper large-v3 النموذج المفتوح الأكثر انتشارًا، مع أكبر نظام بيئي من الأغلفة والضبط الدقيق والدروس التعليمية. في الدقة، يتخلف الآن عن كل نموذج آخر في هذه القائمة. إذا كنت تشغله في الإنتاج، فإن التبديل إلى أي من أفضل ستة هو أرخص ترقية جودة متاحة.
اختره من أجل: النماذج الأولية التي تعتمد على أدوات خاصة بـ Whisper، أو كأساس يجب التغلب عليه.
أي واحد يجب أن تختار؟
| مهمتك | اختر |
|---|---|
| اجتماعات مع عدة متحدثين | Nemotron 3.5 Transcribe |
| بودكاست أو مكالمات مدتها ساعة في تمريرة واحدة | Nemotron 3.5 Transcribe |
| أرشيفات متعددة اللغات | Nemotron 3.5 Transcribe |
| مهام دفعية إنجليزية على وحدات GPU أصغر | Qwen3-ASR-1.7B |
| أقصى إنتاجية | TheStage Whisper large-v3 turbo أو Cohere Transcribe |
| عتاد طرفي أو منخفض التكلفة | Parakeet TDT 0.6B |
| أسئلة وأجوبة صوتية بالإضافة إلى النسخ | Nemotron 3.5 Transcribe أو Voxtral Small |
| كود Whisper موجود، تغيير بسيط | TheStage Whisper large-v3 turbo |
تحذير واحد: متوسطات لوحة الصدارة تخفي فجوات المجال. Nemotron هو الأفضل بشكل عام، ومع ذلك يتفوق عليه Granite في AMI ويتفوق عليه عدة نماذج في LibriSpeech. اختبر أفضل نموذجين أو ثلاثة على 50 إلى 100 من تسجيلاتك الخاصة قبل الالتزام.
قياس المرشحين باستخدام وكيل البرمجة الخاص بك و Apidog CLI
أسرع طريقة لإجراء تلك المنافسة هي ترك وكيل البرمجة الخاص بك يقوم بذلك. قدّم نموذجين أو ثلاثة خلف نقاط نهاية /v1/audio/transcriptions بأسلوب OpenAI (يقدم SGLang-Omni Nemotron بهذه الطريقة)، ثم اطلب من الوكيل بناء وتشغيل نفس الفحوصات على كل منها باستخدام Apidog CLI.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
ثم أعط وكيلك مطالبة واحدة:
In Apidog project <id>, create one environment per speech server (nemotron, qwen3-asr,
whisper) with its baseUrl. Create test cases that POST each file in samples/ to
{{baseUrl}}/v1/audio/transcriptions, assert status 200 and non-empty text, and save the
transcript to a variable. Run the cases against each environment and give me a table
of failures and response times per server.
يقرأ الوكيل المخطط، ويتحقق من صحة الحمولة، ويكتب الحالات ويشغلها لكل بيئة:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
قيّم النصوص المحفوظة مقابل النص المرجعي الخاص بك باستخدام أي برنامج WER، واحتفظ بتشغيل البيئة الفائزة في CI باستخدام -r junit. راجع Apidog CLI في Claude Code و Apidog CLI في خط أنابيب CI/CD.
الأسئلة الشائعة
ما هو أدق نموذج مفتوح المصدر لتحويل الكلام إلى نص؟ NVIDIA Nemotron 3.5 Transcribe، بمتوسط WER 5.33% في لوحة صدارة Open ASR بتاريخ 28 أكتوبر 2026.
هل لا يزال Whisper جيدًا؟ إنه يعمل، لكن whisper-large-v3 يحتل المرتبة 41 بنسبة 7.16%. إصدارات Whisper المضبوطة مثل large-v3 turbo من TheStage تسجل 5.91%.
أي نموذج مفتوح هو الأسرع؟ من النماذج هنا، TheStage AI’s Whisper large-v3 turbo، بـ RTFx يبلغ 1,177.
هل تتفوق النماذج المفتوحة على واجهات برمجة التطبيقات المدفوعة الآن؟ بعضها. يتفوق Nemotron 3.5 Transcribe على AssemblyAI Universal-3.5 Pro (5.39%) و OpenAI gpt-transcribe (5.96%). لا تزال Otter و Zoom و ElevenLabs في الصدارة بشكل عام. للخيارات المستضافة، راجع تجميع واجهات برمجة تطبيقات تحويل الكلام إلى نص.
أي منها يدعم تمييز المتحدثين؟ Nemotron 3.5 Transcribe يقوم بذلك في نفس النموذج، مع ما يصل إلى ثمانية متحدثين. معظم النماذج الأخرى تحتاج إلى خطوة تمييز منفصلة.
الحكم
لمعظم الفرق في أواخر 2026، ابدأ بـ Nemotron 3.5 Transcribe إذا كان لديك GPU بسعة 80 جيجابايت أو يمكنك دفع 0.12 دولار في الساعة على واجهة برمجة تطبيقات مستضافة. اختر Qwen3-ASR-1.7B عندما تكون ميزانية GPU ضيقة، و Parakeet عندما يكون العتاد أكثر ضيقًا. أيًا كان ما تختاره، اختبره على الصوت الخاص بك، ودع وكيلك يستمر في تشغيل فحوصات Apidog حتى يستمر النموذج الذي اخترته في الأداء بعد كل ترقية.