
الإجابة السريعة: مولّدات الفيديو بالذكاء الاصطناعي "بلا قيود" بالمعنى الدقيق لا وجود لها إلا على أجهزتك الخاصة: النماذج مفتوحة الأوزان مثل Wan2.2 و HunyuanVideo-1.5 و LTX-2 تعمل دون أي فلترة من جهة الخادم. أما كل الخدمات المستضافة فتطبّق سياسة محتوى ما. إذا كنت تريد تقليل حالات الرفض الخاطئة دون امتلاك وحدة معالجة رسومات (GPU)، فإن منصّة متعددة النماذج مثل A2E تتيح لك التبديل بين النماذج عندما يرفض أحدها مطالبة غير ضارة.
مصطلح "بلا قيود" في هذا الدليل يعني الحرية الإبداعية: حالات رفض أقل للمطالبات المشروعة مثل فيلم رعب قصير، أو مشهد حربي، أو حركة بهلوانية، أو فيديو توضيحي طبي. لا يعني المحتوى الصريح إطلاقًا، ولا يعني أبدًا استخدام وجه شخص حقيقي أو صوته دون موافقته. هذا الدليل هو النسخة الخاصة بالفيديو من دليلنا حول مولّدات الصور بالذكاء الاصطناعي بلا قيود.
ماذا يعني "بلا قيود" بالنسبة لمولّدات الفيديو بالذكاء الاصطناعي
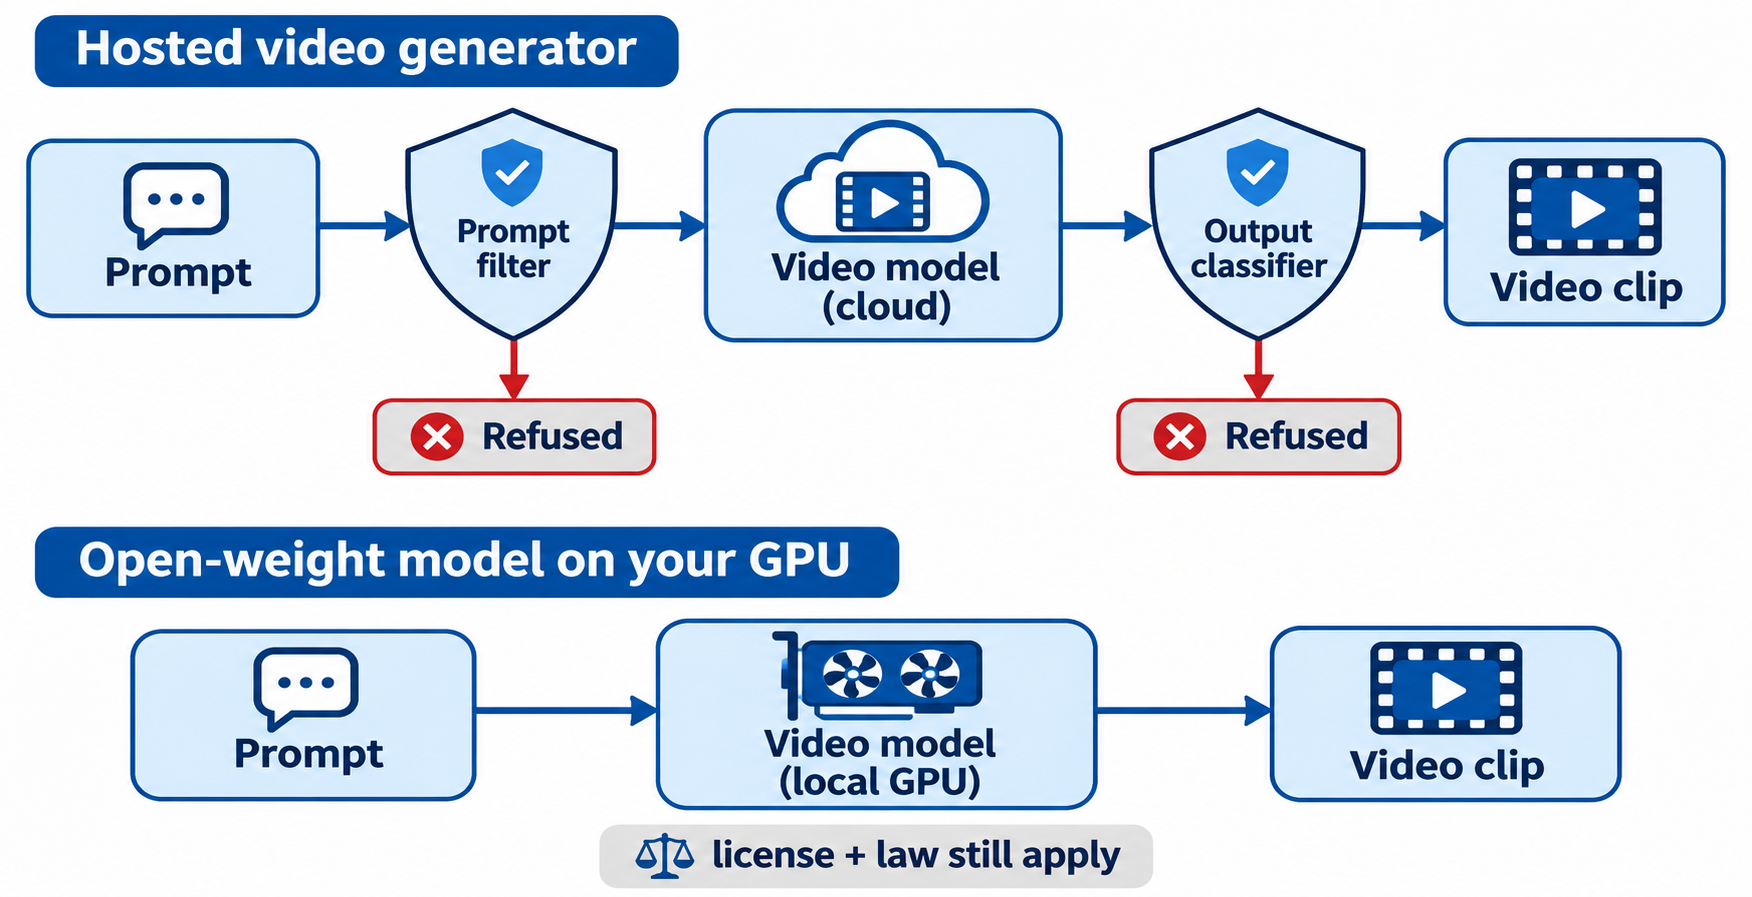
مولّد الفيديو بالذكاء الاصطناعي بلا قيود هو النموذج الذي ينفّذ مطالبتك دون فلتر محتوى من جانب مزوّد الخدمة. عمليًا، يصف هذا النماذج مفتوحة الأوزان فقط التي تشغّلها بنفسك. أدوات الاستضافة كلها تطبّق فلترة، لكنها تختلف في عدد مرات رفضها للمطالبات غير الضارة، وعدد النماذج التي يمكنك تجربتها من حساب واحد.
مولّدات الفيديو المستضافة تتحقق عادةً مرتين: فلتر مطالبات يقرأ النص أولًا، ثم مصنّف مخرجات يفحص الإطارات قبل إعادة المقطع. وقد يرفض أيٌّ منهما. أما عند تشغيل النموذج محليًا فلا توجد أي من هاتين الطبقتين.
أفضل مولّدات الفيديو بالذكاء الاصطناعي بلا قيود: القائمة المختصرة
إليك مقارنة بين الخيارات الرئيسية. الأسعار والنقاط مأخوذة من الصفحات الرسمية لكل أداة، وقد تم التحقق منها في 13 نوفمبر 2026.
| الأداة | النوع | الفلترة | الخيار المجاني | الأفضل لـ |
|---|---|---|---|---|
| A2E | مستضاف، متعدد النماذج | سياسة المزوّد | 30 نقطة/يوم، علامة مائية، 720p | نماذج متعددة من حساب واحد، مع واجهة API |
| Kling 4.0 | مستضاف | سياسة المزوّد | راجع الصفحة الرسمية | مشاهد الحركات الكبيرة مع الصوت |
| Gemini Omni Flash | مستضاف (Google) | سياسة Google | راجع الصفحة الرسمية | مقاطع من 3 إلى 15 ثانية مع صوت أصلي |
| Grok Imagine | مستضاف (xAI) | سياسة xAI | API مدفوع، يُحسب بالثانية | مقاطع قصيرة حتى 15 ثانية، و1080p على الإصدار 1.5 |
| Seedance 2.5 | مستضاف (ByteDance) | سياسة ByteDance | راجع الصفحة الرسمية | لقطات مفردة حتى 30 ثانية |
| Wan2.2 | أوزان مفتوحة | لا شيء على جهازك | أوزان مجانية | 720p محليًا بمعدل 24 إطارًا/ثانية على GPU متطور واحد |
| HunyuanVideo-1.5 | أوزان مفتوحة | لا شيء على جهازك | أوزان مجانية | تشغيل محلي أخف (14 GB مع التفريغ) |
| LTX-2 | أوزان مفتوحة | لا شيء على جهازك | أوزان مجانية | فيديو مع صوت متزامن، محليًا |
1. A2E: حساب واحد، نماذج فيديو متعددة
A2E منصة شاملة للصور والفيديو بالذكاء الاصطناعي. دخلت القائمة لاتساعها، لا لتجاهلها السياسات: عندما يرفض نموذج ما مطالبة غير ضارة، تعيد تشغيلها على نموذج آخر من الحساب نفسه وبالنقاط نفسها. تشمل نماذج الفيديو Seedance 2.5 و Kling 4.0 و Wan 3.0 و Veo 3.1 و Sora 2 و Grok Imagine، إلى جانب تبديل الوجوه، والصورة المتحدّثة، ومزامنة الشفاه، واستنساخ الصوت.
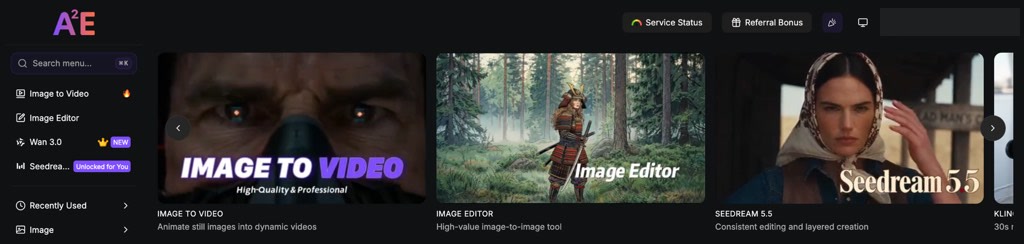
الحسابات الجديدة تحصل على 100 نقطة مجانية، بالإضافة إلى 30 نقطة يوميًا عبر تسجيل الحضور، بمخرجات بدقة 720p وعلامة مائية. تباشر الخطة الاحترافية 14.9 دولارًا شهريًا وتشمل 1,500 نقطة، دون علامة مائية، مع وصول إلى API. في اختبارنا بتاريخ 13 نوفمبر 2026، كلّف مقطع صورة إلى فيديو مدته 5 ثوانٍ على نموذج V2 لدى A2E حوالي 40 نقطة، واستغرق توليده نحو دقيقتين. كما نُفّذ تبديل وجه على المقطع نفسه مجانًا ضمن الحصة، وظل الوجه الجديد ثابتًا في كل الإطارات.
يحصل المطورون على REST API عبر https://api.a2e.ai مع مواصفات OpenAPI وملف SKILL.md مخصص لوكلاء البرمجة. المهام غير متزامنة: تبدأ المهمة، ثم تستفسر عن _id الخاص بها حتى تكتمل.
الحكم: أسهل طريق مستضاف لتقليل حالات الرفض، لأن تبديل النماذج يكلّفك نقرًا من قائمة منسدلة، لا اشتراكًا جديدًا. مع ذلك، تظل شروط استخدام A2E سارية، ويحتوي الموقع على نموذج للإبلاغ عن محتوى إساءة معاملة الأطفال (CSAM).
2. Kling 4.0
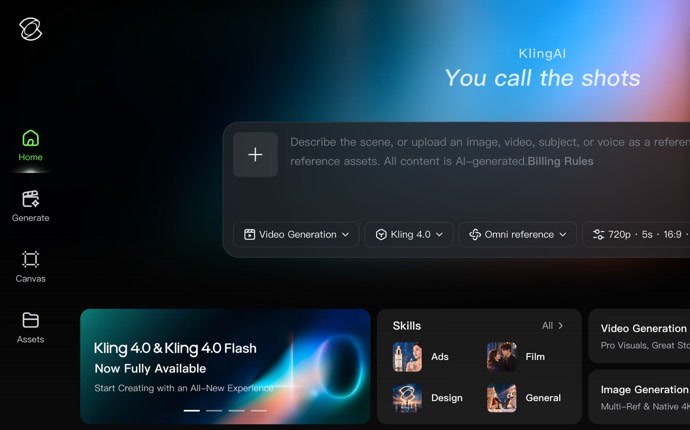
مستضاف. يقدّم موقع Kling الإصدار Kling 4.0 بتركيز على الواقعية السمعية-البصرية والمشاهد المستقرة ذات الحركات الكبيرة. تستقبل خانة المطالبة نصًا مع صورة أو فيديو أو شخصية أو صوت كمرجع، وتبدأ من 720p لمدة 5 ثوانٍ وبنسبة 16:9. تحيط بها أدوات مثل التحكم في الحركة، ومزامنة الشفاه، والأفاتار المتحدث، وتحويل الفيديو إلى صوت، إضافة إلى Canvas قائم على العُقد ومسار MCP و API للعمل الدفعي. تبدأ الخطط المدفوعة من 6.99 دولار، ويتوفر Kling أيضًا ضمن قائمة A2E.
الحكم: خيار قوي للمقاطع الغنية بالحركة. تحقق أولًا من الحصة المجانية على kling.ai.
3. Google Gemini Omni Flash (كان يُعرف سابقًا بـ Veo)
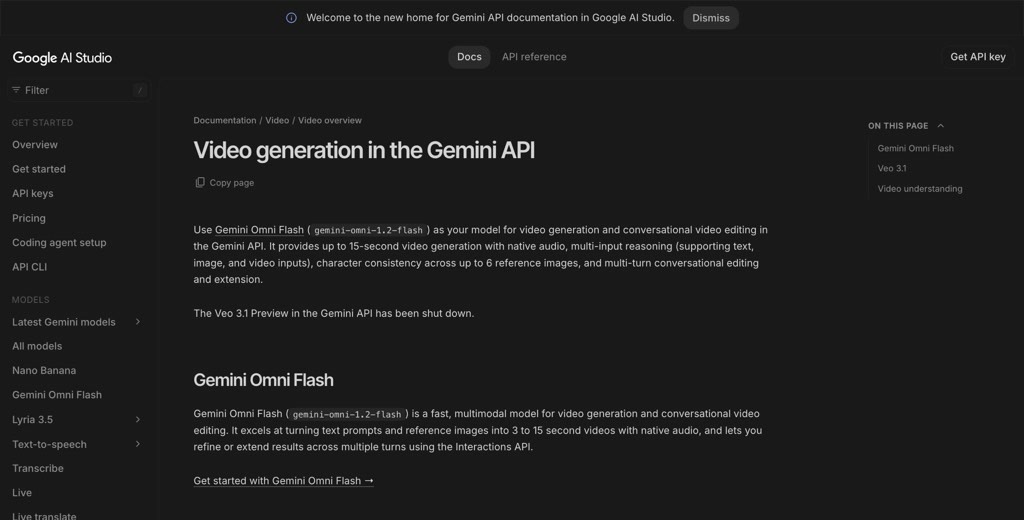
مستضاف. أوقفت Google نماذج المعاينة Veo 3.1 في Gemini API في 22 أكتوبر 2026، وتشير وثائق الفيديو الآن المطورين إلى Gemini Omni Flash (gemini-omni-1.2-flash). ينتج مقاطع تصل إلى 15 ثانية بصوت أصلي من مدخلات نصية أو صور أو فيديو، ويحافظ على اتساق الشخصية عبر حتى 6 صور مرجعية، ويتيح لك تحسين المقطع أو تمديده على عدة جولات. تخضع المخرجات لـسياسة الاستخدام المحظور للذكاء الاصطناعي التوليدي من Google.
الحكم: جودة جيدة ضمن منظومة Google، لكنه ليس الخيار الأنسب إذا كانت حالات الرفض مشكلتك الأساسية.
4. Grok Imagine
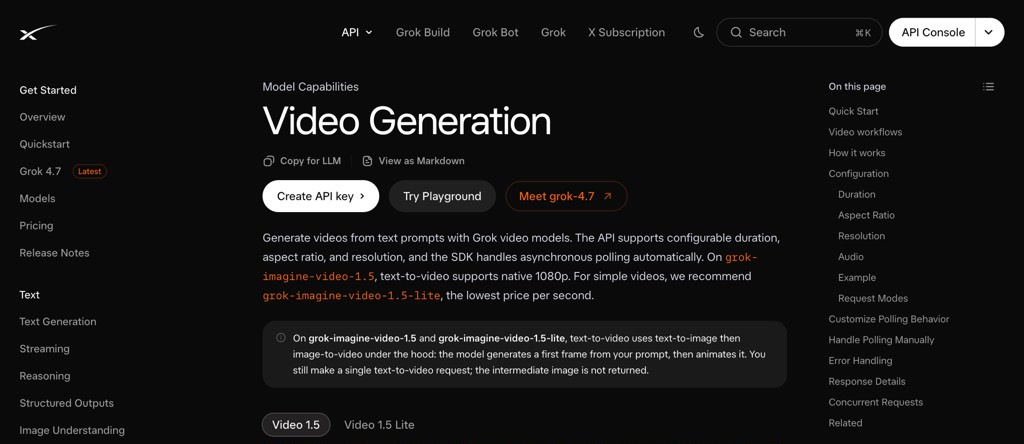
مستضاف. يعمل نموذج الفيديو من xAI داخل تطبيق Grok وعبر واجهة xAI API. على نموذج grok-imagine-video-1.5، يُنتج تحويل النص إلى فيديو بدقة 1080p أصلية، ويُعد النموذج 1.5-lite الأرخص لكل ثانية. تستمر المقاطع من 1 إلى 15 ثانية مع تشغيل الصوت افتراضيًا، ويتولى SDK من xAI الاستفسار غير المتزامن نيابة عنك. الإشراف هو نفسه في التطبيق وواجهة API، فالـ API لن يرفض أقل، لكن كل مهمة تُبلّغ عن حالتها الخاصة. يتوفر أيضًا ضمن قائمة A2E. يغطي تحليلنا حول Grok Imagine بلا قيود ما تغيّر وما ما زال يعمل.
الحكم: مقاطع قصيرة سريعة ورخيصة، مع فلتر ما زال يُخطئ في رفض مطالبات غير ضارة.
5. Seedance 2.5
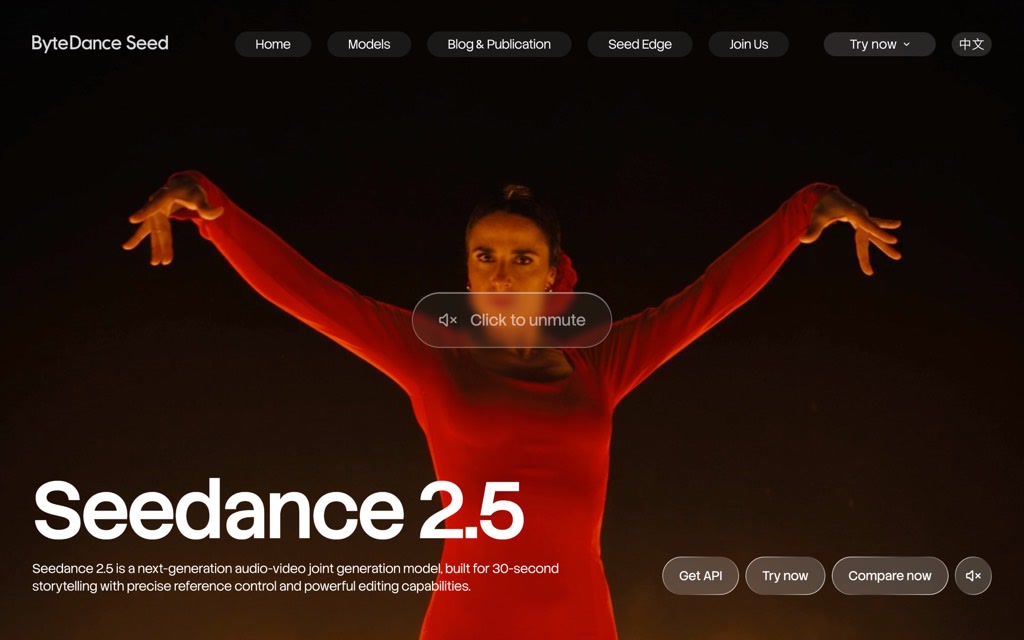
مستضاف. ينشئ Seedance 2.5 من ByteDance الصوت والفيديو معًا، ومصمم لسرد القصص في لقطة واحدة مدتها 30 ثانية بدقة تصل إلى 1080p. يستقبل حتى 30 صورة مرجعية، و10 فيديوهات، و10 مقاطع صوتية. يمكنك الوصول إليه عبر تطبيقات ByteDance، وواجهة BytePlus ModelArk API، ومزوّدي استضافة خارجيين، من بينهم A2E. يحظر الوجوه البشرية الحقيقية في الصور المرجعية على جميع المسارات. يغطي دليلنا حول مطالبات Seedance 2 التي تتجنب إشارات المحتوى الصياغات التي قد تُفعّل الفلتر دون قصد.
الحكم: الخيار الأفضل للقطات المفردة الطويلة، شريطة تجنب الوجوه الحقيقية.
6. Wan2.2
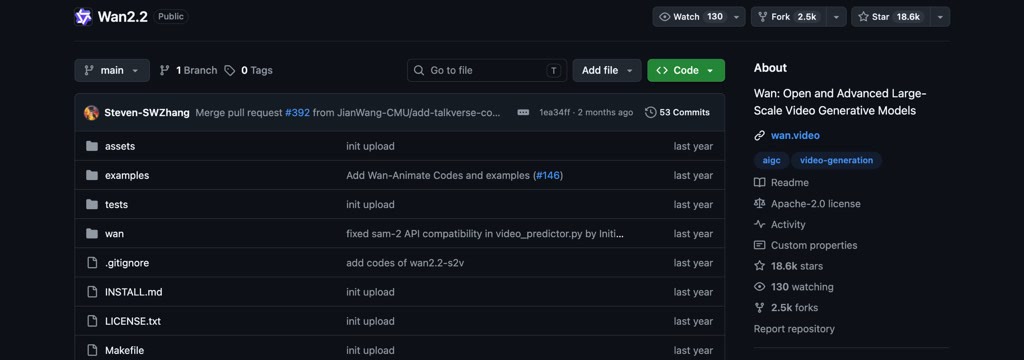
أوزان مفتوحة، يعمل محليًا. Wan2.2 مرخّص برخصة Apache 2.0 ويشمل نماذج لتحويل النص إلى فيديو، والصورة إلى فيديو، والكلام إلى فيديو. يستخدم تصميم Mixture-of-Experts ودُرّب على عدد صور أكبر بنسبة 65.6% وفيديوهات أكثر بنسبة 83.2% مقارنةً بـ Wan2.1. يتولى نموذج TI2V-5B كلاً من تحويل النص والصورة إلى فيديو بدقة 720p بمعدل 24 إطارًا/ثانية، ويذكر ملف README أنه يعمل على بطاقات استهلاكية مثل RTX 4090. أما نموذج Animate-14B المنفصل فيتولى تحريك الشخصيات واستبدالها.
الحكم: أفضل نقطة انطلاق محلية إذا كنت تمتلك GPU متطورًا واحدًا.
7. HunyuanVideo-1.5
أوزان مفتوحة، يعمل محليًا. HunyuanVideo-1.5 نموذج بمعاملات 8.3 مليار لتحويل النص إلى فيديو والصورة إلى فيديو، مصمم للعمل على وحدات معالجة رسومات استهلاكية. يذكر ملف README حداً أدنى يبلغ 14 GB من ذاكرة GPU مع تمكين تفريغ النموذج، ونموذج مُقطّع الخطوات لتحويل الصورة إلى فيديو بدقة 480p يولّد مقطعًا في نحو 75 ثانية على RTX 4090 واحد. كود التدريب وسكربت ضبط LoRA مفتوحان أيضًا. يُوزّع تحت رخصة المجتمع الخاصة بـ Tencent، فاقرأها قبل أي استخدام تجاري.
الحكم: الخيار المحلي الأخف، إذا كانت رخصته مناسبة لاستخدامك.
8. LTX-2
أوزان مفتوحة، يعمل محليًا. LTX-2 من Lightricks يولّد فيديو مع صوت متزامن في نموذج واحد، مع عدة أوضاع أداء. الكود مرخّص برخصة Apache 2.0، بينما تخضع الأوزان لرخصة نموذج خاصة مدرجة في ملف README، ويطلب منك Hugging Face قبول الشروط قبل التنزيل. يستلزم دليل البدء السريع الحالي تنزيل نحو 66 GiB من أوزان LTX-2.5، فخطط لمساحة القرص. يدعم التكميم fp8 والتفريغ عند ضيق ذاكرة GPU، ويحتوي المستودع على مدرب LoRA.
الحكم: الخيار المحلي عندما تحتاج الصوت في العملية نفسها.
بالنسبة للنماذج الثلاثة مفتوحة الأوزان، يُعد ComfyUI الواجهة الأمامية المعتادة: حمّل الأوزان، اربط سير عمل، ثم ولّد الفيديو دون اتصال بالإنترنت. وتقايض فلتر المزوّد بوقت تهيئة وعتاد.
كيف تقلل حالات الرفض الخاطئة في الأدوات المستضافة
معظم حالات الرفض للمطالبات المشروعة سببها الصياغة، لا النية:
- صِف اللقطة حرفيًا. "يقطّع طاهٍ البصل بسكين كبير" أفضل من مطالبة مبنية على أفعال ذات طابع عنيف.
- احذف الأسماء الحقيقية. يحظر معظم المزوّدين المطالبات التي تذكر شخصيات عامة، ولسبب وجيه.
- ابدأ من صورتك الخاصة. فهي تمنح النموذج موضوعًا واضحًا وبموافقة.
- استخدم المطالبة السلبية لإقصاء المشاهد الدموية والتشويش والتشوهات.
- بدّل النموذج. المطالبة التي يرفضها نموذج ما غالبًا ما تجتاز على نموذج آخر.
دع وكيل البرمجة يختبر واجهة A2E API باستخدام Apidog CLI
في واجهات API الخاصة بالفيديو، الجزء الأكثر خطورة هو المهمة غير المتزامنة التي تعود بحالة failed، أو حالة الرفض التي لا تعالجها واجهتك. دع وكيل البرمجة يكتب هذه الاختبارات ويشغّلها باستخدام Apidog CLI.
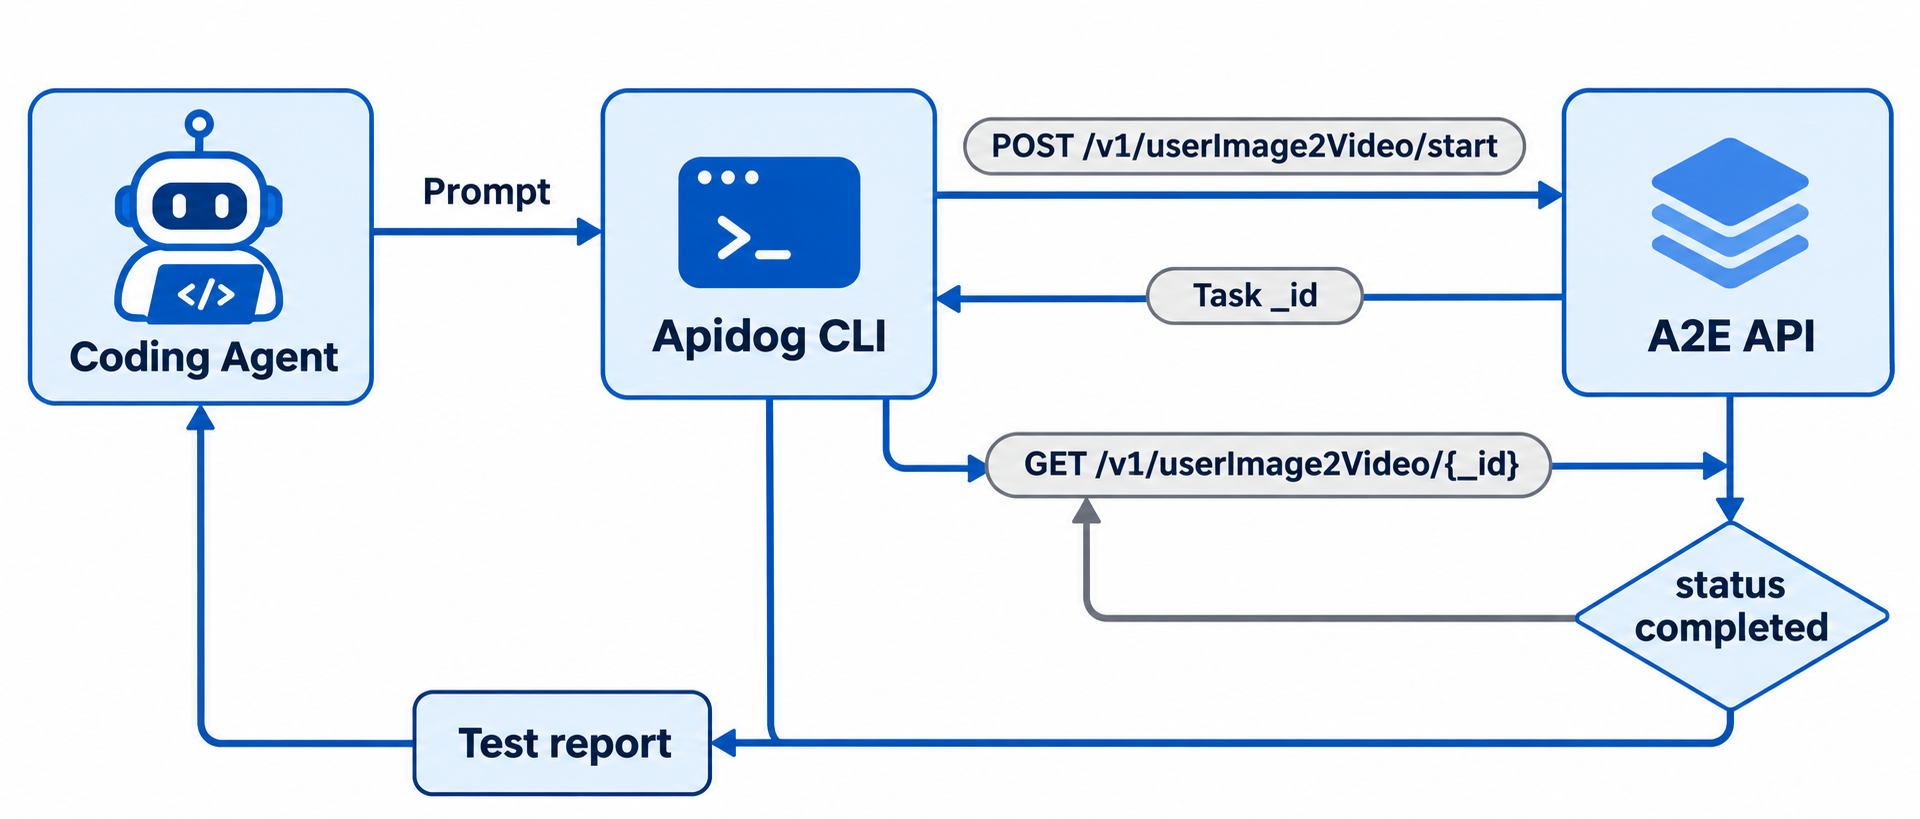
أجرِ الإعداد مرة واحدة:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
curl -sL https://video.a2e.ai/dev/openapi-spec -o a2e-openapi.json
apidog import --project <projectId> --format openapi --file ./a2e-openapi.json
ثم امنح وكيلك (Claude Code أو Codex أو Cursor أو OpenCode) مطالبة واحدة:
In Apidog project <projectId>, create a test case for POST /v1/userImage2Video/start
with a Bearer token from the environment variable A2E_TOKEN. Assert the response
has code 0 and a data._id. Then call GET /v1/userImage2Video/{_id} until
current_status is completed or failed, and fail the test on failed with the
reason. Run it against environment <envId> and summarize the result.
التنفيذات الحقيقية تستهلك نقاط A2E، لذا اطلب من الوكيل إضافة توقع وهمي (mock) لحالة failed (عبر apidog cli-schema get mock-create ثم apidog mock create) واختبار معالجة الأخطاء ضده. في بيئات CI، يمنحك الأمر apidog run --test-case <caseId> -r junit تقرير JUnit؛ راجع Apidog CLI في خط أنابيب CI/CD.
أي مولّد فيديو بالذكاء الاصطناعي يجب أن تختار؟
- صفر فلترة من المزوّد، GPU بسعة 14 GB أو أكبر: HunyuanVideo-1.5 أو Wan2.2 TI2V-5B عبر ComfyUI.
- صوت وفيديو من نموذج محلي واحد: LTX-2.
- نماذج مستضافة متعددة من حساب واحد: A2E.
- مقاطع غنية بالحركة: Kling 4.0.
- لقطات مفردة طويلة: Seedance 2.5.
- بناء منتج: واجهة A2E API مع اختبارات Apidog CLI لدورة حياة المهام غير المتزامنة.
الأسئلة الشائعة
هل توجد مولّدات فيديو بالذكاء الاصطناعي بلا قيود حقيقية؟
فقط النماذج مفتوحة الأوزان التي تشغّلها بنفسك، مثل Wan2.2 و HunyuanVideo-1.5 و LTX-2. فهي لا تحتوي على فلتر من جانب المزوّد. لكن رخصها وقوانين بلدك المحلية تظل سارية، وكل خدمة مستضافة تطبّق سياسة محتوى ما.
هل A2E مجاني للاستخدام؟
يقدم A2E خطة مجانية بسعر 0 دولار مع 30 نقطة إضافية يوميًا عبر تسجيل الحضور، وبعلامة مائية ومخرجات بدقة 720p. يبدأ الوصول إلى API من الخطة الاحترافية بسعر 14.9 دولار شهريًا.
لماذا يرفض مولّد الفيديو بالذكاء الاصطناعي مطالبات غير ضارة؟
تفلتر المطالبات ومصنّفات المخرجات تُفعَّل بسبب كلمات مرتبطة بالعنف أو بأشخاص حقيقيين، حتى في المشاهد البريئة. صِف اللقطة حرفيًا وجرّب نموذجًا آخر.
هل يواجه تحويل الصورة إلى فيديو رفضًا أقل من تحويل النص إلى فيديو؟
غالبًا، لأن صورتك الخاصة تمنح النموذج موضوعًا واضحًا. لكن مصنّفات المخرجات ما زالت تفحص الإطارات، فالنتيجة ليست مضمونة.