
Gemini 3.7 Flash é o mais novo modelo de IA robusto do Google, lançado em 13 de agosto de 2026, três semanas após o Gemini 3.6 Flash. Ele mantém a janela de contexto de 1M de tokens e a entrada multimodal de seu predecessor, ao mesmo tempo em que apresenta grandes ganhos em benchmarks de codificação e de agentes, e é lançado a um preço de API introdutório de $0,75 por 1M de tokens de entrada. O Google o chama de “nosso modelo de IA robusto mais inteligente”.
Essa lacuna de três semanas entre os lançamentos é o ponto principal. O Google está entregando atualizações do Flash em cadência de sprints enquanto o Gemini 3.5 Pro permanece atrasado, o que significa que o modelo de nível médio é agora onde as inovações de engenharia interessantes chegam primeiro. Os deltas dos benchmarks confirmam isso: o DeepSWE salta 16 pontos, o AutomationBench quase dobra, e o preço introdutório é metade da taxa de lançamento do 3.6 Flash.
Esta publicação aborda tudo o que mudou: a tabela completa de benchmarks que o Google divulgou em seu anúncio, os períodos de preços que você precisa agendar, todos os lugares onde você pode acessar o modelo hoje e uma requisição cURL funcional que você pode executar em cinco minutos. Se você deseja uma análise mais aprofundada do endpoint, o guia rápido da API Gemini 3.7 Flash acompanha esta explicação, e o Apidog oferece um espaço de trabalho para testar o novo modelo com seus prompts existentes antes de se comprometer com a mudança.
Resumo
- Gemini 3.7 Flash foi lançado em 13 de agosto de 2026, três semanas após o 3.6 Flash. ID do Modelo:
gemini-3.7-flash. - Os benchmarks de codificação e de agentes aumentaram: DeepSWE v1.1 de 49,0% para 65,3%, AutomationBench de 17,0% para 30,4%, WebDev Arena Elo de 1538 para 1588.
- O preço introdutório da API é de $0,75 por 1M de tokens de entrada e $3,75 por 1M de saída, metade do preço de lançamento do 3.6 Flash. As taxas padrão ($1,50 / $7,50) começam em 1º de janeiro de 2027.
- As especificações permanecem estáveis: contexto de entrada de 1M de tokens, limite de saída de 64k, entrada multimodal (texto, imagem, vídeo, áudio, PDF), chamada de função, pesquisa como ferramenta e uso de computador.
- Disponível agora na API Gemini, AI Studio, aplicativo Gemini, Gemini Spark, Google Antigravity, Android Studio e Gemini Enterprise, em mais de 160 países.
- O Gemini 3.5 Pro ainda está atrasado; o Google está entregando melhorias do Flash antes de seu próximo carro-chefe.
O que é o Gemini 3.7 Flash
Flash é o nível intermediário da linha Gemini: mais barato e rápido que o Pro, mais inteligente que o Flash-Lite, e ajustado para as cargas de trabalho de alto volume que compõem a maior parte do tráfego de IA em produção. O Gemini 3.7 Flash é o terceiro lançamento do Flash na linha 3.x, e a abordagem do Google mudou com ele. O anúncio oficial o posiciona como um modelo de codificação e agente primeiro, e um modelo de chat em segundo.
A folha de especificações é herdada do 3.6 Flash:
- Contexto: Janela de entrada de 1M de tokens, limite de saída de 64k tokens.
- Modalidades de entrada: texto, imagem, vídeo, áudio e PDF. A saída é texto.
- Ferramentas: chamada de função, pesquisa como ferramenta e uso de computador.
- Segurança: salvaguardas CBRN e cibernéticas atualizadas são lançadas com a versão.
O que mudou foi o comportamento, não a arquitetura. O Google afirma que o 3.7 Flash depura melhor, gera código pronto para produção e implementável na primeira tentativa com mais frequência, adapta-se quando encontra obstáculos, faz perguntas para esclarecer a intenção quando ambígua e segue as instruções com maior fidelidade. Essas são as alegações. Os benchmarks abaixo são a evidência.
Melhorias nos benchmarks: 3.6 vs 3.7
O Google espalhou esses números em uma postagem de blog e um cartão de modelo. Aqui estão eles em uma única tabela, com as diferenças que importam:
| Benchmark | Gemini 3.6 Flash | Gemini 3.7 Flash | Mudança |
|---|---|---|---|
| DeepSWE v1.1 (codificação agêntica) | 49,0% | 65,3% | +16,3 pts |
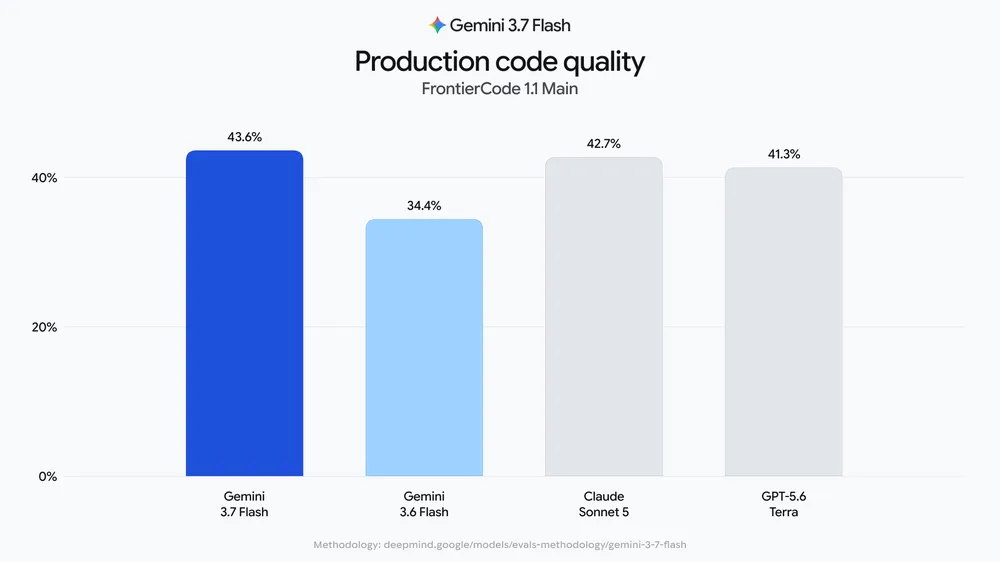
| FrontierCode 1.1 Main | 34,4% | 43,6% | +9,2 pts |
| WebDev Arena (Elo) | 1538 | 1588 | +50 Elo |
| GDP.pdf (raciocínio de documentos) | 22,0% | 34,0% | +12,0 pts |
| AutomationBench (tarefas de agente) | 17,0% | 30,4% | +13,4 pts |
Duas pontuações autônomas completam o cenário: 90,7% no Harvey LAB-AA, um benchmark de raciocínio jurídico, e 97,0% na recuperação de contexto longo de 128k agulhas. Esse segundo número importa se você alimenta o modelo com documentos longos; a qualidade da recuperação em profundidade é onde muitos modelos falham discretamente.
O padrão em toda a tabela é consistente. Os maiores saltos ocorrem nos benchmarks agênticos, aqueles que medem o trabalho em várias etapas em vez de respostas únicas. O AutomationBench passando de 17,0% para 30,4% é o tipo de diferença que muda as tarefas que você pode atribuir a um modelo de nível intermediário. A cobertura do lançamento destacou o ganho do DeepSWE como o resultado principal, e por um bom motivo: um salto de 16 pontos na codificação agêntica em três semanas é incomum para qualquer linha de modelo. Para contextualizar como as diferenças de benchmark se traduzem entre modelos concorrentes, a comparação Grok 4.6 vs GPT 5.6 vs Claude mostra como lacunas semelhantes se manifestam em cargas de trabalho reais.
Melhorias em codificação e agentes
A tabela de benchmarks informa o que melhorou. As notas de lançamento do Google dizem como isso se manifesta na prática, e as afirmações são específicas o suficiente para serem testadas:
- Depuração. O modelo é melhor em localizar a causa de uma falha em vez de corrigir os sintomas. O ganho do DeepSWE é o número de apoio aqui, já que esse benchmark pontua correções de bugs em vários arquivos em repositórios reais.
- Código implementável na primeira tentativa. O Google afirma que mais códigos gerados são executados sem uma rodada de correção. A melhoria de 9,2 pontos do FrontierCode é a medida pública mais próxima.
- Lidar com obstáculos. Quando uma chamada de ferramenta falha ou um arquivo está faltando, o 3.7 Flash adapta seu plano em vez de entrar em loop. Este é o comportamento que o AutomationBench enfatiza.
- Esclarecimento de intenção. O modelo faz uma pergunta quando a solicitação é ambígua em vez de adivinhar. Em um pipeline de agente, uma rodada de esclarecimento é mais barata do que uma resposta errada de 5.000 tokens.
- Fidelidade às instruções. Solicitações de formato de saída, limites de comprimento e restrições negativas se mantêm de forma mais confiável em conversas longas.
O conjunto de ferramentas importa tanto quanto as pontuações brutas. A chamada de função e a pesquisa como ferramenta são herdadas do 3.6, e o suporte ao uso de computador significa que o modelo pode controlar um navegador quando nenhuma API existe para a tarefa. Essa última capacidade fica em uma posição estranha para os desenvolvedores: poderosa, mas mais lenta e menos determinística do que um endpoint estruturado. A análise de uso de computador vs. APIs estruturadas abrange quando cada abordagem vale a pena.
Preços: metade do preço até 31 de dezembro de 2026
O Gemini 3.7 Flash é lançado com uma tabela de preços em duas fases na API Gemini:
| Período | Entrada (por 1M de tokens) | Saída (por 1M de tokens) |
|---|---|---|
| Até 31 de dezembro de 2026 | $0,75 | $3,75 |
| A partir de 1º de janeiro de 2027 | $1,50 | $7,50 |
A taxa introdutória é metade do custo do Gemini 3.6 Flash no lançamento, o que torna os próximos quatro meses e meio o período mais barato que esta família de modelos já teve. O problema é a duplicação em 1º de janeiro. Se você construir um orçamento em torno de tokens de entrada de $0,75, esse orçamento será comprometido em cinco meses, a menos que você planeje isso agora.
Duas conclusões práticas. Primeiro, verifique as taxas atuais na página oficial de preços antes de lançar qualquer coisa; os períodos introdutórios já mudaram antes. Segundo, modele seus custos para 2027 com a taxa padrão, não com a taxa promocional. Os exemplos completos, incluindo cálculos de tokens para chatbots, pipelines de documentos e loops de agentes, estão na análise de preços do Gemini 3.7 Flash.
Onde você pode usá-lo hoje
O Google lançou o 3.7 Flash em toda a sua área de atuação no primeiro dia, em mais de 160 países:
- API Gemini. O caminho para desenvolvedores. Obtenha uma chave do AI Studio e chame
gemini-3.7-flashdiretamente. - Google AI Studio. Playground no navegador para testes de prompts antes de escrever código.
- Aplicativo Gemini. O aplicativo de chat para consumidores incorporou o novo modelo no lançamento.
- Gemini Spark. Disponível para assinantes AI Pro e Ultra.
- Google Antigravity. O ambiente de desenvolvimento agêntico do Google é executado nele.
- Android Studio. A integração do IDE obtém o modelo para assistência de código.
- Gemini Enterprise. A oferta gerenciada para organizações com requisitos de conformidade.
Para acesso à API em escala, você também obtém o caminho do Vertex AI em aiplatform.googleapis.com com OAuth, IAM e registro de auditoria. Mesmo modelo, mesmo esquema de solicitação, diferentes garantias de autenticação e hospedagem.
Por que o Google lançou o Flash antes do Gemini 3.5 Pro
A ordem de lançamento é incomum. Modelos carro-chefe normalmente lideram e os níveis mais baratos seguem. O Google inverteu isso: 3.6 Flash no final de julho, 3.7 Flash três semanas depois, e Gemini 3.5 Pro ainda sem data. A Axios relata que o Google está deliberadamente lançando atualizações do Flash antes de seu próximo carro-chefe enquanto o Pro permanece atrasado.
Interpretado como estratégia em vez de um atraso na programação, a mudança faz sentido. A maior parte do tráfego de produção é executada em modelos de nível médio porque é onde o custo por token atende à qualidade aceitável. Melhorar o Flash aprimora o modelo que a maioria dos clientes usa todos os dias. Também mantém o Google na conversa sobre o ciclo de lançamentos durante um período em que todos os grandes laboratórios estão lançando rapidamente, sem queimar o anúncio do carro-chefe.
Para os desenvolvedores, a consequência prática é que o nível Flash não é mais a ponta de trás. As capacidades de agente estão chegando aqui primeiro. Se você adiou a migração de cargas de trabalho do 3.6 porque estava esperando pelo Pro, o guia de migração do 3.6 para o 3.7 Flash cobre a troca, que para a maioria das bases de código é uma alteração de uma linha no ID do modelo mais uma passada de regressão.
Como testar a API em cinco minutos
Você precisa de uma chave de API do AI Studio. Crie uma, exporte-a e envie sua primeira requisição:
export GEMINI_API_KEY="AIza..."

curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.7-flash:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [{
      "parts": [{ "text": "Review this function for bugs: def dedupe(items): return list(set(items))" }]
    }],
    "generationConfig": {
      "temperature": 0.4,
      "maxOutputTokens": 1024
    }
  }'
A resposta retorna como um array candidates com o texto gerado em content.parts, além de um bloco usageMetadata que informa as contagens exatas de tokens de entrada e saída. Monitore esse bloco desde o primeiro dia; ele é seu medidor de custos. Para streaming, troque :generateContent por :streamGenerateContent?alt=sse e a API retorna eventos enviados pelo servidor.
Assim que a primeira chamada funcionar, tire a experimentação do seu terminal. No Apidog, importe a especificação da Generative Language API, vincule GEMINI_API_KEY ao cabeçalho x-goog-api-key como uma variável de ambiente e salve o ID do modelo como uma variável de caminho. Agora você pode reexecutar o mesmo prompt contra gemini-3.6-flash e gemini-3.7-flash lado a lado, observar fluxos SSE renderizando ao vivo e salvar respostas como exemplos para que as verificações de regressão não queimem tokens. É a maneira mais rápida de verificar a afirmação do Google de “melhor seguimento de instruções” com seus próprios prompts, em vez de aceitar a palavra da postagem de lançamento.
Perguntas Frequentes
O Gemini 3.7 Flash é gratuito para usar?
A API Gemini possui um nível gratuito através do AI Studio com cota diária, o que abrange prototipagem. O uso pago começa com a taxa introdutória de $0,75 por 1M de tokens de entrada até 31 de dezembro de 2026. Se você deseja estender ainda mais a cota gratuita, o guia para acesso gratuito à API Gemini cobre os limites e como trabalhar dentro deles.
Qual a diferença entre o Gemini 3.6 Flash e o 3.7 Flash?
Mesmas especificações, melhor comportamento. A janela de contexto, limite de saída, modalidades e suporte a ferramentas permanecem inalterados. Os ganhos estão nos benchmarks de codificação e de agentes: DeepSWE subiu 16,3 pontos, AutomationBench subiu 13,4 pontos, WebDev Arena subiu 50 Elo. O Google também reivindica melhor depuração, seguimento de instruções e planejamento em várias etapas.
O Gemini 3.7 Flash substitui o Gemini 3.5 Pro?
Não. O Pro continua sendo o nível carro-chefe para as tarefas de raciocínio mais difíceis, e o Gemini 3.5 Pro ainda está em desenvolvimento. O Flash 3.7 é o modelo que o Google recomenda para trabalhos de produção de alto volume onde custo e latência importam tanto quanto a qualidade.
O que acontece com os preços em 1º de janeiro de 2027?
A taxa introdutória termina e o preço padrão assume: $1,50 por 1M de tokens de entrada e $7,50 por 1M de tokens de saída, o dobro da taxa de lançamento. Orce com base na taxa padrão para qualquer carga de trabalho que perdure além de 2026.
O Gemini 3.7 Flash pode processar imagens e PDFs?
Sim. As modalidades de entrada cobrem texto, imagem, vídeo, áudio e PDF no mesmo array contents. A saída é apenas texto. A pontuação de benchmark GDP.pdf de 34,0%, subindo de 22,0%, é a evidência do Google de que a compreensão de documentos melhorou junto com os ganhos de codificação.
Onde o 3.7 Flash se encaixa na sua pilha
O Gemini 3.7 Flash é um modelo de nível intermediário com pontuações de benchmark de nível de agente e um desconto de preço de quatro meses. Essa combinação torna a decisão menos sobre avaliá-lo e mais sobre a rapidez. Os ganhos agênticos são números reais em benchmarks públicos, as especificações correspondem ao que você executa hoje no 3.6, e o preço introdutório significa que testá-lo agora custa metade do que a mesma avaliação custará em janeiro.
A sequência sensata: execute seu conjunto de prompts existente contra gemini-3.7-flash, compare as saídas e o uso de tokens com seu modelo atual, e deixe os resultados escolherem o vencedor. Baixe o Apidog para executar essa comparação em um único espaço de trabalho; salve suas respostas do 3.6 como exemplos, reproduza as mesmas requisições contra o 3.7, e você saberá em uma tarde se a história do benchmark se mantém para sua carga de trabalho.