
A equipe Qwen da Alibaba lançou o Qwen-Image-2.1 como código aberto em 20 de setembro de 2026. É um modelo que realiza geração de texto para imagem e edição de imagem, com 7 bilhões de parâmetros em seu componente de geração visual, e pode gerar PNGs transparentes diretamente de um prompt, em vez de simular a transparência com uma passagem de remoção de fundo. A publicação de lançamento lista quatro mudanças: uma arquitetura mais leve e rápida, transparência nativa, edição com até 10 imagens de referência e melhor tipografia e detalhes de retratos. Os pesos estão no Hugging Face e ModelScope, e o código está no GitHub.
Uma linha na ficha do modelo importa mais do que qualquer recurso: a licença é a Qwen Research License, não a Apache 2.0. O uso comercial requer um acordo separado. Se você está avaliando o 2.1 para um produto, leia essa seção antes dos benchmarks. Se você deseja executá-lo, o guia de como usar o Qwen-Image-2.1 contém o código diffusers e um wrapper HTTP que você pode testar no Apidog. Se você está comparando-o com a API hospedada Qwen Image 3.0, a comparação entre 2.1 e 3.0 é a página de decisão.
Qwen-Image-2.1 em resumo
| Item | Detalhe (publicação de lançamento, ficha do modelo, README do GitHub) |
|---|---|
| Data de lançamento | 20 de setembro de 2026 |
| O que ele faz | Geração de texto para imagem e edição de imagem em um único modelo, incluindo saída transparente (RGBA) |
| Gerador visual | 32 camadas DiT de fluxo único, 7B parâmetros |
| Codificador de texto | Qwen3-VL 8B |
| VAE | Autoencoder RGBA de 64 canais, compressão espacial 16x |
| Saída padrão | 2048 x 2048; sete proporções de aspecto até 2752 x 1536 |
| Imagens de referência | Até 10 por edição |
| Edição local | Círculos, anotações pintadas ou uma imagem de máscara separada |
| Modelos complementares | Modelos de reescrita de prompt Qwen-Image-2.1-PE-T2I e PE-I2I (fine-tunes de Qwen3.5-VL 9B) |
| Licença | Qwen Research License Agreement; o uso comercial requer uma licença separada |
| Experimente | Hugging Face Space, Qwen Chat, ComfyUI (suporte nativo desde o dia do lançamento) |
Onde ele se posiciona na linha Qwen-Image
O Qwen-Image original foi lançado em agosto de 2025 como um modelo MMDiT de 20B conhecido pela renderização de texto, com o Qwen-Image-Edit como um modelo de edição separado. Ao longo do final de 2025, a linha se dividiu ainda mais: a atualização 2512 para realismo, o Edit-2511 para consistência de múltiplas pessoas e o Qwen-Image-Layered em dezembro para camadas transparentes. O Qwen-Image-2.0 em fevereiro de 2026 unificou a geração e edição em um único modelo de 7B com saída nativa de 2K.
A versão 2.1 mantém o tamanho e o design unificado do 2.0 e incorpora a transparência do modelo Layered, de modo que um único checkpoint agora cobre o que antes exigia três. Ele também ganha um novo caminho de inferência (mais sobre isso abaixo) e uma interface de edição construída em torno de máscaras e múltiplas referências. Em paralelo, a Alibaba mantém uma linha hospedada: Qwen Image 3.0 e 3.0 Pro lançados em julho de 2026 como modelos de API sem pesos publicados. Portanto, a nomenclatura é um fork, não uma sequência. O 2.1 é o modelo aberto que você baixa; o 3.0 é o modelo que você aluga.
O que há de novo na 2.1
Uma arquitetura mais leve e um caminho de edição mais rápido
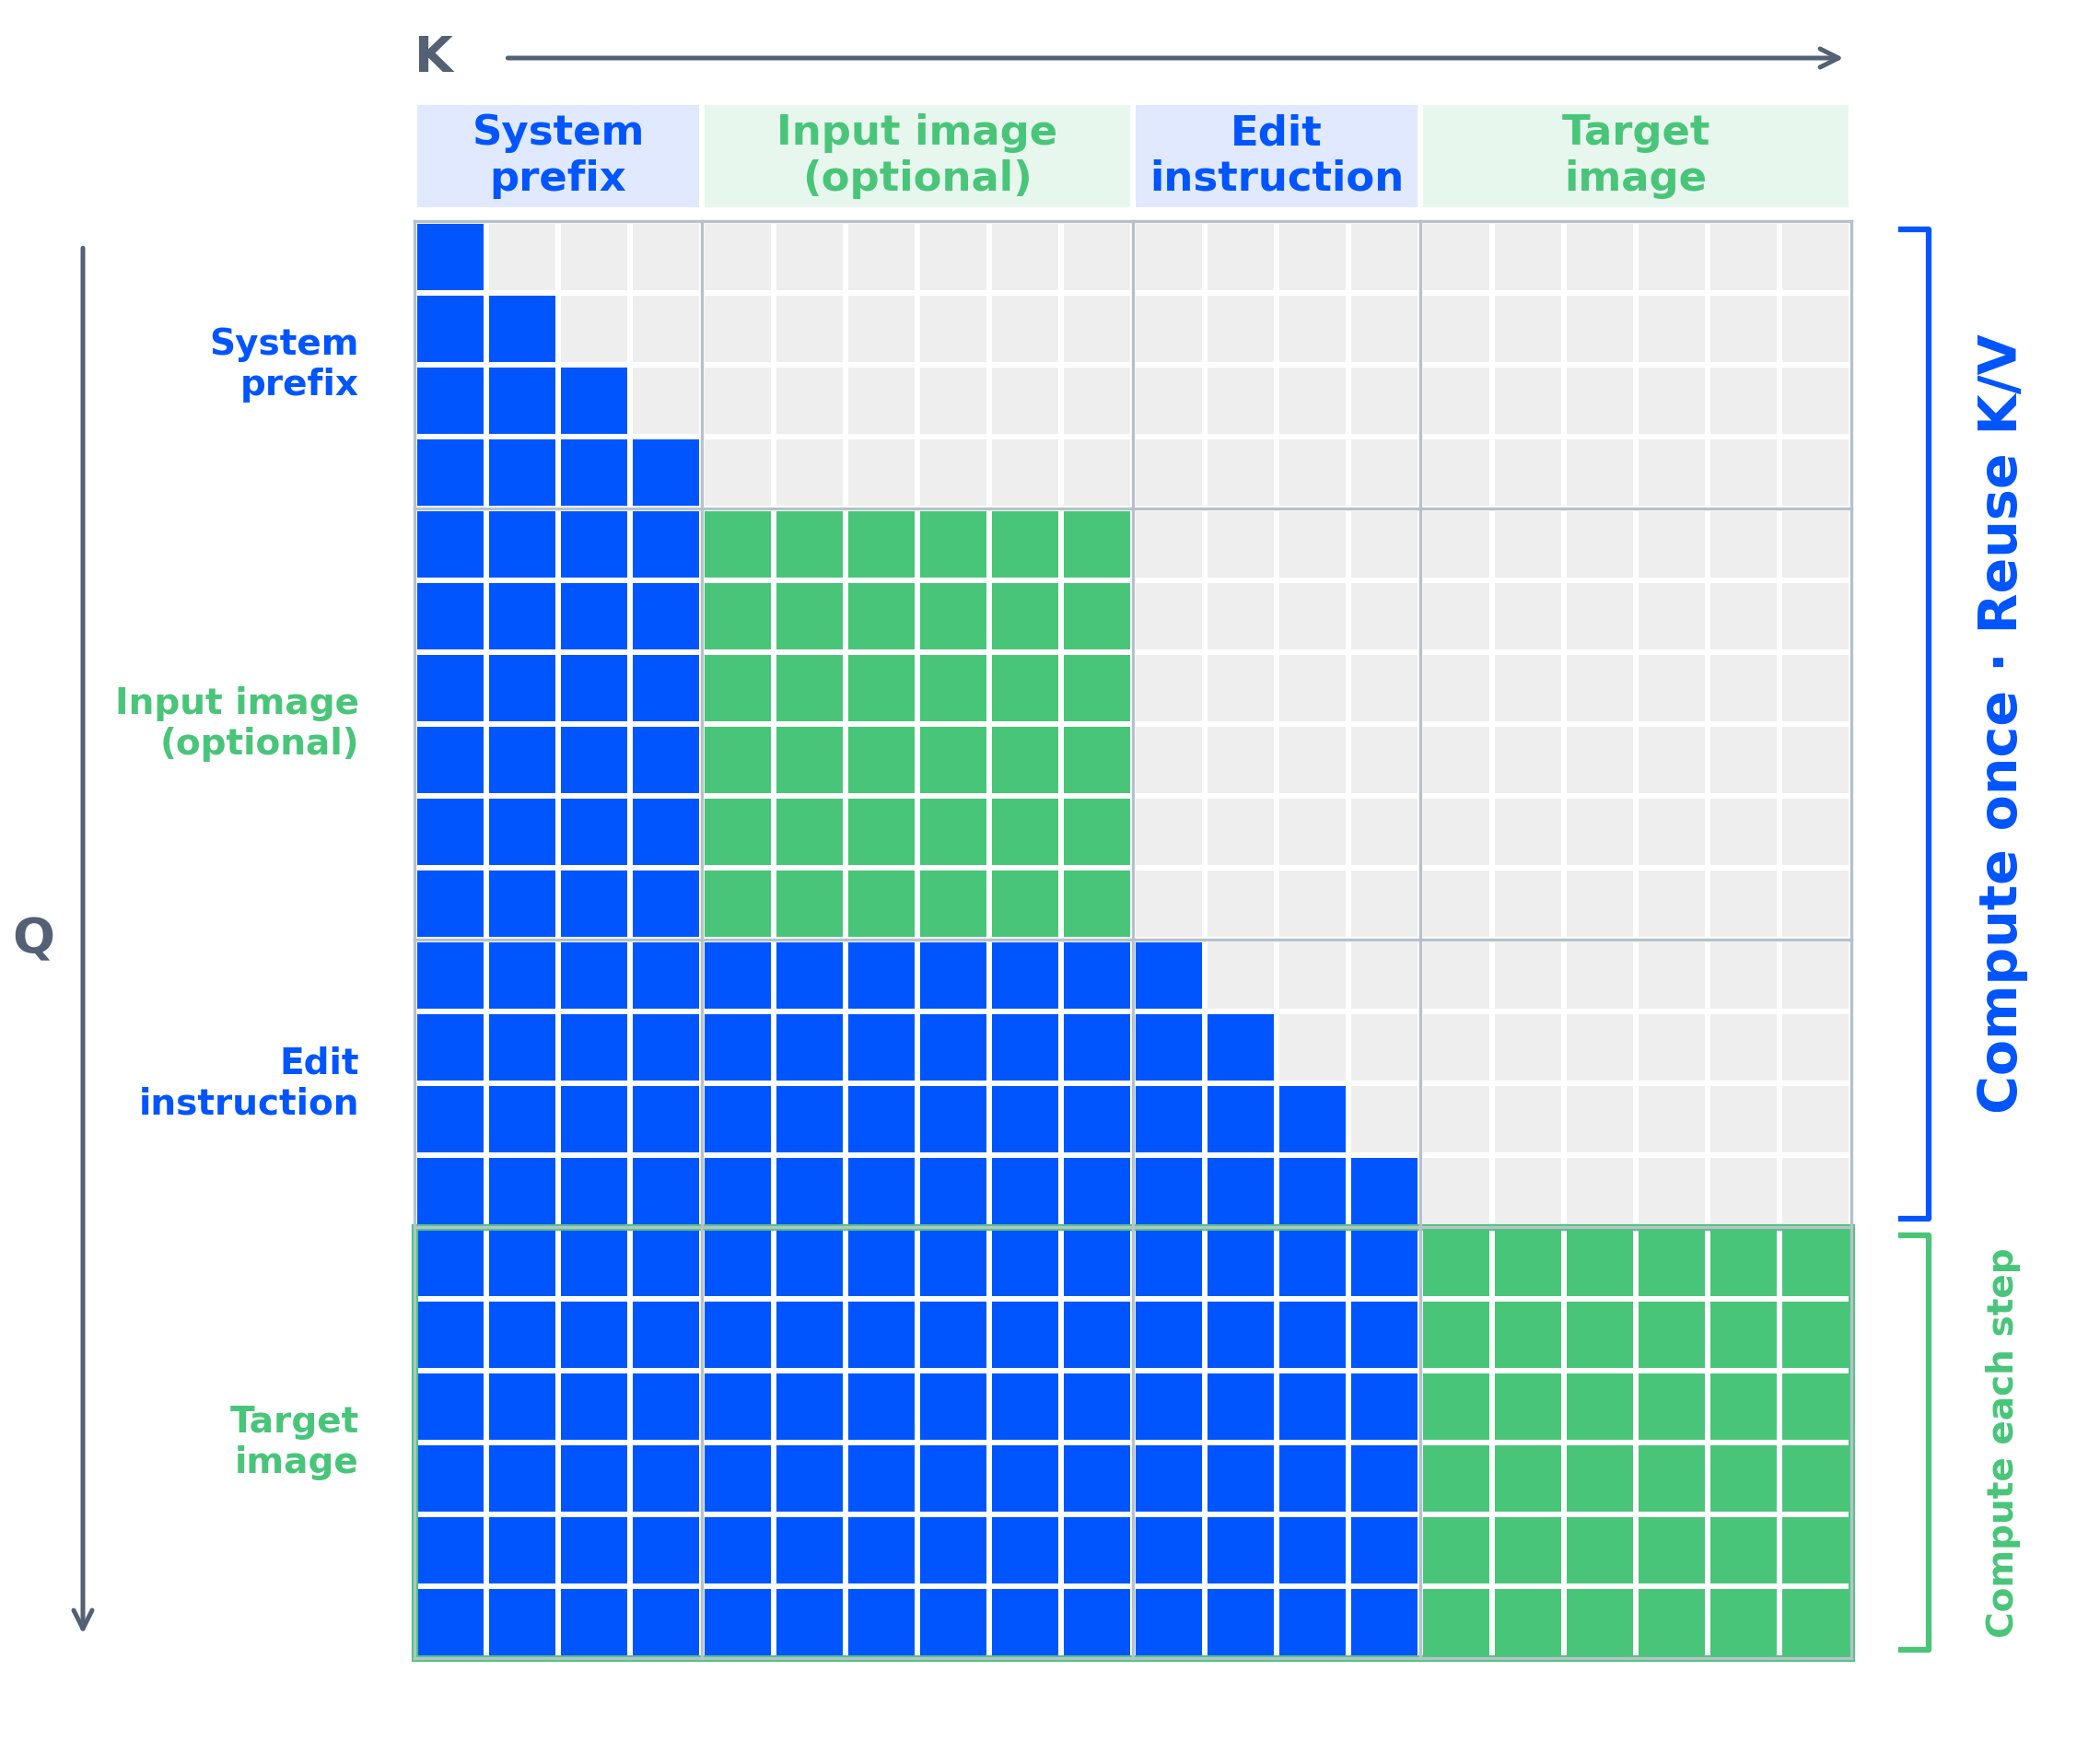
O gerador visual possui 32 camadas DiT de Fluxo Único com 7B de parâmetros, emparelhado com o codificador Qwen3-VL de 8B e um VAE que suporta um canal alfa nativamente. A engenharia interessante está na atenção. Qwen a chama de granularidade mista: tokens de texto (o prefixo do sistema e sua instrução de edição) usam uma máscara causal em nível de token, enquanto a geração de imagem usa uma máscara em nível de chunk. Como as imagens de entrada e a instrução são estáticas entre os passos de denoising, o modelo calcula seu cache de chave-valor uma vez no primeiro passo e o reutiliza. O benefício declarado da Qwen é menor latência e memória ao editar com várias imagens de referência, que é exatamente a carga de trabalho que ficou mais pesada com o limite de 10 imagens.
O agendador é de flow matching com passos discretos de Euler, e o código de referência executa 40 passos por padrão.
Transparência nativa no mesmo modelo
Esta é a manchete. Você pede uma imagem transparente no prompt e o modelo retorna RGBA. A frase recomendada no README é literal: comece com “This is an RGBA image with transparency” (Esta é uma imagem RGBA com transparência) e diga que o fundo é transparente. A publicação de lançamento mostra objetos únicos, composições de múltiplos elementos e três casos de edição em entradas transparentes: mudança da expressão de um objeto mantendo o canal alfa, substituição de texto dentro de uma camada transparente e extração de um objeto de uma foto RGB comum como um recorte RGBA.
Para equipes de produto, isso substitui um pipeline de dois modelos (gerar, depois mascarar) por uma única chamada. Também remove os artefatos de halo que os removedores de fundo deixam ao redor de cabelos e vidros, porque o canal alfa é gerado, e não inferido posteriormente. Se as bordas se mantêm em 2K em seus próprios ativos é algo a ser testado, e não presumido; o guia da camada gratuita mostra onde executar esses testes sem uma GPU.
Edição com até 10 referências e controle real de região
Três recursos de edição se destacam nos exemplos de lançamento:
- Múltiplas referências. Seis retratos se transformam em uma foto de grupo; uma modelo, roupas, sapatos, bolsa e chapéu se tornam um traje completo; dez fotos de móveis se transformam em um cômodo mobiliado. O limite é de 10 imagens de entrada.
- Edição local de três maneiras. Desenhe círculos coloridos e refira-se a cada um pela cor no prompt (“remover o relógio no círculo azul”), pinte sobre uma região ou passe o original intocado mais uma máscara separada como duas entradas para que nada na fonte seja coberto.
- Fidelidade. A Qwen afirma que a identidade facial e o texto, textura e forma do produto sobrevivem melhor às edições do que no 2.0. A publicação mostra pares de antes e depois, mas sem métricas, então trate isso como uma afirmação a ser verificada em seus próprios SKUs.
O mesmo caminho de edição lida com panoramas a partir de uma selfie, infográficos a partir de uma foto de produto e storyboards a partir de uma ficha de personagem de três vistas. Edições locais sequenciais podem ser encadeadas em curtas animações, o que a publicação demonstra com um clipe de capivara.
Tipografia e qualidade de retrato
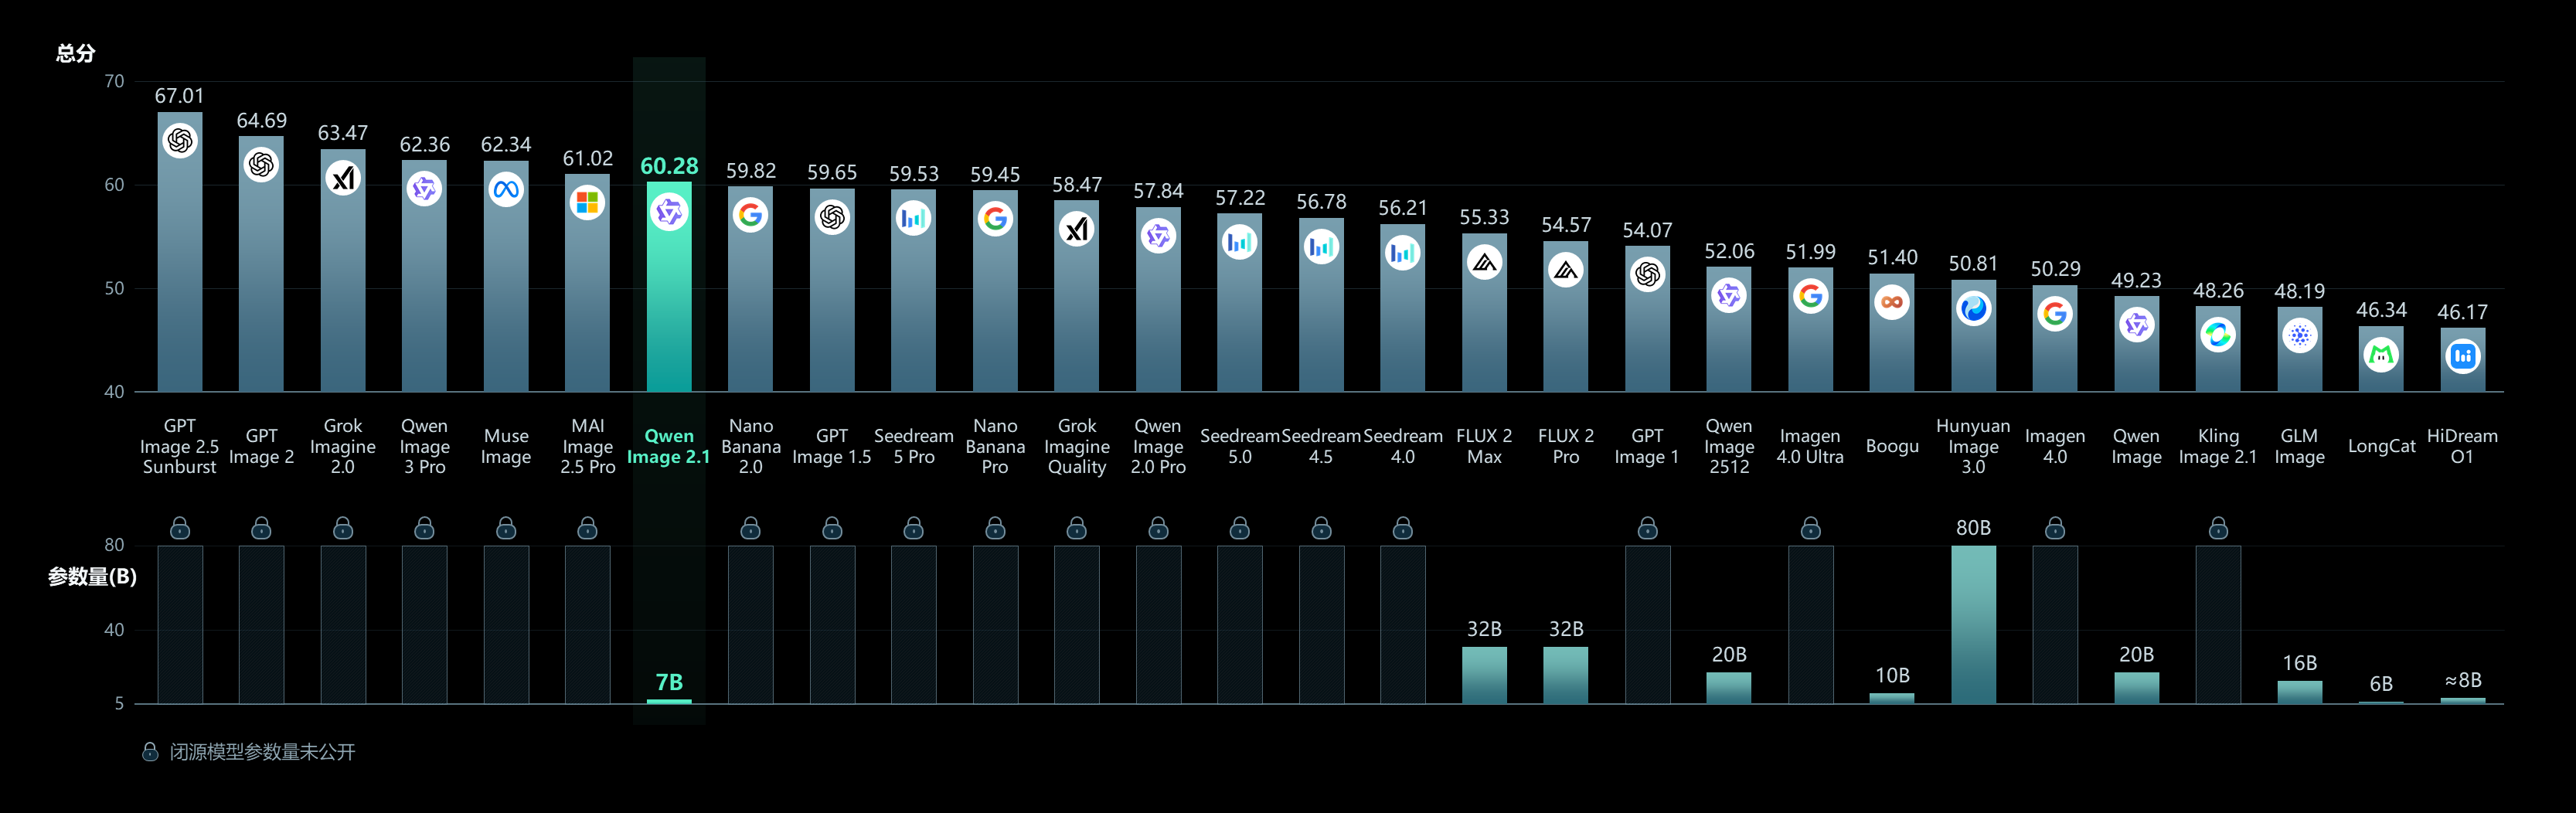
A Qwen tem liderado a renderização de texto de código aberto desde o primeiro Qwen-Image, e o 2.1 a estende para estilo de fonte, layout e como o texto se posiciona na composição, em vez de apenas a ortografia. A iluminação de retrato e os detalhes finos também recebem um tratamento especial. A publicação de lançamento apoia isso com um gráfico Qwen-Image-Bench comparando modelos abertos e fechados; o gráfico é uma imagem e a publicação não apresenta números, então não citamos nenhum aqui.
A licença: pesos abertos, termos de pesquisa
O Qwen-Image original era Apache 2.0. O Qwen-Image-2.1 é lançado sob o Qwen Research License Agreement, e o texto da licença é curto e claro sobre o ponto que importa:
- Você não pode usar o modelo “para qualquer propósito comercial sem obter uma licença comercial separada”, solicitada por e-mail da Qwen.
- A redistribuição e os derivados devem conter a licença, um aviso “Built with Qwen” (Construído com Qwen) ou “Improved using Qwen” (Melhorado usando Qwen), e a linha de direitos autorais nomeando Hangzhou Tongyi Laboratory.
- Você não pode usar “Qwen” como o nome principal de um derivado.
- O acordo é regido pela lei chinesa com jurisdição em Hangzhou.
Os modelos complementares de reescrita de prompt são lançados sob os mesmos termos. Para um projeto de hobby, um artigo de pesquisa ou uma avaliação interna, isso está ok. Para um recurso SaaS, isso significa uma conversa com a Alibaba primeiro, ou usar a API hospedada 3.0, que vem com termos comerciais comuns e um preço por imagem.
Os dois modelos de reescrita de prompt
Junto com o gerador, a Qwen publicou Qwen-Image-2.1-PE-T2I e Qwen-Image-2.1-PE-I2I. O PE-T2I é um Qwen3.5-VL 9B ajustado que recebe uma breve solicitação em qualquer idioma e retorna JSON com um prompt detalhado em inglês e uma proporção de aspecto recomendada. O PE-I2I é a contraparte de edição [VERIFICAR]. Eles são opcionais, e é assim que o Space de demonstração obtém prompts longos e estruturados a partir de entradas de uma única linha. Se você está construindo uma API em torno do 2.1, este é o passo de “aprimoramento de prompt” que produtos como o ChatGPT Images fazem de forma invisível.
O que o lançamento não disse
- Sem números de VRAM por resolução. O README aponta para
enable_model_cpu_offload(), vLLM-Omni com FP8, SGLang e LightX2V para um serviço mais leve ou rápido, além de suporte AMD, mas sem tabela. - Sem números de benchmark publicados, apenas um gráfico.
- Nenhuma API hospedada para 2.1 no Model Studio no lançamento [VERIFICAR]; a linha hospedada é 3.0.
- Nenhuma afirmação de velocidade de inferência fixa, apenas “eficiência aprimorada” devido à reutilização do cache KV.
Colocando-o por trás de uma API e testando-o
A maioria das equipes não chamará um pipeline de diffusers do código da aplicação. Elas o encapsularão em um serviço HTTP em uma caixa de GPU e farão chamadas para ele. Uma vez que é um endpoint, é uma API como qualquer outra, e o Apidog é onde você a projeta e testa: defina o esquema da solicitação (prompt, imagens de referência opcionais, proporção de aspecto, uma flag de transparência), envie chamadas reais, afirme que a resposta é um PNG com um canal alfa e transforme os casos bem-sucedidos em um conjunto de testes de regressão que você executa novamente após cada atualização do modelo. Você também pode simular o endpoint para que a equipe de frontend construa contra um contrato estável enquanto a GPU está ocupada. O guia de como usar detalha esse wrapper e os testes do Apidog passo a passo.
Baixe o Apidog para acompanhar.
FAQ
O Qwen-Image-2.1 é gratuito para uso comercial? Não, não sem uma licença comercial separada da Qwen. Os pesos são gratuitos para baixar e usar para fins de pesquisa e não comerciais. Consulte a seção de licença acima e o guia da camada gratuita para as formas sem custo de experimentá-lo.
Como o 2.1 difere do Qwen-Image-2.0? Mesmo tamanho de 7B e design unificado de geração mais edição. Novidades no 2.1: saída e edição RGBA nativas, até 10 imagens de referência, edições locais orientadas por máscaras e anotações, um caminho de atenção de granularidade mista com reutilização de cache KV para edição de múltiplas imagens mais rápida, e tipografia e detalhes de retratos aprimorados.
É o mesmo que Qwen Image 3.0? Não. O 3.0 e o 3.0 Pro são modelos de API hospedados lançados em julho de 2026 sem pesos abertos; o 2.1 é o modelo de pesos abertos. A comparação aborda as diferenças de preço e capacidade.
Qual hardware ele precisa? A Qwen não publicou os requisitos de VRAM. O código de referência carrega o pipeline em bfloat16 em um dispositivo CUDA e oferece offload de CPU; stacks de serviço da comunidade adicionam FP8. Espere uma GPU de data center ou de alto desempenho para consumidor para saída 2K em 40 passos.
Ele pode editar imagens transparentes, não apenas gerá-las? Sim. Os exemplos de lançamento mostram a mudança da expressão de um objeto e a substituição de texto dentro de uma camada transparente, mantendo o canal alfa, e a extração de um objeto RGBA de uma foto RGB.
Para onde ir em seguida
O Qwen-Image-2.1 é um poderoso modelo de edição de código aberto com um recurso que ninguém mais oferece em um único checkpoint, a transparência nativa, e uma restrição que decide se você pode usá-lo: a licença de pesquisa. Execute-o localmente com o guia de como usar, experimente-o sem uma GPU através das opções gratuitas e compare a API hospedada 3.0 antes de se comprometer. Qualquer que você escolha, coloque o endpoint em teste no Apidog para que uma troca de modelo nunca quebre seu produto silenciosamente.