
A Alibaba lançou oficialmente o Qwen 3.8-Max no início de agosto de 2026, e ele chega com uma combinação incomum: um modelo Mixture-of-Experts de 2,4 trilhões de parâmetros que ativa apenas 95 bilhões de parâmetros por token, um preço fixo de $2/$6 por milhão de tokens em um contexto completo de 1M, e a promessa de que os pesos serão disponibilizados publicamente no Hugging Face e ModelScope dentro de uma semana. Essa última parte é importante. Nenhum modelo da classe Qwen-Max havia sido lançado com pesos abertos antes.
O anúncio oficial o descreve como o Qwen mais capaz até hoje, e a tabela de benchmarks do fornecedor corrobora isso com alguns resultados realmente fortes e algumas perdas honestas. Este guia detalha o que o Qwen 3.8-Max realmente é, o que os números dizem, onde ele se posiciona em relação a Kimi K3, Fable 5 e GPT-5.6 Sol, e todas as formas de executá-lo hoje. Se você planeja desenvolver com a API, o modelo vem com endpoints compatíveis com OpenAI e Anthropic, o que torna um cliente ciente de protocolo como o Apidog útil para testar ambas as formas com a mesma chave.
Qwen 3.8-Max em resumo
| Especificação | Qwen 3.8-Max |
|---|---|
| Desenvolvedor | Alibaba (equipe Qwen) |
| Lançamento | Início de agosto de 2026 (Disponibilidade Geral no Model Studio, 3 de agosto) |
| Arquitetura | MoE, construído sobre a base Qwen 3.5 |
| Parâmetros totais | 2,4T |
| Parâmetros ativos | 95B (~4% de ativação) |
| Janela de contexto | 1.000.000 tokens |
| Saída máxima | 65.536 tokens |
| Modalidades | Entrada de texto + imagem, saída de texto |
| Controles de raciocínio | reasoning_effort: xhigh (padrão), medium, low |
| ID do modelo da API | qwen3.8-max |
| Precificação | $2 de entrada / $6 de saída por 1M de tokens, fixo em todo o contexto |
| Pesos abertos | Prometidos para a próxima semana (~10 de agosto); ainda não disponíveis para download no início de agosto de 2026 |
| Protocolos da API | Compatíveis com OpenAI e Anthropic |
Tudo nesta tabela vem dos materiais de lançamento da própria Alibaba e da página de preços do Model Studio. Agora, os detalhes.
O que é o Qwen 3.8-Max
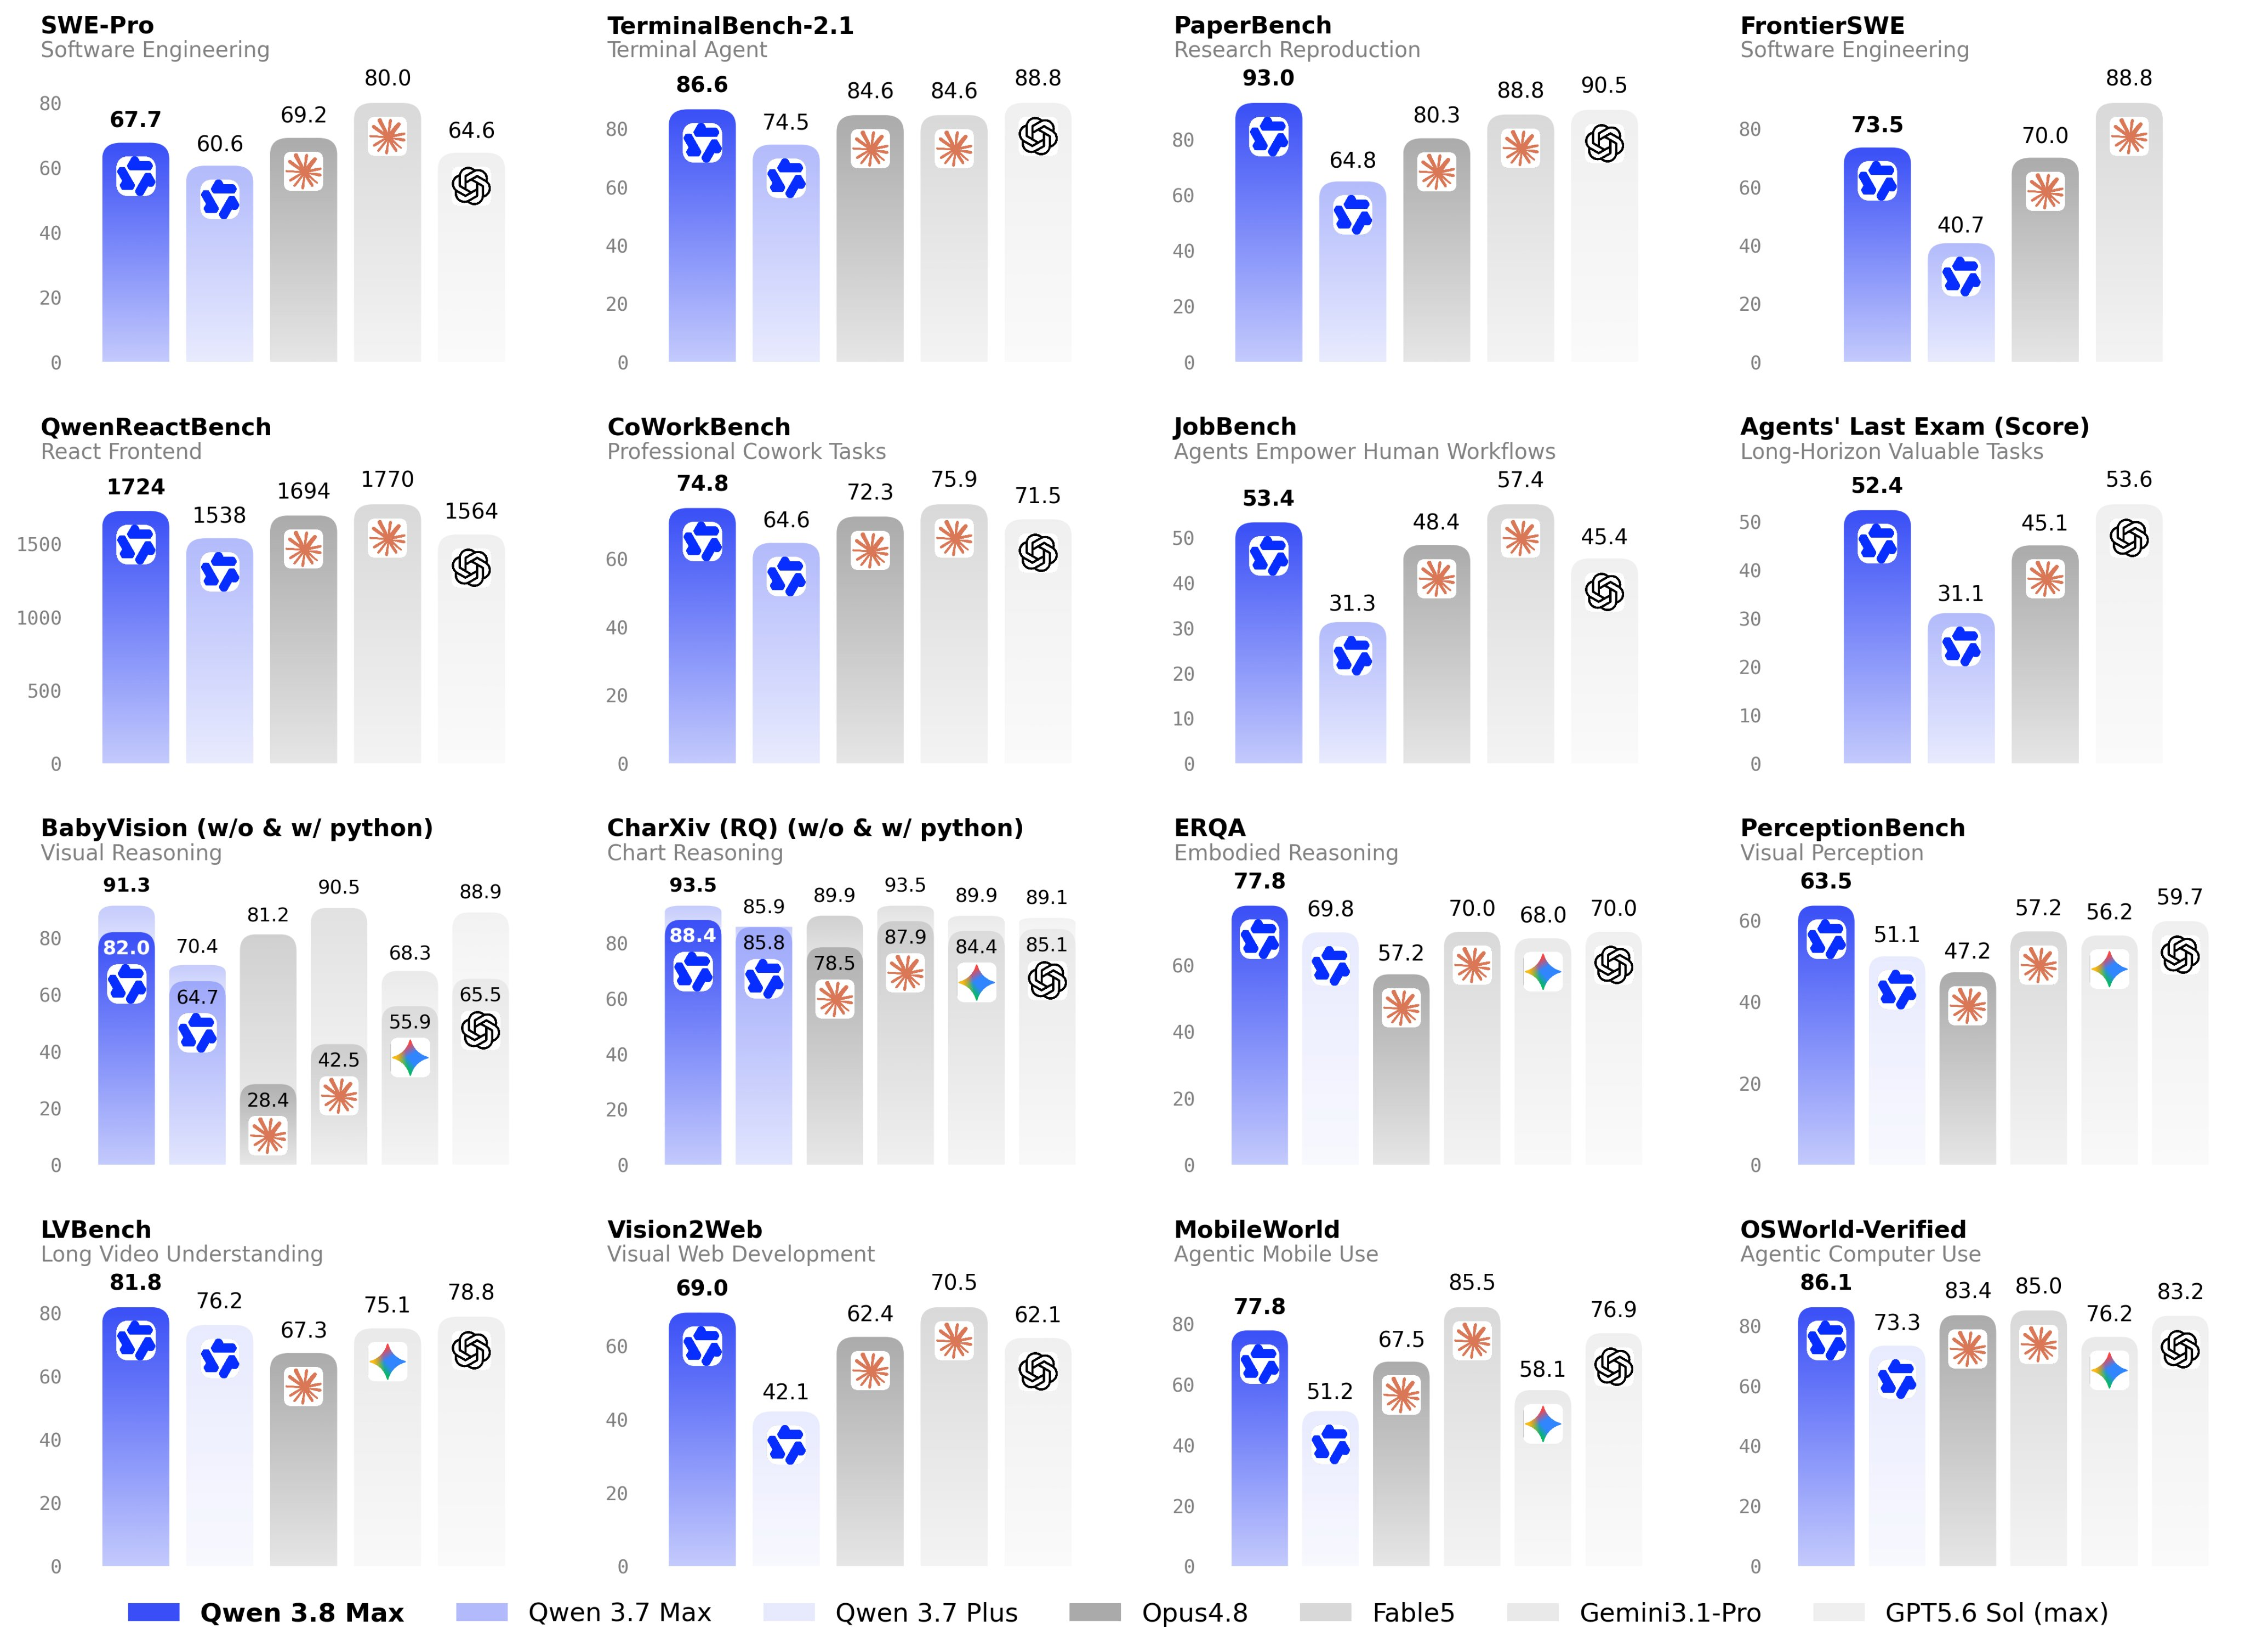
O Qwen 3.8-Max é o novo carro-chefe da família Qwen da Alibaba, construído sobre a base arquitetônica do Qwen 3.5. Ele substitui o Qwen3.7-Max no topo da linha, e a tabela do fornecedor mostra saltos significativos em relação ao seu predecessor: o Terminal Bench 2.1 passou de 74.5 para 86.6, e o PaperBench de 64.8 para 93.0. Se você está decidindo se deve migrar do modelo mais antigo, as diferenças estão detalhadas em nossa comparação Qwen 3.8 vs Qwen 3.7 Max.
A principal especificação é a divisão de parâmetros. 2,4T de parâmetros totais soa enorme, e é, mas o design MoE ativa apenas 95B por passagem direta. Essa taxa de ativação de aproximadamente 4% é a razão pela qual a Alibaba pode servir um modelo tão grande por $2/$6 por milhão de tokens. Para contextualizar, o Kimi K3 roda com 2,8T totais e 104B ativos, então o Qwen 3.8-Max é o modelo menor em ambos os aspectos.
No lado da entrada, o modelo aceita texto e imagens via API. O blog da Alibaba também demonstra compreensão de documentos longos (PDFs com mais de 200 páginas) e compreensão de vídeos de 100 horas através do que eles chamam de gráficos de memória. Trate-os como capacidades demonstradas no blog, e não como tipos de entrada de API separados; as configurações de API publicadas listam texto e imagem como as modalidades de entrada.
O raciocínio é controlado através de um parâmetro reasoning_effort com três níveis: xhigh (o padrão), medium e low. Há também enable_thinking e preserve_thinking, com o raciocínio preservado por padrão. Um detalhe de precificação importante a saber antecipadamente: os modos com e sem raciocínio são cobrados pela mesma tarifa, mas os tokens de raciocínio contam como saída, então as contas reais no padrão xhigh serão mais altas do que um cálculo de preço de tabela ingênuo.
O primeiro Qwen de classe Max com pesos abertos
Esta é a maior jogada estratégica do lançamento. A Alibaba já abriu o código de muitos modelos Qwen ao longo dos anos, mas nunca da camada Max. O Qwen 3.8-Max quebra esse padrão: a empresa diz que os pesos serão disponibilizados no Hugging Face e ModelScope 'na próxima semana', o que se traduz em torno de 10 de agosto.
Duas ressalvas, declaradas claramente:
- Os pesos ainda não estão disponíveis para download. No início de agosto de 2026, a promessa é uma promessa. O Kimi K3 estabeleceu um precedente recente aqui: seus pesos chegaram 11 dias após o lançamento, então um pequeno atraso não seria surpreendente.
- Hospedar um modelo de 2,4T por conta própria é um projeto de múltiplos nós. Mesmo quantizado agressivamente, não é algo que você executa em uma estação de trabalho. Para a maioria das equipes, 'pesos abertos' significarão acesso hospedado mais barato através de provedores terceirizados, e não uma implantação local.
Se o seu interesse no Qwen 3.8-Max é principalmente não pagar o preço de tabela, as rotas realistas atuais são o Qwen Chat e a cota gratuita do Model Studio, ambas abordadas em nosso guia sobre como usar o Qwen 3.8 gratuitamente.
O que os benchmarks mostram, incluindo as perdas
A Alibaba publicou uma tabela completa de benchmarks comparando o Qwen 3.8-Max com Claude Opus 4.8, Fable 5, GPT-5.6 Sol e Qwen3.7-Max. Duas ressalvas antes de qualquer número: estes são resultados executados pelo fornecedor, e a maioria das linhas de codificação foram executadas usando o framework Claude Code para todos os modelos. Vários benchmarks (QwenSWEBench, QwenQoderBench, CoWorkBench, RecreationBench) são criações internas da própria Alibaba. Não existiam números independentes de veículos como Artificial Analysis no momento da escrita.
Com essa contextualização, as linhas de destaque conforme a tabela da Alibaba:
Onde ele ganha:
- PaperBench: 93.0, seu melhor resultado carro-chefe, à frente do GPT-5.6 Sol (90.5), Fable 5 (88.8) e Opus 4.8 (80.3)
- IFBench: 82.8, a pontuação mais alta da linha, à frente dos 72.7 do Sol
- Terminal Bench 2.1: 86.6, superando Opus 4.8 e Fable 5 (ambos 84.6), ficando atrás apenas do Sol (88.8)
- Multimodal é seu ponto mais forte: MathVision 95.2, LogicVista 91.9, OSWorld-Verified 86.1 e linhas de OCR que superam quase tudo na tabela
Onde ele perde:
- SWE-bench Pro: 67.7, bem atrás dos 80.0 do Fable 5 e ligeiramente atrás dos 69.2 do Opus 4.8 (ele supera os 64.6 do Sol)
- HLE: 43.6, a pontuação mais fraca entre os carros-chefe na linha; Fable 5 registra 53.3, Sol 47.2 e Opus 4.8 45.7
O resumo honesto: de acordo com os próprios números da Alibaba, o Qwen 3.8-Max supera o Opus 4.8 em várias linhas de agentes, fica atrás do Fable 5 na maioria dos trabalhos de codificação essenciais e obtém grandes vitórias em inteligência multimodal e de documentos. No GPQA Diamond, ele atinge 92.6, empatado com o Fable 5 e logo atrás dos 94.1 do Sol, então o raciocínio científico bruto é competitivo. Para uma análise completa da tabela, incluindo os detalhes dos frameworks e o que procurar em verificações independentes, consulte nossa análise dos benchmarks do Qwen 3.8.
A Alibaba também publicou um conjunto de execuções de demonstração: uma sessão de codificação autônoma de 16 dias em um repositório público (265 commits, 127 pull requests), uma execução de reprodução de artigo que superou o resultado AIME24 do artigo original, e uma entrada em um concurso Tianchi que superou 458 de 526 equipes humanas em 24 horas. Estas são demonstrações do próprio fornecedor, então interprete-as como anúncios de capacidade, e não como avaliações controladas. A história da codificação, incluindo como reproduzir as configurações dos frameworks, recebe um tratamento dedicado em Qwen 3.8 para codificação.
Onde ele se posiciona em relação a Kimi K3, Fable 5 e GPT-5.6 Sol
Vs Kimi K3. Esta é a rivalidade natural: dois laboratórios chineses, dois modelos MoE gigantes de pesos abertos, lançados com semanas de diferença. O K3 é maior (2.8T total, 104B ativo vs 2.4T/95B), somente texto onde o Qwen é multimodal, e seus pesos já estão disponíveis enquanto os do Qwen ainda são uma promessa. A precificação também diverge acentuadamente: o K3 cobra $3 de entrada/$15 de saída com $0.30 por cache hits, contra os $2/$6 fixos do Qwen. Nenhuma avaliação direta ainda existe; cada fornecedor publicou sua própria tabela. Nós os comparamos linha a linha em Qwen 3.8 vs Kimi K3, e se você é novo no modelo da Moonshot, comece com o que é Kimi K3.
Vs Fable 5. O carro-chefe da Anthropic continua sendo o benchmark de codificação a ser superado, e o Qwen 3.8-Max não o supera: SWE-bench Pro (67.7 vs 80.0) e HLE (43.6 vs 53.3) são lacunas claras, conforme a própria tabela da Alibaba. O que o Qwen oferece em vez disso é preço (uma fração das taxas de fronteira), um contexto de 1M, pesos abertos a caminho e linhas multimodais mais fortes.
Vs GPT-5.6 Sol. O Sol leva o Terminal Bench (88.8 vs 86.6), GPQA (94.1 vs 92.6) e HLE (47.2 vs 43.6), enquanto o Qwen 3.8-Max vence no PaperBench (93.0 vs 90.5) e IFBench (82.8 vs 72.7). Em termos de preço, os $2/$6 do Qwen superam os $2/$12 do GPT-5.6 Terra na saída, e o acesso à camada Sol ainda custa mais.
Mais um ponto de referência: o Claude Opus 5 custa $5/$25. Independentemente do que você ache das tabelas dos fornecedores, a Alibaba está precificando seu carro-chefe em um nível que muda a matemática para cargas de trabalho de alto volume.
Precificação: $2/$6 fixos em 1M de tokens
A precificação é simples o suficiente para ser declarada em uma frase: $2 por milhão de tokens de entrada, $6 por milhão de tokens de saída, uma única camada fixa do token zero ao limite de contexto de 1M, com ou sem modo de raciocínio.
A camada fixa é a parte incomum. A maioria dos modelos de contexto longo aumenta os preços à medida que seu prompt cresce; o Qwen 3.8-Max não faz isso. Ele também é lançado mais barato do que o preço de tabela do Qwen3.7-Max de $2.5/$7.5, embora esse modelo mais antigo esteja atualmente com uma promoção de 50% ($1.25/$3.75), o que o mantém relevante como uma opção de valor.
O cache de contexto otimiza cargas de trabalho com prefixos repetidos: os acertos de cache são cobrados a 10% da taxa de entrada, e a criação explícita de cache custa 125%. Há também uma cota gratuita (1M de tokens, apenas na região de Cingapura, válida por 90 dias) para testar. A discriminação completa dos custos, com exemplos por tarefa e a quantificação do 'detalhe' dos tokens de raciocínio, está em nosso guia de preços do Qwen 3.8.
Como acessar o Qwen 3.8-Max
A matriz de acesso é mais ampla do que um lançamento típico. Cinco rotas:
1. Qwen Chat. O aplicativo para consumidor, sem necessidade de chave API. A maneira mais rápida de formar uma opinião.
2. A API no Alibaba Cloud Model Studio (DashScope). Obtenha uma chave em home.qwencloud.com, defina DASHSCOPE_API_KEY e chame o ID do modelo qwen3.8-max através dos endpoints de chat-completions ou responses compatíveis com OpenAI. Três URLs base regionais estão ativas: Pequim (dashscope.aliyuncs.com/compatible-mode/v1), Cingapura (dashscope-intl.aliyuncs.com/compatible-mode/v1) e EUA-Virgínia (dashscope-us.aliyuncs.com/compatible-mode/v1). A página de modelos do Model Studio o lista no topo da pilha recomendada.
3. O endpoint compatível com Anthropic. Este é o realmente incomum: https://dashscope-intl.aliyuncs.com/apps/anthropic fala o protocolo Anthropic Messages, então ferramentas construídas para Claude podem apontar para Qwen com duas variáveis de ambiente.
4. Frameworks de codificação. A Alibaba publicou configurações oficiais para cinco agentes: Claude Code (via ANTHROPIC_BASE_URL mais ANTHROPIC_MODEL=qwen3.8-max), Codex, Qoder, Qwen Code e OpenClaw. Vale a pena notar que a Alibaba executou a maioria de seus benchmarks de codificação dentro do framework Claude Code, então a configuração que publicou é também a configuração por trás de seus próprios números.
5. Pesos abertos, em breve. Hugging Face e ModelScope, prometidos para a próxima semana, ainda não disponíveis para download no início de agosto de 2026.
Os detalhes de configuração para as rotas 2 a 4, com Python e cURL prontos para copiar e colar, estão em nosso guia da API Qwen 3.8.
Testando a API de protocolo duplo
O mesmo modelo respondendo em duas formas de protocolo diferentes cria uma questão prática de teste: sua requisição se comporta de forma idêntica em ambos? É aqui que um cliente API se mostra útil. No Apidog, você pode salvar as três URLs base regionais como ambientes e alternar regiões sem editar requisições, enviar o mesmo prompt através do endpoint compatível com OpenAI e do endpoint de protocolo Anthropic lado a lado, e inspecionar o fluxo SSE para observar os deltas de reasoning_content chegarem antes da resposta final. Essa última parte é útil para verificar o quanto de raciocínio o padrão xhigh realmente gera, já que esses tokens afetam sua conta como saída. Baixe o Apidog gratuitamente se quiser acompanhar ao configurar os endpoints; o mesmo espaço de trabalho também facilita a comparação A/B de qwen3.8-max contra qwen3.7-max ou kimi-k3 em prompts idênticos antes de se comprometer com uma carga de trabalho.
Onde o Qwen 3.8-Max se encaixa na linha
Se você está mapeando a família mais ampla, o Qwen 3.8-Max agora se posiciona acima do Qwen3.7-Max e dos modelos de camada plus, e nosso guia para os melhores modelos Qwen aborda qual camada se encaixa em qual carga de trabalho. A versão curta: o 3.8-Max é a escolha quando você precisa do teto multimodal e de agentes, o 3.7-Max com 50% de desconto é o carro-chefe de valor enquanto a promoção durar, e os modelos plus continuam sendo os cavalos de batalha baratos para tarefas rotineiras.
FAQ
O Qwen 3.8 é de código aberto?
Ainda não, mas está próximo. A Alibaba prometeu os pesos para Hugging Face e ModelScope 'na próxima semana', a partir do lançamento no início de agosto de 2026, o que o tornaria o primeiro Qwen de classe Max com pesos abertos. Nada está disponível para download no momento da escrita. Até então, o acesso é feito via API ou Qwen Chat; veja como usar o Qwen 3.8 gratuitamente para as rotas sem custo.
Quanto custa o Qwen 3.8-Max?
$2 por milhão de tokens de entrada e $6 por milhão de tokens de saída, em uma única camada fixa em todo o contexto de 1M. Os acertos de cache são cobrados a 10% da entrada. Os tokens de raciocínio são cobrados como saída, e o esforço de raciocínio padrão é xhigh, então orce acima da taxa de tabela para trabalhos que exigem muito raciocínio.
O Qwen 3.8-Max é melhor que o Kimi K3?
Ainda não há uma avaliação direta; ambos os fornecedores publicaram suas próprias tabelas. No papel, o Qwen 3.8-Max é menor (2.4T/95B ativo vs 2.8T/104B), multimodal onde o K3 é apenas texto, e mais barato na saída ($6 vs $15). A vantagem do K3 hoje é que seus pesos já são públicos.
Posso usar o Qwen 3.8-Max no Claude Code?
Sim. A Alibaba publicou uma configuração oficial: aponte ANTHROPIC_BASE_URL para o endpoint DashScope compatível com Anthropic e defina ANTHROPIC_MODEL=qwen3.8-max. Codex, Qoder, Qwen Code e OpenClaw também possuem configurações oficiais.
O que fazer a seguir
O Qwen 3.8-Max é um lançamento de carro-chefe real, não uma prévia para a imprensa: GA em três regiões de API, preços publicados, uma tabela completa de benchmarks (executada pelo fornecedor) com vitórias e perdas, e pesos abertos a poucos dias. A leitura honesta é que ele não destrona o Fable 5 na codificação essencial, mas supera o Opus 4.8 em várias linhas de agentes, lidera em trabalho com documentos e multimodal, e custa $2/$6 ao fazê-lo.
O movimento sensato é testá-lo contra sua própria carga de trabalho, em vez de confiar na tabela de qualquer um. Obtenha a cota gratuita, conecte ambos os endpoints de protocolo e compare as saídas em prompts que você realmente usa. Comece com o guia de configuração da API, e verifique por volta de 10 de agosto para ver se os pesos foram lançados conforme o previsto.