
O Open Responses é uma especificação aberta, publicada como um documento OpenAPI 3.1, que descreve um único formato de requisição e resposta para chamar modelos de linguagem entre provedores. Ele é baseado na OpenAI Responses API: você envia model, input e tools opcionais para POST /v1/responses, e recebe de volta itens tipados e eventos de streaming semânticos em vez de um formato específico de provedor. A OpenAI lançou o Open Responses em 2026-01-15, ele é licenciado sob Apache 2.0, e em 2026-10-22 a OpenAI o contribuiu para a Agentic AI Foundation (AAIF), o órgão da Linux Foundation que também hospeda o MCP.
Esse último passo é a notícia: a especificação agora tem um estatuto técnico, um comitê diretivo e um lar neutro. Este post cobre o que ela define, quem a implementa, o que a mudança para a AAIF altera e como verificar se um endpoint do qual você depende está em conformidade. Se você é novo na API subjacente, comece com como usar a OpenAI Responses API.
O que o Open Responses define
A especificação descreve o problema de forma clara: os provedores convergiram para os mesmos blocos de construção (mensagens, chamadas de ferramentas, streaming, entrada multimodal), mas cada um os codifica de forma diferente. O Open Responses escolhe uma codificação e a documenta.
O documento OpenAPI atual está na versão 2026-04-24 e cobre uma superfície pequena:
| Operação | O que faz |
|---|---|
POST /responses (createResponse) |
Cria uma resposta, com ou sem streaming |
WebSocket em /responses |
O mesmo modelo de resposta sobre um socket persistente (adicionado em 2026-04-24) |
POST /responses/compact (compactResponse) |
Retorna uma janela de entrada compactada para conversas longas |
O corpo da requisição aceita os campos que você esperaria se já usou a API da OpenAI: model, input, instructions, tools, tool_choice, stream, store, previous_response_id, reasoning, text, truncation, temperature, top_p, max_output_tokens, prompt_cache_key e mais alguns. O objeto de resposta (ResponseResource) carrega id, status, output, usage, error e um eco das configurações que você enviou. O documento define 108 schemas no total, a maioria deles tipos de item e de evento de streaming.
Três ideias sustentam o design.
Itens são a unidade de contexto
Tudo o que o modelo lê ou produz é um item: uma message, um function_call, um function_call_output, um item de reasoning. Os itens são bidirecionais, então a saída de um turno pode ser realimentada diretamente como entrada do próximo. Cada tipo de item é discriminado pelo seu campo type e tem seu próprio schema.
Os itens também são máquinas de estado: cada um passa de in_progress para completed ou incomplete (o orçamento de tokens acabou), e um item incomplete deve ser o último emitido, com a resposta inteira marcada como incompleta. Um status não diz nada sobre se o servidor armazenou o item; a persistência é uma preocupação separada.
Streaming são eventos semânticos, não deltas brutos
Quando você define stream: true, o servidor deve responder com Content-Type: text/event-stream e uma sequência de eventos definida. Um item de saída abre com response.output_item.added; o texto dentro dele chega como response.content_part.added, depois eventos repetidos response.output_text.delta, então response.output_text.done e response.content_part.done; o item fecha com response.output_item.done. O stream deve terminar com um evento terminal: response.completed, response.failed ou response.incomplete. Um [DONE] ao final é opcional, e os clientes devem lidar com um stream que termina sem ele.
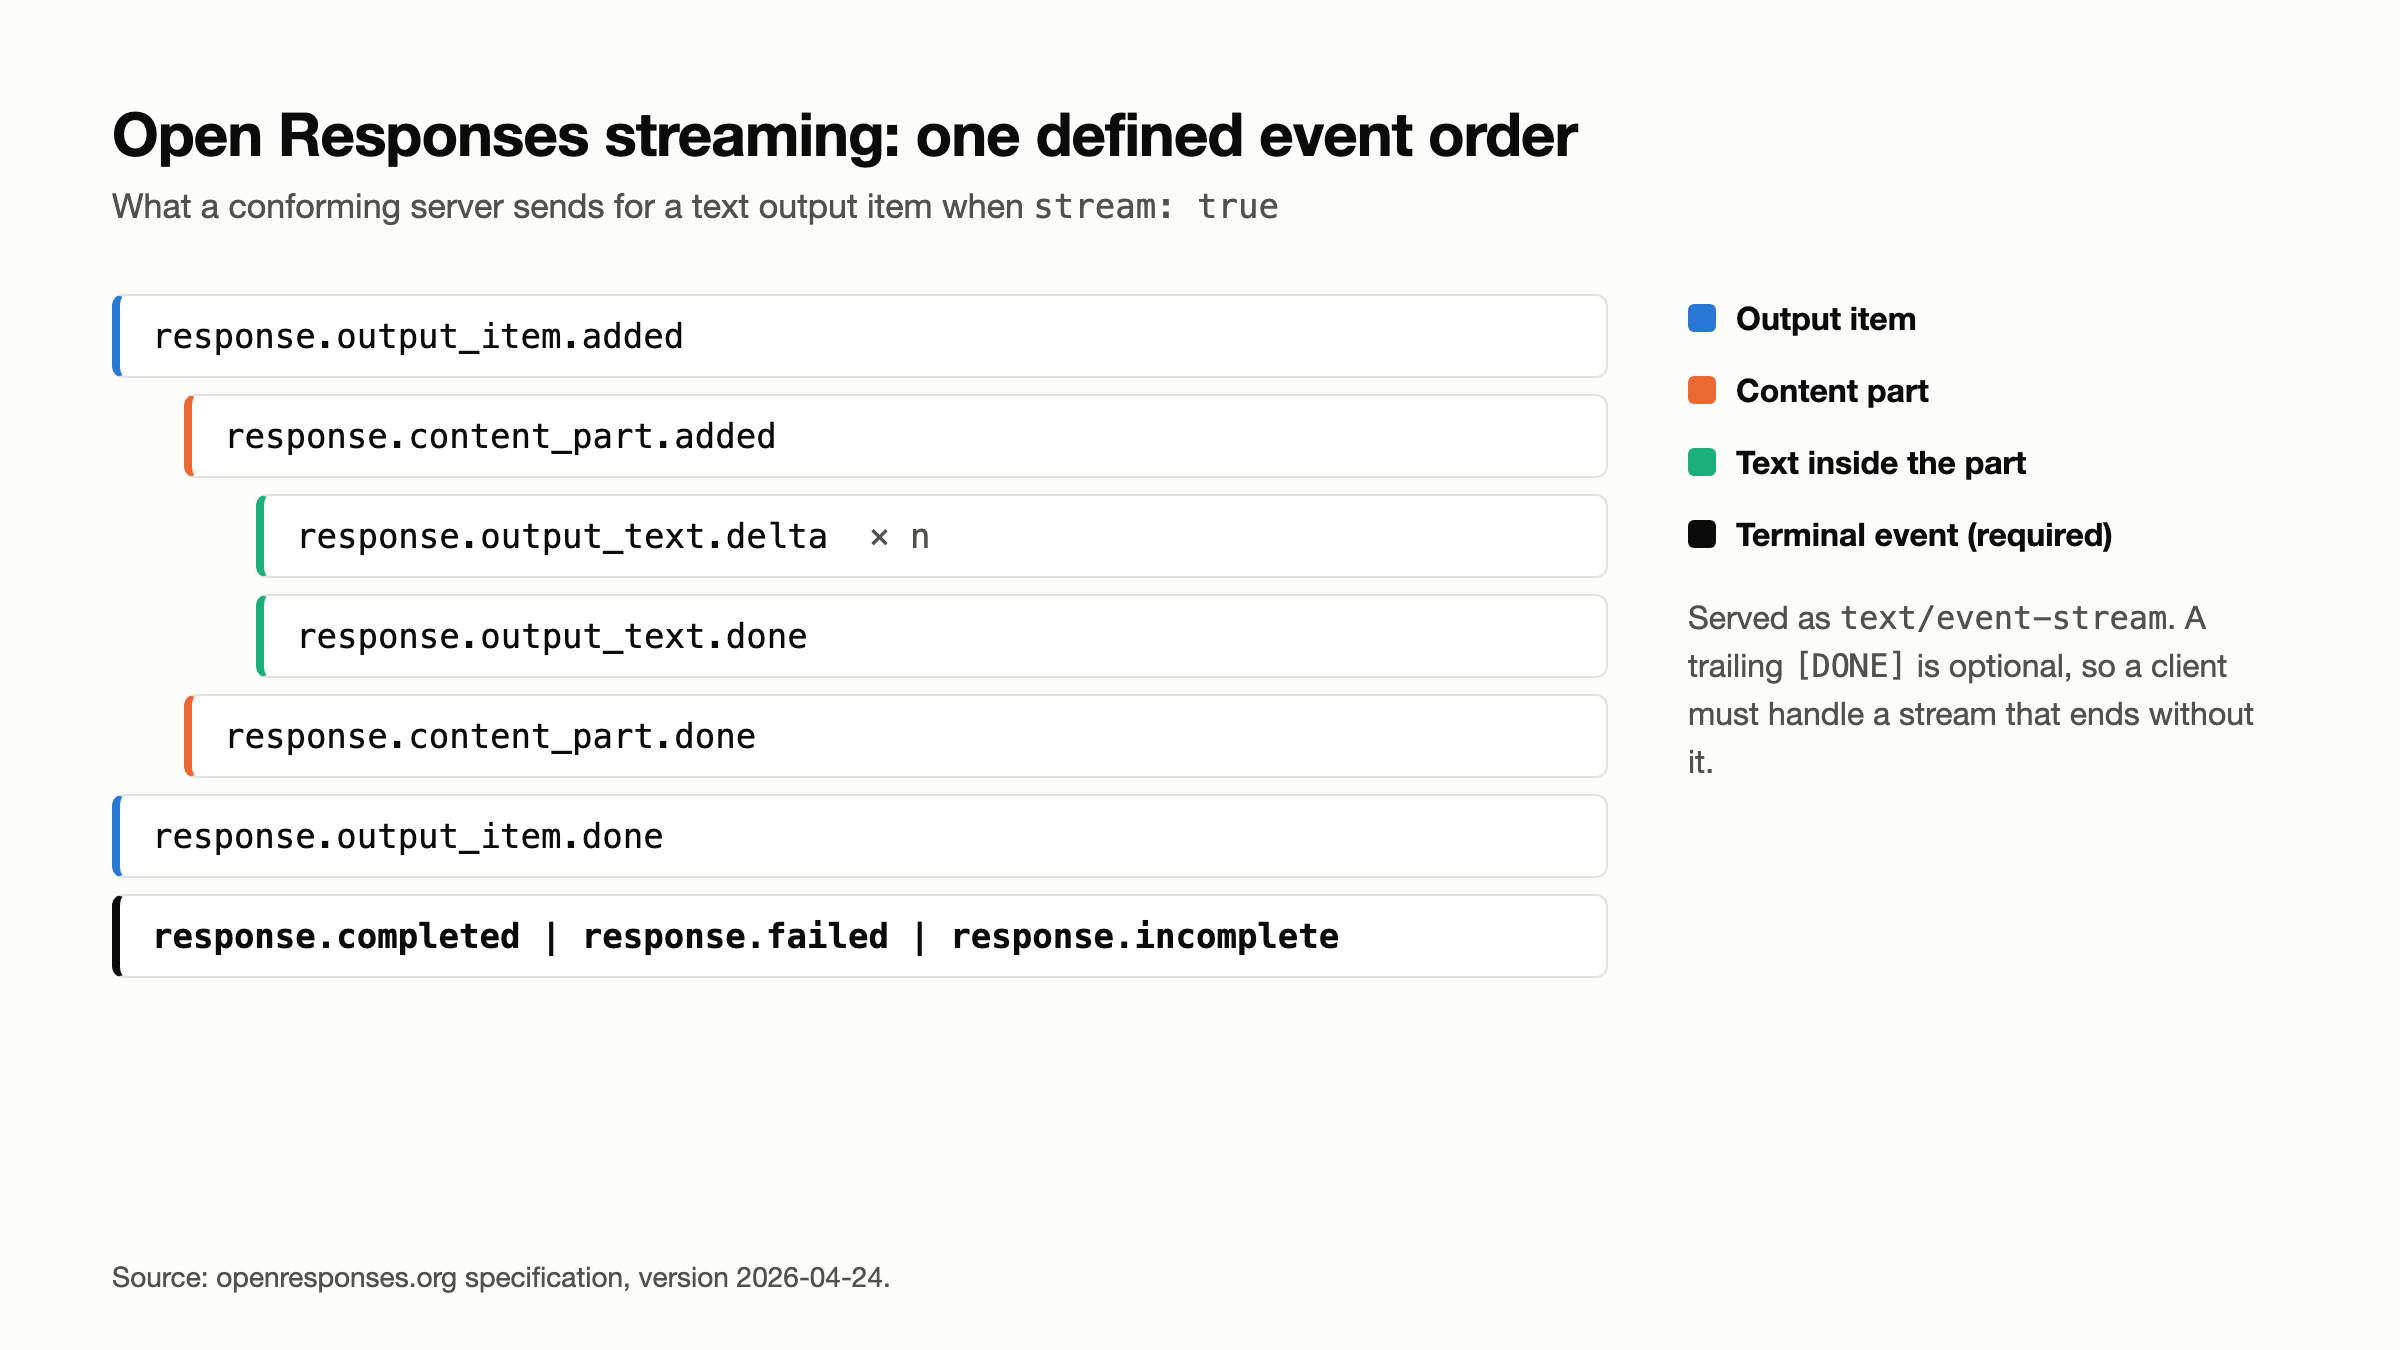
Isso importa principalmente para o código do cliente: se dois provedores emitem os mesmos eventos na mesma ordem, um único parser SSE funciona para ambos. Nosso guia de testes de SSE mostra como inspecionar esses streams evento por evento.
Um núcleo estável com extensões com namespace
Os provedores podem adicionar seus próprios tipos de item, ferramentas e eventos de streaming, mas devem prefixá-los com um slug do provedor. O próprio exemplo da especificação é openai:web_search_call. Um cliente que não reconhece um tipo prefixado pode ignorá-lo sem quebrar. É assim que a especificação permanece portátil enquanto ferramentas hospedadas, como busca na web ou busca em arquivos, continuam sendo recursos do provedor.
O restante do contrato
Mais algumas regras vale a pena conhecer antes de construir sobre a especificação:
- Dois tipos de ferramentas. Ferramentas hospedadas externamente (funções, servidores MCP) são executadas fora do provedor; para funções, o modelo emite um
function_call, você o executa e envia de volta umfunction_call_outputcom ocall_idcorrespondente. Ferramentas hospedadas internamente (a busca em arquivos da OpenAI, por exemplo) são executadas dentro do provedor sem devolver o controle. tool_choiceeallowed_tools.tool_choiceaceitaauto(o padrão),required,noneou um objeto que nomeia uma função.allowed_toolsrestringe quais ferramentas o modelo pode chamar enquanto ainda mostra todas elas, para que você não invalide um prompt em cache ao editar o arraytools. Os servidores devem aplicá-lo como um limite rígido.previous_response_id. O servidor deve tratar a nova requisição comoprevious_response.input + previous_response.output + input, nessa ordem, para que você não reenvie o histórico.- Itens de raciocínio podem carregar
contentbruto, um blob opacoencrypted_content, umsummaryseguro para o usuário ou qualquer combinação. - Erros carregam um
type(server_error,invalid_request,not_found,model_error,too_many_requests), além decode,paramemessage; no meio do stream, um erro é seguido porresponse.failed.
A revisão de 2026-04-24 (changelog) adicionou o transporte WebSocket: cada turno começa com uma mensagem response.create, uma conexão processa uma resposta por vez, as conexões têm limite de 60 minutos (código de erro websocket_connection_limit_reached), e continuações com store: false vivem na memória local da conexão, falhando com previous_response_not_found quando esse estado se perde. A mesma revisão adicionou /responses/compact, um campo opcional phase nas mensagens do assistente (commentary ou final_answer) e tornou logprobs opcional.
Open Responses vs Chat Completions
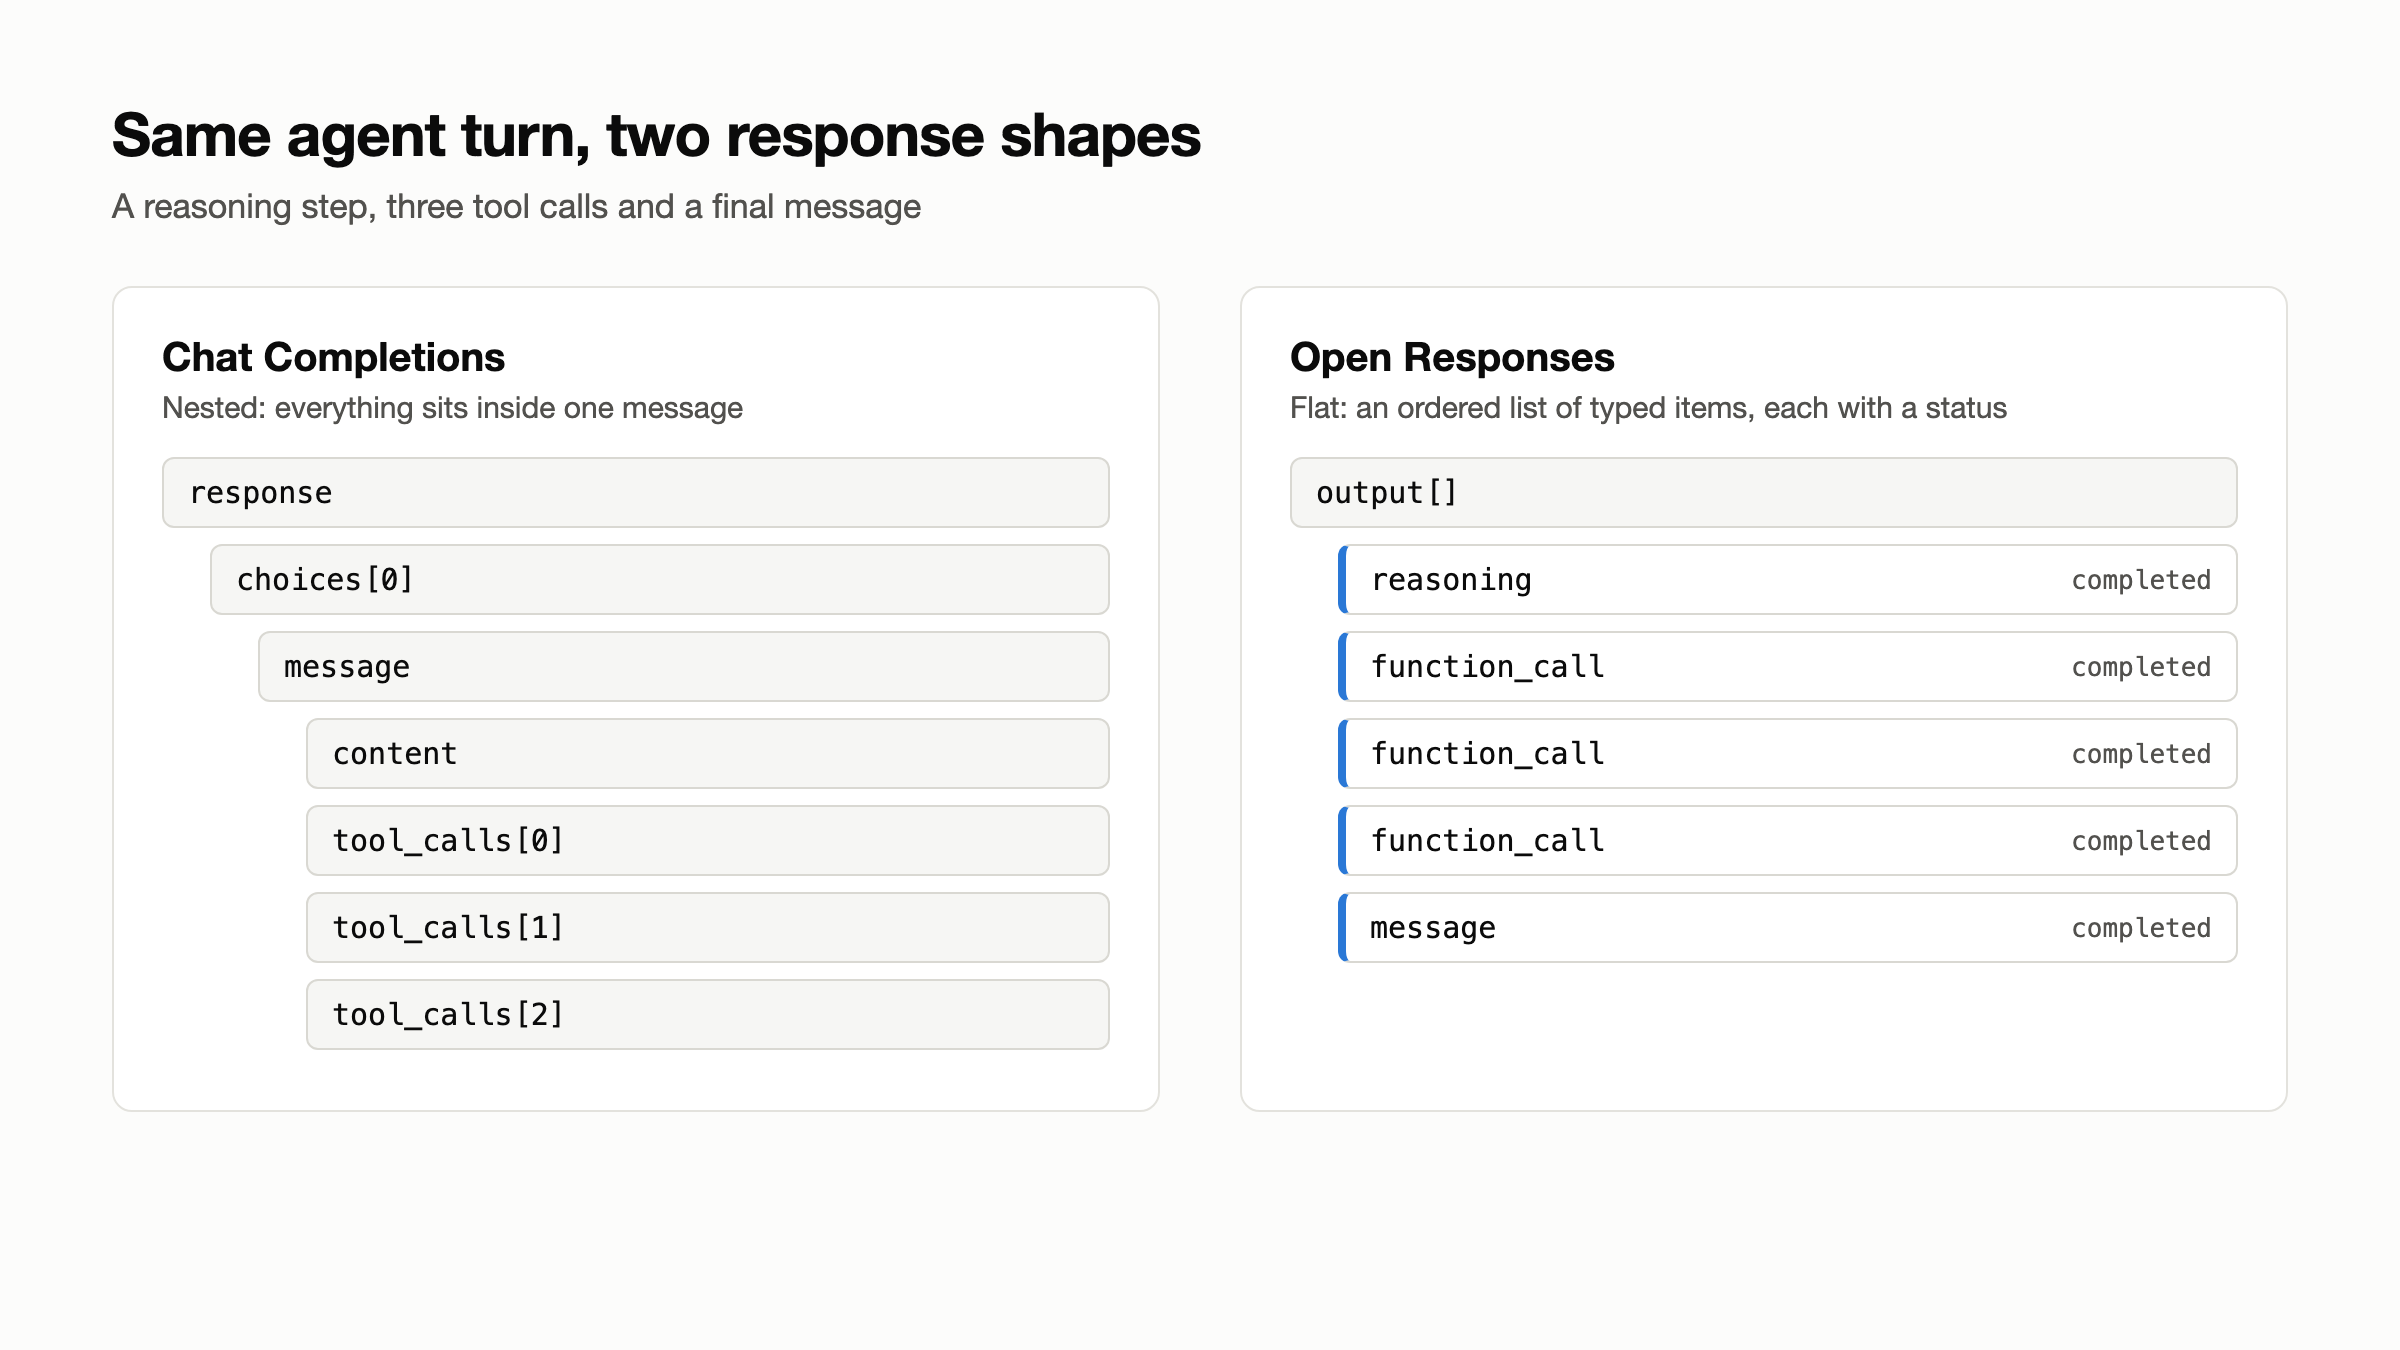
O Chat Completions ainda é a interface de LLM mais amplamente copiada. A diferença está na forma: o Chat Completions retorna choices contendo uma mensagem, com as chamadas de ferramentas embutidas nela, enquanto o modelo Responses retorna uma lista plana de itens tipados. Um passo de raciocínio, três chamadas de ferramentas e uma mensagem final se tornam objetos separados e ordenados, com status próprio, o que se adapta melhor a loops de agentes.
Comparamos os três formatos dominantes lado a lado, com requisições reais, em Chat Completions vs Anthropic Messages vs Responses API. Se você está escolhendo entre as próprias superfícies da OpenAI, o comparativo Agents API vs Responses API vs Agents SDK cobre onde o Responses se encaixa.
Quem implementa
A lista de apoiadores inclui AWS Bedrock, Databricks, Hugging Face, LM Studio, Nvidia, Ollama, OpenRouter, Red Hat, Vercel e vLLM, ao lado da OpenAI. Anthropic e Google não estão entre os apoiadores nomeados; ambos ainda oferecem seus próprios formatos nativos.
“Suporta” cobre uma ampla variedade, então verifique os detalhes do runtime que você usa:
- Ollama adicionou
POST /v1/responsesna v0.13.3. Sua documentação de compatibilidade diz que “apenas a variante sem estado é suportada”: streaming, ferramentas de função e resumos de raciocínio funcionam, masprevious_response_id,conversationetruncationnão. Você reenvia o histórico por conta própria. - LM Studio tornou seu endpoint
http://localhost:1234/v1/responsescompatível na versão 0.3.39, incluindoprevious_response_id, URLs de imagens remotas para modelos de visão e logprobs. Veja nosso guia do LM Studio para configuração.
Para dar uma ideia de escala, o API Evangelist fez um levantamento de base em 13 de setembro: de 120 provedores que alegam compatibilidade com a OpenAI e publicam um documento OpenAPI legível, 26 declaram POST /responses, contra 105 que declaram POST /chat/completions. O objetivo do levantamento é medir se a governança neutra move esse número.
O que a mudança para a Agentic AI Foundation altera
A AAIF anunciou o Open Responses em 2026-10-22 na AGNTCon + MCPCon North America em San Jose, junto com três outros novos projetos: Agent Skills (da Anthropic), OpenEnv (da Hugging Face) e OpenSandbox (da Alibaba). Isso leva a AAIF a 10 projetos hospedados em seu primeiro ano, ao lado de MCP, do protocolo Agent2Agent, do AGENTS.md, do goose, do agentgateway e do Agent Router. Se você está tentando entender como tudo isso se encaixa, nosso explicador MCP vs A2A é um bom começo.
O que muda:
- Governança. O projeto agora é “Open Responses a Series of LF Projects, LLC”, com um estatuto técnico adotado em 2026-10-21. Um Comitê Diretivo Técnico, inicialmente os mantenedores do projeto, é responsável pelas decisões técnicas, e a participação é aberta a qualquer pessoa que siga o estatuto.
- Credibilidade para outros fornecedores. Uma especificação de propriedade de uma empresa é um produto. Uma especificação sob uma fundação é mais fácil para um concorrente adotar sem parecer que está seguindo um rival.
O que não muda:
- A própria API da OpenAI. A Responses API em
api.openai.commantém seus próprios recursos e cronograma de lançamento. O Open Responses descreve o núcleo portátil; ferramentas específicas da OpenAI permanecem atrás do prefixoopenai:. - O formato de transmissão. Nenhuma nova versão da especificação veio com a mudança. O lançamento mais recente ainda é
2026-04-24, e lançamentos datados são imutáveis. - Conformidade. Estar na lista de apoiadores não significa que um endpoint passa nos testes. Ninguém publica um índice de aprovação/reprovação ainda, então você mesmo verifica os endpoints dos quais depende.
Verifique um endpoint com os testes de aceitação
O projeto traz seus próprios testes de aceitação. A página de conformidade executa 10 testes no navegador contra qualquer URL base, modelo e chave: resposta de texto básica, streaming, prompt de sistema, chamada de ferramentas, entrada de imagem, histórico de múltiplos turnos, rótulos de phase do assistente, o endpoint de compactação e um teste negativo para uma requisição de compactação sem model. Mais sete testes de WebSocket (turnos sequenciais, continuação com store: false, recuperação de reconexão, despejo de cache após uma continuação falha) são executados apenas pela CLI:
git clone https://github.com/openresponses/openresponses
cd openresponses && bun install
bun run test:compliance --base-url http://localhost:11434/v1 --api-key ollama
Cada requisição HTTP e cada turno de WebSocket tem um prazo de 30 segundos, e um timeout reprova apenas aquele teste. Espere que um runtime sem estado, como o Ollama, falhe nos testes de continuação por design.
Deixe seu agente de código testá-lo com o Apidog CLI
Os testes de aceitação dizem se um servidor segue a especificação hoje. Eles não monitoram o endpoint que seu app chama a cada deploy, atualização do Ollama ou troca de provedor. Para isso, importe a especificação em um projeto Apidog e deixe seu agente de código escrever e executar testes de regressão contra ela com o Apidog CLI.
Instale a CLI e a skill do agente uma vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois dê ao Claude Code, Codex ou Cursor um prompt:
Download https://www.openresponses.org/openapi/openapi.json and import it into
Apidog project <id>. Create an environment "local-ollama" with base URL
http://localhost:11434/v1. Add test cases for POST /responses: one that expects 200,
status "completed" and an output item of type "message"; one with stream: true that
expects text/event-stream ending in response.completed; one without "model" that
expects a 4xx error with an error.type field. Run them and summarize any failures.
O agente lê os schemas, valida seus payloads antes de escrever qualquer coisa e executa os casos:
curl -sLO https://www.openresponses.org/openapi/openapi.json
apidog import --project <id> --format openapi --file ./openapi.json
apidog environment create local-ollama --project <id> --base-url http://localhost:11434/v1
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
A entrada servers da especificação aponta para https://api.openai.com/v1, então adicione um ambiente por provedor e execute os mesmos casos contra cada um: essa é a promessa de portabilidade, testada. Coloque a linha apidog run ... -r junit no seu pipeline para que uma atualização de runtime que remova um campo quebre o build (guia de CI/CD); Apidog CLI no Claude Code cobre a configuração do agente em detalhes.
FAQ
O Open Responses é o mesmo que a OpenAI Responses API? Não. O Open Responses é uma especificação derivada dela. A Responses API da OpenAI é uma implementação com recursos extras exclusivos da OpenAI; Ollama, LM Studio e vLLM são outras.
Quem é o dono do Open Responses agora? Desde 2026-10-22, é um projeto da Agentic AI Foundation sob a Linux Foundation, operado como uma série da LF Projects com um Comitê Diretivo Técnico. É licenciado sob Apache 2.0.
A Anthropic suporta o Open Responses? A Anthropic não está entre os apoiadores nomeados. Ela contribuiu com o Agent Skills para a AAIF no mesmo dia, mas a interface nativa do Claude ainda é a Messages API.
Onde está o arquivo da especificação? Em https://www.openresponses.org/openapi/openapi.json, com lançamentos datados no repositório do GitHub.
Próximo passo
Escolha o endpoint que seu produto mais chama, execute os testes de aceitação do navegador contra ele e importe a especificação no Apidog para que seu agente possa manter essas verificações rodando a cada deploy. Baixe o Apidog para começar.