
Jev é um novo tipo de modelo da TypeSafe AI. Ele não escreve texto. Você entrega a ele um pedaço do estado do programa, declara as perguntas que precisa que sejam respondidas, e ele retorna respostas tipadas com probabilidades calibradas: uma probabilidade de sim/não, uma escolha de uma lista, ou uma pontuação em uma rubrica. A TypeSafe o chama de “Modelo de Sistema Um”, e a proposta é simples: a maioria das chamadas de IA dentro do software não está pedindo prosa, está pedindo uma decisão. Se você conectou um LLM a um classificador e depois escreveu um analisador para extrair um rótulo de sua resposta, o Jev foi construído exatamente para esse trabalho, da mesma forma que as saídas estruturadas foram um primeiro passo nessa direção.
Ele foi lançado no Vercel AI Gateway em 16 de setembro de 2026, o que o colocou na frente da maioria dos desenvolvedores. Este guia abrange o que é o Jev, como ele difere de um modelo de linguagem, os três tipos de perguntas, como chamá-lo diretamente e através do Gateway, e como testá-lo e simulá-lo no Apidog antes que ele afete sua lógica de roteamento.
O que é o Jev
A publicação de lançamento da TypeSafe descreve o Jev como “uma chamada de função de inteligência de fronteira: estado não estruturado de entrada, decisões probabilísticas tipadas de saída.” Três propriedades o definem.
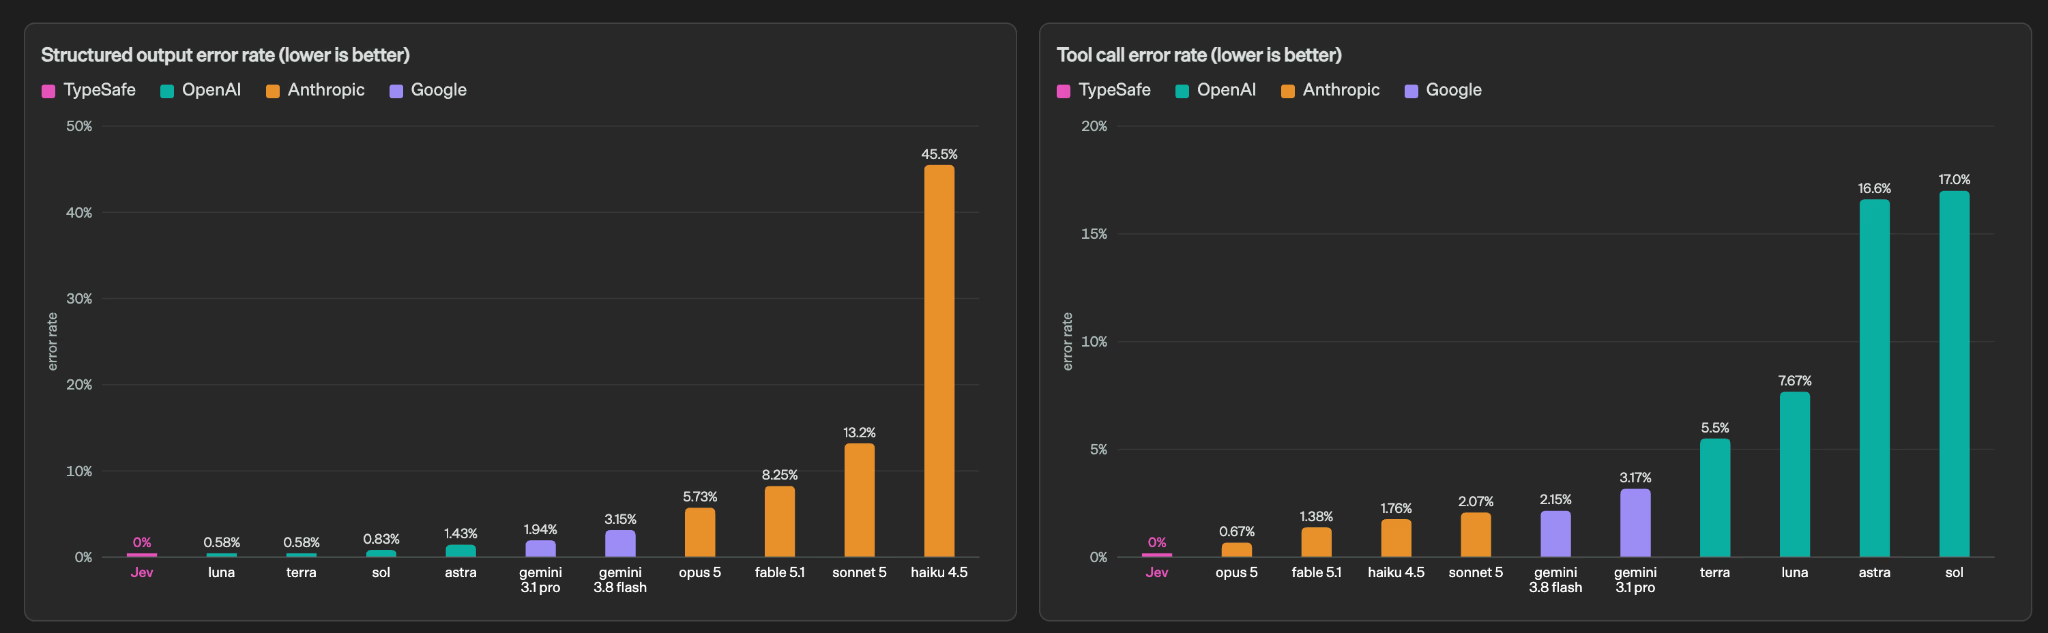
A saída é tipada e declarada antes da chamada. Você define a forma de cada pergunta antecipadamente. O modelo só pode responder dentro dessa forma, então não há nada para analisar e nenhuma incompatibilidade de esquema para pegar. A palavra da TypeSafe para isso é que o Jev “nunca comete erros de tipo.”
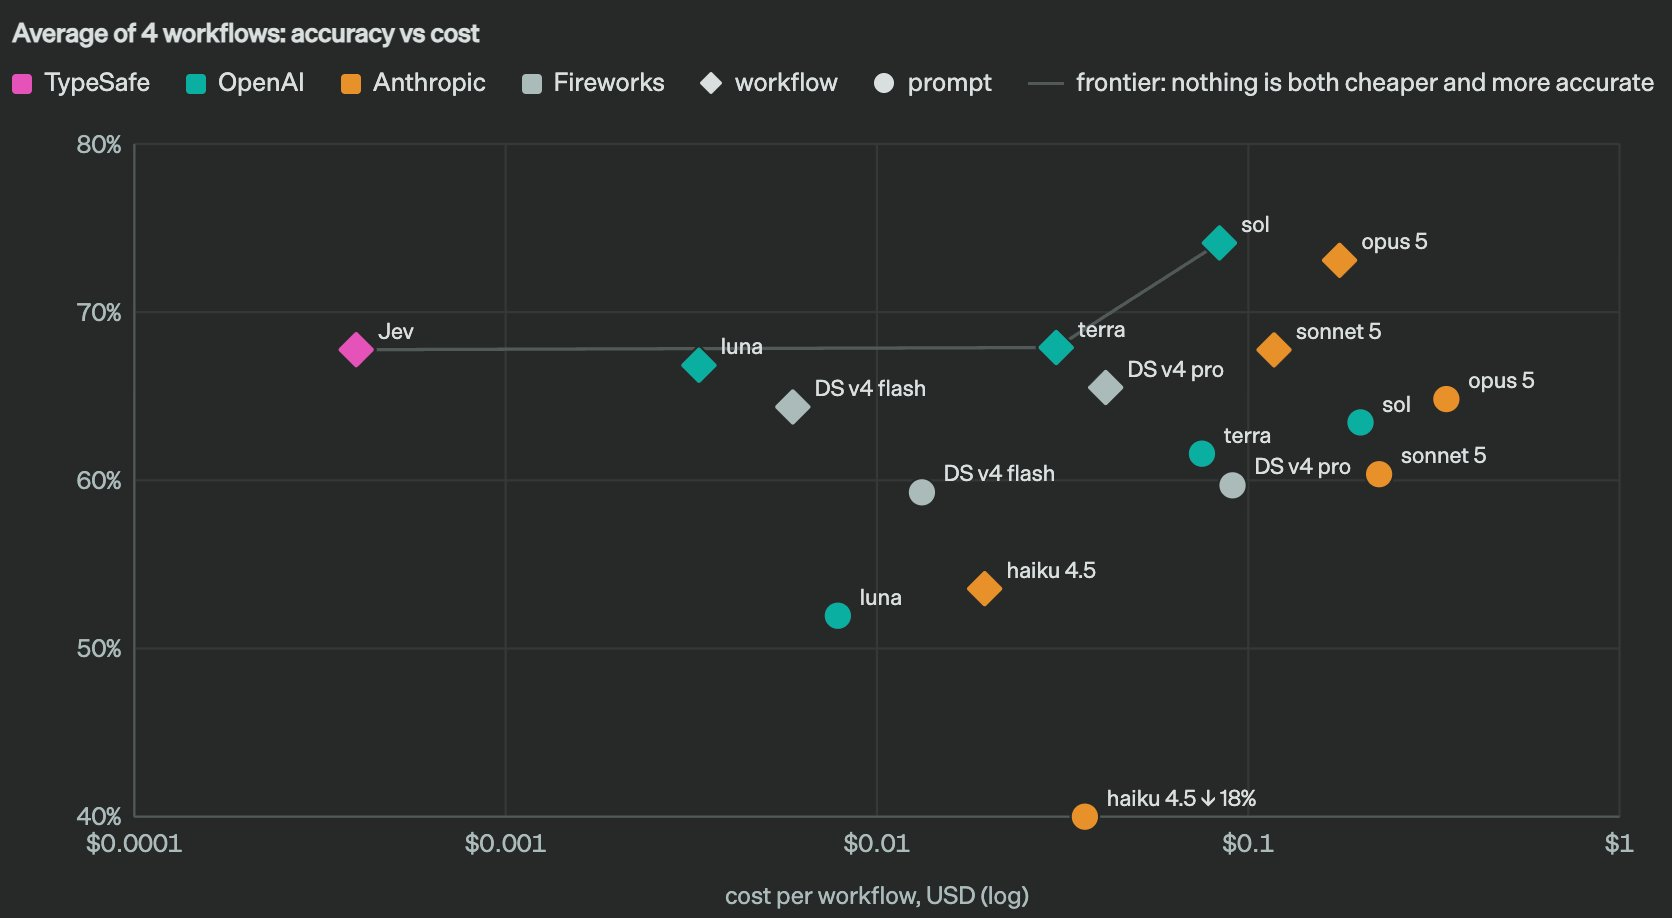
Cada resposta carrega uma probabilidade. Uma pergunta de sim/não não retorna true; ela retorna um número como 0.97. Uma escolha retorna a distribuição completa entre as opções. A TypeSafe treinou o modelo com um método que chama de Aprendizado por Reforço para Decisões Calibradas, e a alegação é que maior confiança significa maior precisão, então você pode definir um limiar: automatizar os casos claros, encaminhar os incertos para um humano.
As perguntas são respondidas em paralelo, em uma única requisição. Um modelo de linguagem produz um token por vez. O Jev avalia cada pergunta declarada de uma vez contra o mesmo estado, e é por isso que a TypeSafe cita tempos de resposta de ponta a ponta de 70ms a 500ms. Esses são os próprios números do fornecedor; trate-os como uma afirmação a ser verificada contra sua carga de trabalho, não como um benchmark.
Como o Jev difere de um modelo de linguagem
| Modelo de Linguagem | Jev | |
|---|---|---|
| Saída | Texto livre que você analisa | Valores tipados que você declarou |
| Amostragem | Sequencial, token por token | Todas as perguntas em paralelo |
| Confiança | Não exposto por padrão | Uma probabilidade em cada resposta |
| Melhor em | Escrita, chat, sumarização | Decidir, rotear, pontuar, verificar |
| Entrada | Mensagens | Estado estruturado: uma string, objeto ou array |
| Imagens | Frequentemente suportado | Somente texto, por enquanto |
A compensação é explícita: o Jev abandona completamente a geração de strings. Não é um modelo de chat e não resumirá um documento. Onde ele se encaixa é na “instrução if inteligente” dentro de uma aplicação: qual equipe lida com este ticket, qual a gravidade deste bug, esta resposta é segura para enviar, a compilação foi bem-sucedida.
Os três tipos de perguntas
A API direta do Jev expõe três primitivos. Cada um é um objeto JSON sob uma chave que você escolhe.
Noul: uma probabilidade de sim/não. O nome da TypeSafe para o tipo booleano. Ele retorna a probabilidade de a resposta ser sim, e você define o limiar em código.
{ "is_urgent": { "type": "noul", "instructions": "Does this message express urgency?" } }
Response: { "type": "noul", "noul": 0.99 }.
Choice: escolha uma opção de um conjunto nomeado. criteria mapeia nomes de opções para descrições, até 255 opções. A resposta carrega a escolha principal mais a distribuição completa e um valor de confiança.
{ "department": { "type": "choice", "instructions": "Which team should handle this?",
  "criteria": { "billing": "Charges, invoices, payment problems",
                "shipping": "Delivery status, delays, lost packages",
                "returns":  "Exchanges, refunds, damaged items" } } }
Response: { "type": "choice", "choice": "returns", "confidence": 1.0, "probabilities": { "returns": 1.0, "shipping": 0.0, "billing": 0.0 } }.
Score: uma posição em uma escala ordenada. criteria é um array de 2 a 10 descrições de nível, do mais baixo primeiro. A pontuação é a posição ponderada pela probabilidade, então pode cair entre os degraus.
{ "bug_severity": { "type": "score", "instructions": "How severe is the reported issue?",
  "criteria": [ "Cosmetic; no impact to functionality",
                "Broken feature, but a workaround exists",
                "Blocking issue; no workaround" ] } }
Response: { "type": "score", "score": 1.3, "confidence": 0.54, "probabilities": { "0": 0.0, "1": 0.7, "2": 0.3 }, "legend": { "0": "Cosmetic...", "1": "Broken...", "2": "Blocking..." } }.
Uma pequena diferença de nomenclatura: através do Vercel AI SDK, o tipo sim/não é chamado de boolean e o campo de resposta é probability. Contra a própria API da TypeSafe, é noul. Mesma ideia, chave diferente.
Duas maneiras de chamar o Jev
Diretamente. Obtenha uma chave em console.typesafe.ai/settings/keys, então envie POST https://api.typesafe.ai/v1/systemone com um token Bearer. O ID do modelo é jev-latest, que atualmente se resolve para jev-1.13.0; jev-preview aponta para a construção mais recente, oficial ou não. SDKs Python e JavaScript existem, conforme o guia de início rápido, mas o endpoint bruto é um único POST, que é o formato que usaremos no Apidog.
Através do Vercel AI Gateway. O ID do modelo é typesafe-ai/jev e você o chama com experimental_evaluate do AI SDK (versão 7 ou posterior). Uma ressalva dos documentos de avaliação: a avaliação está disponível apenas através do AI SDK, não através dos endpoints compatíveis com OpenAI ou Anthropic do Gateway. Se você já roteia modelos através do Gateway, como em nosso tutorial GPT-5.6 Sol no AI Gateway, este é o caminho natural; nosso guia do Vercel AI SDK abrange a configuração.
import { experimental_evaluate as evaluate } from 'ai';

const result = await evaluate({
  model: 'typesafe-ai/jev',
  state: 'The support agent issued a full refund to the customer.',
  questions: { refunded: { type: 'boolean', instructions: 'Was a refund issued?' } },
});
// result.answers.refunded -> { type: 'boolean', probability: 0.99 }
Sua primeira requisição com curl
Isso prioriza uma mensagem de suporte com todos os três tipos em uma única chamada:
export TYPESAFE_API_KEY="..."

curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "My card was charged twice for one order and I need this fixed today.",
    "questions": {
      "department": { "type": "choice", "instructions": "Which team handles this?",
        "criteria": { "billing": "charges and refunds", "shipping": "delivery", "technical": "bugs" } },
      "urgency": { "type": "score", "instructions": "How urgent is this?",
        "criteria": ["low", "medium", "high"] },
      "wants_refund": { "type": "noul", "instructions": "Is the customer asking for money back?" }
    }
  }'
A resposta possui model, um objeto answers indexado pelos IDs de suas perguntas, e usage com input_tokens e output_tokens. Leia answers.department.choice, answers.urgency.score, e answers.wants_refund.noul, então aplique seus limiares.
Teste e simule o Jev no Apidog
Um modelo que retorna probabilidades muda a aparência de um teste. Você não está mais afirmando uma string; você está afirmando que um número cruza uma linha. O Apidog transforma isso em uma verificação salva e repetível, em vez de um curl único.
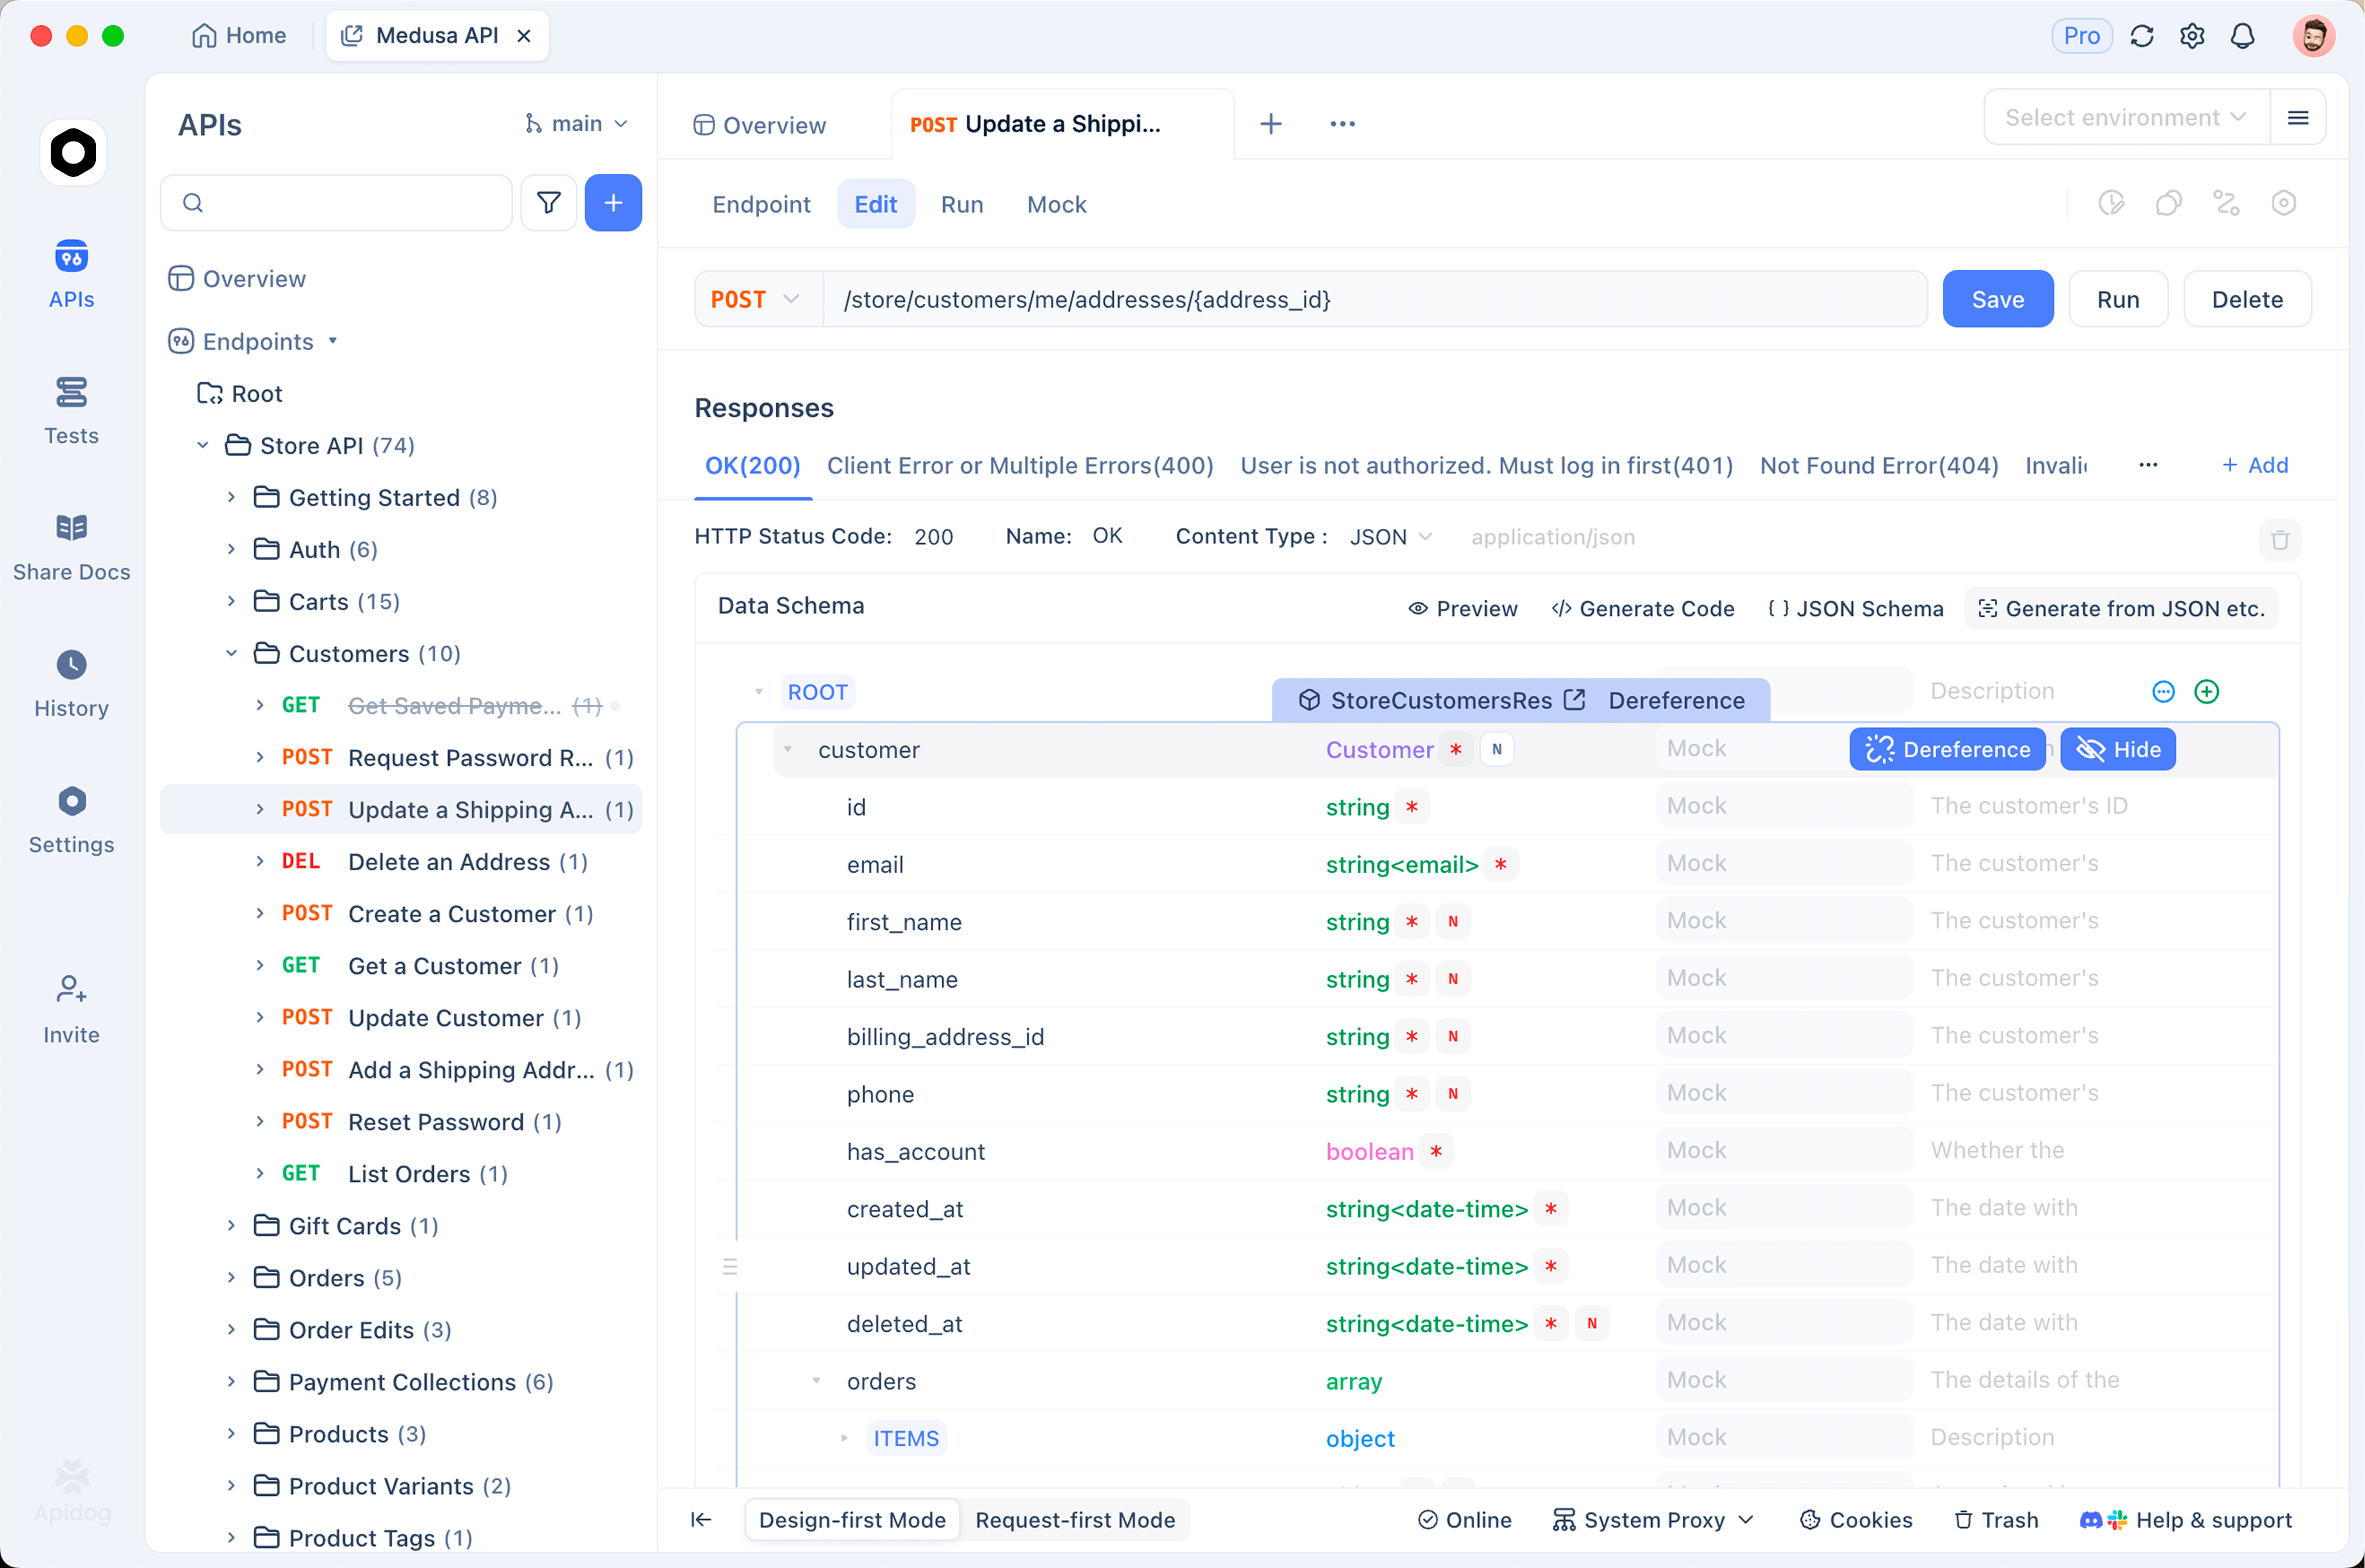
Armazene a chave. Abra o Gerenciamento de Ambiente, crie um ambiente chamado TypeSafe e adicione TYPESAFE_API_KEY com o valor real no campo local, para que ele permaneça em sua máquina e nunca seja sincronizado com a equipe. Nosso guia para ambientes e variáveis secretas abrange as regras de escopo.
Construa a requisição. Nova requisição, POST https://api.typesafe.ai/v1/systemone, tipo de autenticação Bearer Token com {{TYPESAFE_API_KEY}}, corpo JSON do exemplo curl. Envie e leia as respostas no painel de resposta.
Afirme sobre a decisão, não sobre o texto. Adicione asserções de pós-processador como answers.department.choice igual a billing, answers.wants_refund.noul maior que 0.9, e answers.urgency.score maior que 1.5. Agora, uma regressão no comportamento do Jev, ou na sua própria formulação de critérios, falha em um teste em vez de encaminhar tickets erroneamente em silêncio.
Simule para o frontend. Salve a resposta como um mock, e sua UI de tickets poderá ser construída e demonstrada contra um objeto answers estável, sem gastar tokens ou esperar pelo modelo. Como o formato é declarado, o mock e a resposta real não podem divergir.
Salve como um cenário. Encadeie alguns estados, uma mensagem calma, uma irritada, uma ambígua, e afirme que a confiança cai no caso ambíguo. Essa é a verificação que lhe diz que seu limiar está funcionando. Baixe o Apidog para configurar isso; o plano gratuito cobre uma equipe de quatro.
Preços, limites e erros
Da página de modelos da TypeSafe:
- Preço: $0.042 por milhão de tokens de entrada. Tokens de saída não são cobrados. O Gateway lista o mesmo $0.042 por milhão de entrada.
- Limites de taxa: 250.000 tokens por segundo e 1.200 requisições por minuto, ajustados dinamicamente.
- Contexto: 64k tokens por requisição, dos quais 32k são para
statemais a pergunta mais longa. - Entrada: apenas texto. Uma string, um objeto JSON ou um array de texto. Sem imagens, áudio ou vídeo.
- Idioma: Inglês é o melhor; outros idiomas funcionam com menor precisão.
Erros retornam como códigos de status HTTP: 401 para uma chave ausente ou inválida, 422 quando o corpo falha na validação (um Score com um nível, um Choice sem critérios), 429 para limites de taxa, e 529 quando o serviço está sobrecarregado. Recue e tente novamente nos dois últimos; os SDKs fazem isso por padrão.
FAQ
O Jev é um substituto para um LLM?
Não. Ele substitui a parte de uma chamada de LLM onde você estava pedindo uma decisão e analisando texto para obtê-la. Geração, chat e sumarização ainda precisam de um modelo de linguagem.
O Jev pode alucinar?
Ele pode estar errado, mas não pode produzir uma resposta fora do esquema que você declarou. O argumento da TypeSafe é que a correspondência de esquema é garantida, então um rótulo “alucinado” é impossível; um rótulo errado de baixa confiança ainda é possível, e é por isso que a probabilidade importa.
O que "calibrado" significa na prática?
Se o modelo diz 0.9, ele deve estar certo cerca de 90% das vezes para esse tipo de pergunta. É isso que permite que você escolha um limiar e automatize acima dele. Teste-o em seus próprios dados antes de confiar no número; um cenário salvo no Apidog com estados rotulados é uma maneira barata de fazer isso.
Eu preciso do Vercel para usar o Jev?
Não. A API direta em api.typesafe.ai funciona por si só com uma chave Bearer. O Vercel AI Gateway é uma conveniência se você já usa o AI SDK, e é a única rota que suporta experimental_evaluate. De qualquer forma, os fundamentos do JSON Schema por trás das formas declaradas valem a pena conhecer.
Onde o Jev se encaixa
Use o Jev quando a pergunta tiver um conjunto fixo de respostas e você precisar de uma probabilidade com elas: roteamento, classificação, pontuação, verificação, guardrails. Mantenha seu modelo de linguagem para tudo que precisa de palavras. Declare o formato, teste os limiares no Apidog e deixe o número de confiança decidir o que será automatizado.