
Grok 4.6 é o modelo de linguagem de fronteira da xAI, lançado em 12 de agosto de 2026. Ele se baseia no Grok 4.5 com foco em agentes de longa duração, codificação agêntica e trabalho interativo ou visual, oferecendo uma janela de contexto de 500.000 tokens a US$ 2 por milhão de tokens de entrada e US$ 6 por milhão de saída. No Índice de Inteligência da Artificial Analysis, ele atinge 61 pontos, igualando o GPT-5.6 Sol da OpenAI e ficando um ponto atrás do Claude Fable 5 da Anthropic, tornando-o o modelo mais barato atualmente na fronteira da inteligência.
Essa é a resposta em um parágrafo. O restante desta postagem aborda o que realmente mudou em relação ao Grok 4.5, o que os números de benchmark significam, onde você pode usar o modelo hoje e o que isso significa para você, caso esteja desenvolvendo usando APIs de LLMs. Se essa última parte se aplica a você, o Apidog oferece um espaço de trabalho gratuito para projetar, testar e simular chamadas de API de LLM, útil para experimentar o Grok 4.6 sem precisar escrever um cliente primeiro.
TL;DR (Em Resumo)
- Lançamento: 12 de agosto de 2026, pela xAI.
- Foco: agentes de longo horizonte, codificação multi-etapas, trabalho interativo e visual. A xAI afirma que o modelo auto-testa e verifica seu próprio trabalho com mais frequência antes de prosseguir.
- Especificações: janela de contexto de 500K, corte de conhecimento em 1º de fevereiro de 2026.
- Preços: US$ 2 / 1M de entrada, US$ 6 / 1M de saída. Uma variante mais rápida custa 2x. A primeira semana inclui o dobro de uso no Grok Build e Cursor.
- Benchmarks: Índice de Inteligência 61 (empata com GPT-5.6 Sol), grandes saltos em relação ao 4.5 no DeepSWE (54 → 65.9) e APEX-Agents (47.1 → 57.5).
- Onde usá-lo: API da xAI, Grok Build, Cursor, OpenRouter, Vercel e Cloudflare.
Grok 4.6 em um relance
| Especificação | Grok 4.6 |
|---|---|
| Desenvolvedor | xAI |
| Data de lançamento | 12 de agosto de 2026 |
| Janela de contexto | 500.000 tokens |
| Corte de conhecimento | 1º de fevereiro de 2026 |
| Preço de entrada/saída | US$ 2 / US$ 6 por 1M de tokens |
| Variante rápida | 2x preço |
| Índice de Inteligência | 61 (GPT-5.6 Sol: 61, Claude Fable 5: 62) |
| Disponibilidade | API da xAI, Cursor, Grok Build, OpenRouter, Vercel, Cloudflare |
O que realmente mudou em comparação com o Grok 4.5
Grok 4.6 não é uma revelação de arquitetura, é uma história de treinamento. De acordo com a xAI, o modelo passou por um período de treinamento suplementar mais longo do que o Grok 4.5, com três ingredientes realizando o trabalho pesado:
- Dados curados gerados por modelos, visando raciocínio e conceitos técnicos avançados.
- Conjuntos de dados de engenharia de alta qualidade, continuando a dieta pesada em codificação que começou quando a xAI iniciou o treinamento em sessões de desenvolvimento reais.
- Um otimizador e receita de treinamento aprimorados, com trajetórias de fine-tuning supervisionado regeneradas em áreas de raciocínio e específicas de domínio.
A mudança comportamental que os desenvolvedores notarão é a auto-verificação. Durante execuções agênticas longas, o Grok 4.6 verifica seu próprio trabalho antes de passar para a próxima etapa, executando o teste que acabou de escrever, relendo o arquivo que acabou de editar, em vez de avançar com uma suposição não verificada. A xAI também relata tentativas iniciais mais fortes em projetos interativos e visuais: dashboards, pequenos aplicativos e trabalho de UI saem mais próximos de serem utilizáveis na primeira tentativa.
Se a abordagem de treinamento do Grok 4.5 lhe interessou, nossa análise de o que o treinamento da sessão do Cursor significou para os desenvolvedores abrange a linhagem na qual este modelo se baseia.
Os benchmarks, com deltas que importam
Os números de lançamento dos fornecedores merecem ceticismo, mas os deltas de 4.5 para 4.6 são grandes o suficiente para serem significativos. Aqui está o panorama, incluindo a posição da concorrência:
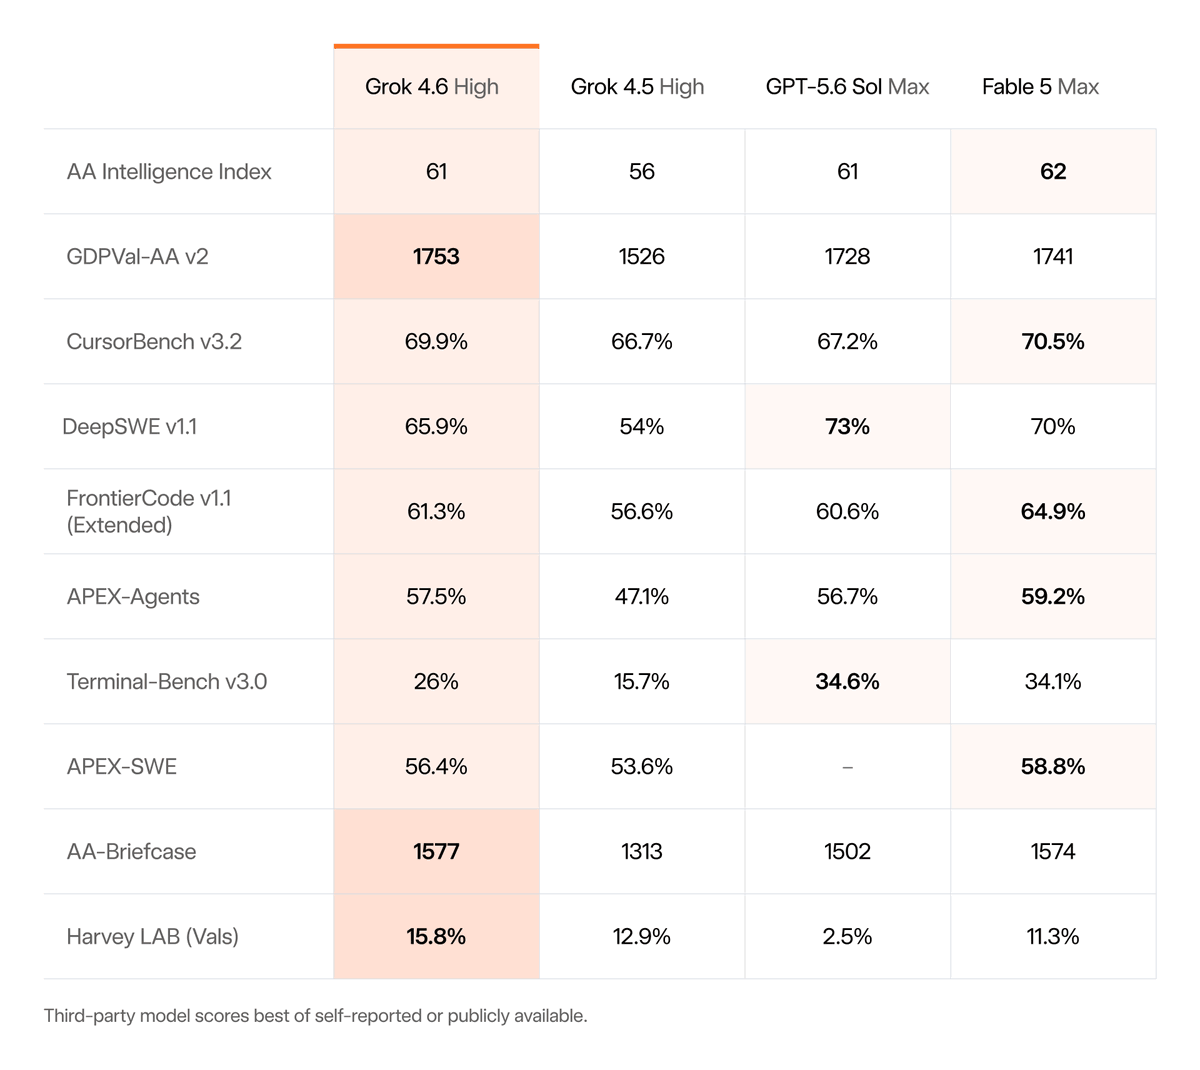
Três pontos principais:
- A lacuna do agente diminuiu. O salto de 10,4 pontos no APEX-Agents move o Grok de "claramente atrás" para 1,7 pontos do Fable 5 Max, e ligeiramente à frente do GPT-5.6 Sol Max (56,7%).
- A codificação em escala de repositório melhorou mais. O aumento de quase 12 pontos no DeepSWE é a diferença entre um modelo que tropeça em mudanças de vários arquivos e um que compete, embora o Sol Max ainda lidere esse benchmark por uma ampla margem.
- Números independentes apoiam a história. A Artificial Analysis mediu um custo médio de US$ 0,84 por tarefa em suas avaliações agênticas, o mais baixo entre os modelos de nível de fronteira, e um Elo de 1753 no GDPval-AA v2 para trabalho de conhecimento profissional.
Para contexto sobre como ler os lançamentos de benchmark da xAI, e as ressalvas que se aplicavam à geração anterior também, consulte nossa análise dos benchmarks do Grok 4.5.
Preços: a jogada de valor da fronteira
O Grok 4.6 manteve os preços do Grok 4.5: US$ 2 por milhão de tokens de entrada, US$ 6 por milhão de saída. Em comparação com os modelos com os quais ele agora se compara, essa é uma diferença acentuada:
| Modelo | Preço de saída / 1M tokens |
|---|---|
| Grok 4.6 | US$ 6 |
| Claude Opus 4.8 | US$ 25 |
| GPT-5.6 Sol | US$ 30 |
Essa é uma diferença de 5x no preço de saída em relação ao GPT-5.6 Sol para um modelo que o empata no índice de inteligência composto. Tokens baratos não significam automaticamente tarefas baratas; uma execução mais fraca que precisa de revisão e reparo custa mais do que sua conta de tokens, mas os dados independentes de custo por tarefa sugerem que a eficiência é real, não apenas um preço baixo de tabela.
A variante mais rápida com preço 2x (US$ 4/US$ 12) é destinada a usos interativos sensíveis à latência. E até 19 de agosto, usuários do Grok Build e Cursor recebem o dobro de uso incluído para testar o modelo.
Onde você pode usar o Grok 4.6 hoje
- API da xAI via console.x.ai, compatível com OpenAI. Nosso guia da API do Grok 4.5 se aplica diretamente; basta mudar o nome do modelo.
- Cursor, disponível como opção de modelo; o Cursor publicou suas próprias notas de lançamento junto com as da xAI.
- Grok Build, o próprio espaço de trabalho agêntico da xAI, com o bônus de uso 2x na semana de lançamento.
- OpenRouter, Vercel e Cloudflare, para equipes que roteiam vários modelos através de um único gateway; listado como
x-ai/grok-4.6no OpenRouter.
Não há um lançamento separado para o consumidor a ser desvendado aqui: este é um lançamento focado em desenvolvedores, e a maneira mais rápida de avaliá-lo é através da API ou de um IDE que já o suporte.
Limitações e questões em aberto
Uma avaliação da semana de lançamento deve a você as ressalvas juntamente com os números principais:
- Os benchmarks são em sua maioria reportados pelo fornecedor. A Artificial Analysis publicou pontuações independentes que geralmente concordam, mas os números específicos de codificação (DeepSWE, FrontierCode, CursorBench) vêm da própria tabela de lançamento da xAI. Os números de lançamento do Grok 4.5 se sustentaram apenas parcialmente sob testes independentes; assuma alguma regressão à média aqui também.
- A janela de contexto é a menor na fronteira. 500K tokens cobrem a maioria das cargas de trabalho reais, mas o GPT-5.6 Sol oferece 1,05M e o Claude Fable 5 oferece 1M. Se você processa monorepos inteiros ou grandes conjuntos de documentos em uma única chamada, essa lacuna é material.
- Sol ainda lidera onde é mais difícil. O déficit de 7 pontos no DeepSWE significa que o trabalho totalmente autônomo em grandes bases de código existentes permanece mais forte no GPT-5.6 Sol Max, e essa é a carga de trabalho de agente mais valiosa economicamente.
- A maturidade do ecossistema está atrasada. O processamento em lote, as camadas de cache de prompt e os controles de uso na plataforma xAI são mais recentes do que os equivalentes da OpenAI e da Anthropic. A compatibilidade com a OpenAI encobre a maior parte, mas não tudo.
Nenhuma dessas são desqualificantes. Elas definem onde o Grok 4.6 se encaixa: a opção de preço-desempenho que você avalia seriamente, não o padrão que você adota pela reputação.
O que isso significa para desenvolvedores de API
A leitura estratégica: a fronteira agora tem um verdadeiro concorrente em preço. Até este lançamento, igualar a saída de nível GPT-5.6 Sol significava pagar US$ 25–30 por milhão de tokens de saída. O Grok 4.6 faz isso por US$ 6, o que muda a matemática em ciclos de agente especialmente; um agente que faz 40 chamadas de modelo por tarefa sente uma diferença de preço de saída de 5x imediatamente.
Na prática, a API compatível com OpenAI significa que avaliá-la custa uma tarde, não um sprint. Aponte seu cliente existente para https://api.x.ai/v1, execute sua carga de trabalho real contra ele e compare. Configure essa comparação no Apidog e você poderá manter as requisições de GPT-5.6, Claude e Grok 4.6 lado a lado em um projeto, com ambientes por provedor e asserções verificando a qualidade da saída, uso de tokens e latência em todos os três, evidências úteis antes de você comprometer uma carga de trabalho de produção com qualquer um deles.
O foco do modelo em agentes também eleva a aposta na correção das chamadas de ferramentas. Se sua integração com o Grok envolve chamadas de função, teste os payloads que ele gera, não apenas o texto que ele escreve.
FAQ (Perguntas Frequentes)
- O que é o Grok 4.6 em uma frase? É o modelo de fronteira da xAI de agosto de 2026, ajustado para agentes de longa duração e codificação, com uma janela de contexto de 500K e pontuações de benchmark de nível de fronteira a aproximadamente um quinto do preço de saída dos concorrentes.
- O Grok 4.6 é melhor que o GPT-5.6? Eles empatam no Índice de Inteligência da Artificial Analysis com 61 pontos. O GPT-5.6 Sol Max lidera na codificação em escala de repositório (DeepSWE); o Grok 4.6 avança no APEX-Agents e custa cerca de 5x menos por token de saída.
- Qual a diferença entre o Grok 4.5 e o 4.6? Mesmo preço, mesma API, modelo significativamente melhor: +11,9 pontos no DeepSWE, +10,4 no APEX-Agents e uma nova tendência de auto-verificação durante tarefas longas.
- Posso experimentar o Grok 4.6 gratuitamente? Grok Build e Cursor incluem 2x o uso durante a semana de lançamento, e os métodos em nosso guia para usar o Grok 4.5 gratuitamente se aplicam amplamente ao 4.6.