
O GPT-Live-1.1 é o modelo de voz full-duplex da OpenAI, disponível na API desde 20 de novembro de 2026. Ele ouve enquanto fala, delega o raciocínio e as chamadas de ferramentas para um modelo de backend de sua escolha e é cobrado por minuto: US$ 0,05 por minuto ativo e US$ 0,02 por minuto em espera. O acesso é feito por um único endpoint, v1/live/sessions, e não pela API Realtime.
Nosso post anterior sobre o que é o GPT-Live abordou o recurso de voz do ChatGPT antes de ele ficar disponível para desenvolvedores. Este guia cobre o modelo via API: o que há de novo, quanto custa, como funciona uma sessão e como ele se compara ao GPT-Realtime.
O que é o GPT-Live-1.1?
O GPT-Live-1.1 é um modelo de voz que mantém uma conversa falada em tempo real enquanto um modelo de backend separado faz o raciocínio. Ele aceita áudio e texto, retorna áudio e texto e continua ouvindo enquanto fala, de modo que o interlocutor pode interromper ou adicionar detalhes no meio da frase. Seu ID de modelo é gpt-live-1.1 e ele oferece suporte a streaming e function calling.
A página do modelo GPT-Live-1.1 o descreve como um "modelo de voz full-duplex para conversas multilíngues". Full duplex significa que o áudio flui nos dois sentidos ao mesmo tempo, como em uma ligação telefônica, e não como em um rádio comunicador, em que um lado precisa esperar.
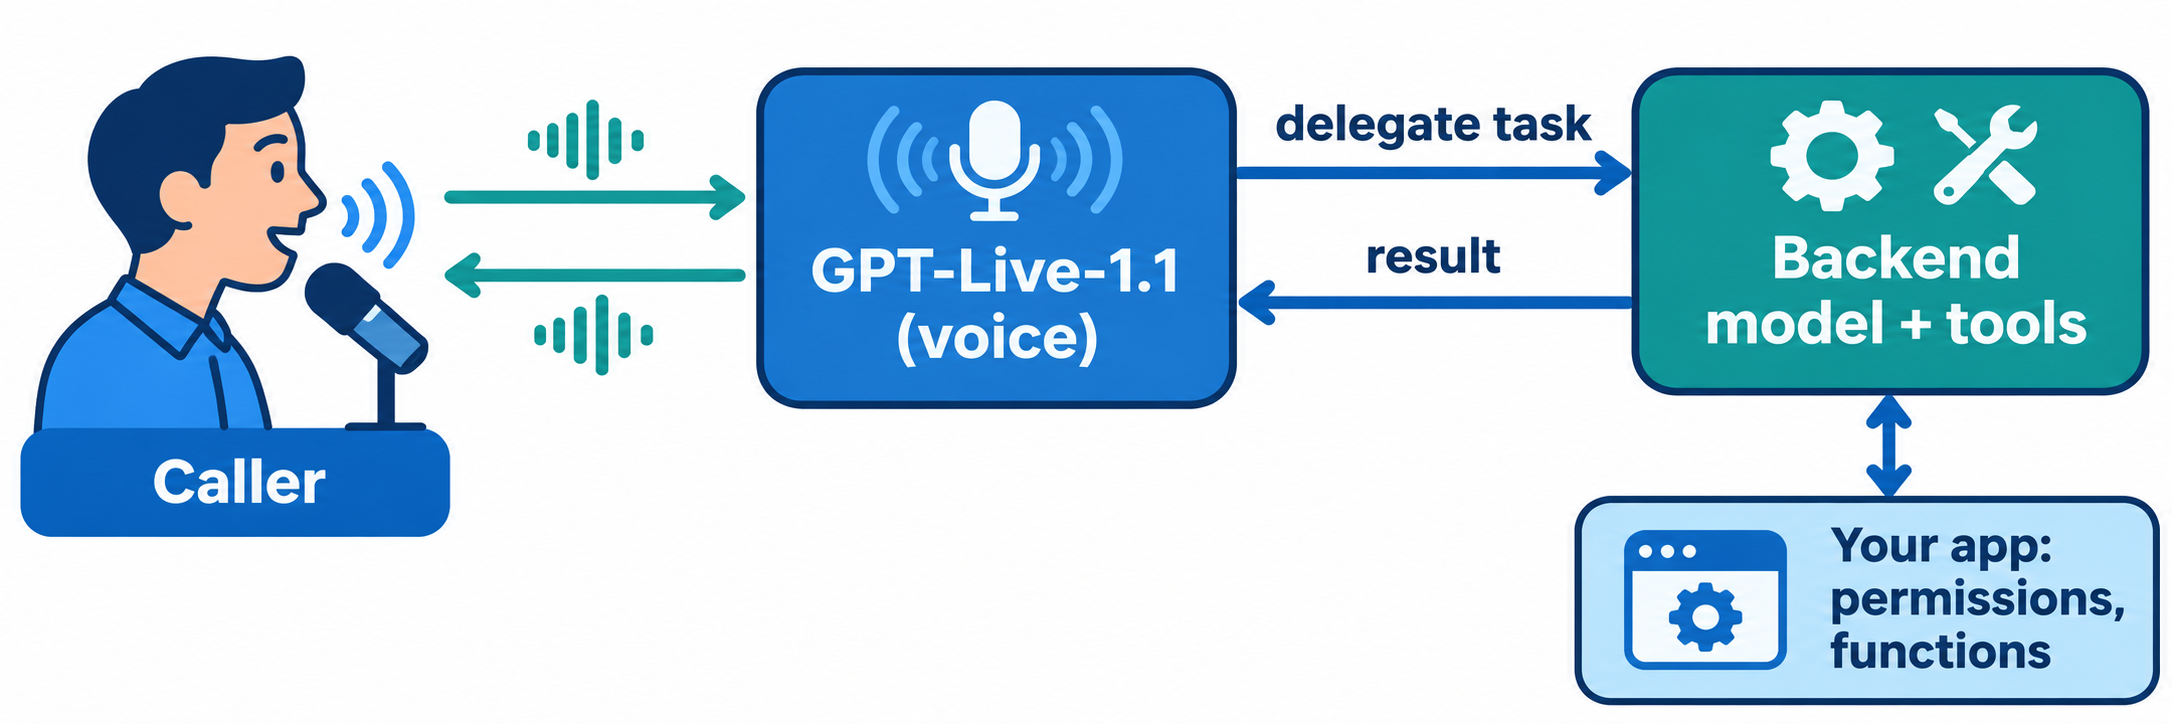
A outra metade do design é a delegação. O GPT-Live decide quando uma solicitação exige trabalho real, envia para um backend (um modelo Responses da OpenAI ou seu próprio agente), continua falando enquanto o backend processa e depois explica o resultado em voz alta.
O que mudou em relação ao GPT-Live-1
O GPT-Live-1.1 mantém o mesmo endpoint, preços e conjunto de recursos do GPT-Live-1. As mudanças estão na qualidade da voz e no desempenho em tarefas. Veja o que a OpenAI lista na documentação do modelo e em seu anúncio no X:
| Área | GPT-Live-1 | GPT-Live-1.1 |
|---|---|---|
| Transcrição de fala | Base | Mais precisa, segundo a página do modelo |
| Sotaque e voz entre idiomas | Base | Mais consistente, segundo a página do modelo |
| Sessões ociosas | Tarifa de espera listada em sua página | Espera anunciada como opção nova, US$ 0,02/min |
| Conclusão de tarefas | Base | "Conclui tarefas com ainda mais confiabilidade", segundo o anúncio da OpenAI |
| Endpoint | v1/live/sessions |
v1/live/sessions |
| Preço (ativo) | US$ 0,05/min | US$ 0,05/min |
| Limites de taxa | Sessões concorrentes | Limite separado de sessões concorrentes |
A OpenAI não publicou números de benchmarks para os ganhos em transcrição ou confiabilidade, então trate-os como afirmações do fornecedor até que você os meça. Além disso, o anúncio da OpenAI apresenta a espera como novidade desta versão, enquanto a página do GPT-Live-1 agora lista a mesma tarifa de espera de US$ 0,02.
Como os dois modelos compartilham o mesmo endpoint e preços, a troca começa definindo o model da sessão como gpt-live-1.1. Depois, execute novamente suas próprias avaliações de voz para confirmar os ganhos no seu tráfego.
Preços do GPT-Live-1.1
O GPT-Live-1.1 cobra as sessões de voz por duração, não por tokens. Estas são as tarifas na página de preços da OpenAI, verificadas em 20 de novembro de 2026:
| Métrica | Preço |
|---|---|
| Tempo de sessão ativa | US$ 0,05 por minuto |
| Tempo de sessão em espera | US$ 0,02 por minuto |
| Modelo de backend e ferramentas | Cobrados separadamente nas tarifas normais do modelo |
Alguns detalhes de cobrança são importantes ao estimar custos:
- Cobrança por segundo. A duração não é arredondada para o próximo minuto inteiro.
- A espera é exclusiva do WebRTC. A tarifa reduzida se aplica a sessões WebRTC enquanto a inferência está pausada.
- Taxa de inicialização. A criação de uma sessão WebRTC cobra 15 segundos durante a configuração, valores descontados da cobrança de duração quando a sessão entra em operação.
- O backend é uma segunda cobrança. Os tokens Responses delegados e as chamadas de ferramentas também são cobrados.
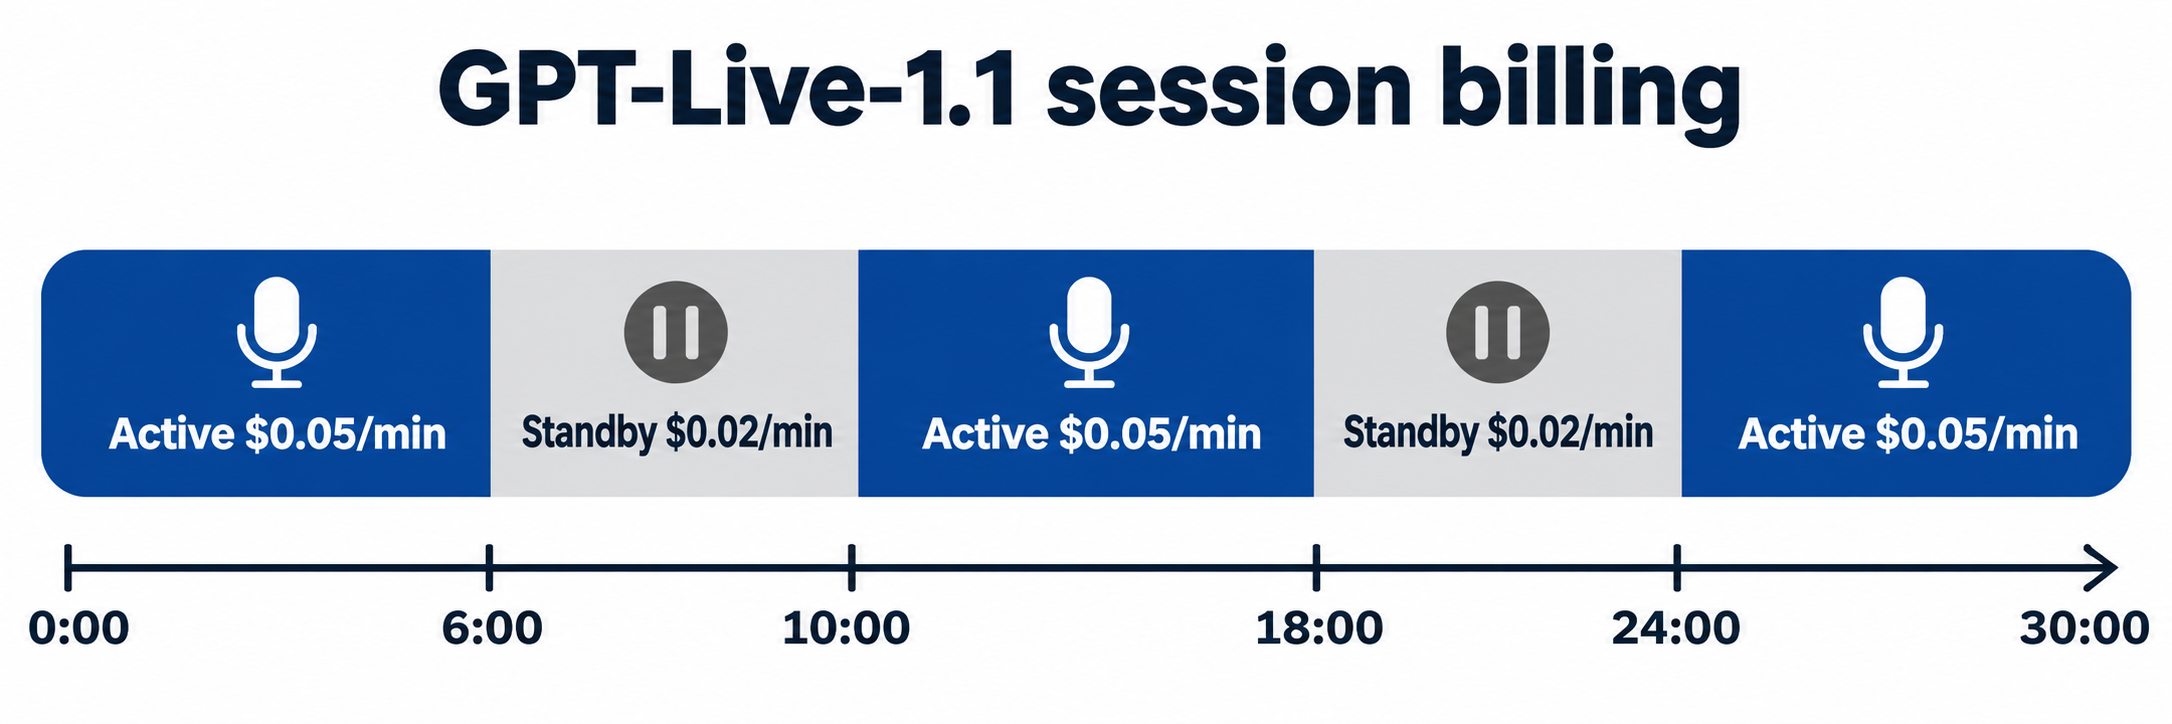
Exemplo prático com base na linha do tempo acima: uma sessão de suporte de 30 minutos passa 20 minutos ativa e 10 minutos em espera enquanto o interlocutor pesquisa algo. Custo de voz: 20 x US$ 0,05 + 10 x US$ 0,02 = US$ 1,20. Sem espera, a mesma sessão custaria 30 x US$ 0,05 = US$ 1,50. Some o que o modelo de backend gastar em suas tarefas delegadas.
Como funciona o GPT-Live-1.1: voz mais delegação
Uma aplicação GPT-Live tem duas partes. O guia de primeiros passos as divide assim:
- O GPT-Live cuida da conversa. Ele ouve, fala e decide quando pedir ajuda ao backend. Você fornece um prompt curto sobre o estilo de fala e quando delegar.
- O backend cuida das tarefas delegadas. Ele raciocina, chama ferramentas e retorna resultados para o GPT-Live falar em voz alta. As instruções detalhadas, as regras de negócio e os fluxos de trabalho das ferramentas ficam aqui.
- Sua aplicação cuida das partes críticas. Ela verifica permissões, coleta confirmações, executa funções que acessam seus sistemas e salva o progresso das tarefas.
Você escolhe um dos dois modos de delegação ao criar a sessão, e não é possível alternar modos durante a sessão:
| Modo | Quem executa o backend | Escolha quando |
|---|---|---|
| Delegação Responses | A OpenAI chama o modelo Responses que você configurou e transmite contexto e resultados | Você quer que o GPT-Live gerencie as solicitações ao backend por você |
| Delegação no cliente | Sua aplicação executa qualquer modelo, agente ou serviço e devolve os resultados | Você precisa validar, ocultar ou combinar resultados, ou usar um backend que não seja da OpenAI |
O guia de delegação recomenda começar com a delegação Responses. A delegação no cliente é ideal para equipes que desejam adicionar voz a um agente de texto já existente.
Crie sua primeira sessão GPT-Live-1.1
O GPT-Live tem um endpoint próprio. A página do modelo lista o v1/live/sessions como suportado e marca Chat Completions, Responses e v1/realtime como não suportados. A OpenAI recomenda WebRTC para áudio, com WebSockets e SIP como alternativas.
O fluxo WebRTC do quickstart funciona em cinco etapas:
- O navegador solicita acesso ao microfone e adiciona suas faixas a uma conexão peer.
- Ele cria um canal de dados e, em seguida, gera uma oferta SDP.
- O navegador envia a oferta ao seu servidor.
- Seu servidor envia
sessionetransport: { type: "webrtc", sdp }paraPOST /v1/live/sessionscom sua chave de API. - O navegador aplica a resposta SDP retornada e aguarda o
session.started.
Este é o código de chamada do servidor do exemplo em TypeScript da OpenAI, reduzido à configuração da sessão:
const result = await client.live.create({
  session: {
    model: "gpt-live-1.1",
    instructions:
      "Be concise. Delegate requests needing current information to the backend, which can search the web.",
    delegation: {
      type: "responses",
      responses: {
        model: "gpt-5.6-terra",
        instructions:
          "Use web search when current facts are needed. Return concise, grounded results for a spoken conversation.",
        tools: [{ type: "web_search" }],
        tool_choice: "auto",
      },
    },
  },
  transport: { type: "webrtc", sdp: request.body.sdp },
});
Mantenha a chave de API no servidor e não envie session.start no canal de dados: a requisição HTTP já inicia a sessão. A OpenAI também disponibiliza o OpenAI Live Console, um aplicativo de exemplo local para acompanhar conversas, delegações e a atividade das ferramentas do backend.
Modo de espera: reduza custos de ociosidade
O modo de espera mantém uma conexão WebRTC aberta enquanto ninguém está falando e retoma a inferência quando alguém fala. A conexão e o ID da sessão permanecem os mesmos, e o histórico da conversa volta quando a sessão é retomada.
Você o ativa com dois campos da sessão:
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 20
  }
}
wake_policy.type: "speech"aguarda fala antes de iniciar a inferência.idle_timeout_saceita um número inteiro de 5 a 60. Após esse número de segundos sem transcrição de entrada ou saída, a sessão entra em espera.vad_thresholdvaria de 0 a 1 e tem padrão 0,5. Valores mais altos exigem evidências mais fortes de fala para acordar.
Fique atento a session.paused e session.resumed para acompanhar o estado, e mantenha a faixa do microfone ativa. Uma desvantagem apontada pelo guia de gerenciamento de sessões: a primeira resposta a uma fala curta após a espera pode demorar mais. Para intervalos longos, fechar a sessão e iniciar uma nova pode custar menos do que o modo de espera.
GPT-Live-1.1 vs GPT-Realtime
O guia de agentes de voz da OpenAI enquadra a escolha pela arquitetura. O GPT-Live é ideal para conversas full-duplex com um backend separado. A API Realtime é ideal para um único modelo que ouve, raciocina, chama ferramentas e fala em uma única sessão.
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| Endpoint | v1/live/sessions |
v1/realtime |
| Design | Frontend de voz com backend delegado | Um único modelo de fala para fala |
| Entrada | Áudio, texto | Texto, áudio, imagem |
| Cobrança | US$ 0,05/min ativo, US$ 0,02/min em espera | Por token: US$ 32 de entrada, US$ 64 de saída por 1M de tokens de áudio |
| Custo do backend | Cobrado separadamente | Incluído no preço por token |
| Melhor para | Adicionar voz a um agente de texto existente | Agentes de voz autossuficientes |
A cobrança por minuto torna o custo de voz do GPT-Live fácil de prever em chamadas longas. A cobrança por token no Realtime acompanha o volume de áudio e texto que trafega e inclui o raciocínio em um único preço. Para uma análise mais aprofundada dessa comparação, veja GPT-Live vs GPT-Realtime e nosso guia da API GPT-Realtime-2.
Limites de taxa e acesso
Os limites do GPT-Live contam sessões concorrentes, não tokens. O GPT-Live-1.1 e o GPT-Live-1 têm limites separados que se aplicam em todas as regiões de inferência. A página do GPT-Live-1 lista 50 sessões concorrentes no tier Build, 300 no Launch e 500 no Grow, e marca o tier gratuito como não suportado. A página do GPT-Live-1.1 ainda não publica sua própria tabela, então verifique a página de limites da sua organização antes de planejar a carga.
Teste seu servidor de sessões com o Apidog CLI
Sua integração GPT-Live tem uma superfície HTTP que é sua: o endpoint /api/session que troca ofertas SDP. O exemplo da OpenAI retorna 403 para uma origem inesperada e 400 para uma oferta SDP ausente. Esses caminhos nunca chegam à OpenAI, então você pode testá-los a cada commit sem custo de voz. Deixe seu agente de codificação escrever e executar os testes com o Apidog CLI.
Instale o CLI, faça login e adicione a skill do Apidog ao seu agente:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois, dê um único prompt ao seu agente:
In Apidog project <projectId>, add POST /api/session for my GPT-Live-1.1 server.
Create test cases that assert: a request with a wrong Origin header returns 403,
a request with no sdp field returns 400. Run them against the local environment
and summarize any failures.
O agente lê os esquemas, valida seus payloads, cria o endpoint e os casos de teste e, então, os executa:
apidog cli-schema get endpoint-create
apidog endpoint create --project <projectId> --file ./endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
O mesmo apidog run com -r junit se encaixa no CI; veja como executar o Apidog CLI em um pipeline de CI/CD. Se você usa Claude Code, o guia do Apidog CLI no Claude Code detalha a configuração. O plano gratuito do Apidog cobre equipes de até 4 usuários.
FAQ
O GPT-Live-1.1 está disponível na API? Sim. A OpenAI disponibilizou o GPT-Live-1.1 na API em 20 de novembro de 2026, com o ID de modelo gpt-live-1.1 no endpoint v1/live/sessions. Nosso post anterior sobre a API do GPT-Live é anterior a esse lançamento.
Quanto custa o GPT-Live-1.1? US$ 0,05 por minuto ativo e US$ 0,02 por minuto em espera, com cobrança por segundo. O uso do modelo de backend e das ferramentas é cobrado separadamente nas tarifas normais.
Qual é a diferença entre o GPT-Live-1 e o GPT-Live-1.1? O GPT-Live-1.1 transcreve a fala com mais precisão, mantém sotaque e voz mais consistentes entre idiomas e adiciona uma opção de espera para sessões ociosas. Os preços e o endpoint são os mesmos.
O GPT-Live-1.1 enxerga imagens? Não diretamente. Envie as imagens para um modelo de backend com suporte a visão, que retorna texto para o GPT-Live usar.
O GPT-Live-1.1 oferece suporte a function calling? Sim. A página do modelo lista streaming e function calling. Na prática, seu backend processa as chamadas de ferramentas por meio da delegação, e sua aplicação executa as funções personalizadas.