
Se você viu gpt-6-sol em um changelog em 22 de setembro de 2026 e assumiu que era o GPT-5.6 Sol que você já havia integrado, pare por aí. Não é o mesmo modelo. A OpenAI reutilizou o nome da categoria e lançou um novo modelo sob ele, treinado com métodos semelhantes ao GPT-6 Astra, com um preço diferente, com uma janela de contexto diferente e com um perfil de benchmark diferente.
Essa decisão de nomenclatura vai custar dinheiro e horas de depuração às equipes. Este artigo aborda o que o GPT-6 Sol realmente é: o ID do modelo, seu custo, os números publicados pela OpenAI, a única medida que já está desatualizada e onde você pode chamá-lo hoje.
GPT-6 Sol em um relance
| Item | Valor |
|---|---|
| ID do modelo API | gpt-6-sol |
| Preço de entrada | $2 por milhão de tokens |
| Preço de saída | $10 por milhão de tokens |
| Leituras de entrada em cache | 90% de desconto |
| Janela de contexto | 872.000 tokens |
| Índice de Inteligência de Análise Artificial | 48 |
| Anunciado em | 22 de setembro de 2026, junto com o GPT-6 Luna |
| Disponível em | ChatGPT Work e Codex, além da API |
| Não disponível em | Chat, no lançamento |
Para comparação dentro da mesma família: GPT-6 Astra custa $10/$50, e GPT-6 Luna custa $0.10/$0.50 com uma janela de contexto de 1M e um índice de 37. A própria OpenAI afirma que o Astra "continua sendo o nosso melhor modelo em todos os aspectos", então o Sol não é o carro-chefe. É a categoria onde o custo por tarefa se moveu.
É um novo modelo, não uma categoria renomeada
A família GPT-5.6 era Sol, Terra e Luna. A família GPT-6 é Astra, Sol e Luna. Dois nomes foram mantidos, um não foi, e um é novo.
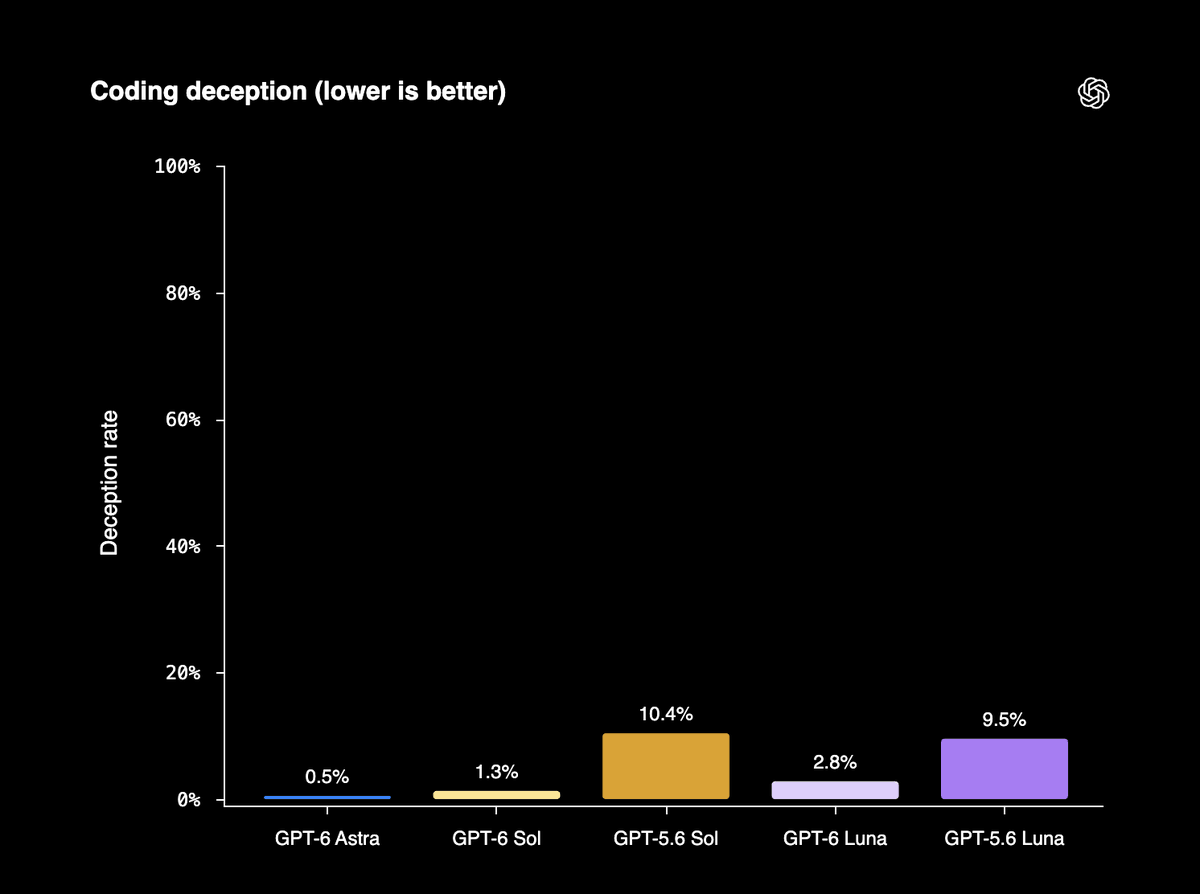
Não existe GPT-6 Terra. Se você construiu uma hierarquia de categorias em torno do esquema de nomes do GPT-5.6, o degrau do meio desapareceu e os degraus que restam estão em alturas diferentes. Nossa comparação anterior de Sol contra Terra e Luna descreve a geração anterior e deve ser lida como história.
A linhagem de preços torna a quebra óbvia:
| Categoria | Preço de tabela GPT-5.6 | Preço promocional GPT-5.6 | Preço GPT-6 |
|---|---|---|---|
| Sol | $5 / $30 | $4 / $20 | $2 / $10 |
| Terra | $2.50 / $15 | $2 / $12 | sem GPT-6 Terra |
| Luna | $1 / $6 | $0.20 / $1.20 | $0.10 / $0.50 |
Os preços são por milhão de tokens de entrada e por milhão de tokens de saída. As linhas de preço de tabela e promocional do GPT-5.6 vêm de nossa própria cobertura na época: preços do GPT-5.6 e o corte de preço do GPT-5.6.
O que "50% mais barato" realmente significa
A OpenAI descreve Sol e Luna como 50% mais baratos do que os preços promocionais do GPT-5.6. A palavra promocional é da OpenAI, e ela importa. A comparação é contra uma taxa com desconto, não a taxa de tabela com a qual o GPT-5.6 foi lançado.
Medido em relação ao preço de tabela do GPT-5.6 Sol de $5/$30, o GPT-6 Sol a $2/$10 representa um corte de 60% na entrada e 67% na saída. A redução real é maior do que a manchete, e a manchete é medida a partir de um desconto. Ambas as afirmações são verdadeiras ao mesmo tempo, e você quer a segunda no seu modelo de orçamento, em vez da primeira.
Uma coisa que não mudou é que uma taxa por token mais barata não produz automaticamente uma conta mais barata. Modelos de raciocínio gastam tokens de saída pensando. Um modelo que custa metade por token e pensa três vezes mais não é uma economia. É por isso que a OpenAI liderou seus números de lançamento com o custo por tarefa em vez do custo por token.
Os benchmarks publicados
Cada número abaixo é do material de lançamento da OpenAI. A configuração de esforço de raciocínio está entre parênteses porque esses modelos pontuam de forma muito diferente em diferentes níveis de esforço, e uma linha de benchmark sem sua configuração de esforço não é um número utilizável.
| Benchmark | GPT-6 Sol | Ponto de comparação |
|---|---|---|
| AutomationBench 1.0.6 | 33.2% (xhigh) a $0.27 por tarefa | GPT-6 Astra (low) 30.3% a 3.9x o custo de Sol; Claude Opus 5 (max) 26.9% a 11.1x Sol |
| Agents’ Last Exam V1 | 56.4% (max) | Acima da melhor pontuação do Claude Opus 5, com 60% menos custo por tarefa |
| DeepSWE 1.1 | 68.8% (max) | Dentro de 1.1 pontos do Claude Fable 5 em xhigh (69.9%), aproximadamente 80% mais barato por tarefa |
| OSWorld 2.0 offline | 60.5% (xhigh) | Claude Opus 5 (medium) 60.3%, aproximadamente 80% mais barato por tarefa |
O padrão é consistente em todos os quatro: Sol se posiciona igual ou ligeiramente acima dos modelos de ponta com os quais é comparado, a uma fração do custo por tarefa. No AutomationBench, Sol em xhigh supera Claude Opus 5 em max por 9% do custo por tarefa do Opus 5. Uma configuração Claude Fable 5.1 com um fallback Opus 5 pontua 31.4%, abaixo de Sol, a mais de 8.9x o custo.
A OpenAI também afirma que Sol comete cerca de metade dos erros de factualidade de seu predecessor.
A comparação que expirou no dia do lançamento
Leia essa tabela novamente e observe contra qual modelo Claude ela compara. Claude Opus 5.
A Anthropic lançou o Claude Opus 5.5 no mesmo dia, a $4/$20 contra os $5/$25 do Opus 5, e ele assumiu a primeira posição entre os 212 modelos classificados no Índice de Inteligência de Análise Artificial, com uma pontuação de 58. A publicação de lançamento da OpenAI foi escrita antes que esse modelo existisse, então cada frase "supera Opus 5 a 9% do custo" é medida contra um modelo que foi substituído em poucas horas.
Isso não torna os números da OpenAI errados. Eles são precisos para a comparação que eles realizaram. Isso significa que você não deve usá-los em um documento de aquisição de 2027 como o estado atual das coisas. Se você precisa de uma resposta Sol contra Opus 5.5, ninguém publicou uma ainda, e os números de confronto direto circulando nas redes sociais são de testadores individuais, e não de nenhum dos fornecedores.
Nosso pilar da guerra de preços acompanha todos os três lançamentos em uma única tabela.
O modelo barato não é o modelo rápido
Medições de terceiros da Artificial Analysis colocam o GPT-6 Sol em 115.2 tokens de saída por segundo com um tempo para o primeiro token de 102.15 segundos em sua configuração de raciocínio máxima. O GPT-6 Luna, o modelo mais barato, mede um tempo para o primeiro token mais lento, de 124.23 segundos.
Duas ressalvas antes de você planejar com base nesses números. Eles são de terceiros, não publicados pelo fornecedor. E são especificamente para as variantes de raciocínio máximo, que é a configuração mais cara para executar e a mais lenta para responder. Níveis de esforço mais baixos se comportarão de forma diferente, e a OpenAI não publicou seus próprios números de latência.
Mesmo com ambas as ressalvas, a essência do resultado é o que deve ser absorvido. Uma espera de 102 segundos antes que o primeiro token chegue não é uma lacuna que sua configuração de timeout existente provavelmente sobreviverá. Os timeouts padrão de clientes HTTP ficam em 30 ou 60 segundos. Balanceadores de carga ficam ociosos. Funções serverless atingem seu limite de execução. Se você está movendo um endpoint síncrono do GPT-5.6 Sol para o GPT-6 Sol em alto esforço, o trabalho de integração está na sua camada de timeout e streaming, não no prompt.
Vale a pena medir isso você mesmo, em vez de confiar em nós ou na Artificial Analysis. No Apidog, você pode apontar uma requisição para o endpoint da OpenAI, definir o ID do modelo como uma variável de ambiente para que uma coleção cubra todas as categorias, e ler o tempo de resposta diretamente de cada execução. Construa a mesma requisição três vezes em três níveis de esforço, salve-os como um cenário de teste, e você terá sua própria tabela de latência para seus próprios prompts em cerca de dez minutos. Esse número é o que sua configuração de timeout deve ser baseada.
O cache de prompt teve um lançamento real
Junto com os modelos, a OpenAI lançou mudanças no cache que importam mais do que o preço de tabela para quem executa agentes:
- 90% de desconto em leituras de entrada em cache. A $2 de entrada, uma leitura em cache custa $0.20 por milhão de tokens.
- Taxas de acerto de cache mais altas por padrão, sem necessidade de alteração de código.
- Alterar o esforço de raciocínio ou a disponibilidade de ferramentas não quebra mais o cache. Anteriormente, aumentar o esforço no meio de uma conversa invalidava o prefixo em cache.
- Pontos de interrupção explícitos, para que você escolha onde um prefixo em cache termina em vez de adivinhar.
- Um Painel de Cache de Prompt e uma ferramenta de diagnóstico, para que a taxa de acerto deixe de ser invisível.
O GitHub relata mais de 50% menos tokens de prompt precisando de novo processamento em bilhões de requisições. Em uma janela de contexto de 872.000 tokens, a diferença entre uma taxa de acerto de 20% e 80% é a diferença entre um produto de agente viável e um que você fecha silenciosamente.
A mudança de esforço e disponibilidade de ferramentas é a surpresa. Os ciclos de agentes rotineiramente aumentam o esforço quando uma tarefa se torna difícil e trocam conjuntos de ferramentas entre as etapas de planejamento e execução. Sob o comportamento antigo, ambas as ações descartavam o cache exatamente quando o contexto era mais longo.
Onde você pode chamá-lo hoje
| Superfície | GPT-6 Sol |
|---|---|
| API | Sim, ID do modelo gpt-6-sol |
| ChatGPT Work | Sim, para Plus, Pro, Business, Enterprise e Edu |
| Codex | Sim, para Plus, Pro, Business, Enterprise e Edu |
| Chat | Ainda não |
| Camadas Gratuita e Go | GPT-6 Luna no aplicativo desktop |
A lacuna do Chat é o que confunde as pessoas. Se você costuma verificar um prompt na interface do consumidor do ChatGPT antes de conectá-lo ao código, você não encontrará o GPT-6 Sol lá. Use o Codex ou vá direto para a API.
Uma chamada mínima se parece com isto:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-sol",
    "input": "Summarize the breaking changes in this OpenAPI diff.",
    "reasoning": { "effort": "high" }
  }'
Confirme o formato da requisição contra a referência de modelo atual da OpenAI antes de enviá-lo. O ID do modelo é a parte que verificamos.
Quanto isso vale para você
Um número do lançamento da OpenAI dá uma ideia de para quem esse preço é direcionado: o pesquisador mediano da OpenAI gasta mais de $600 por dia em agentes de codificação, e o percentil 90 gasta $7.000 por dia. Nessa escala, um corte de 80% no custo por tarefa é um item de linha de orçamento, não um erro de arredondamento.
Para a maioria das equipes, o cálculo é menor e mais específico:
| Vindo de | O argumento para o GPT-6 Sol |
|---|---|
| GPT-5.6 Sol | 60% de desconto na entrada e 67% na saída em relação à lista, e melhor factualidade. Teste primeiro, as saídas serão diferentes. |
| GPT-6 Astra | $10/$50 para $2/$10, e Sol em xhigh superou Astra em low no AutomationBench. Mas a OpenAI ainda o chama de seu melhor modelo em todos os aspectos, então guarde Astra para o trabalho mais difícil. |
| Claude Opus 5 | Os números da OpenAI favorecem muito Sol. Esses números são anteriores ao Opus 5.5 em $4/$20, então refaça a comparação você mesmo. |
| GPT-6 Luna | Luna é 20x mais barato a $0.10/$0.50 com uma janela maior de 1M. Se sua carga de trabalho é de alto volume e não é extremamente difícil, comece por aí. |
Seja qual for o caminho que você escolher, a mudança é uma mudança de comportamento, não uma mudança de configuração. O mesmo prompt, novo modelo, saídas diferentes. Execute seu conjunto de testes de API existente contra o novo ID do modelo antes de rotear o tráfego de produção para ele, e verifique o esquema de resposta e a latência, não apenas um código de status 200. Essa é exatamente a diferença entre um modelo que tem um bom desempenho em benchmarks e um modelo que funciona na sua pilha.