
A camada mais barata em uma família de modelos costumava ser a camada em que você não confiava. Você enviava tráfego de classificação, sumarização e retentativas para lá, mantinha qualquer coisa agentiva no carro-chefe e aceitava que o modelo de orçamento falharia no momento em que uma tarefa exigisse mais de uma etapa.
GPT-6 Luna, anunciado em 22 de setembro de 2026, tem o preço dessa camada e não se comporta como ela. Custa US$ 0,10 por milhão de tokens de entrada e US$ 0,50 por milhão de tokens de saída, possui uma janela de contexto de 1 milhão de tokens, e os números publicados da OpenAI o colocam dentro do alcance dos modelos de fronteira em benchmarks de codificação agentiva por uma pequena fração do custo por tarefa.
Uma coisa a ser esclarecida primeiro: este não é o GPT-5.6 Luna que você já pode ter conectado a uma cadeia de fallback. Mesmo nome de camada, novo modelo, novo preço, nova janela de contexto. Assumir o contrário é uma maneira fácil de implementar uma mudança de comportamento silenciosa e só descobrir através de um ticket de suporte.
GPT-6 Luna em um piscar de olhos
| Item | Valor |
|---|---|
| ID do modelo de API | gpt-6-luna |
| Preço de entrada | US$ 0,10 por milhão de tokens |
| Preço de saída | US$ 0,50 por milhão de tokens |
| Leituras de entrada em cache | 90% de desconto |
| Janela de contexto | 1.000.000 tokens |
| Índice de Inteligência de Análise Artificial | 37 |
| Anunciado | 22 de setembro de 2026, juntamente com o GPT-6 Sol |
| Disponível em | ChatGPT Work e Codex, o aplicativo desktop para usuários Free e Go, além da API |
| Não disponível em | Chat, a partir do lançamento |
Dentro da mesma família, GPT-6 Sol custa US$ 2/US$ 10 com uma janela de 872.000 tokens e um índice de 48, e GPT-6 Astra custa US$ 10/US$ 50. A OpenAI afirma que Astra “continua sendo nosso melhor modelo em todos os aspectos”, então Luna não está sendo vendido como o modelo mais inteligente. Ele está sendo vendido como aquele em que o custo por tarefa desabou.
É um novo modelo, não uma camada renomeada
A família GPT-5.6 era Sol, Terra e Luna. A família GPT-6 é Astra, Sol e Luna. Dois nomes foram mantidos, Terra não foi, e Astra é novo. A OpenAI descreve Sol e Luna como treinados com métodos semelhantes ao GPT-6 Astra, o que significa que são novos modelos compartilhando uma convenção de nomenclatura com os antigos.
Não existe GPT-6 Terra. Se você construiu uma escada de roteamento em torno do esquema de nomenclatura do GPT-5.6, o degrau do meio não existe mais, e nossa comparação anterior de Sol contra Terra e Luna agora é lida como história em vez de orientação atual.
A linhagem de preços mostra o quão longe a camada se moveu:
| Camada | Lista GPT-5.6 | Promocional GPT-5.6 | GPT-6 |
|---|---|---|---|
| Sol | US$ 5 / US$ 30 | US$ 4 / US$ 20 | US$ 2 / US$ 10 |
| Terra | US$ 2,50 / US$ 15 | US$ 2 / US$ 12 | sem GPT-6 Terra |
| Luna | US$ 1 / US$ 6 | US$ 0,20 / US$ 1,20 | US$ 0,10 / US$ 0,50 |
Todos os valores são por milhão de tokens de entrada e por milhão de tokens de saída. As linhas do GPT-5.6 vêm de nossa cobertura na época, preços do GPT-5.6 e o corte de preço do GPT-5.6.
A OpenAI descreve Sol e Luna como 50% mais baratos do que os preços promocionais do GPT-5.6. A palavra promocional é da própria OpenAI e muda o significado da afirmação: a comparação é feita contra uma taxa com desconto, não a taxa de lançamento do GPT-5.6. Medido contra o preço de tabela do GPT-5.6 Luna de US$ 1/US$ 6, o GPT-6 Luna a US$ 0,10/US$ 0,50 representa um corte de 90% na entrada e 92% na saída. A redução real é maior do que a manchete, e a manchete é medida a partir de um desconto. Coloque o segundo número em seu modelo de orçamento, não o primeiro.
O modelo barato tem a janela de contexto maior
Este é o detalhe que a maioria das coberturas de lançamento ignorou. Luna é lançado com uma janela de contexto de 1.000.000 tokens. Sol, vinte vezes mais caro, é lançado com 872.000.
Isso inverte uma suposição que muitos códigos de roteamento codificam: que você promove uma solicitação para um modelo mais caro quando o payload aumenta. Com o GPT-6, a maior janela da família fica na parte inferior da lista de preços. Um documento de 900.000 tokens não cabe no Sol, mas cabe no Luna.
A aritmética segue dos dois preços. Preencher a janela completa de Luna uma vez custa US$ 0,10 em tokens de entrada. Preencher a janela de 872.000 tokens de Sol uma vez custa aproximadamente US$ 1,74. Preencher a janela de 1M do Claude Opus 5.5 a US$ 4 por milhão custa US$ 4,00. Mesma classe de payload, uma diferença de quarenta vezes no que você paga para lê-lo.
Adicione o trabalho de cache da OpenAI por cima e a lacuna se alarga novamente. O GPT-6 aplica um desconto de 90% nas leituras de entrada em cache, então um prefixo de 1M de tokens que permanece em cache entre as chamadas custa cerca de US$ 0,01 para ser lido novamente, em vez de US$ 0,10. A OpenAI também diz que o GPT-6 obtém taxas de acerto de cache mais altas por padrão, que a alteração do esforço de raciocínio ou da disponibilidade da ferramenta não invalida mais o cache, e que os pontos de interrupção explícitos permitem controlar onde um prefixo em cache termina. O GitHub relata mais de 50% menos tokens de prompt precisando de processamento novo em bilhões de solicitações.
O que a OpenAI publicou
Cada número abaixo é do material de lançamento da OpenAI. As configurações de esforço de raciocínio aparecem entre parênteses, porque esses modelos pontuam de forma muito diferente em diferentes níveis de esforço e uma linha de benchmark sem sua configuração de esforço não é um número utilizável.
| Benchmark | GPT-6 Luna | Ponto de comparação |
|---|---|---|
| DeepSWE 1.1 | 66,6% (máx.) | Comparável a Claude Opus 5 e Claude Fable 5 no nível médio, 93% mais barato por tarefa que Opus 5 e 96% mais barato que Fable 5 |
| AutomationBench 1.0.6 | Supera seu predecessor em 5,4 pontos (alto) | Com 58% menos custo por tarefa |
| OSWorld 2.0 offline | Supera o GPT-5.6 Sol (médio) no esforço máximo | A aproximadamente um décimo do custo |
| Factualidade | Corresponde ao GPT-5.6 Sol em esforço maior | A aproximadamente um centésimo do custo |
A linha DeepSWE é a que merece atenção. Um modelo a US$ 0,10 por milhão de tokens de entrada pontuando 66,6% em um benchmark de engenharia de software agentiva, no mesmo território que dois modelos de fronteira com esforço médio, por 93% menos por tarefa do que um deles, é uma proposta diferente de uma camada de orçamento. Não significa que Luna substitui um modelo de fronteira em seu trabalho mais difícil. Significa que a fronteira entre “encaminhar isso para o modelo barato” e “isso precisa do caro” se moveu, e onde quer que você tenha traçado essa linha antes de setembro de 2026, agora está traçada no lugar errado.
O resultado de factualidade é o que mais provavelmente importará para o trabalho de produto comum. Corresponder à camada intermediária da geração anterior em precisão factual, por cerca de um centésimo de seu custo, é o que torna Luna viável para sumarização e extração voltadas para o usuário, em vez de apenas trabalhos em lote internos.
Toda comparação aqui é contra Claude Opus 5
Observe contra qual modelo Claude essas linhas de benchmark se comparam. Claude Opus 5.
A Anthropic lançou o Claude Opus 5.5 no mesmo dia, a US$ 4/US$ 20 contra US$ 5/US$ 25 do Opus 5, e ele conquistou a primeira posição no Índice de Inteligência de Análise Artificial com 58 pontos, classificando-se em primeiro lugar entre 212 modelos. A publicação de lançamento da OpenAI foi escrita antes da existência do Opus 5.5, então cada comparação de custo por tarefa contra o Opus 5 é medida contra um modelo que foi substituído horas após a publicação.
Isso não torna os números da OpenAI errados. Eles são precisos para a comparação que foi feita. Mas significa que você não deve levar “93% mais barato que Opus 5” para um documento de aquisição como o estado atual do mercado sem dizer a qual Opus se refere. Nenhum fornecedor publicou uma comparação direta de Luna contra Opus 5.5, e as comparações que circulam nas redes sociais vêm de testadores individuais, não de nenhum dos laboratórios. Nosso pilar de guerra de preços rastreia todos os três lançamentos uns contra os outros em uma tabela.
Latência: o modelo barato não é o modelo rápido
Medições de terceiros da Artificial Analysis colocam o GPT-6 Luna em 153,9 tokens de saída por segundo com um tempo para o primeiro token de 124,23 segundos. Duas ressalvas se aplicam e ambas são importantes. Esses são dados de terceiros, não publicados pelo fornecedor. E são medidos na variante de raciocínio máximo, a configuração mais lenta e cara disponível.
Mesmo com ambas as ressalvas, a direção vale a pena ser absorvida: Luna é mais lento para o primeiro token do que Sol, que mede 102,15 segundos. Preço e latência não estão correlacionados nesta família. Uma espera de dois minutos antes da chegada do primeiro token quebrará o timeout padrão de um cliente HTTP, inativará um balanceador de carga e excederá o limite de execução na maioria dos runtimes serverless. Se você estiver roteando um endpoint síncrono para Luna com alto esforço, o trabalho de integração reside na sua camada de timeout e streaming, e não no seu prompt.
Teste-o contra sua própria carga de trabalho antes de rotear para ele
Tabelas de benchmark são agregadas. Seu prompt não é. A pergunta útil é se Luna se mantém em seu tráfego em um nível de esforço que você pode pagar, e isso leva cerca de dez minutos para ser respondido corretamente.
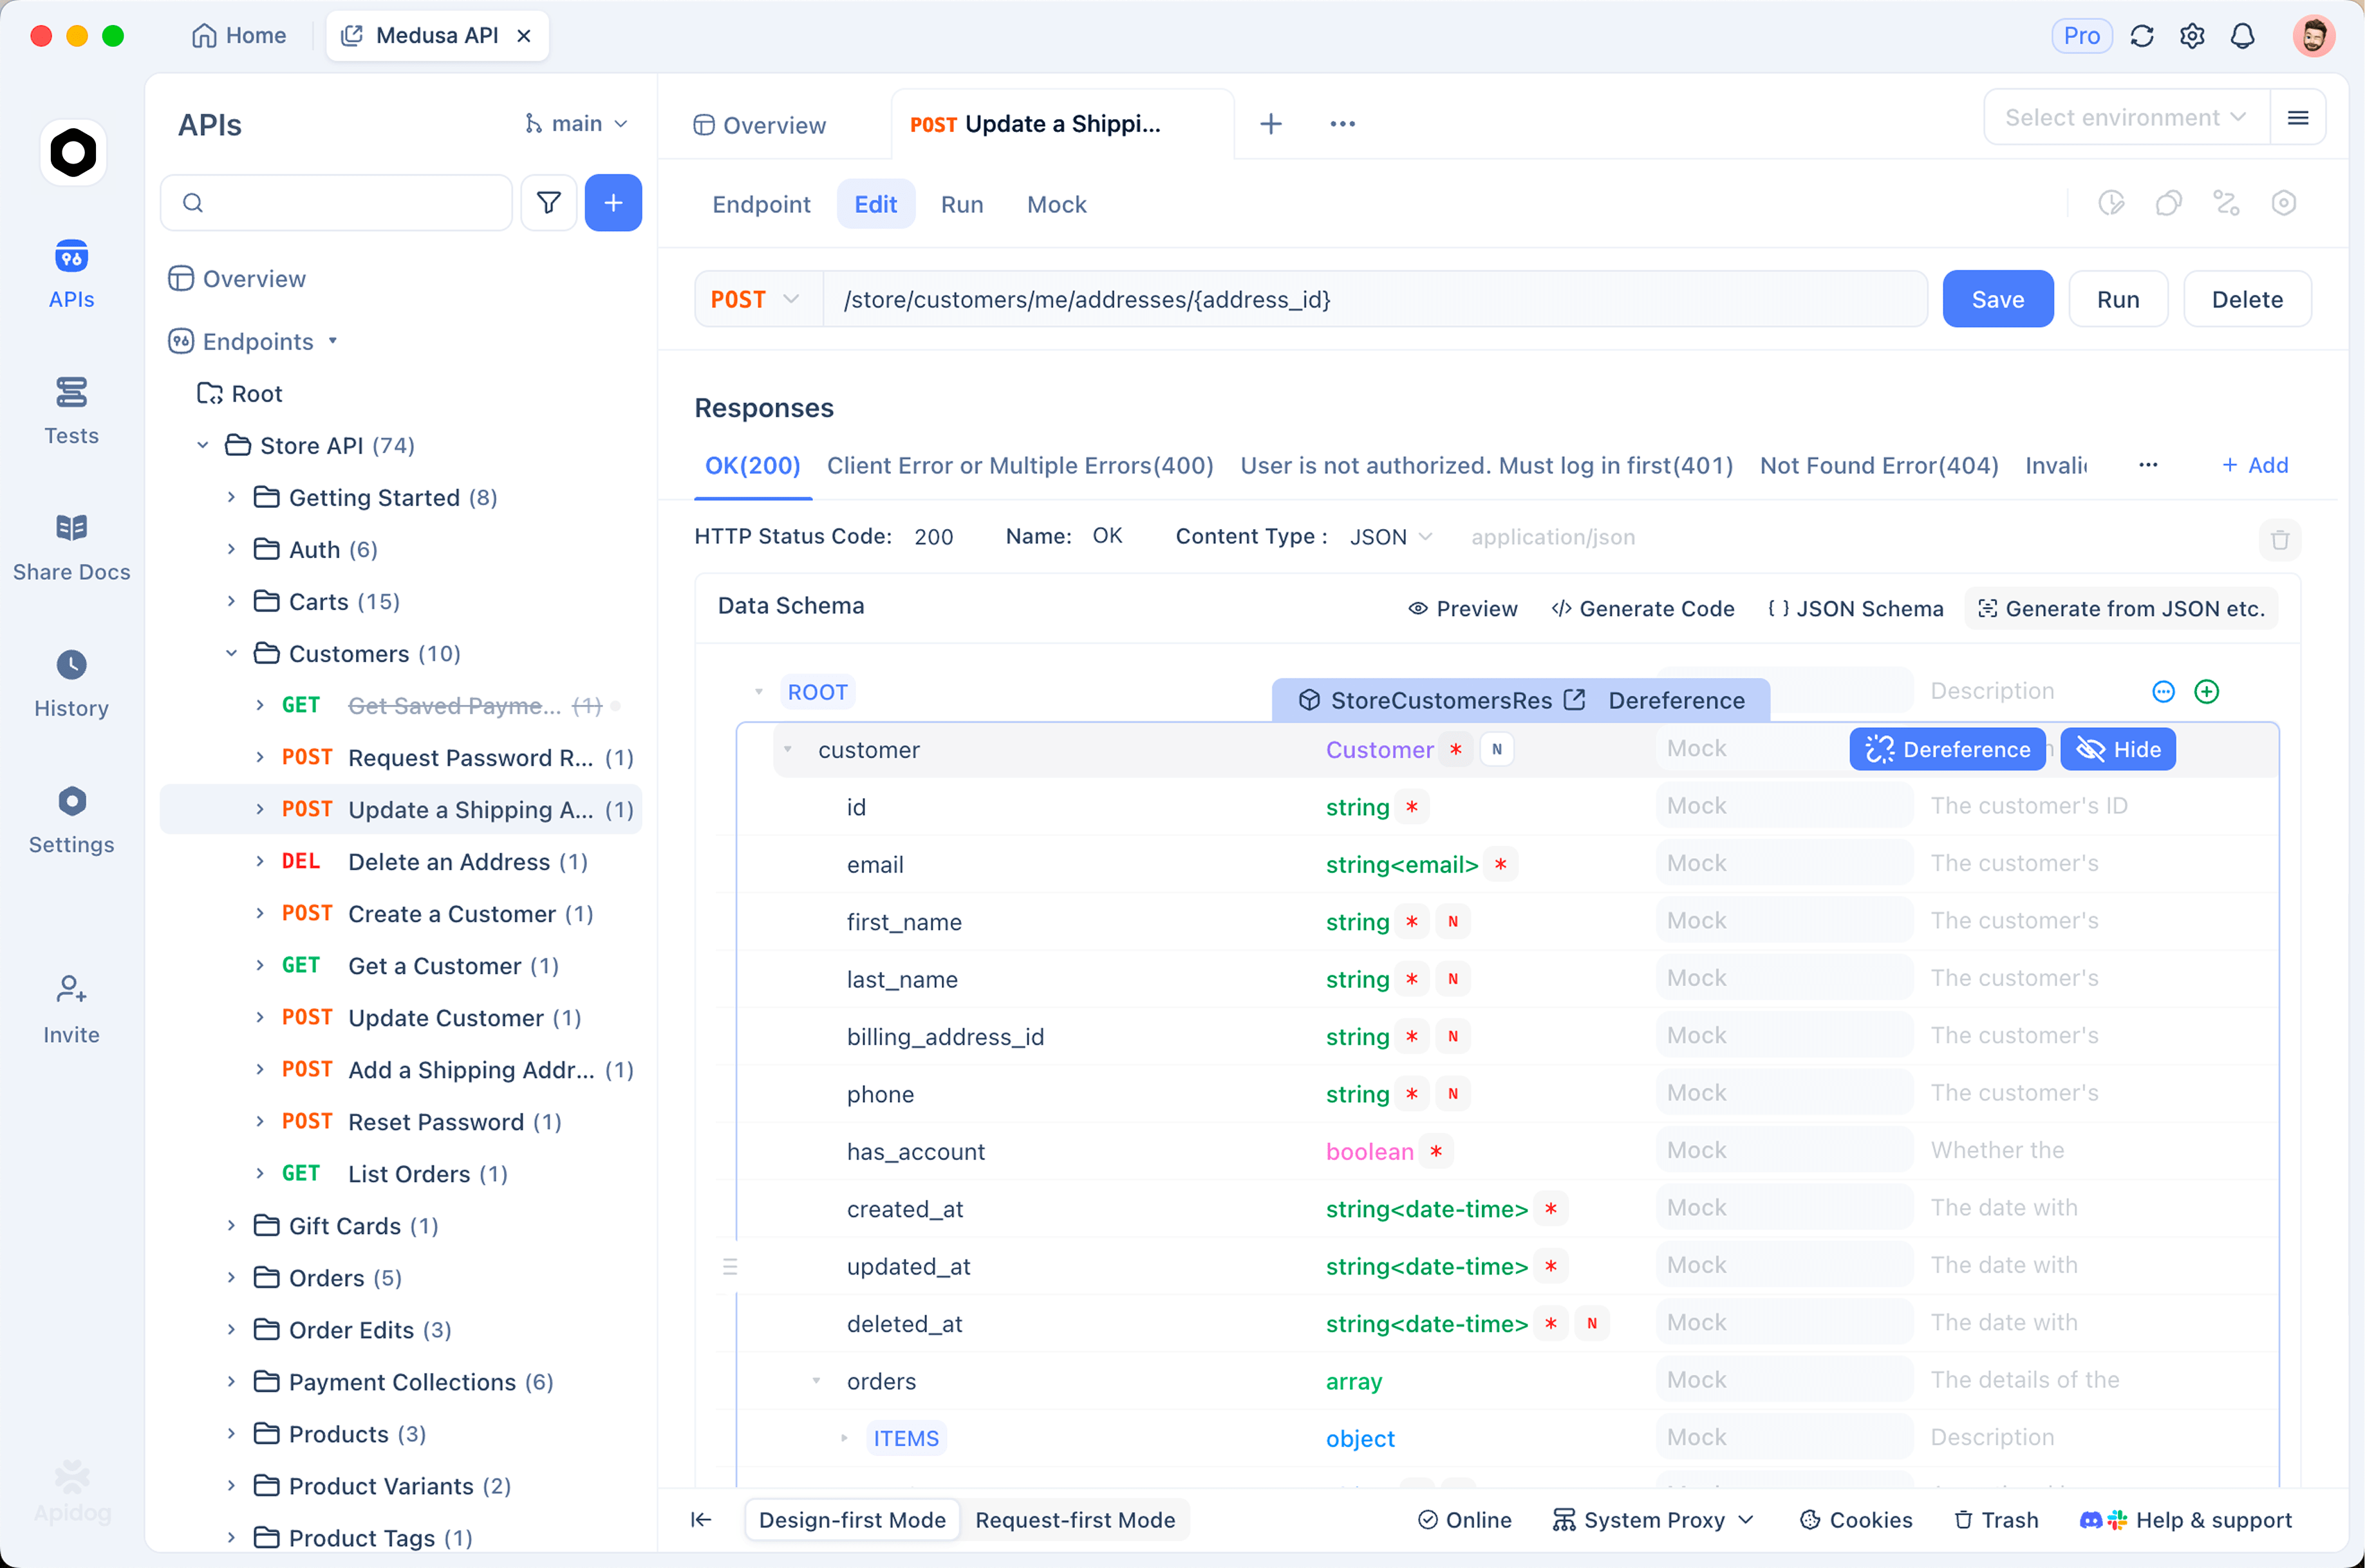
Configure uma solicitação por modelo, parametrize o ID do modelo e execute o mesmo payload em toda a camada:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "Extract every endpoint, method and required parameter from the OpenAPI document below as JSON.",
    "reasoning": { "effort": "high" }
  }'
Confirme os nomes do endpoint e dos parâmetros em relação à referência do modelo atual da OpenAI antes de construir com base nesta estrutura. O ID do modelo gpt-6-luna é a parte que é confirmada a partir do material de lançamento.
No Apidog, a mesma solicitação se torna um endpoint salvo com o ID do modelo como uma variável de ambiente, de modo que uma única coleção abrange Luna, Sol e Astra sem duplicar nada. Execute-o como um cenário de teste e você obterá o tempo de resposta e o uso de tokens por execução, além de asserções sobre o formato da resposta, que é o que detecta o verdadeiro modo de falha de um modelo mais barato: não uma resposta errada, mas uma resposta que deixa de estar em conformidade com o esquema JSON que seu parser espera. Execute o mesmo cenário em três níveis de esforço e você terá uma tabela de custo, latência e confiabilidade para seus próprios prompts, em vez de para o conjunto de benchmarks de outra pessoa.
Quando Luna é a escolha certa
Encaminhe para Luna quando o payload for grande, a tarefa for bem especificada e você puder verificar a saída programaticamente. Extração de documentos, análise de especificações, triagem de logs, geração de testes, classificação de alto volume e qualquer trabalho em lote onde uma janela de 1M economiza uma pipeline de chunking se qualificam, e o desconto de cache se potencializa quando um prefixo longo permanece estável entre as chamadas.
Mantenha a camada mais cara para trabalhos onde você não pode verificar a resposta de forma barata, e para qualquer coisa sensível à latência até que você tenha medido o tempo do primeiro token em seu próprio tráfego. Luna moveu a linha. Não a apagou.
button