
O GPT-6.2 Astra é o novo modelo de fronteira da OpenAI para trabalhos difíceis e de longa duração, lançado em 17 de novembro de 2026 junto com o GPT-6.2 Sol, um modelo mais barato para o dia a dia. O Astra custa US$ 8 de entrada e US$ 40 de saída por milhão de tokens; o Sol custa US$ 2 e US$ 10. Ambos compartilham uma janela de contexto de 1,05 milhão de tokens, 128K tokens de saída e os IDs de API gpt-6.2-astra e gpt-6.2-sol.
Então, o que é o GPT-6.2 Astra e vale a pena mudar? Resumindo: o Astra é 20% mais barato que o GPT-6 Astra e o supera nos gráficos da própria OpenAI, mas as primeiras avaliações dos desenvolvedores estão divididas. O Sol mantém o preço antigo e melhora na maioria dos testes. Este guia cobre o que cada modelo é, quanto custa, onde você pode usá-lo e como escolher entre eles.
O que é o GPT-6.2 Astra?
O GPT-6.2 Astra é o modelo topo de linha da OpenAI a partir de novembro de 2026, descrito no post de lançamento como seu "novo modelo de fronteira para os seus projetos mais difíceis". Ele substitui o GPT-6 Astra no topo da linha de modelos, raciocina em níveis de esforço configuráveis, aceita até 922K tokens de entrada e retorna até 128K tokens de saída. Sua data de corte de conhecimento é 18 de maio de 2026.
O Astra é o modelo que você escolhe quando uma tarefa é longa, com múltiplas etapas e erros custam caro: refatorações em uma base de código grande, execuções de agentes que duram horas, análises jurídicas ou científicas e uso de computador. A OpenAI o disponibiliza na API, no Codex e no ChatGPT Work.
Se você usou a geração anterior, o guia da API do GPT-6 Astra ainda descreve o formato das requisições. O ID do modelo é o principal ponto que muda.
O que é o GPT-6.2 Sol?
O GPT-6.2 Sol é o irmão eficiente, que a OpenAI chama de seu "modelo eficiente e versátil para o trabalho do dia a dia". Ele tem a mesma janela de contexto de 1,05 milhão de tokens e limite de saída de 128K que o Astra, uma data de corte de conhecimento um pouco mais recente (1º de junho de 2026) e um preço quatro vezes menor. A OpenAI diz que muitos de seus próprios funcionários usam o Sol como modelo padrão.
O Sol serve para assistentes de chat, pipelines de recuperação, classificação, revisão de código em diffs de tamanho normal e qualquer coisa que você chame milhares de vezes por dia. Ele é o sucessor do GPT-6.1 Sol, pelo mesmo preço de tabela.
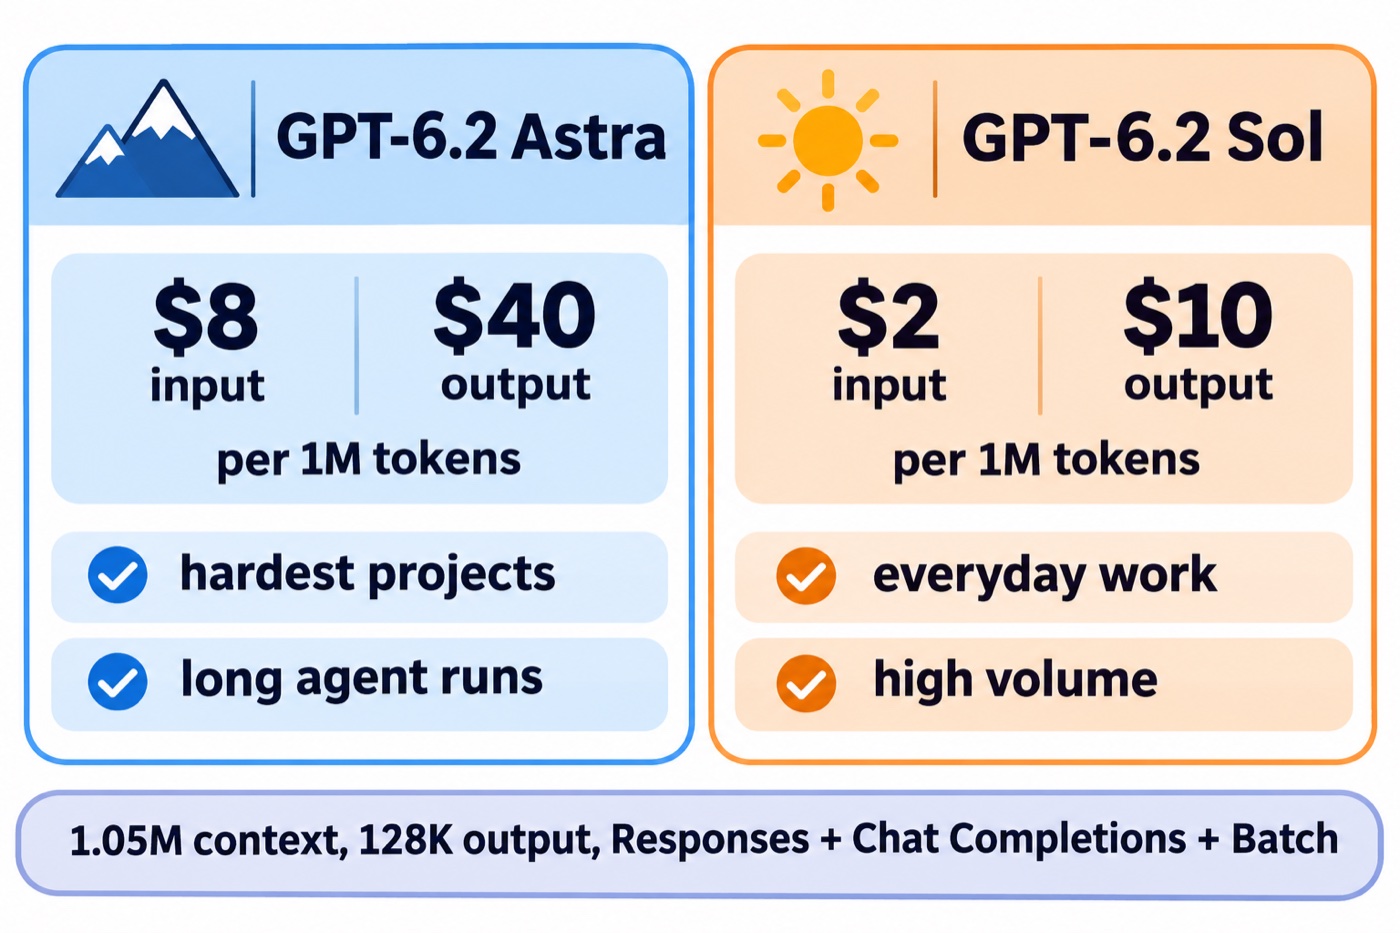
GPT-6.2 Astra vs GPT-6.2 Sol em resumo
Ambos os modelos vêm do mesmo lançamento e compartilham a maior parte da infraestrutura. As diferenças estão no preço, na data de corte e na intensidade com que cada um raciocina. Esses dados vêm das páginas de modelo da OpenAI para o GPT-6.2 Astra e o GPT-6.2 Sol, verificadas em 18 de novembro de 2026.
| Especificação | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| ID do modelo na API | gpt-6.2-astra |
gpt-6.2-sol |
| Entrada, por 1M de tokens | US$ 8,00 | US$ 2,00 |
| Entrada em cache, por 1M | US$ 0,40 | US$ 0,10 |
| Escritas de cache, por 1M (retenção de 30 min) | US$ 10,00 | US$ 2,50 |
| Saída, por 1M de tokens | US$ 40,00 | US$ 10,00 |
| Janela de contexto | 1.050.000 | 1.050.000 |
| Entrada máxima | 922.000 | 922.000 |
| Saída máxima | 128.000 | 128.000 |
| Corte de conhecimento | 18 de maio de 2026 | 1º de junho de 2026 |
| Endpoints | Responses, Chat Completions, Batch | Responses, Chat Completions, Batch |
Ambos os modelos rejeitam requisições que definem o esforço de raciocínio como none, portanto toda chamada faz algum raciocínio. Desenvolvedores que testaram no dia do lançamento os executaram com esforço high, xhigh e max.
Quanto custa o GPT-6.2 Astra?
O Astra custa US$ 8 de entrada e US$ 40 de saída por milhão de tokens. O GPT-6 Astra custava US$ 10 e US$ 50, então o novo modelo é 20% mais barato por token. O Sol permanece a US$ 2 e US$ 10, o mesmo preço do GPT-6.1 Sol e do GPT-6 Sol.
Alguns detalhes de preço importam mais que a taxa principal:
- Prompts longos custam mais. O VentureBeat relata que requisições acima de 272K tokens de entrada são cobradas a taxas mais altas, com o Astra subindo para US$ 16 de entrada e US$ 60 de saída.
- O Batch custa metade do preço para trabalhos que podem esperar, segundo o mesmo relato.
- Os modos Fast e Ultrafast custam mais: o Fast roda a duas vezes a taxa padrão e o Ultrafast começa a três vezes, acrescenta o VentureBeat.
- O nível de esforço determina a conta. O teste do dia de lançamento de Simon Willison desenhou a mesma imagem SVG com cada modelo. O Astra custou 11,55 centavos com esforço high e 88,71 centavos com max. O Sol custou 2,41 centavos com high e 13,69 centavos com max.
Esse último ponto é o que as equipes costumam ignorar. O preço por token é apenas metade da história; um modelo que raciocina por mais tempo gasta mais tokens. Meça o custo por tarefa concluída, não o custo por milhão de tokens.
Para uma análise mais aprofundada do dilema de custo entre as duas faixas na geração anterior, veja GPT-6 Astra para GPT-6 Sol: a migração.
Onde você pode usar o GPT-6.2 Astra e o Sol?
O anúncio de lançamento da OpenAI no fórum de desenvolvedores lista três lugares:
- A API, como
gpt-6.2-astraegpt-6.2-sol, nos endpoints Responses, Chat Completions e Batch. - Codex, no app desktop e na CLI, para usuários dos planos Plus, Pro, Enterprise e Edu.
- ChatGPT Work, para os mesmos planos. A OpenAI observa que este rollout não adiciona nenhum dos modelos ao Chat normal, e o acesso depende do plano, das permissões do workspace e do momento do rollout.
Assinantes do Pro 500 têm acesso ao Ultrafast em ambos os modelos. Assinantes do Pro 200 têm Ultrafast no Sol. Administradores de Enterprise e Edu podem ativá-lo para workspaces elegíveis.
Na API de Responses, ambos os modelos suportam pesquisa na web, busca de arquivos, geração de imagens, interpretador de código, shell hospedado, apply patch, skills, uso de computador, MCP e busca de ferramentas. Realtime, Assistants e fine-tuning não são suportados.
O que mudou em relação ao GPT-6 Astra?
Os gráficos de lançamento da OpenAI comparam o Astra com o GPT-6 Astra e o Sol com o GPT-6.1 Sol em nove benchmarks. O Astra vence todos os nove. O Sol vence oito e cai em um. Estes são os resultados que o VentureBeat transcreveu do post de lançamento:
| Benchmark | 6.2 Astra | 6 Astra | 6.2 Sol | 6.1 Sol |
|---|---|---|---|---|
| Agents’ Last Exam | 78,3% | 73,1% | 73,0% | 72,5% |
| Terminal-Bench-Science | 77,1% | 68,1% | 68,0% | 57,0% |
| BenchCAD 2.1 Core | 82,5% | 62,6% | 73,1% | 52,6% |
| AutomationBench | 52,4% | 41,4% | 41,2% | 36,1% |
| Vals Science Index | 68,4% | 65,1% | 58,5% | 59,6% |
Os números independentes são mais modestos. A Artificial Analysis coloca o Astra em 62 no seu Intelligence Index, cinco pontos acima do GPT-6 Astra e em segundo lugar, atrás do Claude Fable 5.2. A pontuação de coding agent do Astra não mudou, e a do Sol caiu três pontos.
A OpenAI também diz que ambos os modelos atingem seu limiar de segurança cibernética "Critical", então eles são lançados com salvaguardas mais rigorosas que a geração anterior.
Por que as primeiras avaliações estão divididas?
O lançamento atraiu críticas mais duras que a maioria dos lançamentos da OpenAI, como mostra o levantamento do VentureBeat. O desenvolvedor Theo Browne relatou que, em tarefas longas, o modelo "pode recrutar muitos subagentes" e depois trava em perguntas internas estranhas. Ethan Mollick chamou o Astra de "muito irregular & estranho" e mais difícil de direcionar. Dan Shipper disse que ele frequentemente parava cedo em builds de ponta a ponta.
Os elogios também são específicos. Browne creditou ao Astra uma forte revisão de código, trabalhos em 3D e uso de computador. Outros destacaram animação e edição de vídeo. Simon Willison achou a saída do Astra com esforço máximo a mais detalhada em seu teste, ao mesmo tempo em que observou que ele fica atrás do Fable 5.2 em vários benchmarks.
A conclusão prática: não troque seu modelo de produção no dia do lançamento porque um gráfico mudou. Execute seus próprios prompts contra ambos os modelos e compare os resultados que você realmente entrega.
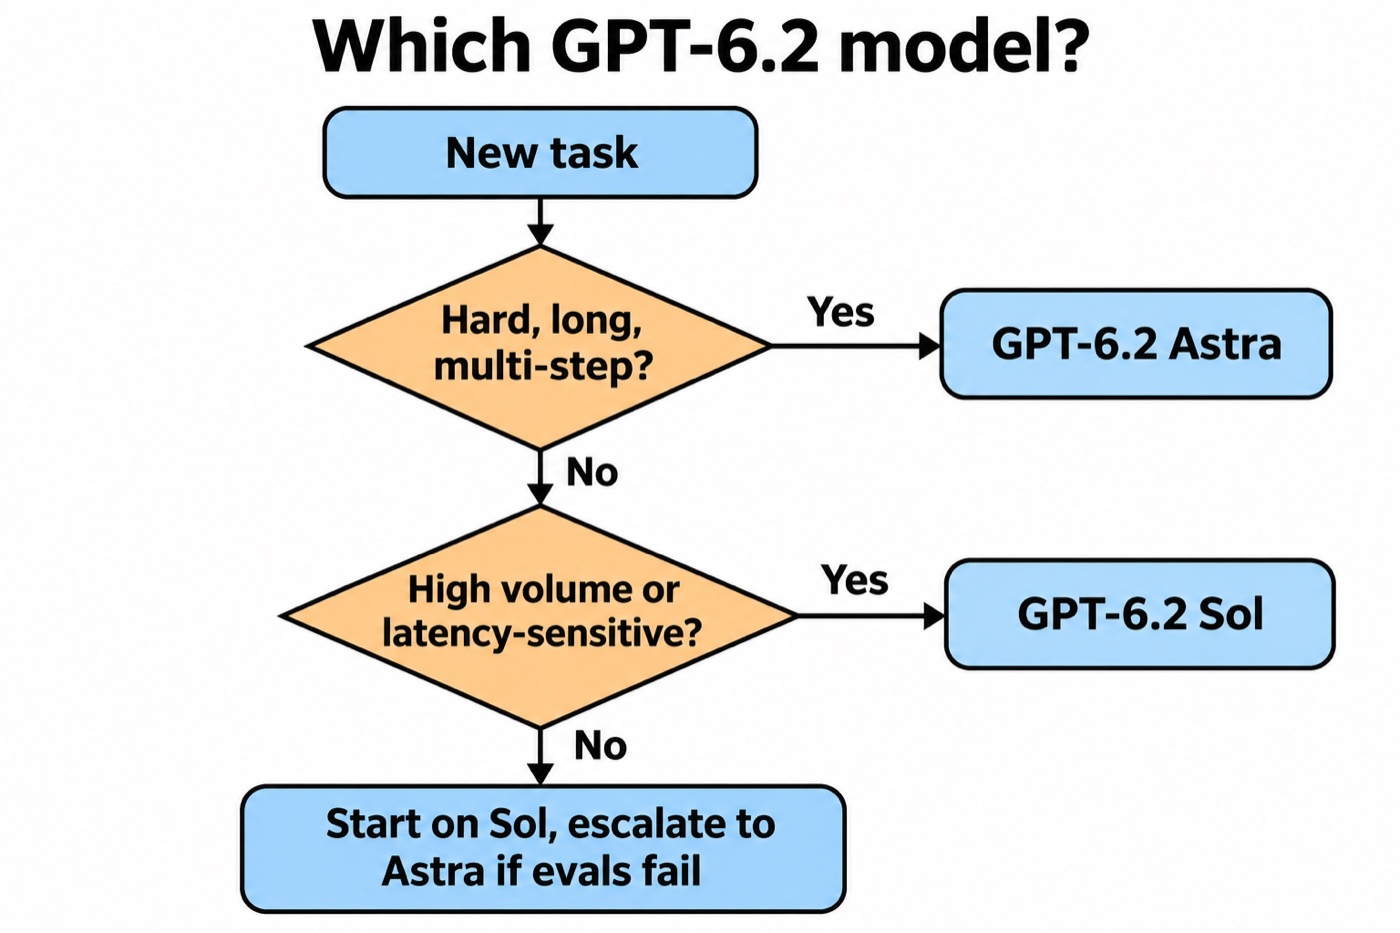
Qual você deve usar?
Escolha pela carga de trabalho e confirme com seus próprios evals:
- Use o GPT-6.2 Sol para chamadas de alto volume, chat, recuperação, extração e programação de rotina. Ele custa um quarto do preço e melhorou em oito dos nove benchmarks da OpenAI.
- Use o GPT-6.2 Astra para os 10% de tarefas mais difíceis: execuções longas de agentes, refatorações grandes, trabalhos com CAD e ciência, e uso de computador, onde uma resposta melhor economiza mais que o preço 4x.
- Comece no Sol e escale. Encaminhe uma requisição ao Astra apenas quando o Sol falhar em uma verificação. Isso mantém a maior parte do tráfego a US$ 2 e US$ 10.
Chamar qualquer um dos modelos é uma mudança de uma linha se você já usa a API de Responses:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.2-sol",
    "reasoning": { "effort": "high" },
    "input": "Summarize the breaking changes in this changelog."
  }'
Troque gpt-6.2-sol por gpt-6.2-astra para comparar. Mantenha o prompt, o nível de esforço e a entrada idênticos para que a comparação seja justa.
Deixe seu agente de código testar ambos os modelos com a Apidog CLI
Comparar dois modelos colando prompts em uma janela de chat não escala, e não detecta regressões no mês seguinte. Em vez disso, deixe seu agente de código escrever as verificações e executá-las com a Apidog CLI. Você escreve um prompt; o agente faz a configuração.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois, dê ao Claude Code, Codex ou Cursor um único prompt:
In Apidog project <projectId>, create a test case for POST https://api.openai.com/v1/responses
that sends the same prompt to gpt-6.2-sol and gpt-6.2-astra at "high" effort.
Assert status 200, that the response "model" field starts with the requested ID,
and that usage.output_tokens is under 4000. Run it against the <envId> environment
and summarize latency and token usage for each model.
O agente lê o schema do payload, valida seu arquivo, cria o caso de teste e o executa:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Armazene OPENAI_API_KEY como variável de ambiente na Apidog, não no prompt, para que a chave nunca fique no contexto do seu agente. Adicione --upload-report se quiser revisar a execução no app da Apidog depois.
O mesmo comando apidog run com -r junit se encaixa em um pipeline, para que a comparação seja executada novamente sempre que a OpenAI atualizar qualquer um dos modelos. O guia da Apidog CLI em CI/CD mostra a configuração, e o Apidog CLI no Codex cobre o lado do agente. O plano gratuito da Apidog cobre equipes de até 4 usuários.
FAQ
O que é o GPT-6.2 Astra em uma frase? É o modelo de fronteira da OpenAI para tarefas difíceis e de longa duração, lançado em 17 de novembro de 2026, com preço de US$ 8 de entrada e US$ 40 de saída por milhão de tokens e uma janela de contexto de 1,05 milhão de tokens.
O GPT-6.2 Astra é melhor que o GPT-6 Astra? Nos gráficos da OpenAI, sim: ele vence os nove benchmarks comparativos e custa 20% menos. Testes independentes mostram ganhos menores, e alguns desenvolvedores relatam que ele é mais difícil de direcionar em tarefas longas.
O GPT-6.2 Sol é gratuito? Não. O Sol custa US$ 2 de entrada e US$ 10 de saída por milhão de tokens na API. No ChatGPT, ambos os modelos estão no ChatGPT Work e no Codex para os planos Plus, Pro, Enterprise e Edu, não no Chat normal.
Qual é a janela de contexto do GPT-6.2 Astra? 1.050.000 tokens, com até 922.000 tokens de entrada e 128.000 tokens de saída. O Sol tem os mesmos limites.
Posso usar o GPT-6.2 Astra no Codex? Sim. Ambos os modelos estão no app desktop e na CLI do Codex para usuários dos planos Plus, Pro, Enterprise e Edu, e assinantes do Pro 500 podem usar o Ultrafast com qualquer um dos modelos.
Devo migrar do GPT-6.1 Sol para o GPT-6.2 Sol? Custa o mesmo preço, então a mudança é barata de testar. Execute seus próprios prompts em ambos primeiro: o Sol melhorou em oito dos nove benchmarks da OpenAI, mas caiu três pontos em uma pontuação independente de coding agent.