
O Gemini 4 Neon é o novo modelo intermediário do Google na família Gemini 4, lançado em 18 de novembro de 2026, para programação complexa, análise e fluxos corporativos de alta frequência. Custa US$ 3 por milhão de tokens de entrada e US$ 15 por milhão de tokens de saída, compartilha uma janela de contexto de 1 milhão de tokens com sua saída, oferece quatro níveis de raciocínio e está disponível apenas no nível pago da API do Gemini.
Se o Hydrogen parece leve demais para suas tarefas difíceis e o Carbono pesado demais para rodar o dia inteiro, o Neon é a resposta do Google. Veja o que foi lançado, onde ele se encaixa e o que ainda não está claro.
O que é o Gemini 4 Neon?
O Gemini 4 Neon (gemini-4-neon) é o nível de equilíbrio da família Gemini 4 do Google. O Google o descreve como “inteligência de fronteira com conclusão rápida de tarefas de ponta a ponta” para engenharia de software, trabalho do conhecimento e ciência. Ele fica entre o Gemini 4 Hydrogen, o modelo rápido do dia a dia, e o Gemini 4 Carbon, o modelo para seus projetos mais difíceis e de longo prazo.
Os fatos principais, do post de lançamento do Google e da página do modelo no AI Studio:
| Especificação | Gemini 4 Neon |
|---|---|
| ID do modelo | gemini-4-neon (estável) |
| Lançamento | 18 de novembro de 2026 |
| Entrada | Texto, imagem, vídeo, áudio, PDF |
| Saída | Apenas texto |
| Janela de contexto | 1.048.576 tokens, compartilhados entre entrada e saída |
| Saída máxima | 65.536 por solicitação, até 1.048.576 com long decode |
| Níveis de raciocínio | low, medium, high (padrão), xhigh |
| Preço (padrão) | US$ 3,00 entrada, US$ 15,00 saída por 1M de tokens |
| Entrada em cache | US$ 0,15 por 1M de tokens (apenas cacheamento implícito) |
| Nível gratuito da API | Não |
Ele suporta chamadas de função, saídas estruturadas, execução de código, uso de computador, busca de arquivos, contexto de URL e grounding com o Google Search e o Google Maps. Não gera imagens nem áudio e não está disponível na Live API.
Gemini 4 Neon vs Carbon vs Hydrogen
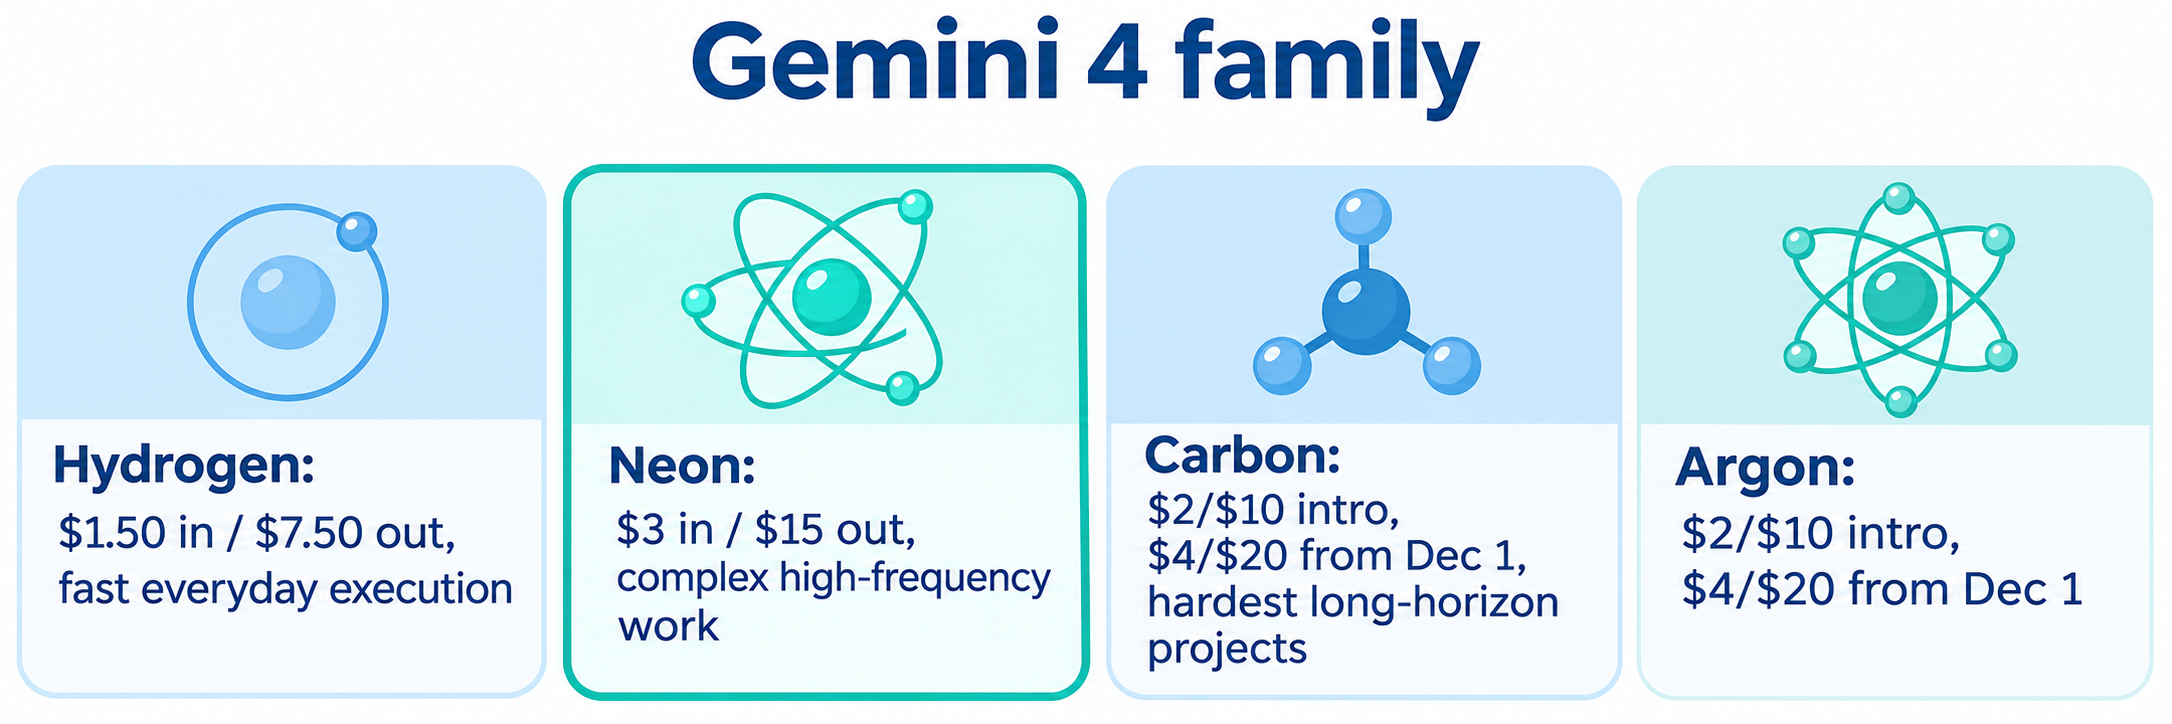
Em resumo: Hydrogen para volume, Neon para trabalho complexo de alta frequência, Carbon para os problemas únicos mais difíceis. O guia Novidades do Gemini 4 Neon do Google coloca assim: use o Neon para trabalhos complexos de engenharia e análise, o Carbon para seus problemas mais difíceis de arquitetura, depuração, ciência e segurança, e mantenha o Hydrogen como padrão para programação cotidiana e agentes.
| Modelo | Entrada / saída por 1M de tokens | Melhor para |
|---|---|---|
| Gemini 4 Hydrogen | US$ 1,50 / US$ 7,50 | Programação cotidiana rápida e etapas de agentes |
| Gemini 4 Neon | US$ 3,00 / US$ 15,00 | Programação e análise complexas de alta frequência |
| Gemini 4 Carbon | US$ 2 / US$ 10 introdutório, US$ 4 / US$ 20 a partir de 1º de dezembro | Projetos mais difíceis e de longo prazo |
| Gemini 4 Argon | US$ 2 / US$ 10 introdutório, US$ 4 / US$ 20 a partir de 1º de dezembro | Modelo de fronteira anterior da família Gemini 4 |
A precificação parece estranha por alguns dias. Até 30 de novembro, a taxa introdutória do Carbon fica abaixo do preço de tabela do Neon. A partir de 1º de dezembro, o Carbon dobra para US$ 4/US$ 20 (veja nossa análise de preços do Gemini 4 Carbon), e o Neon se torna o mais barato dos dois por token.
Preço por token não é a história toda. O Google afirma que o Neon em high custa 32% menos por tarefa que o Carbon porque conclui em menos etapas. A Artificial Analysis mediu um custo por tarefa cerca de 17% menor. Teste seus próprios prompts antes de confiar em qualquer um desses números.
Níveis de raciocínio do Gemini 4 Neon
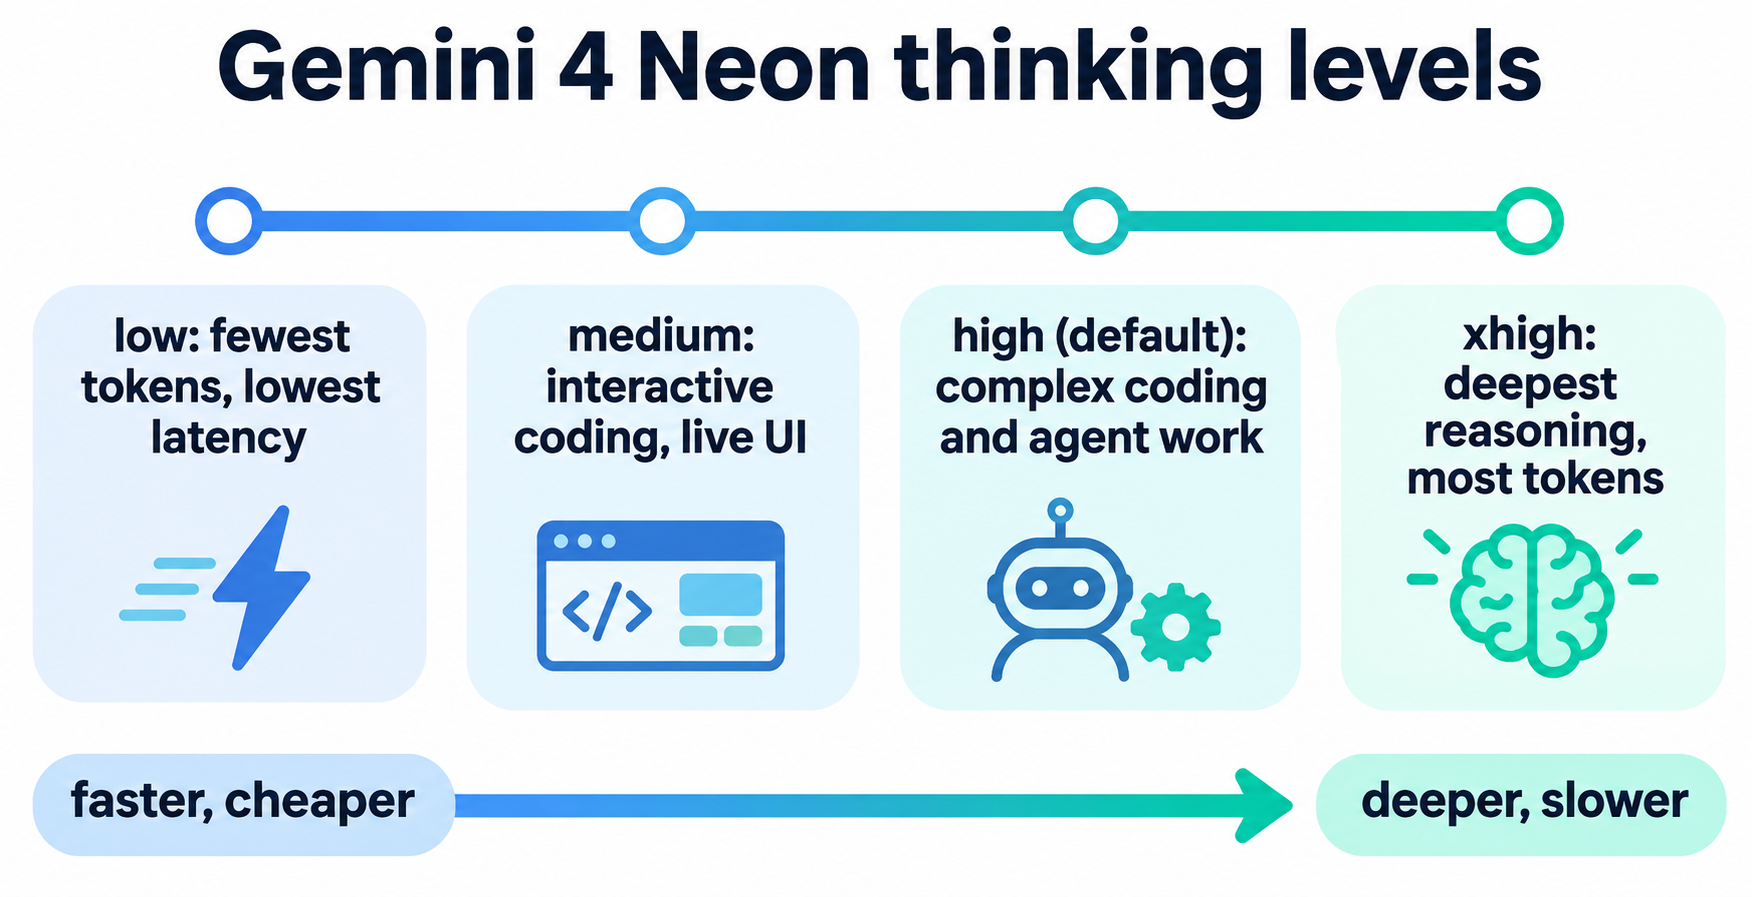
O nível de raciocínio é seu principal controle de qualidade, latência e custo. O Neon usa high como padrão, e o Google recomenda começar por ele:
low: menos tokens e menor latência, para chat rápido e processamento de alto rendimento.medium: programação interativa, prototipagem de UI em tempo real e chamadas de ferramentas sensíveis à latência.high(padrão): programação complexa, execução de agentes, chamadas de ferramentas e trabalho multimodal do conhecimento.xhigh: os problemas mais difíceis de engenharia, análise e ciência com múltiplas etapas, com maior latência e consumo de tokens.
Conselho do Google: avalie nos quatro níveis com um max_output_tokens alto e escolha o menor nível que atenda ao seu padrão de qualidade. Tokens de raciocínio são cobrados como saída, a US$ 15 por milhão.
Duas armadilhas de migração do guia de desenvolvedores do Google Cloud: o nível MINIMAL dos modelos Flash antigos não é suportado, e o antigo parâmetro thinking_budget retorna um HTTP 400 em vez de ser mapeado silenciosamente. Valores personalizados de temperature, top_k e top_p são ignorados, e frequency_penalty ou presence_penalty retornam um 400.
Benchmarks do Gemini 4 Neon
Todos os números abaixo vêm do post de lançamento do Google, que cita vários rankings independentes. Execuções independentes na sua própria carga de trabalho importam mais, mas estes mostram onde o Google mira o modelo:
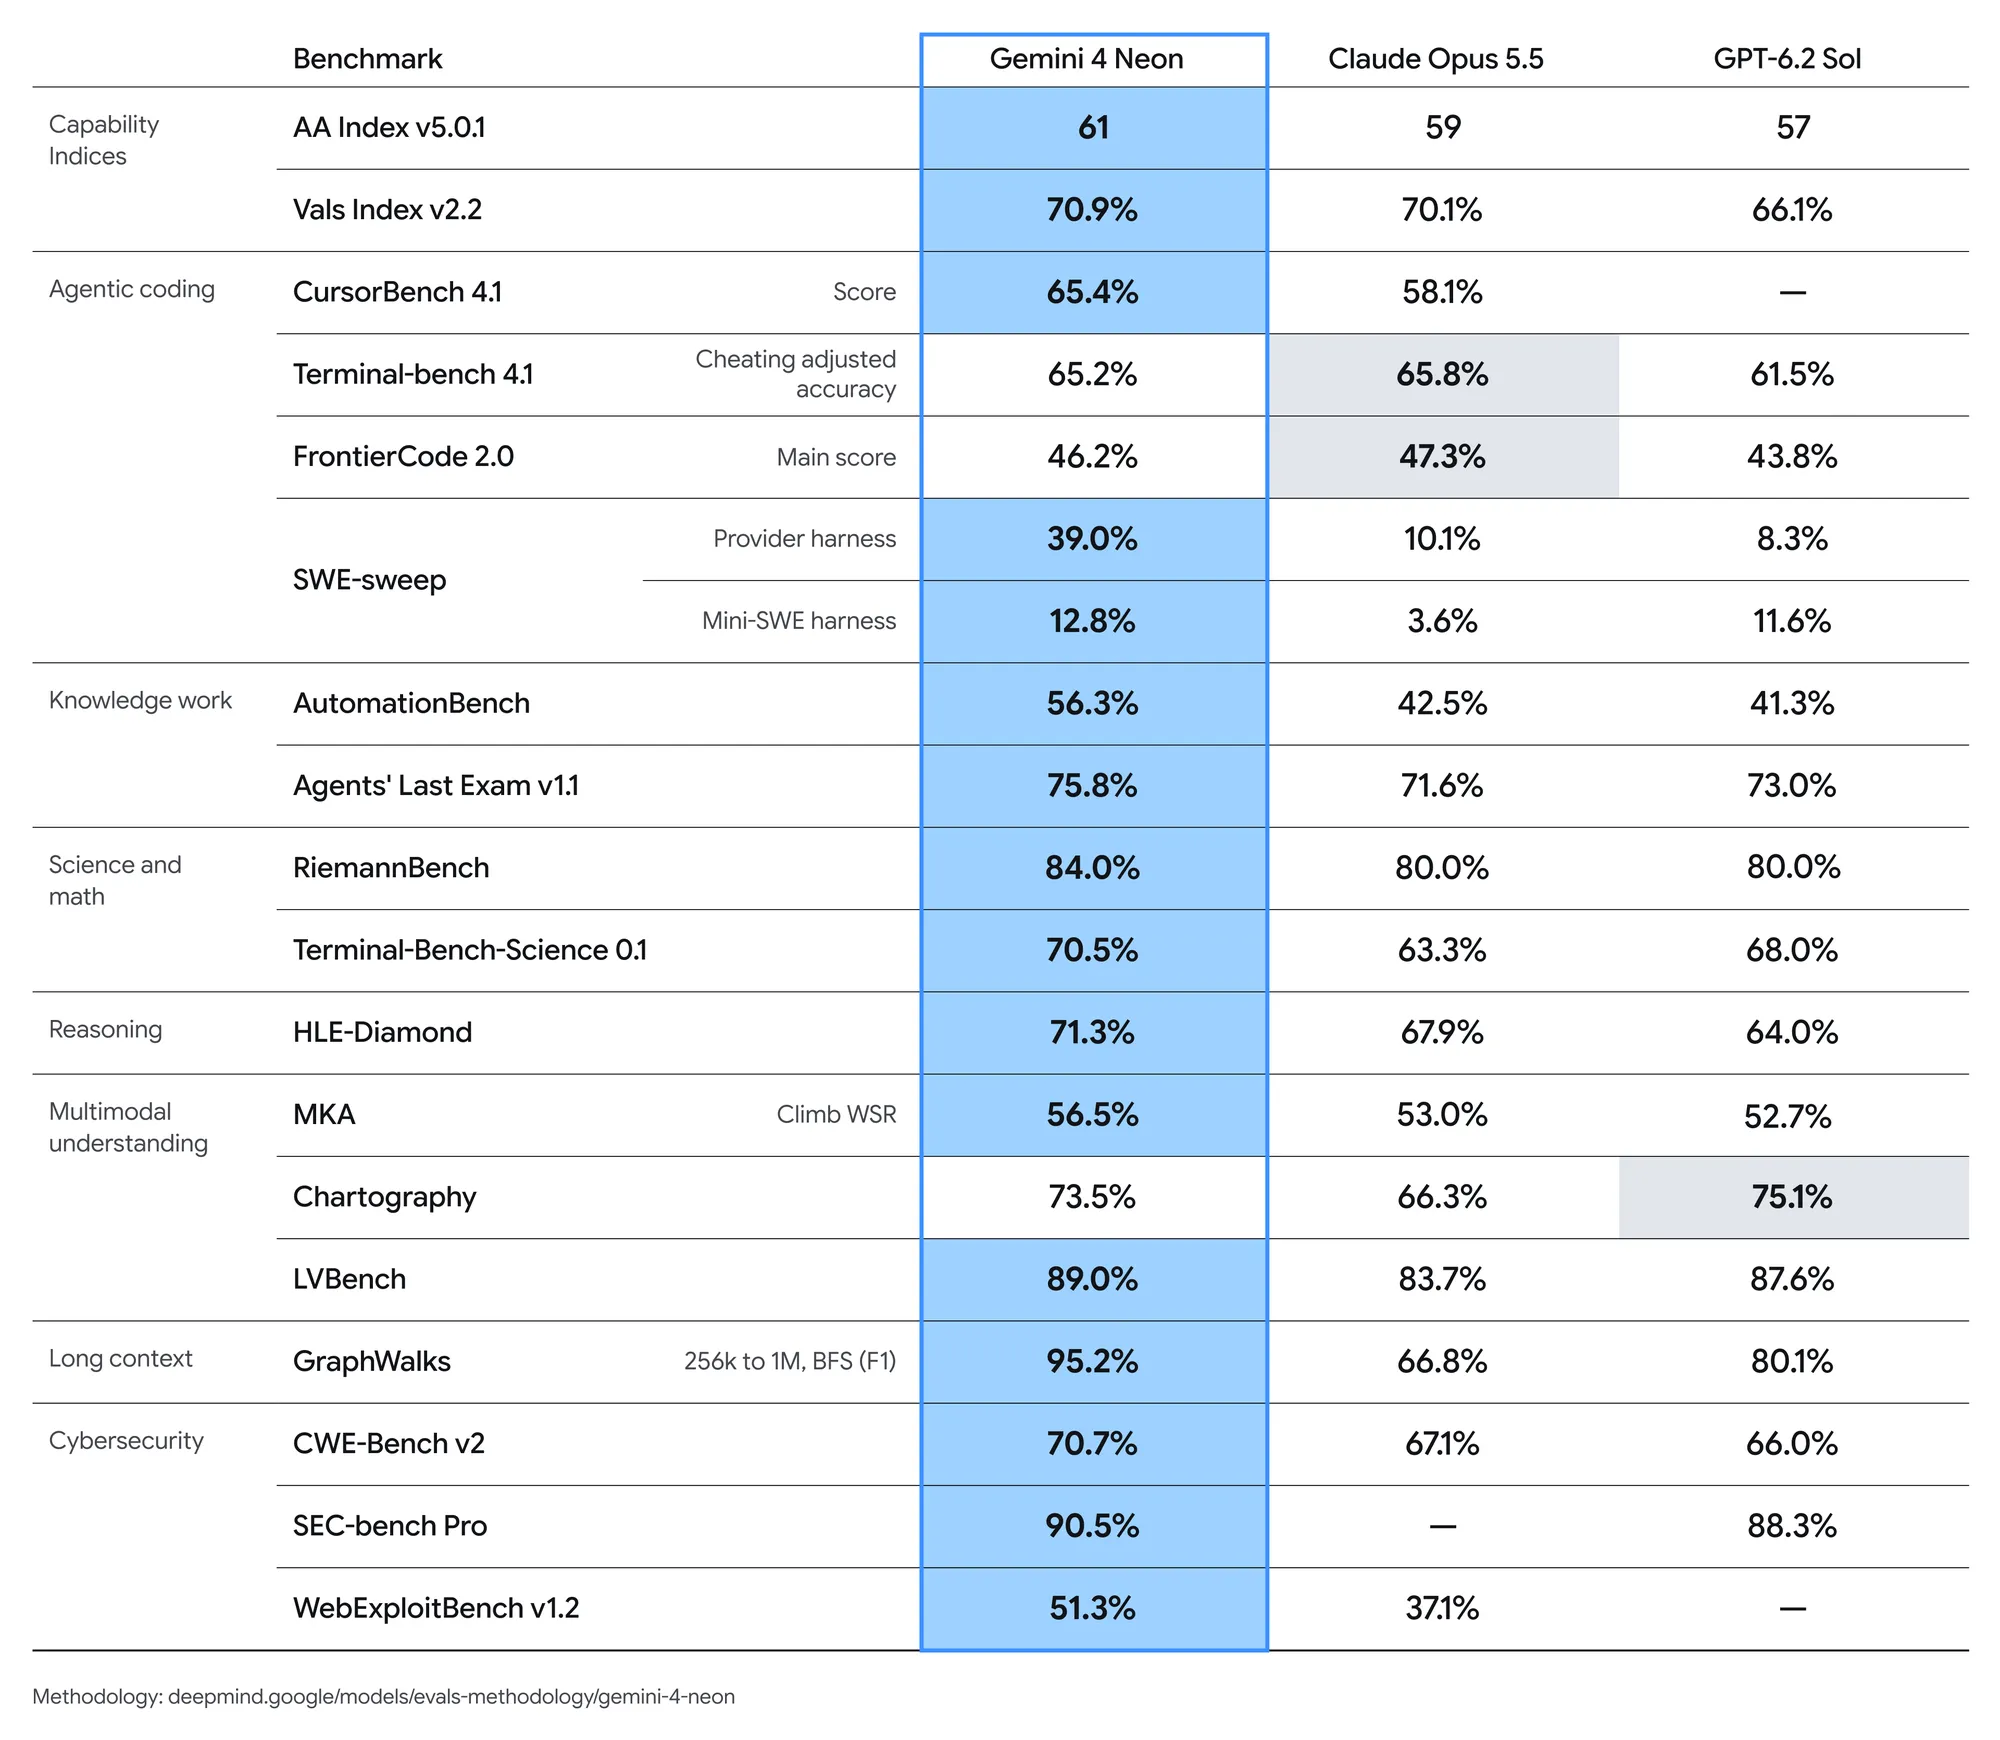
O Neon é otimizado para trabalho de agentes. O Google afirma que ele elimina leituras redundantes de arquivos, lida com a compactação de contexto em sessões longas e registrou sua menor taxa de alucinação até hoje em testes internos do Antigravity.
Onde o Neon não é o primeiro: no Índice de Inteligência da Artificial Analysis, o próprio Google admite que o Neon fica logo atrás de modelos maiores e mais lentos. A Vals AI colocou o Neon 0,4 pontos atrás do Claude Fable 5.2 em seu índice, com menos da metade do custo por tarefa. Para uma visão neutra, acompanhe a Artificial Analysis conforme mais execuções independentes forem publicadas.
Onde você pode usar o Gemini 4 Neon hoje
O Neon foi lançado no dia do lançamento em cinco superfícies:
- API do Gemini (nível pago) no Google AI Studio e no Android Studio, tanto em
generateContentquanto na API Interactions. - Gemini Enterprise Agent Platform no Google Cloud, no endpoint
globale nas multirregiõesuseeu. O Google diz que está disponível para clientes corporativos verificados em regiões selecionadas. - Google Antigravity para assinantes pagos do Google AI Pro e Ultra, onde pode orquestrar subagentes Hydrogen em paralelo.
- App Gemini para assinantes Pro e Ultra, onde agora alimenta o Tasks.
- Gemini for business por meio da API e do menu suspenso de modelos.
Não há nível gratuito da API: a página de preços do Google lista todas as linhas do Neon como “Indisponível” no nível gratuito. Assinantes Pro e Ultra podem experimentá-lo no AI Studio. Uma variante de defesa cibernética chega a defensores confiáveis pelo Fairwind Program do Google nos próximos dias.
Inferência Batch e Flex cortam o preço pela metade, para US$ 1,50 de entrada e US$ 7,50 de saída por milhão de tokens, se seus trabalhos podem esperar.
Neon como orquestrador
O Neon herda o padrão planejador-e-trabalhador que o Google introduziu com o Hydrogen. Você planeja ou verifica um fluxo de trabalho com o gemini-4-neon e, em seguida, passa previous_interaction_id para o gemini-4-hydrogen para que o modelo mais barato execute as etapas individuais. O guia do Cloud do Google mostra isso com a API Interactions:
from google import genai

client = genai.Client()

plan = client.interactions.create(
    model="gemini-4-neon",
    input="Design a 3-step plan to migrate our REST order service to gRPC in Go.",
    store=True,
)

step = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Implement step 1 (.proto service definition) from the plan.",
    previous_interaction_id=plan.id,
)
print(step.output_text)
O Neon gasta US$ 15 por milhão de tokens de saída em julgamento; o Hydrogen gasta US$ 7,50 em execução. Nosso guia do orquestrador Gemini 4 Hydrogen cobre a versão com Carbon desse ciclo.
Limitações e questões em aberto
Algumas coisas a saber antes de mover tráfego de produção:
- Sem cacheamento explícito. Apenas cacheamento implícito se aplica, em prefixos de prompt compartilhados de 4.096 tokens ou mais. Se você construiu sobre
cached_contentcom um modelo antigo, essa chamada precisará ser reescrita. - Saídas longas precisam de continuação. Uma solicitação retorna até 65.536 tokens. Além disso, você usa long decode, com execução em segundo plano ou um loop de continuação; chamadas REST diretas precisam do caminho
v1beta1no Google Cloud. - Todos os tokens são cobrados. Tokens de raciocínio, além das instruções internas de ferramentas e declarações de função que o Google adiciona quando você usa grounding, contam para sua fatura.
- Mudança de região para alguns usuários do Argon. Se você executava
gemini-4-argonemeurope-west2ouasia-southeast1, migre paraglobal,usoueu. - Limites de taxa. Verifique seu nível na página de limites de taxa da API do Gemini antes de planejar o throughput.
Teste o Gemini 4 Neon com o Apidog CLI e seu agente de programação
A verdadeira questão é se o Neon justifica seu preço em relação ao Hydrogen nos seus prompts. Deixe seu agente de programação responder isso com um teste repetível. Esta solicitação segue o formato documentado da API Interactions do Google; não a executamos ao vivo para este post:
MODEL="${GEMINI_MODEL:-gemini-4-neon}"

curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{\"model\": \"${MODEL}\", \"input\": \"Find the race condition in this retry queue.\", \"generation_config\": {\"thinking_level\": \"high\"}}"
O Apidog CLI dá ao Claude Code, Codex, Cursor ou OpenCode uma forma de linha de comando para criar e executar testes de API. Configure-o uma vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # escolha seu agente quando solicitado
Depois, dê ao seu agente um único prompt:
In Apidog project <id>, create an environment for the Gemini API with a MODEL
variable and a GEMINI_API_KEY variable. Add a test case for POST
/v1beta/interactions that sends the same coding prompt at thinking_level high,
asserts HTTP 200 and a non-empty output, and records response time and token
usage. Run it for gemini-4-neon and gemini-4-hydrogen and compare the results.
O agente cria o ambiente, valida o payload do caso de teste contra seu schema e o executa uma vez por modelo:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "MODEL=gemini-4-neon" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "MODEL=gemini-4-hydrogen" -r cli,json
Coloque o mesmo apidog run ... -r junit no CI com o guia de CI/CD do Apidog CLI, ou comece pelo Apidog CLI no Claude Code. O plano gratuito do Apidog cobre até 4 usuários.
Perguntas frequentes
Quando o Gemini 4 Neon foi lançado? Em 18 de novembro de 2026, o mesmo dia em que estreou na API do Gemini, no AI Studio, no Antigravity e no app Gemini.
Quanto custa o Gemini 4 Neon? US$ 3 por milhão de tokens de entrada, US$ 15 por milhão de tokens de saída (raciocínio incluído) e US$ 0,15 por milhão de tokens de entrada em cache. Batch e Flex custam metade: US$ 1,50 e US$ 7,50.
O Gemini 4 Neon é gratuito? Não na API. O Google não lista nível gratuito para o Neon. Assinantes do Google AI Pro e Ultra podem usá-lo no AI Studio, no app Gemini e no Antigravity como parte do plano.
O Gemini 4 Neon é melhor que o Gemini 4 Carbon? Para a maioria dos trabalhos frequentes e complexos, o Google diz que o Neon iguala ou supera ligeiramente o Carbon com um custo 32% menor por tarefa. O Google ainda recomenda o Carbon para seus problemas mais difíceis de arquitetura, depuração, ciência e segurança.
Qual é o ID do modelo do Gemini 4 Neon? gemini-4-neon. É um ID estável tanto na API do Gemini quanto no Gemini Enterprise Agent Platform do Google Cloud.