
O Gemini 4 Hydrogen é o modelo Gemini 4 rápido e de custo mais baixo da Google, lançado em 12 de novembro de 2026 e projetado para programação do dia a dia e trabalho com agentes. Custa US$ 1,50 por milhão de tokens de entrada e US$ 7,50 por milhão de tokens de saída em um contexto de 1 milhão de tokens, oferece quatro níveis de raciocínio (low, medium, high, xhigh) e está disponível no nível gratuito da API Gemini.
Se você usa o Gemini 3.8 Flash, o Hydrogen é a atualização recomendada pela Google. Se você paga pelo Carbon ou pelo Argon em etapas rotineiras, o Hydrogen foi feito para assumir essas tarefas. Veja o que foi lançado, como ele se encaixa no ecossistema e o que ainda permanece desconhecido.
O que é o Gemini 4 Hydrogen?
O Gemini 4 Hydrogen (gemini-4-hydrogen) é o nível de velocidade da família Gemini 4 da Google. A Google o chama de “motor do dia a dia para fluxos de trabalho agentivos”: um modelo que escreve código, chama ferramentas, executa testes e lê documentos rapidamente, seja de forma independente ou como motor de execução sob um modelo de fronteira como o Gemini 4 Carbon.
Os fatos principais, extraídos do post de lançamento da Google e do guia “Novidades” do AI Studio:
| Especificação | Gemini 4 Hydrogen |
|---|---|
| ID do modelo | gemini-4-hydrogen |
| Lançamento | 12 de novembro de 2026 |
| Preço pago | US$ 1,50 / 1M de entrada, US$ 7,50 / 1M de saída (preço fixo em todo o contexto) |
| Entrada em cache | US$ 0,075 / 1M de tokens com cache implícito |
| Janela de contexto | 1.048.576 tokens, compartilhados entre entrada, raciocínio e saída |
| Saída por requisição | 65.536 tokens de forma síncrona; até 1M com execução em segundo plano |
| Níveis de raciocínio | low, medium, high (padrão), xhigh |
| Entradas | Texto, imagens, PDFs, planilhas, gráficos, áudio, vídeo |
| Nível gratuito | Sim, com limites de taxa, no AI Studio e na API Gemini |
| APIs | generateContent e a API Interactions |
Os tokens de saída incluem os tokens de raciocínio, portanto uma requisição em xhigh custa mais do que a mesma requisição em low, mesmo quando a resposta visível tem o mesmo tamanho.
Hydrogen vs Carbon vs Argon: onde ele se encaixa
Os três modelos Gemini 4 compartilham o mesmo contexto unificado de 1M, o design de decodificação longa e as ferramentas integradas. Eles se diferenciam em quanto raciocinam por turno e quanto custam.
| Hydrogen | Argon | Carbon | |
|---|---|---|---|
| Função | Execução rápida, programação do dia a dia | A maioria das tarefas de longo prazo, com menos tokens que o Carbon | Modelo de fronteira mais poderoso |
| Raciocínio padrão | high |
medium |
medium |
| Raciocínio máximo | xhigh |
high |
high |
| Limite sem streaming | 65.536 tokens | 32.768 tokens (REST) | 32.768 tokens (REST) |
| Recomendação da Google | Caminho de atualização a partir do 3.8 Flash | Tarefas longas avançadas | Arquitetura complexa, segurança, ciência |
A própria orientação da Google é combiná-los: deixe o Carbon planejar interfaces ou desvendar um bug difícil e, em seguida, entregue ao Hydrogen as edições de código, o trabalho paralelo de subagentes e a execução de testes. A troca de modelos dentro de uma mesma conversa funciona por meio do previous_interaction_id na API Interactions, sem alterações no esquema de requisições.
Para uma comparação mais detalhada entre os dois modelos de fronteira, leia Gemini 4 Carbon vs Argon. Para os custos, consulte as análises de preços do Carbon e preços do Argon.
Os quatro níveis de raciocínio
O nível de raciocínio do Hydrogen é seu principal controle sobre velocidade, qualidade e custo. Ele é definido pelo campo thinking_level, e a Google recomenda começar com o padrão e mudar apenas quando seus testes de avaliação indicarem.
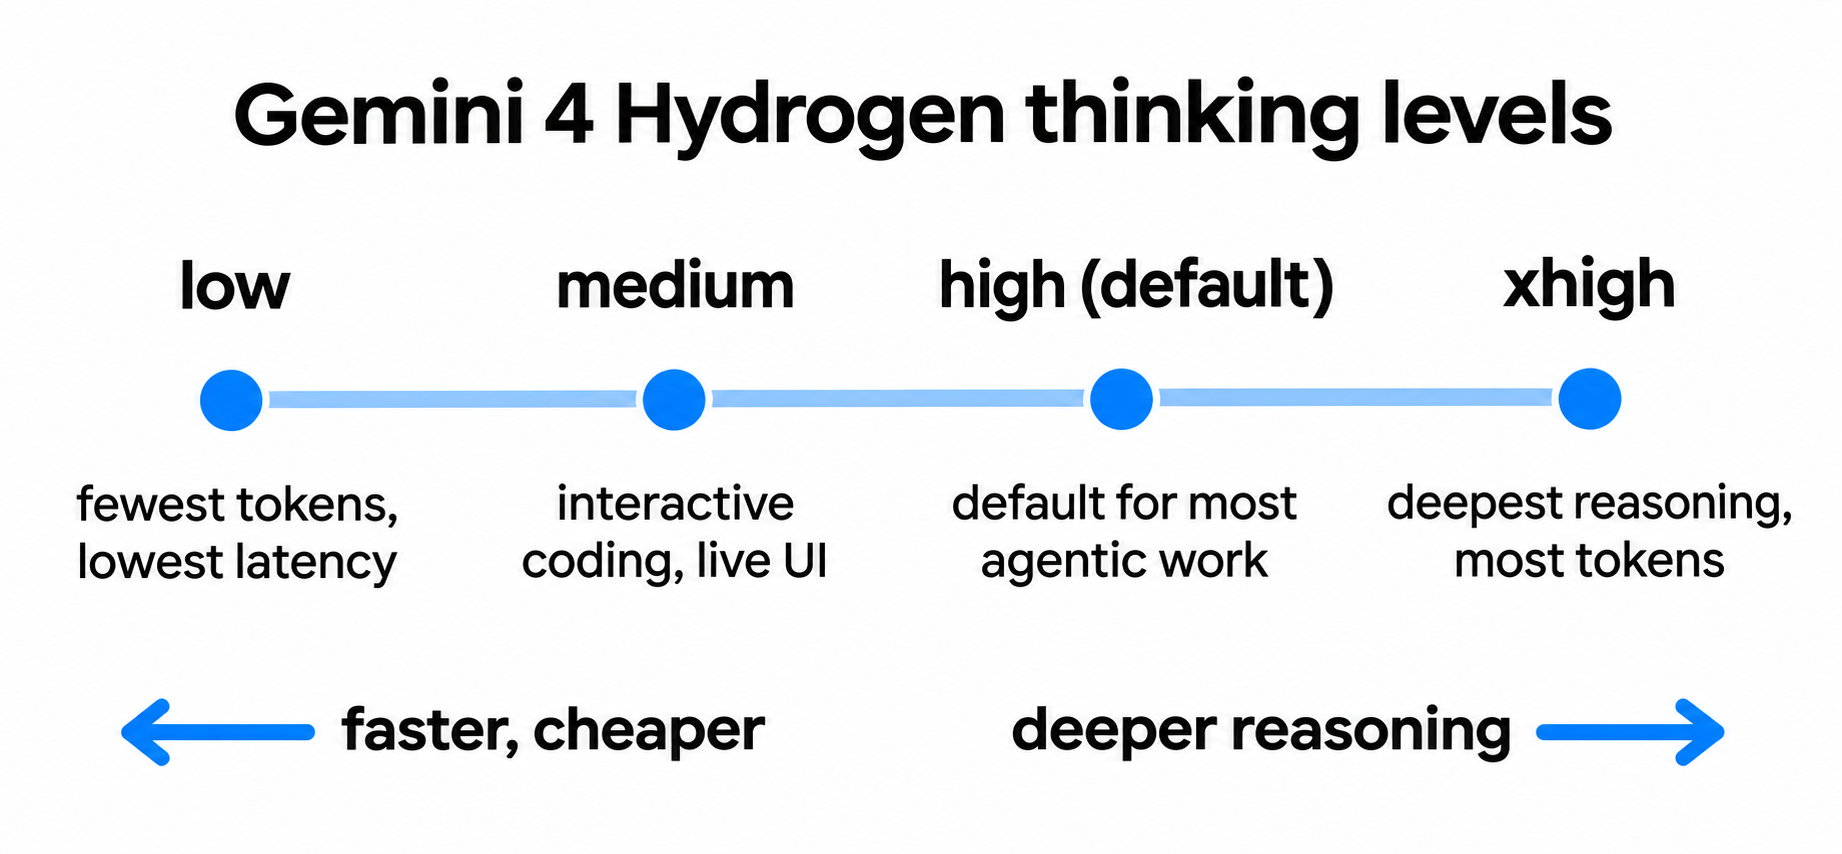
low: menos tokens, menor latência. Chat rápido e processamento de alto volume.medium: programação interativa, prototipagem de UI em tempo real e chamadas de ferramentas sensíveis à latência.high(padrão): programação complexa, execução agentiva, chamadas de ferramentas e trabalho com documentos multimodais.xhigh: novidade do Hydrogen. Problemas difíceis de múltiplas etapas em que ohighnão é suficiente.
A Google alerta que o xhigh pode raciocinar demais em prompts simples, adicionando latência e tokens sem produzir uma resposta melhor. A recomendação: execute sua suíte de avaliações nos quatro níveis com um max_output_tokens generoso e escolha o nível mais baixo que atenda ao seu padrão de qualidade. Se você está migrando do 3.8 Flash, saiba que o Hydrogen rejeita minimal com um erro e usa high como padrão, em vez de medium. O guia de preços do Hydrogen detalha o custo de cada nível.
Benchmarks do Gemini 4 Hydrogen
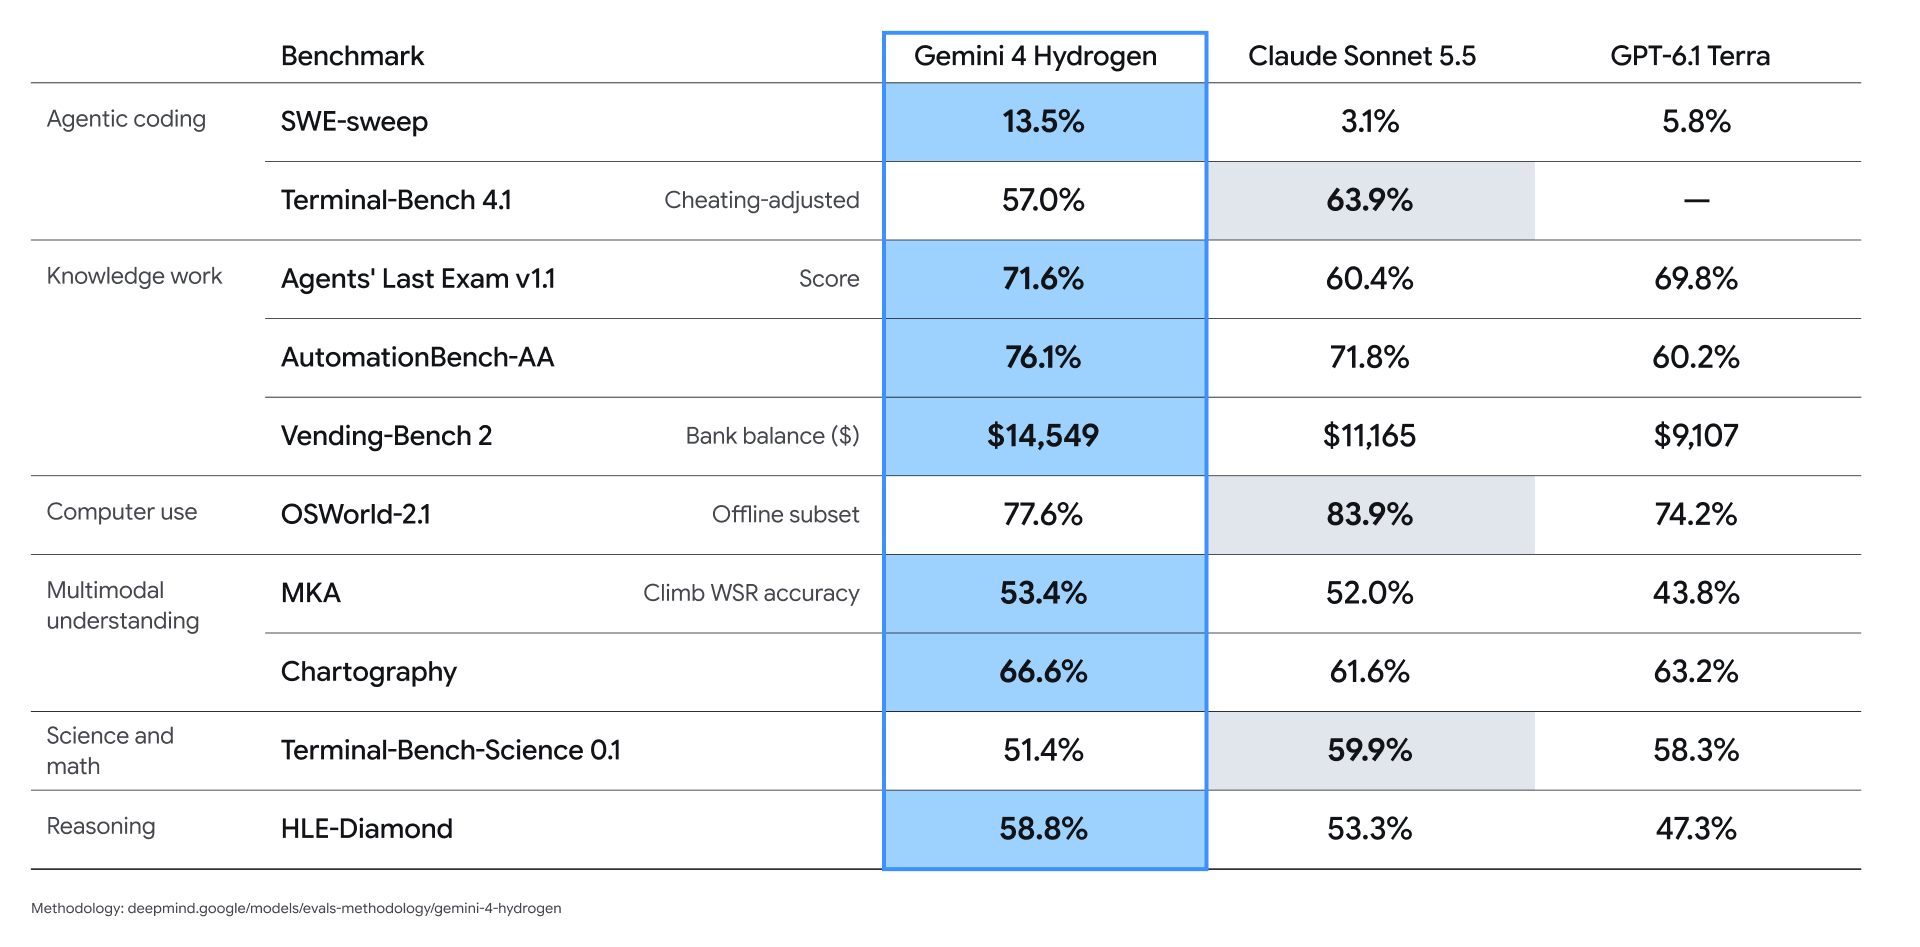
Todos os números abaixo são da Google, publicados no lançamento. A replicação independente era escassa um dia após o lançamento, portanto trate-os como alegações do fornecedor.
Contra o Argon e suas próprias configurações
- Índice de Inteligência da Artificial Analysis: 51 em
high, à frente dos 50 do Argon, e 54 emxhigh.
Contra o Gemini 3.8 Flash
- 2,5x mais rápido no padrão
high. - Terminal-Bench 4.1: 57% vs 18,2%.
- Mais de 5x menos alegações fabricadas.
- Parceiros de lançamento relatam execuções 2x a 2,8x mais rápidas e 12% a 23% menos tokens em workloads de grafos, SQL e com grande volume de dados.
Trabalho agentivo e por domínio
- HLE-Diamond: 58,8%, o que segundo a Google lidera sua categoria.
- Vals Tax Agent Bench: 1º lugar com 52,3%.
- Vals Legal Research Bench: empate em 1º lugar com 55,8%.
- Agent Arena (arena.ai): 5º lugar.
- Multimodal Knowledge Agent (MKA): 53,4%.
- Agents’ Last Exam v1.1: 71,6%.
Segurança, segundo a Google
- Até 81% menos excesso de intervenção e até 79% menos subatendimento em tarefas agentivas.
- 12x menos ações desalinhadas e atalhos em tarefas nas avaliações de uso de ferramentas e programação.
- 96,7% na avaliação interna de honestidade de agentes da Google.
- Mais de 2,3x mais resistente à injeção indireta de prompts no benchmark Gray Swan IPI.
O padrão geral importa mais do que qualquer pontuação isolada: o Hydrogen praticamente iguala o Argon em inteligência geral e representa um salto grande em relação ao 3.8 Flash em programação agentiva. Teste-o no seu próprio workload antes de confiar nele. O model card traz as notas completas de avaliação da Google.
Onde você já pode usar o Gemini 4 Hydrogen
A Google lançou o Hydrogen em produtos de desenvolvimento, negócios e consumo no dia do lançamento:
- API Gemini, Google AI Studio e Android Studio: todos os níveis, gratuitos e pagos. O nível gratuito tem limites de taxa; o guia gratuito do Hydrogen cobre o que você obtém sem cadastrar cartão.
- Gemini para empresas: via API, no seletor de modelos, no Antigravity e no Gemini no Google Sheets para planos empresariais elegíveis.
- App Gemini: no seletor de modelos. Usuários gratuitos têm acesso ao Hydrogen apenas por meio da seleção automática de modelo, quando o Gemini decide que ele é adequado ao prompt.
- Google Search: gerando respostas para todos os usuários.
- Google Sheets: começando com assinantes do Google AI Pro e Ultra.
- Google Antigravity: para assinantes pagos do Google AI Pro e Ultra.
O Hydrogen também é agora o modelo padrão por trás do agente Antigravity no Gemini Managed Agents, então qualquer pessoa que chamar esse agente pela API já está usando o Hydrogen, a menos que configure outro modelo.
Orchestrator: Hydrogen e Carbon em uma mesma sessão
O Orchestrator é uma nova opção de modelo no Google Antigravity que alterna entre Carbon e Hydrogen dentro de uma mesma tarefa, em ambas as direções. O Carbon explora e planeja, o Hydrogen escreve edições, atualiza pacotes e executa testes e, quando o Hydrogen encontra obstáculos, devolve o controle ao Carbon para corrigir o plano. Ele substitui o roteador estático que estima a dificuldade uma única vez com base no seu primeiro prompt.
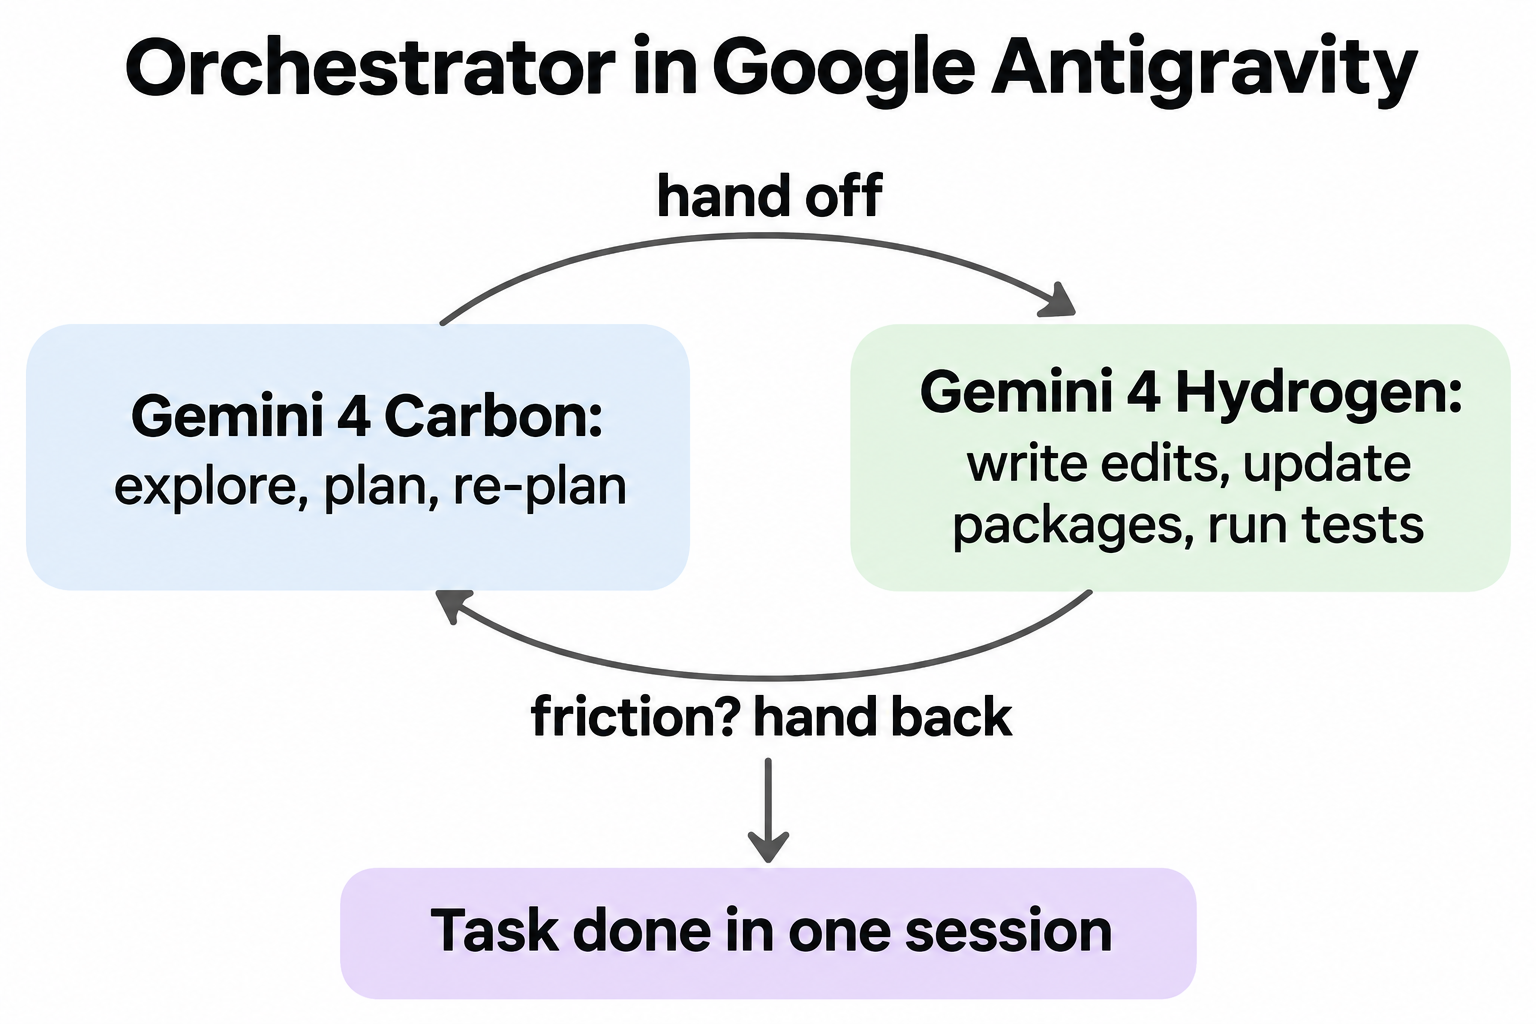
No Terminal-Bench, a Google afirma que o Orchestrator alcançou taxas de sucesso próximas às do Carbon usando 24% menos cota e concluindo em média 19% mais rápido. Vale notar que os dois posts de lançamento da Google citam versões diferentes do benchmark para esse resultado (4.0 no post principal, 4.1 no post do Antigravity).
A disponibilidade é segmentada por plano. Assinantes Ultra têm acesso ao Orchestrator (Carbon) e ao Orchestrator (Argon); assinantes pagos do plano Pro têm acesso ao Orchestrator (Argon). Se preferir definir os papéis você mesmo, o SDK do Antigravity permite atribuir agentes Hydrogen e Carbon explicitamente. O guia do Gemini 4 Hydrogen Orchestrator vai mais a fundo.
Limitações e questões em aberto
Um dia após o lançamento, planeje levando em conta o seguinte:
- Os benchmarks são autorreportados. Todos os números acima vêm da Google ou de seus parceiros de lançamento.
- Sem cache explícito.
cachedContentsecaches.createnão são suportados; aplica-se apenas o cache implícito em prompts de 4.096 tokens ou mais. - Parâmetros de amostragem são ignorados.
temperature,top_petop_knão têm efeito, então não é possível ajustar a aleatoriedade dessa forma. - Os limites do nível gratuito ficam em uma página separada. A Google direciona para sua página de limites de taxa em vez de listar os números do Hydrogen no guia de lançamento.
- O Orchestrator é exclusivo do Antigravity. Não há Orchestrator no nível da API; no seu próprio código, você faz o roteamento entre modelos por conta própria.
Teste o Gemini 4 Hydrogen com a Apidog CLI e seu agente de programação
Para decidir se o Hydrogen pode substituir o 3.8 Flash, execute a mesma requisição em ambos e compare os resultados. Deixe seu agente de programação fazer isso, para que a troca se torne um resultado de teste, não um palpite. Esta requisição segue o formato generateContent documentado pela Google; não a executamos em produção para este post:
MODEL="${GEMINI_MODEL:-gemini-4-hydrogen}"

curl -s "https://generativelanguage.googleapis.com/v1beta/models/${MODEL}:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"contents": [{"parts": [{"text": "List three checks a CI job should run before a release."}]}]}'
A Apidog CLI oferece ao Claude Code, Codex, Cursor ou OpenCode uma forma de criar e executar testes de API pela linha de comando. Configure uma vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois, dê ao seu agente um único prompt:
In Apidog project <id>, create an environment for the Gemini API with a MODEL
variable set to gemini-4-hydrogen and a GEMINI_API_KEY variable. Add a test case
for POST /v1beta/models/{MODEL}:generateContent that asserts HTTP 200, a non-empty
candidates array, and that usageMetadata is present. Run it for gemini-4-hydrogen
and gemini-3.8-flash and compare response time and token counts.
O agente cria o ambiente, valida o payload do caso de teste contra seu esquema e o executa uma vez por modelo:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "MODEL=gemini-4-hydrogen" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "MODEL=gemini-3.8-flash" -r cli,json
Adicione o mesmo apidog run ... -r junit ao seu CI com o guia de CI/CD da Apidog CLI, ou comece pelo Apidog CLI no Claude Code. Para exemplos completos de requisições, veja o guia da API do Gemini 4 Hydrogen. O plano gratuito da Apidog cobre até 4 usuários.
Perguntas frequentes
O Gemini 4 Hydrogen é gratuito? Sim, dentro de certos limites. A Google lista o Hydrogen no nível gratuito da API Gemini e no Google AI Studio, com limites de taxa. O uso pago custa US$ 1,50 por milhão de tokens de entrada e US$ 7,50 por milhão de tokens de saída.
Qual é o ID do modelo Gemini 4 Hydrogen? gemini-4-hydrogen. Funciona tanto com generateContent quanto com a API Interactions.
O Gemini 4 Hydrogen é melhor que o Gemini 4 Argon? Pelos números da Google, o Hydrogen pontua 51 no Índice de Inteligência da Artificial Analysis em high, contra 50 do Argon, e 54 em xhigh. O Argon ainda é posicionado para a maioria das tarefas avançadas de longo prazo, então teste ambos no seu próprio workload.
O que é o nível de raciocínio xhigh? É um quarto nível de raciocínio, novidade do Hydrogen, acima do padrão high. Gasta o máximo de tokens para o raciocínio mais profundo. A Google recomenda usá-lo apenas em problemas difíceis de múltiplas etapas em que o high não é suficiente.
O Gemini 4 Hydrogen substitui o Gemini 3.8 Flash? A Google o apresenta como a atualização recomendada a partir do 3.8 Flash. Troque o ID do modelo, aumente quaisquer limites baixos de max_output_tokens, remova o cache explícito e os parâmetros de amostragem e teste novamente seu nível de raciocínio.
Posso usar o Orchestrator pela API Gemini? Não. O Orchestrator é uma opção de modelo dentro do Google Antigravity para assinantes pagos do AI Pro e Ultra. Na API, você mesmo faz o roteamento entre Carbon e Hydrogen, por exemplo com previous_interaction_id entre turnos.