
O Gemini 4 Argon é o novo modelo de fronteira do Google, anunciado em 30 de setembro de 2026, e está disponível hoje apenas para defensores do Fairwind Program, um grupo selecionado de parceiros de defesa cibernética. O Google o precifica em US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída durante um período introdutório, depois US$ 4 e US$ 20, e aumenta o limite de saída para 1 milhão de tokens por resposta. Não há API pública, ID de modelo publicado e nenhuma data de lançamento ainda.
Este guia é o centro da nossa cobertura do Argon: o que o Google confirmou e o que não confirmou, onde o Argon se encaixa na linha Gemini, quem o receberá em seguida, quanto custa, como ele se compara em benchmarks e o que você pode construir hoje. Escolhendo um modelo agora? Leia nossa comparação Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5. Se você testa APIs de modelos no Apidog, a última seção mostra como fazer a mudança para o Argon com uma alteração de um único valor.
O que o Google confirmou versus o que não confirmou
A maioria da cobertura inicial mistura declarações do Google com suposições de terceiros. Aqui está a divisão, com base na publicação de lançamento e na metodologia de avaliação do Google.
| Item | Status | O que sabemos |
|---|---|---|
| Anúncio | Confirmado | 30 de setembro de 2026, por Koray Kavukcuoglu do Google DeepMind |
| Acesso hoje | Confirmado | Um conjunto de parceiros do Fairwind Program |
| Próximos na fila | Confirmado, sem data | Clientes de API pagantes e assinantes do Google AI Ultra |
| Preço | Confirmado | US$ 2/US$ 10 introdução, depois US$ 4/US$ 20 por 1 milhão de tokens; entrada em cache com 95% de desconto |
| Limite de saída | Confirmado | 1 milhão de tokens, acima dos 64 mil |
| Benchmarks | Confirmado, relatado pelo Google | Uma tabela de 19 linhas mais um PDF de metodologia |
| ID do modelo | Não publicado | Strings online são placeholders de terceiros |
| Janela de contexto de entrada | Não publicado | A avaliação de contexto longo do Google usou prompts de até 1 milhão de tokens |
| Corte de conhecimento | Não publicado | Nada do Google |
| Duração do período introdutório | Não publicado | Nenhuma data para a mudança para US$ 4/US$ 20 |
| Limites de taxa, camada gratuita | Não publicado | Nada do Google |
| Data de lançamento | Não publicado | "Assim que possível" |
Se um site lista uma janela de contexto, uma string de modelo ou um número de velocidade para o Argon, trate-o como não confirmado até que a documentação do próprio Google o mostre.
O que é o Gemini 4 Argon e onde ele se encaixa
O Argon é o único modelo Gemini 4 anunciado até agora e o novo topo da linha do Google. O Google o chama de "nosso novo modelo de fronteira", construído "para sustentar um raciocínio profundo em fluxos de trabalho complexos e de longo horizonte", e afirma desempenho de fronteira em engenharia de software, trabalho de conhecimento empresarial como jurídico e financeiro, e defesa cibernética. Um porta-voz do Google disse à Reuters que o Argon é maior que a linha anterior de modelos "Pro" da empresa.
Até agora, o principal modelo de API Gemini era o gemini-3.1-pro-preview, ainda em Visualização: 1.048.576 tokens de entrada, 65.536 tokens de saída (os "64K" que o Argon substitui), e US$ 2 de entrada / US$ 12 de saída por milhão para prompts de até 200K. O preço introdutório de saída do Argon de US$ 10 o supera. O Google não disse se o Argon terá um nível de prompt longo separado como o 3.1 Pro, ou se outros modelos Gemini 4 virão. A Reuters descreveu o lançamento como ocorrendo "após meses de atrasos", uma referência ao lançamento do Gemini 3.5 Pro que foi prometido para junho e posteriormente descartado.
O Google já executa o Argon internamente. Ele afirma que milhares de funcionários o usam para codificação, pesquisa e escrita, que agentes Argon liberaram mais de 300 TiB de memória da frota, e que está migrando código C e C++ para Rust, até mais de 800 mil linhas para o kernel Fuchsia Zircon, com essas reescritas ainda sob auditoria antes da produção.
Quem pode usar o Gemini 4 Argon hoje e quem será o próximo
Hoje: um subconjunto de parceiros Fairwind. O Fairwind é o programa de defesa cibernética de acesso limitado do Google com mais de 650 parceiros, mas apenas "um conjunto de parceiros do Fairwind Program" obtém o Argon, por si só ou dentro do CodeMender, o agente de segurança de código do Google. Acessado diretamente "como um modelo gerenciado no Gemini Enterprise", ele suporta retenção zero de dados. Os parceiros devem se comprometer com MFA resistente a phishing, acesso limitado a equipes internas de segurança, resposta a incidentes ou testes de penetração, e rastreamento de uso por funcionário. Governos, operadores de infraestrutura crítica e plataformas de tecnologia central podem se inscrever na página do Fairwind Program.
Em seguida: clientes de API pagantes e assinantes do Google AI Ultra. O Google irá "coletar feedback dos primeiros testadores à medida que iteramos nas salvaguardas" primeiro, e está participando do processo voluntário de acesso pré-lançamento do governo dos EUA. A seção de lançamento da postagem é intitulada "Em breve" e não dá uma data. Nosso guia de data de lançamento e acesso rastreia cada etapa.
Ainda não: todos os outros. Em 1º de outubro, a página de modelos da API Gemini, a página de preços, o aplicativo Gemini, Antigravity e OpenRouter não mostram o Argon. Um plano Google AI Ultra (a partir de US$ 99,99 por mês nos EUA) é uma assinatura de consumidor, não uma chave de API, e o Google não disse qual nível Ultra receberá o Argon primeiro. Não há rota gratuita; o Gemini 4 Argon é gratuito aborda o que você pode usar em vez disso.
Preços do Gemini 4 Argon
| Tipo de token | Introdução (por 1 milhão) | Após introdução (por 1 milhão) |
|---|---|---|
| Entrada | US$ 2,00 | US$ 4,00 |
| Entrada em cache (95% de desconto) | US$ 0,10 | US$ 0,20 |
| Saída | US$ 10,00 | US$ 20,00 |
| Uma resposta completa de 1 milhão de tokens, apenas saída | US$ 10,00 | US$ 20,00 |
O Google não informou por quanto tempo o período introdutório dura. Nas taxas padrão, o Argon custa exatamente o mesmo que o Claude Opus 5.5; nas taxas introdutórias, ele se iguala ao GPT-6.1 Sol e ao Claude Sonnet 5.5. Os preços em cache são calculados a partir da regra de 95% do Google. Cenários trabalhados estão em Preços do Gemini 4 Argon.
O limite de saída de 1 milhão
O Google afirma que está "expandindo significativamente o limite de tokens de saída do modelo para um impressionante 1 milhão de tokens, acima dos 64 mil tokens anteriores". O argumento: com espaço para gerar centenas de milhares de tokens em uma única trajetória, o modelo pode resolver problemas difíceis de uma só vez. Para comparação, GPT-6 Astra, Claude Opus 5.5 e Claude Fable 5.1 cada um limita a saída síncrona a 128 mil.
Duas ressalvas. Este é um limite de saída, não uma janela de contexto; o Google não publicou a janela de entrada. E embora o Google diga que o limite de saída do Argon é de 1 milhão de tokens, pelo menos um avaliador de terceiros, Vals AI, lista um máximo de saída de 262 mil para a configuração que testou. Planeje com base no limite que seu endpoint relatar. Nosso guia para os 1 milhão de tokens de saída do Argon aborda tempos limite, streaming e limites de custo.
Benchmarks do Gemini 4 Argon: a manchete
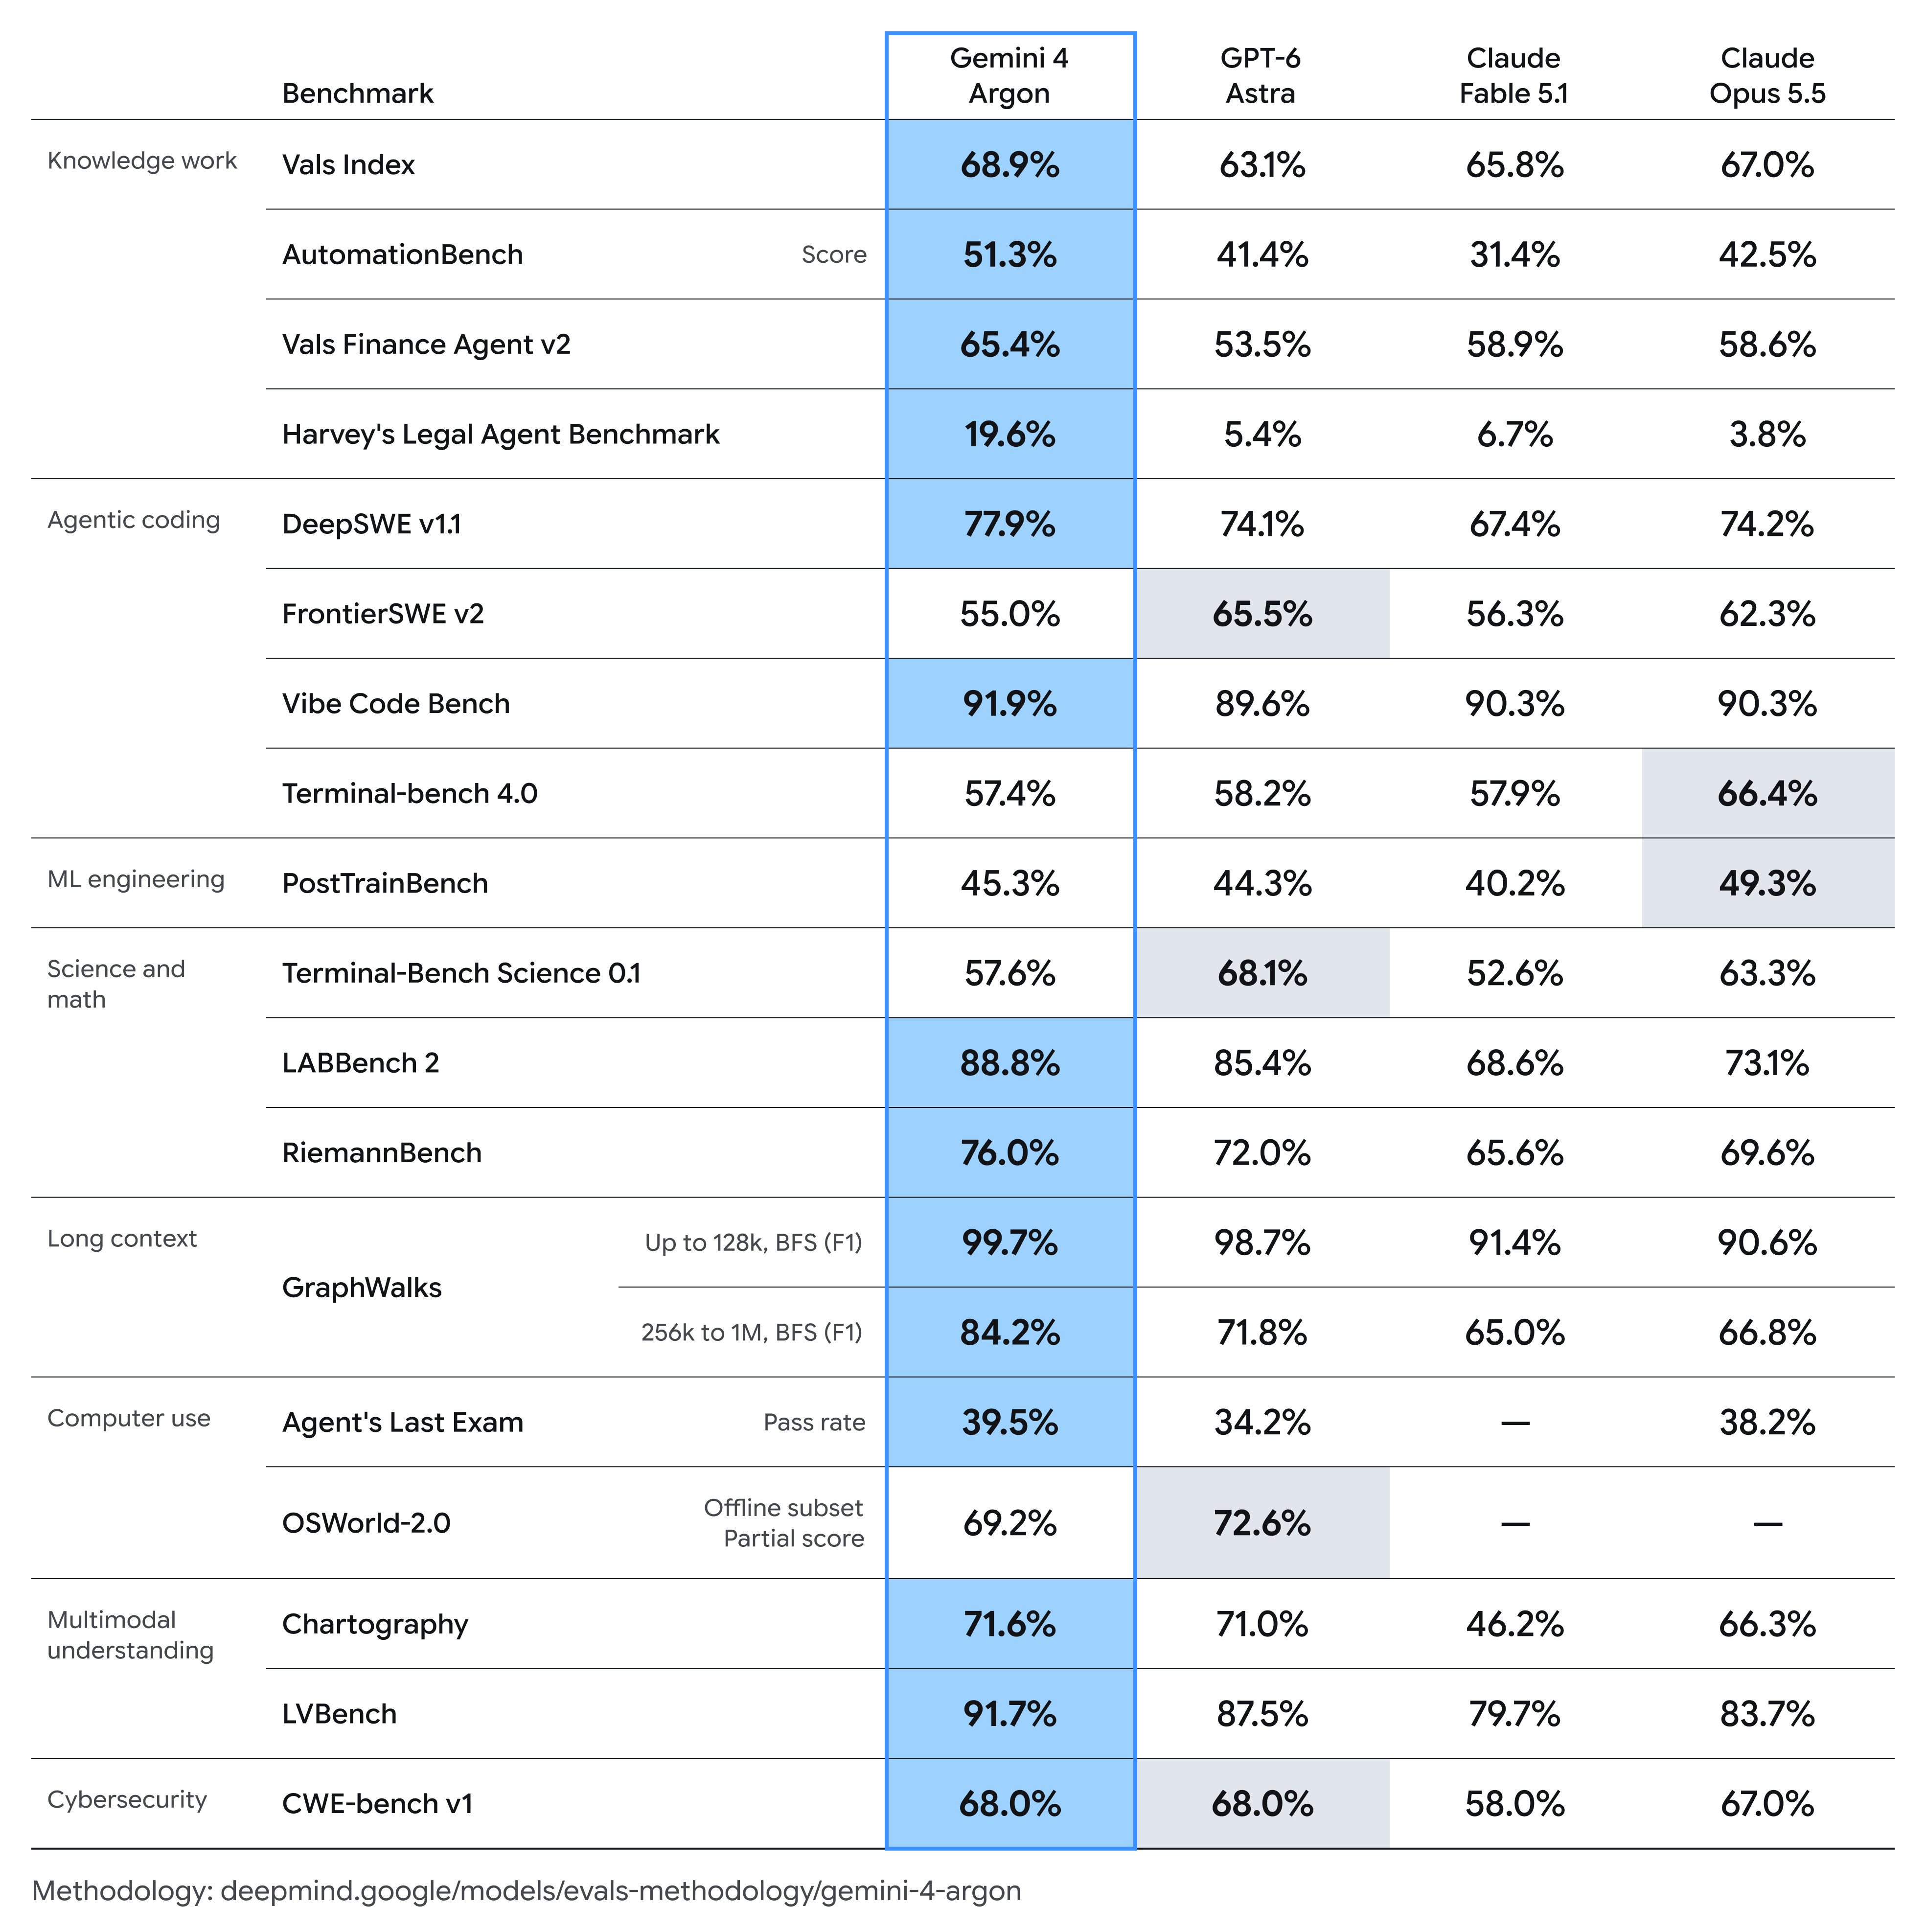
Todos os números abaixo vêm da tabela do Google. As pontuações do Argon são reportadas pelo Google, algumas auto-computadas e algumas de placares como Vals AI; as pontuações dos concorrentes são principalmente dos próprios fornecedores ou resultados de placares públicos, e as ferramentas de teste diferem. Pela nossa recontagem, o Argon lidera 13 das 19 linhas diretamente, empata em uma e fica atrás em cinco.
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Vals Index | 68,9% | 63,1% | 65,8% | 67,0% |
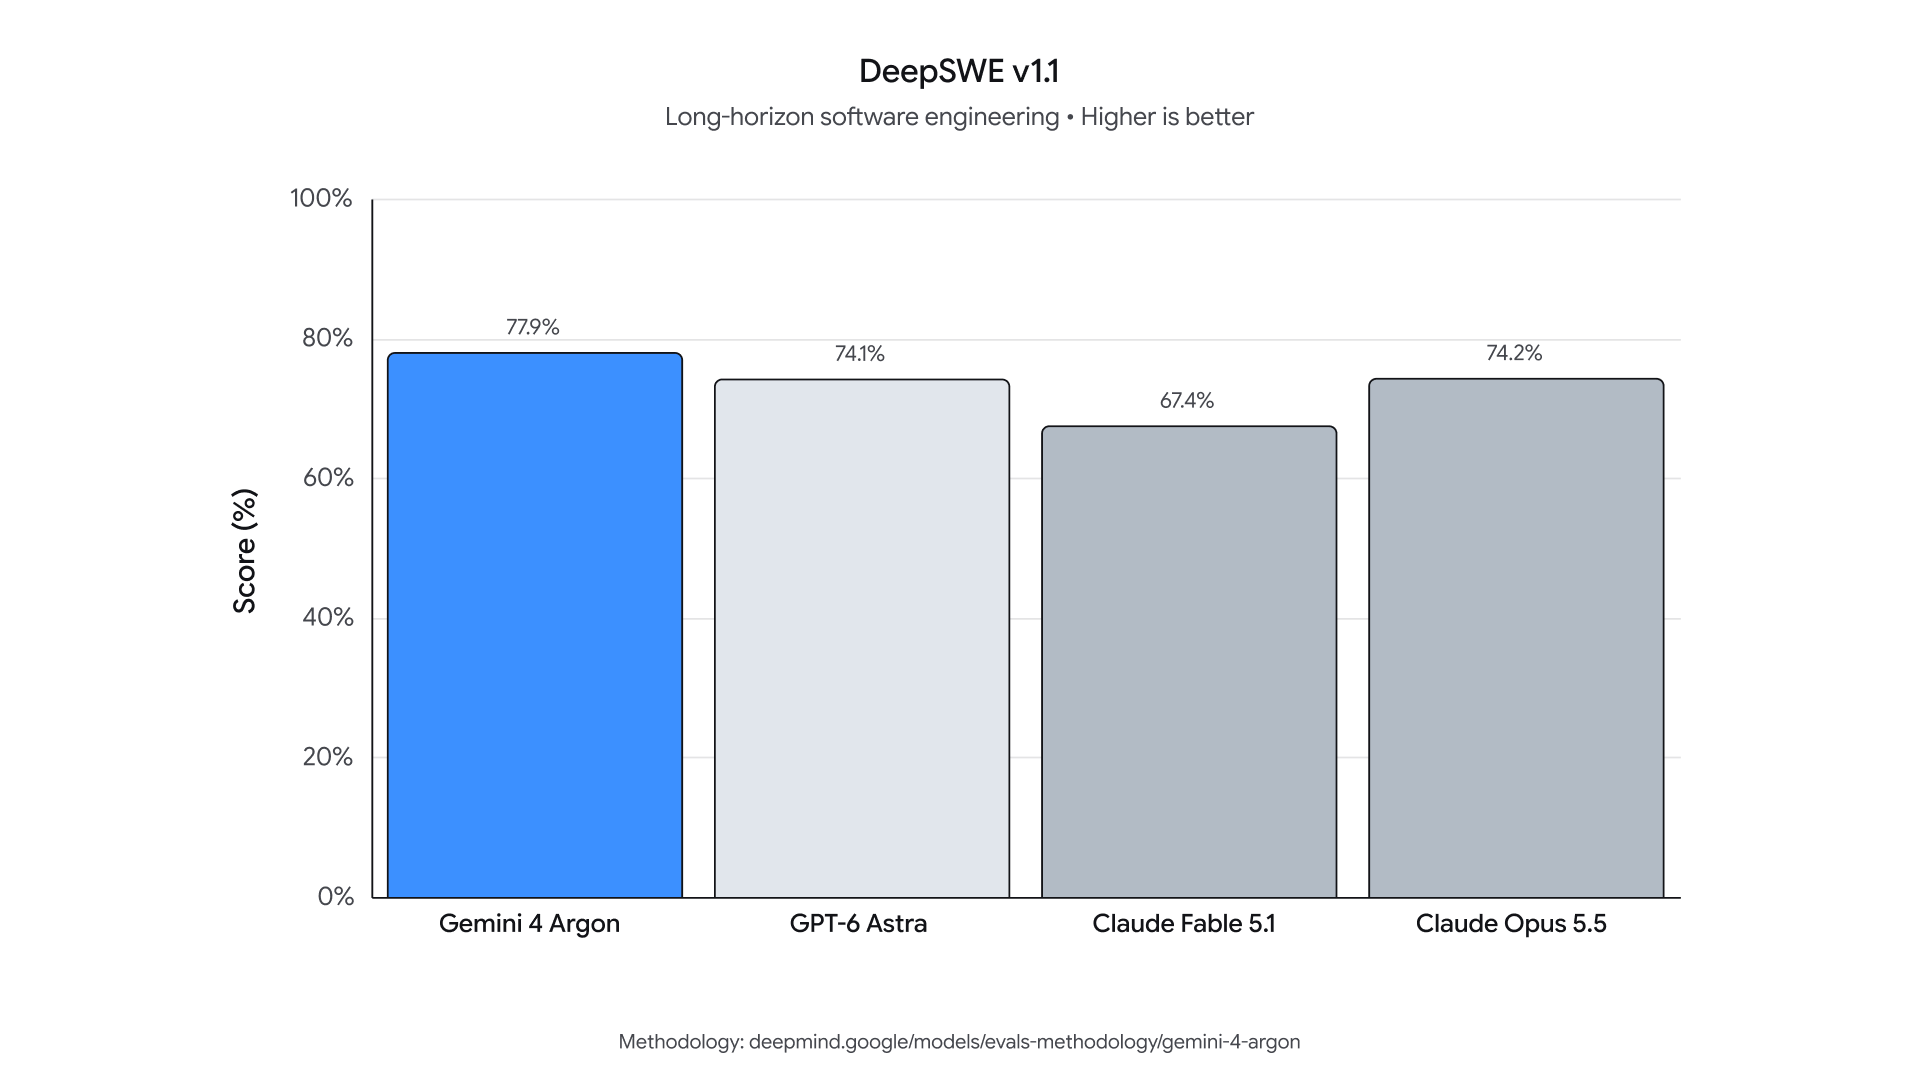
| DeepSWE v1.1 | 77,9% | 74,1% | 67,4% | 74,2% |
| GraphWalks 256K a 1M (F1) | 84,2% | 71,8% | 65,0% | 66,8% |
| FrontierSWE v2 | 55,0% | 65,5% | 56,3% | 62,3% |
| Terminal-bench 4.0 | 57,4% | 58,2% | 57,9% | 66,4% |
| PostTrainBench | 45,3% | 44,3% | 40,2% | 49,3% |
As cinco linhas em que o Argon perde: FrontierSWE v2, Terminal-Bench Science 0.1 e OSWorld-2.0 (para o Astra), além de Terminal-bench 4.0 e PostTrainBench (para o Opus 5.5).
Terceiros colocam o Argon na fronteira, mas sem uma liderança clara. A Artificial Analysis o pontua em 53 em seu Intelligence Index, empatado com o GPT-6 Astra e o Claude Fable 5.1 e atrás do Claude Opus 5.5 (58) e Claude Sonnet 5.5 (56) (configurações máximas); a Vals o classifica em primeiro lugar entre 41 modelos no Vals Index. Todas as 19 linhas e as notas do método do Google estão em Benchmarks do Gemini 4 Argon.
Defesa cibernética em um parágrafo
O Google afirma que "o Argon pode encontrar, validar e corrigir vulnerabilidades críticas de software autonomamente". Para defensores confiáveis e suas equipes internas, ele acrescenta, "lançaremos o Argon sem proteções cibernéticas para que eles possam alavancar suas capacidades completas de defesa cibernética de nível de fronteira". Na página de cibernética do DeepMind, o Argon pontua 85,8% na descoberta de vulnerabilidades no mundo real (Gemini 3.8 Flash Cyber: 71,0%), empata com Grok 4.7 e GPT-6 Astra em 68% no CWE-bench v1, e registra a menor taxa de sucesso de ataque de injeção de prompt indireta Gray Swan do gráfico, 0,7% em k=15. Veja o que o lançamento cibernético do Argon significa para as APIs que você executa e seu predecessor, Gemini 3.8 Flash Cyber.
O que fazer agora como desenvolvedor
Crie com base em um modelo que você pode chamar hoje e mantenha o nome do modelo em uma variável. O gemini-3.8-flash é o substituto: estável, 1.048.576 tokens de entrada e 65.536 de saída, uma camada gratuita e US$ 0,75/US$ 3,75 por milhão até 31 de dezembro de 2026. A documentação da API Interactions do Google diz que "todos os novos modelos, recursos multimodais, ferramentas e recursos agentivos serão lançados na API Interactions", então programe para ela. O Google não publicou o ID do modelo Argon, então você trocará a variável quando ele for lançado.
MODEL="${GEMINI_MODEL:-gemini-3.8-flash}"

curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "'"$MODEL"'",
    "input": "List the breaking changes in this OpenAPI diff.",
    "generation_config": {"thinking_level": "medium"}
  }'
No Apidog, salve a mesma chamada como uma requisição com GEMINI_API_KEY e GEMINI_MODEL como variáveis de ambiente, depois afirme as contagens de tokens no objeto usage da resposta (total_output_tokens mais total_thought_tokens, já que o pensamento é cobrado como saída) para que uma resposta descontrolada falhe no teste. Mantenha a resposta do 3.8 Flash como sua linha de base. Quando o ID do Argon aparecer na lista de modelos, altere GEMINI_MODEL, execute novamente e compare.
Para formatos de requisição, consulte o guia da API Gemini 4 Argon. Para decidir se vale a pena esperar, leia Argon vs Gemini 3.8 Flash.
FAQ
Posso usar o Gemini 4 Argon na API Gemini? Ainda não. Apenas um conjunto de parceiros Fairwind o possui; a lista pública de modelos não o inclui.
Qual é o ID do modelo Gemini 4 Argon? O Google não publicou um. As strings em circulação, incluindo identificadores de avaliadores, são placeholders de terceiros, então não as codifique fixamente.
Quando será o lançamento do Gemini 4 Argon para desenvolvedores? O Google não forneceu uma data. Clientes de API pagantes e assinantes do Google AI Ultra vêm primeiro, "assim que possível".
O Gemini 4 Argon é melhor que o GPT-6 Astra e o Claude Opus 5.5? Ele lidera a maioria das linhas na tabela do Google, mas empata com o Astra na Artificial Analysis e fica atrás do Opus 5.5 lá. Para os rivais em seus próprios termos, veja o que é Claude Opus 5.5 e nosso guia da API GPT-6 Astra.
O Gemini 4 Argon tem uma janela de contexto de 1 milhão? O Google não informou. 1 milhão é o limite de saída; sua avaliação de contexto longo usou prompts de até 1 milhão de tokens, o que não é uma especificação publicada.
Prepare-se antes da abertura do Argon
O Argon foi anunciado, teve seus preços e benchmarks divulgados, mas você ainda não pode chamá-lo. Construa sobre o Gemini 3.8 Flash com nosso guia da API Gemini 3.8 Flash, mantenha o modelo em uma variável e adicione uma afirmação de token em cada requisição. Para ter a requisição, o ambiente e a linha de base prontos para a troca, baixe o Apidog e configure-o hoje.