
O Firecrawl Local é um único binário em Rust que faz scraping, crawling e mapeamento de sites para markdown limpo na sua própria máquina. Você o instala com cargo install firecrawl-local, e ele pode servir a API v2 do Firecrawl em localhost:3002 sem chave de API, sem banco de dados, sem fila e sem contêiner. A busca e alguns outros recursos ainda vão para o Firecrawl Cloud, e você pode desativar isso.
A seguir: o que roda no seu laptop, o que vai para a nuvem, como instalá-lo, as rotas de API que ele serve, seus limites, e como permitir que seu agente de código teste a API local com o Apidog CLI.
O que é o Firecrawl Local?
O Firecrawl Local é a edição open-source e local do Firecrawl. É um único binário que busca páginas da web, limpa-as com o mesmo código de limpeza de HTML que a API hospedada do Firecrawl usa, e retorna markdown, HTML ou links. Ele roda como CLI, como servidor MCP para agentes de IA, ou como uma cópia local da API v2 do Firecrawl.
O Firecrawl o anunciou em 18 de novembro de 2026 em uma postagem de lançamento no X, e o código fica na pasta apps/local do repositório do Firecrawl. O pacote está publicado no crates.io como firecrawl-local, e o repositório tem licença AGPL-3.0.
O Firecrawl afirma que ele é 37x mais rápido que o Firecrawl auto-hospedado e usa 230x menos memória (11 MB em repouso). O README não publica metodologia de benchmark, então trate isso como alegações do fornecedor.
Se você conhece a API hospedada ou o Firecrawl CLI, a ideia é simples: as mesmas chamadas, respondidas na sua máquina.
Como o Firecrawl Local funciona: um binário, dez comandos
Cada recurso fica atrás de um subcomando de firecrawl-local. Aqui está a lista completa do README:
| Comando | O que ele faz | Executa em |
|---|---|---|
scrape <urls...> |
Faz scraping de uma ou mais URLs | Sua máquina |
crawl <url> |
Segue links a partir de uma URL inicial | Sua máquina |
map <url> |
Lista as URLs de um site a partir de sitemaps e da página inicial | Sua máquina |
serve |
Executa a API v2 do Firecrawl em localhost | Sua máquina |
mcp |
Executa o servidor MCP do Firecrawl via stdio | Sua máquina, algumas ferramentas na nuvem |
init |
Adiciona o servidor MCP a ferramentas de IA nesta máquina | Sua máquina |
search <query> |
Busca na web | Firecrawl Cloud |
find-tools <query> |
Encontra provedores de dados do Alexandria | Firecrawl Cloud, login |
data <provider> <capability> |
Executa um provedor de dados do Alexandria | Firecrawl Cloud, login |
login |
Faz login no Firecrawl no navegador | Firecrawl Cloud |
Três comandos cobrem a maior parte do uso diário:
# Print one page as markdown
firecrawl-local scrape https://example.com --markdown

# Crawl up to 50 pages and save one markdown file per page
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages

# List every URL on a site
firecrawl-local map https://firecrawl.dev
Sem --markdown, o scrape imprime o JSON da API do Firecrawl. --format aceita markdown, html, rawHtml e links. PDFs e documentos do Office também são processados localmente.
Para páginas em JavaScript, ele usa o Chrome ou Chromium que você já tem. Sem um deles, páginas estáticas ainda funcionam, e uma página que precisaria de um navegador retorna um aviso. --browser auto|never|always decide quando o Chrome é usado.
O que roda localmente vs. no Firecrawl Cloud
Scraping, crawling, mapeamento e processamento de documentos rodam na sua máquina e não enviam nada para o Firecrawl. Três recursos vão para o Firecrawl Cloud porque um laptop não tem o índice, a rede ou os dados:
- Busca. Não há índice de busca na sua máquina. A busca sem chave funciona, mas tem limite de taxa.
- Páginas que recusam sua máquina. Se um site bloqueia tanto a requisição direta quanto o navegador local, o Firecrawl Cloud a busca. Nenhuma conta é necessária.
- Provedores de dados do Alexandria. Eles rodam no Firecrawl Cloud e exigem uma conta gratuita. Nosso explicativo do Firecrawl Alexandria cobre o que eles são.
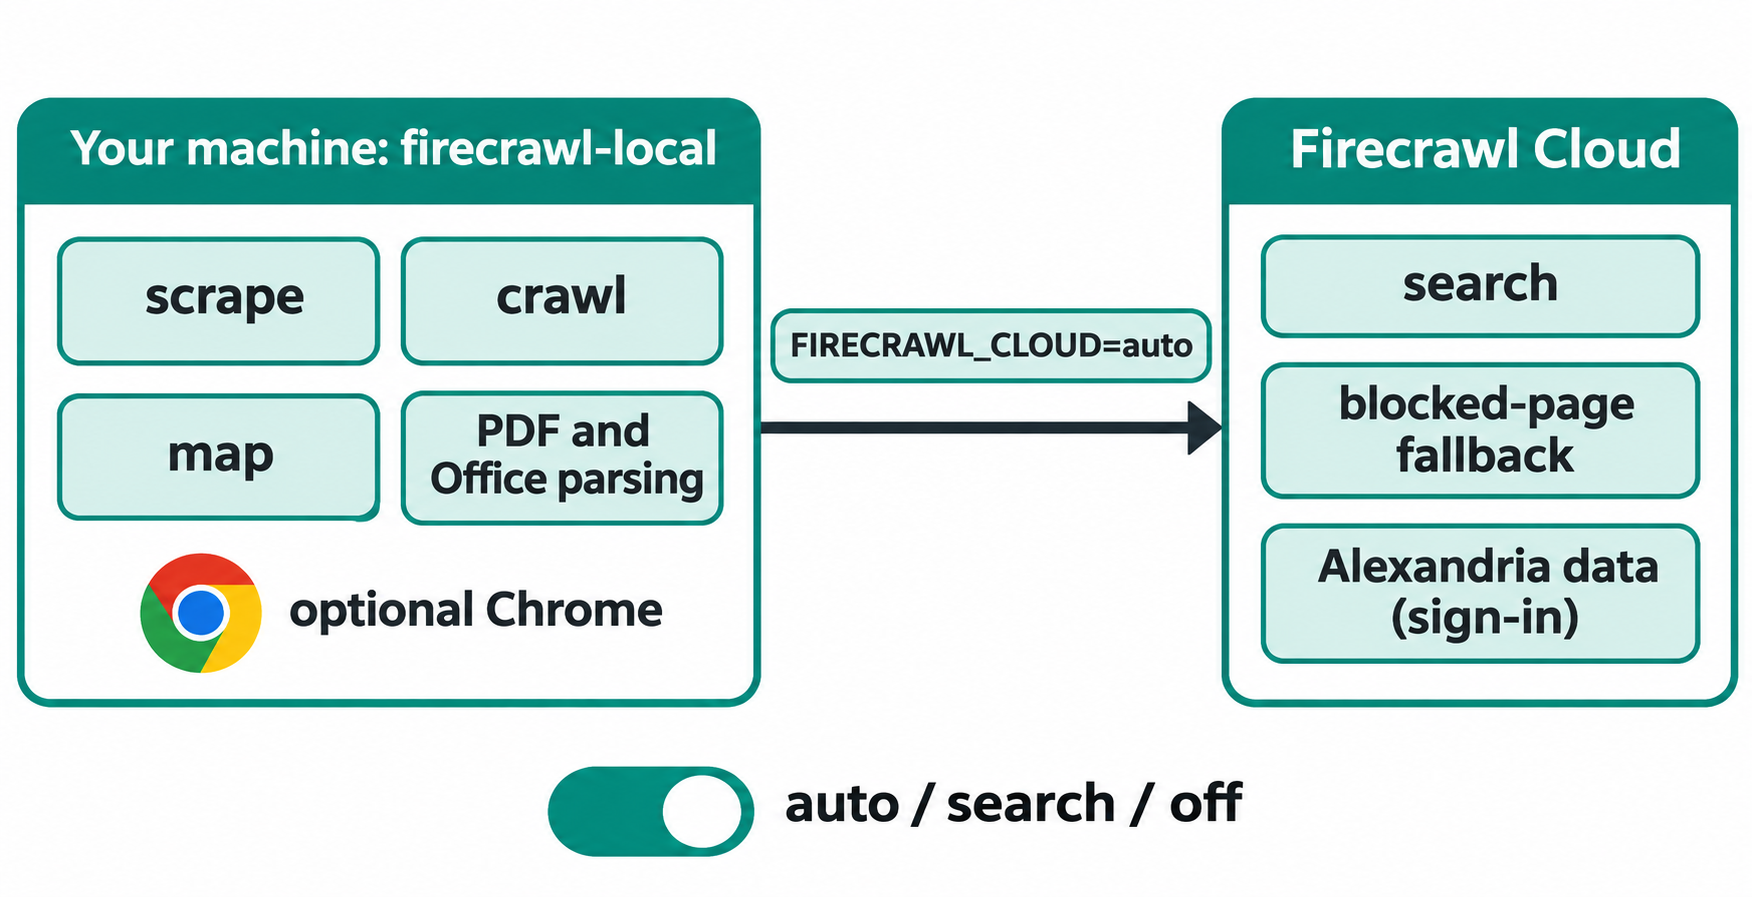
A variável de ambiente FIRECRAWL_CLOUD controla a transferência:
| Valor | Efeito |
|---|---|
auto (padrão) |
Busca, o fallback de páginas bloqueadas e o Alexandria funcionam |
search |
Apenas a busca vai para o Firecrawl Cloud |
off |
Nada vai para o Firecrawl Cloud |
Um valor não reconhecido conta como off. Resultados obtidos na nuvem carregam "source": "firecrawl-cloud"; se a nuvem também falhar, você recebe "blocked": true.
Chamadas à nuvem carregam um ID de instalação aleatório e o nome da ferramenta que fez a chamada, que é como o Firecrawl conta instalações.
Como instalar o Firecrawl Local
Você precisa de Rust e um compilador C. Depois:
- Instale as ferramentas de build. No macOS, execute
xcode-select --install. No Debian ou Ubuntu, instalebuild-essential. - Adicione o Chrome ou Chromium (opcional) se você precisar de páginas renderizadas em JavaScript ou capturas de tela.
- Adicione o Node.js 22 ou mais recente (opcional) se quiser o servidor MCP, que executa o pacote npm
firecrawl-mcpvianpx. - Faça login (opcional) com
firecrawl-local loginpara os provedores do Alexandria.
Instale o binário a partir do crates.io.
cargo install firecrawl-local
firecrawl-local --version
Para compilar o código mais recente, execute cargo build --release em apps/local de um clone do repositório.
API do Firecrawl Local: as rotas v2 em localhost:3002
firecrawl-local serve responde à API v2 do Firecrawl na porta 3002. Nenhuma chave de API é necessária para as rotas locais.
firecrawl-local serve

# in another terminal
curl -s http://localhost:3002/v2/scrape \
  -H 'content-type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown"]}'
Estas rotas rodam na sua máquina:
| Rota | O que ela faz |
|---|---|
POST /v2/scrape |
Faz scraping de uma URL |
POST /v2/map |
Lista as URLs de um site |
POST /v2/crawl, GET e DELETE /v2/crawl/{id} |
Inicia, verifica e cancela um crawl |
POST /v2/batch/scrape, GET e DELETE /v2/batch/scrape/{id} |
Inicia, verifica e cancela um scraping em lote |
GET /health |
Verificação de saúde |
Todas as demais rotas /v2, como /v2/search, são encaminhadas para o Firecrawl Cloud, a menos que FIRECRAWL_CLOUD diga o contrário. As rotas v0 e v1 não são servidas.
Código existente migra mudando apenas uma configuração: aponte a URL da API de qualquer SDK do Firecrawl para http://localhost:3002. Seu scraper ou pipeline de RAG mantém o código, e você para de gastar créditos na nuvem enquanto itera. Para uma visão mais ampla de pipelines de scraping, veja nosso guia de web scraping com Firecrawl.
O Firecrawl Local como servidor MCP para agentes de IA
firecrawl-local init registra o Firecrawl Local como um servidor Model Context Protocol em todas as ferramentas de IA que encontra. Ele conhece Claude Code, Claude Desktop, Cursor, Windsurf, Gemini CLI e Codex, faz backup de cada arquivo de configuração antes, e aceita --dry-run para pré-visualizar mudanças ou --agent cursor para configurar uma ferramenta específica.
Seu agente recebe as ferramentas padrão do Firecrawl MCP: scrape, crawl, map e batch scrape rodam localmente, o resto vai para o Firecrawl Cloud.
Se seu agente navega em sites em que você não confia, registre-o como firecrawl-local mcp --public-only. Uma página com instruções ocultas poderia, caso contrário, levar o agente a abrir uma URL interna na sua rede.
Limites do Firecrawl Local
O Firecrawl Local não é o servidor Firecrawl completo. O README lista o que está faltando:
- Sem os formatos
jsonousummarylocalmente. Scrapes locais os ignoram com um aviso, porque eles precisam de um modelo. - Sem
actionsde navegador. Passos de cliques, rolagens e digitação são ignorados. - Capturas de tela precisam do Chrome.
- Jobs ficam na memória. Jobs de crawl e de lote expiram uma hora após o início e são perdidos quando
servepara. - Sem rotas v0 ou v1 da API.
Para filas, workers e todos os formatos, o servidor completo em apps/api ainda existe, coberto no guia de auto-hospedagem do Firecrawl.
Padrões de segurança que você deveria conhecer
Os padrões variam por comando, porque serve recebe requisições de outros programas:
scrape,crawl,mapemcprodam para a pessoa no teclado, então podem acessarlocalhoste sua rede privada.scrape,crawlemcpaceitam--public-onlypara recusar esses endereços.servevincula-se a127.0.0.1e recusa destinos de localhost e privados, a menos que você passe--allow-private. Vincular outro endereço com--hostrequer--token.- Endereços link-local e de metadata da nuvem são sempre bloqueados, inclusive após redirecionamentos e resolução de DNS.
O Chrome roda headless e em sandbox com um perfil descartável. Ao fazer crawling, o Firecrawl Local lê o robots.txt conforme o Robots Exclusion Protocol, onde donos de sites podem se dirigir a ele como FirecrawlLocal.
Para quem é o Firecrawl Local
- Desenvolvedores que constroem scrapers ou pipelines de RAG e querem iteração gratuita e rápida antes de pagar por volume na nuvem.
- Usuários de agentes de código que querem leitura da web dentro do Claude Code, Cursor ou Codex sem enviar cada página por um terceiro.
- Equipes com regras de dados que precisam que o conteúdo coletado fique na máquina, usando
FIRECRAWL_CLOUD=off.
Encaixa menos se você depende de extração json, ações de navegador ou jobs de crawl de longa duração. Se você só precisa de busca para agentes, veja nossa compilação de busca na web open-source para o Claude.
Deixe seu agente de código testar a API local com o Apidog CLI
Quando o serve está rodando, você tem uma API HTTP real em localhost:3002. Antes de conectar um pipeline a ela, verifique se as rotas respondem como o seu código espera. Dê ao seu agente de código o Apidog CLI e um prompt em vez de clicar por requisições.
Configure uma vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Depois peça ao seu agente:
Start firecrawl-local serve in the background. Write an OpenAPI 3 file for its
local routes (POST /v2/scrape, POST /v2/map, GET /health) and import it into
Apidog project <id>. Create an environment pointing at http://localhost:3002,
add test cases that assert /health returns 200 and /v2/scrape returns
success: true with non-empty data.markdown for https://example.com, then run
them and summarize any failures.
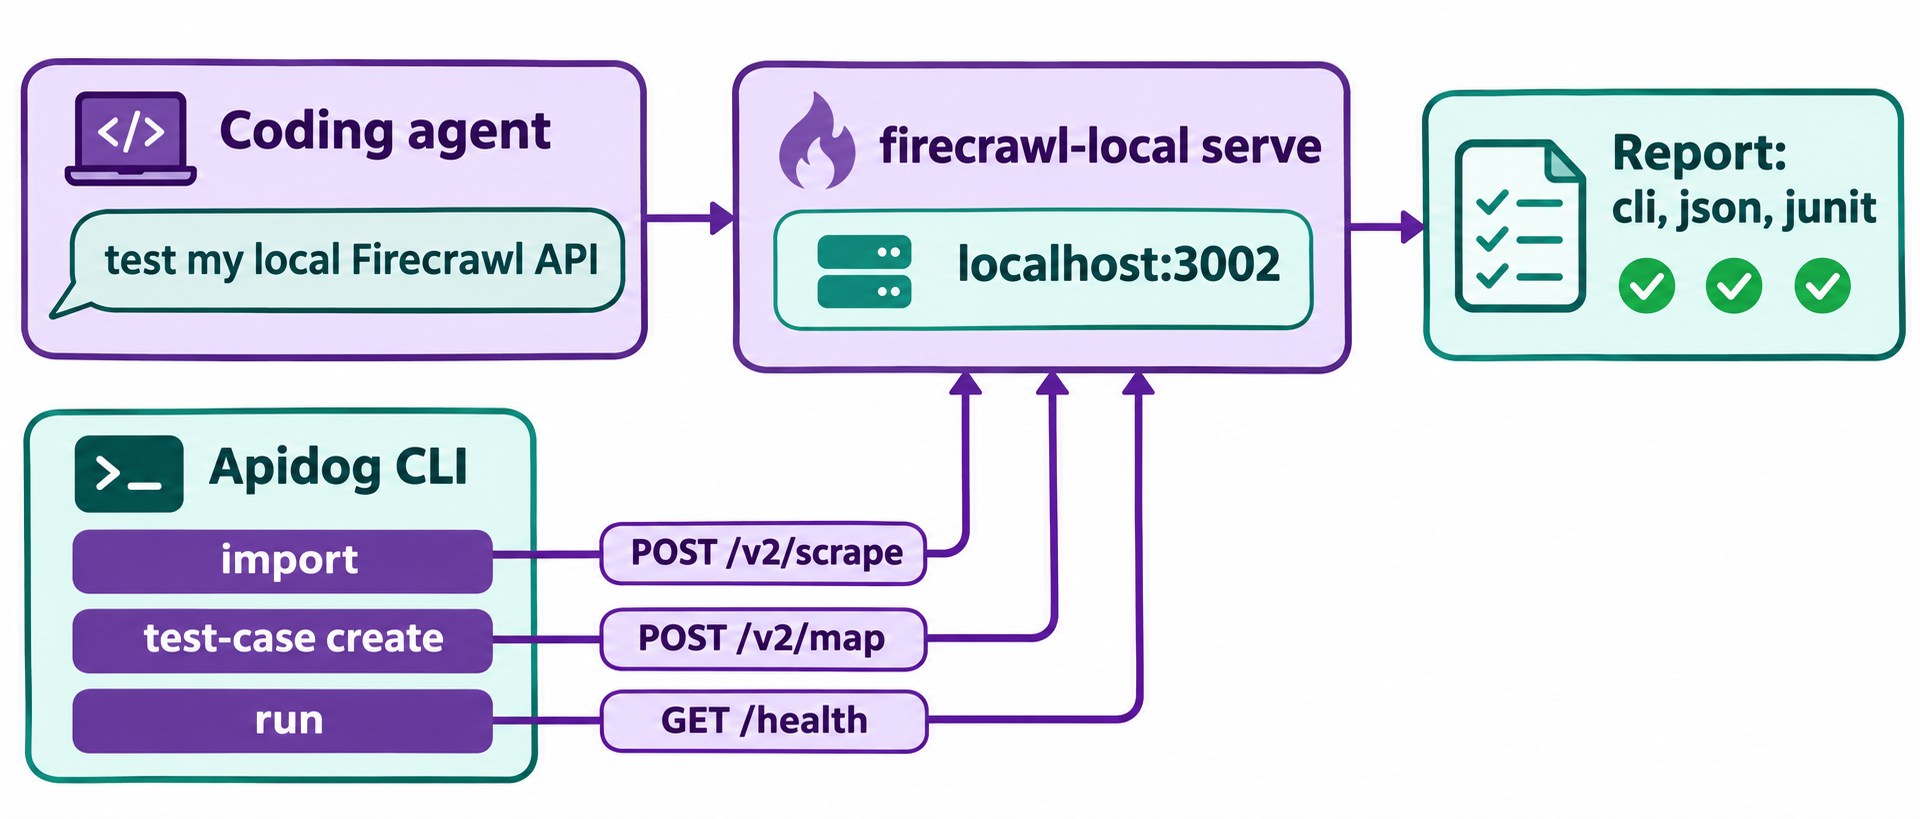
O agente lê o schema, valida o payload e executa comandos como estes:
firecrawl-local serve &
apidog import --project <id> --format openapi --file ./firecrawl-local-v2.yaml
apidog environment create firecrawl-local --project <id> --base-url http://localhost:3002
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file ./case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
O Apidog CLI envia requisições a partir da sua máquina, então localhost:3002 é acessível. Troque -r cli,json por -r junit e a mesma execução entra no CI; nosso guia do Apidog CLI em pipelines CI/CD mostra a configuração, e Apidog CLI no Claude Code percorre o lado do agente. O plano gratuito do Apidog cobre equipes de até 4 usuários.
Perguntas frequentes
O Firecrawl Local é gratuito? O binário é open-source sob AGPL-3.0, e scraping, crawling e mapeamento locais não precisam de chave de API. A busca, o fallback de páginas bloqueadas e o Alexandria vão para o Firecrawl Cloud, e o Alexandria exige uma conta gratuita.
Posso usar o código existente do meu SDK do Firecrawl com o Firecrawl Local? Sim, para as rotas locais. Defina a URL da API do SDK como http://localhost:3002. Scrape, map, crawl e batch scrape rodam localmente; as rotas v0 e v1 não são servidas.
Como faço para o Firecrawl Local parar de chamar a nuvem? Defina FIRECRAWL_CLOUD=off. A busca e o fallback de páginas bloqueadas param de funcionar, e nada sai da sua máquina, exceto um login explícito.
Qual a diferença entre o Firecrawl Local e o Firecrawl auto-hospedado? O Firecrawl auto-hospedado é o servidor completo em apps/api, com filas, workers e todos os formatos. O Firecrawl Local é um binário único e mais leve que abre mão dos formatos json e summary, das ações de navegador e dos jobs persistentes.