
A DeepSeek aposentou seu carro-chefe com seu menor modelo. Em 10 de setembro de 2026, o DeepSeek-V4.1-Flash foi lançado (GA) na API, e as notas de lançamento trazem uma frase que a maioria dos laboratórios esconderia: a partir de 14 de setembro, cada solicitação para deepseek-v4-pro será roteada para o V4.1-Flash e cobrada com os preços Flash. O modelo Flash de 552B parâmetros, com 8B parâmetros ativos na entrada, agora responde por toda a família V4.
Essa é a história por trás das pesquisas por “deepseek v4.1 flash” esta semana, e ela importa por duas razões. Primeiro, a arquitetura é nova. Uma divisão de Encoder-Decoder Causal, cache KV FP4 com 890 bytes por token e visão nativa desde o primeiro passo de pré-treinamento não são mudanças incrementais ao DeepSeek V4. Segundo, a tabela de preços mudou com ele. Se você estava pagando as taxas do V4-Pro, sua conta cairá em 70% ou mais no dia 14, independentemente de você mudar algo ou não.
Este guia aborda o que foi lançado, como a arquitetura funciona em termos de desenvolvedor, o que os benchmarks do fornecedor dizem e a matemática de preços. Ele termina com um fluxo de trabalho para testar o modelo com seus próprios prompts no Apidog, porque uma tabela de benchmarks é um ponto de partida, não um veredito.
TL;DR
- DeepSeek-V4.1-Flash está GA a partir de 10 de setembro de 2026. ID do modelo:
deepseek-flash. URL base inalterada emhttps://api.deepseek.com. - 552B MoE (763B com o encoder de visão), 8B ativos para pré-preenchimento, 16B ativos para decodificação. Contexto de 1M, saída máxima de 384K.
- Pelos próprios números da DeepSeek, ele supera o V4-Pro em HumanEval, GSM8K, DeepSWE e Terminal-Bench.
- Preço de pico: $0.30 por 1M de entrada com cache-miss, $1.20 por 1M de saída. Fora do pico é a metade.
- Solicitações do V4-Pro serão redirecionadas para V4.1-Flash em 14 de setembro às 04:00 UTC.
O que foi lançado em 10 de setembro
A DeepSeek realizou um beta interno de dois dias a partir de 8 de setembro sob o nome do modelo deepseek-v4.1-flash-expires-on-0910, limitado a 20 solicitações simultâneas por conta e com o mesmo preço do deepseek-v4-flash. A TechNode reportou sobre esse beta. Dois dias depois, o modelo foi lançado (GA), com uma entrada no changelog datada de 2026-09-10 e um anúncio no X.
Três mudanças de nomenclatura são importantes para o seu código:
- O novo ID do modelo é
deepseek-flash. Use-o para novas integrações. - Os nomes legados
deepseek-v4-flashedeepseek-v4-flash-vision-expainda funcionam, mas são atendidos pelo V4.1-Flash. V4-Flash e V4-Flash-Vision-Exp são aposentados como modelos separados. deepseek-v4-procontinua funcionando até 14 de setembro, então será roteado para V4.1-Flash.
As URLs base não mudaram: https://api.deepseek.com para o formato OpenAI, https://api.deepseek.com/anthropic para o formato Anthropic. A API de Respostas já era suportada na linha Flash, então as integrações estilo Codex são mantidas. Para detalhes de parâmetros, incluindo entrada de imagem e esforço de raciocínio, consulte como usar a API DeepSeek-V4.1-Flash.
A arquitetura Causal Encoder-Decoder para desenvolvedores
O card do modelo descreve um design que a DeepSeek chama de Causal Encoder-Decoder, ou CED. Veja o que cada número significa quando você é quem paga pelos tokens.
552B parâmetros, 763B com visão. O backbone de linguagem é um modelo mixture-of-experts de 552B parâmetros. Adicione o encoder DeepSeek-ViT, treinado do zero para este lançamento, e o modelo completo atinge 763B. Esses são parâmetros armazenados, não o custo de uma solicitação.
8B ativos para pré-preenchimento, 16B ativos para decodificação. Esta é a principal mudança. As 40 camadas se dividem em 20 camadas de encoder e 20 de decoder. Ler seu prompt (pré-preenchimento) ativa cerca de 8B parâmetros por token. Escrever a resposta (decodificação) ativa cerca de 16B. Modelos MoE anteriores da DeepSeek usavam um orçamento de parâmetros ativos para ambas as fases.
Por que essa divisão importa? O pré-preenchimento é limitado por computação: você empurra um documento de 200K tokens através do modelo em uma única passagem. A decodificação é limitada por memória: você gera um token por vez, e o custo é a leitura de pesos e cache KV da HBM. Menos parâmetros no pré-preenchimento reduzem o tempo para o primeiro token em entradas longas. Mais parâmetros na decodificação melhoram a qualidade da resposta onde a computação extra é barata em relação ao tráfego de memória. Um rastreamento de agente de contexto de 1M que produz uma resposta de 2K tokens segue o caminho mais barato para 99,8% de seus tokens.
384 experts roteados mais 1 expert compartilhado por camada. O roteador escolhe alguns dos 384 experts por token, e o expert compartilhado executa sempre. É assim que 552B parâmetros armazenados se tornam 8B ou 16B ativos.
CSA2 e o cache KV FP4. O Compressed Sparse Attention 2 vem com três modos de atenção estáticos. Combinado com armazenamento FP4 para o cache KV principal, a pegada global do cache é de 890 bytes por token, cerca de um quarto do DeepSeek-V4-Flash. As notas de lançamento indicam que é 1/4 da HBM e 1/8 do armazenamento SSD da geração anterior. Com 890 bytes por token, um contexto completo de 1M tokens precisa de cerca de 0,9 GB de cache KV. Isso faz parte do motivo pelo qual o limite de concorrência é de 2.500 para Flash versus 500 para Pro.
Contexto de 1M, saída de 384K. A atenção esparsa foi treinada com 64K e estendida para 1M na marca de 34T-tokens de um corpus multimodal de 45T-tokens. O esforço de raciocínio é descrito como continuamente controlável em uma escala de 1 a 100; o formato exato do parâmetro da API para essa escala é [VERIFICAR] contra a documentação.
Benchmarks: o que a DeepSeek relata
Cada número nesta seção é reportado pela DeepSeek no card do modelo. Nenhuma avaliação independente havia sido publicada até 10 de setembro. Leia-os como a afirmação do fornecedor e, em seguida, faça seus próprios testes.
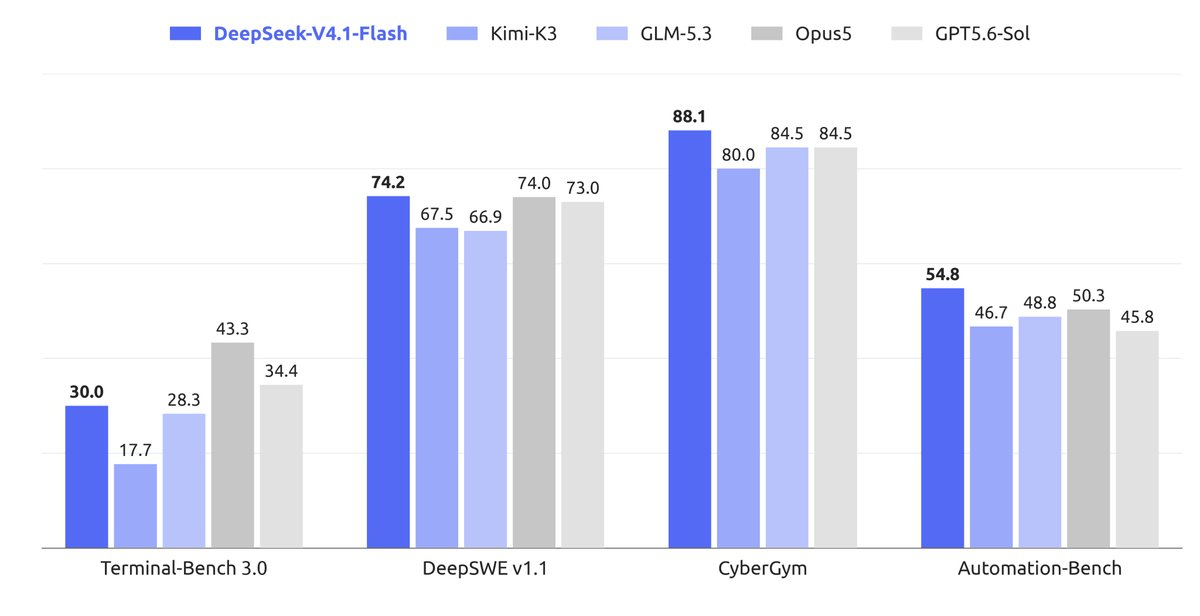
O padrão é consistente: V4.1-Flash está acima do V4-Pro em todas as linhas, com a maior diferença na codificação agentic. DeepSWE salta 11,5 pontos acima do Pro e quase 20 acima do antigo Flash. O GSM8K está saturado, então a vantagem de 0,4 pontos diz pouco.
Pontuações de visão, novamente reportadas pelo fornecedor: MMMU-Pro 56.5, CVBench 77.9, DocVQA 95.6, RefCOCO 86.0. DocVQA é o número a ser observado, pois a análise de documentos é para onde a maior parte do tráfego de visão em produção se destina.
A DeepSeek enquadra o redirecionamento do V4-Pro como o V4.1-Flash “tendo superado amplamente o V4 Pro em desempenho, custo, velocidade e tempo total”, citando testes de múltiplas partes. As partes não são nomeadas. Trate essa frase como uma afirmação que você pode verificar.
Preços e o redirecionamento do V4-Pro
As taxas abaixo são da página de preços, efetivas a partir de 10 de setembro às 04:00 UTC, em USD por 1M de tokens.
| deepseek-flash fora do pico | deepseek-flash pico | deepseek-v4-pro fora do pico | deepseek-v4-pro pico | |
|---|---|---|---|---|
| Entrada, cache hit | $0.003 | $0.006 | $0.022 | $0.044 |
| Entrada, cache miss | $0.15 | $0.30 | $0.66 | $1.32 |
| Saída | $0.60 | $1.20 | $1.98 | $3.96 |
Os horários de pico são das 01:00 às 04:00 e das 06:00 às 10:00 UTC nos dias úteis; fora do pico é 50% do valor de pico. O cache de contexto é automático, e um cache hit custa 50x menos do que um miss em qualquer nível.
Em comparação com as taxas de agosto do V4-Flash, o V4.1-Flash reduz a entrada com cache-hit em cerca de 57%, a entrada com cache-miss em cerca de 32% e a saída em cerca de 9%.
A coluna V4-Pro é a que deve ser observada. Após 14 de setembro, uma solicitação enviada para deepseek-v4-pro pagará a coluna Flash. No pico, isso é $0.30 em vez de $1.32 por 1M de entrada com cache-miss (77% menos) e $1.20 em vez de $3.96 por 1M de saída (70% menos). Você obtém a redução sem mexer no código, embora deva atualizar o ID do modelo de qualquer forma em vez de depender de um alias aposentado. O guia de migração detalha a lista de verificação, e a análise aprofundada de preços cobre a matemática do cache-hit para longas sessões de agente.
Avalie o V4.1-Flash com seus próprios prompts no Apidog
A tabela do fornecedor diz que o modelo é bom em DeepSWE. Não diz se ele lida com seu esquema de extração, seu formato de chamada de ferramenta ou suas transcrições de suporte de 300K tokens. Aqui está um fluxo de trabalho no Apidog que responde a essas perguntas em uma tarde e continua a respondê-las após cada atualização silenciosa do modelo.
- Armazene a chave como uma variável de ambiente. Crie um ambiente Apidog e adicione
DEEPSEEK_API_KEYda plataforma DeepSeek. Referencie-a no cabeçalho de Autorização comoBearer {{DEEPSEEK_API_KEY}}. - Adicione o endpoint. Crie
POST https://api.deepseek.com/chat/completions, ou importe uma especificação OpenAPI. - Salve uma solicitação por prompt real. Pegue de cinco a dez prompts dos logs de produção e salve cada um como sua própria solicitação com
"model": "deepseek-flash". Mantenha uma cópia apontada paradeepseek-v4-proaté o dia 14 para que você possa comparar as saídas lado a lado. - Transmita e observe os eventos. Defina
"stream": true. O Apidog renderiza as respostas SSE evento por evento, então os deltas de raciocínio e os deltas de resposta aparecem separadamente em vez de como uma parede de linhasdata:. É a maneira mais rápida de ver o tempo para o primeiro token em um pré-preenchimento longo. - Adicione asserções e construa um cenário de teste. Afirme o código de status, um campo
tool_callsonde você espera um, e a validade JSON da saída. Encadeie as solicitações salvas em um cenário de teste. - Reexecute em cada atualização do modelo. Quando a DeepSeek lançar a próxima mudança por trás do
deepseek-flash, execute o cenário. Conecte-o ao CI comapidog-clipara que ele seja executado em cada deploy.
Aqui está o corpo para um desses prompts salvos, usando o SDK do OpenAI:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "system", "content": "Extract the order ID, SKU list, and refund amount as JSON."},
        {"role": "user", "content": "Ticket #48213: customer wants a refund of $42.90 for SKUs KB-220 and MS-114 from order ORD-99117."},
    ],
    stream=True,
)

for chunk in response:
    if chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="")
Baixe o Apidog e cole esse corpo em uma solicitação salva. O Apidog testa a camada da API, não um host de modelo, então o que você vê é a resposta que seus usuários receberão.
Perguntas Frequentes
O DeepSeek-V4.1-Flash substitui o V4-Pro? Sim, por decisão da DeepSeek. A partir de 14 de setembro às 04:00 UTC, as solicitações deepseek-v4-pro serão atendidas pelo V4.1-Flash com preços Flash. Não há mais nenhum modelo maior restante na linha de API V4.
Preciso mudar meu ID de modelo? Não imediatamente. deepseek-v4-flash, deepseek-v4-flash-vision-exp e (após o dia 14) deepseek-v4-pro todos resolvem para V4.1-Flash. Mude para deepseek-flash na próxima vez que você mexer na integração. O guia da API tem a referência completa de parâmetros.
O que 8B de pré-preenchimento / 16B de decodificação significa para a latência? Menos parâmetros ativos na entrada significam um tempo mais rápido para o primeiro token em prompts longos. Mais na saída significa que a computação vai para onde a qualidade da geração é decidida. O cache KV de 890 bytes por token mantém as sessões longas baratas para manter na memória.
Posso executá-lo localmente? Os pesos são licenciados pelo MIT no Hugging Face. O backbone sozinho tem cerca de 552 GB em 8 bits ou 280 GB em 4 bits, então este é um projeto para multi-GPU ou streaming via SSD, não para um laptop. O suporte a motores de inferência no dia zero é [VERIFICAR].
Os benchmarks são independentes? Não. Cada pontuação acima vem do card do modelo da DeepSeek. O relatório técnico contém a metodologia.
Onde isso deixa a linha V4
A DeepSeek unificou uma API de dois modelos em um. A aposta é que um modelo de 552B com um orçamento de decodificação de 16B, um cache KV de um quarto do tamanho e 2.500 sessões simultâneas por conta serve melhor às cargas de trabalho de agente do que um modelo maior por três a quatro vezes o preço. Os números do fornecedor apoiam a aposta; sua carga de trabalho decide se ela se sustenta.
Aponte seu SDK para deepseek-flash, execute seus próprios prompts antes do dia 14 e mantenha o cenário de teste. Se você construiu sobre a API V4-Flash original, sua integração já funciona. O que mudou é o modelo por trás dela, e essa é a parte que vale a pena medir.