Claude Sonnet 5.5 é o modelo de nível médio da Anthropic, lançado em 28 de setembro de 2026, com o ID de API claude-sonnet-5-5. Ele custa US$2 por milhão de tokens de entrada e US$10 por milhão de tokens de saída, o mesmo que o Sonnet 5. Em seu post de lançamento, a Anthropic afirma que ele “roda 30%+ mais rápido” que o Sonnet 5 e, nos testes da Anthropic, “custa até 30% menos por tarefa do que seu predecessor”. É o segundo modelo na família Claude 5.5: um complemento mais barato para o Opus 5.5 (US$4/US$20) e um passo acima do Haiku 4.5.
Abaixo: especificações, a linha de modelos, mudanças em relação ao Sonnet 5, benchmarks, onde executá-lo e quem deve mudar, com links para guias mais aprofundados, como o detalhamento de preços. Para chamar o modelo enquanto você lê, o Apidog pode enviar a requisição Messages, manter sua chave em uma variável de ambiente e mostrar a resposta e o uso de tokens juntos.
Especificações do Claude Sonnet 5.5 em um relance
| Especificação | Claude Sonnet 5.5 |
|---|---|
| Data de lançamento | 28 de setembro de 2026 |
| ID do modelo (API Claude, Google Cloud, Microsoft Foundry, Plataforma Claude na AWS) | claude-sonnet-5-5 |
| ID do modelo (Amazon Bedrock) | anthropic.claude-sonnet-5-5 |
| Janela de contexto | 1M tokens |
| Saída máxima | 128K; 300K na API Batch com a beta output-300k-2026-03-24 |
| Pensamento | Adaptativo, ativado por padrão |
| Esforço padrão | high na Plataforma Claude; medium no Claude Code e nos aplicativos Claude |
| Data de corte do conhecimento | Junho de 2026 |
| Descontinuação | Não antes de 28 de setembro de 2027 |
| Preço por MTok | US$2 entrada, US$10 saída, US$0.20 leitura de cache, US$2.50 (5 minutos) ou US$4 (1 hora) escrita de cache; Batch US$1 / US$5 |
Fontes: a visão geral do modelo Sonnet 5.5 e a página de preços do Claude.
Não há premium para contexto longo: uma requisição de 900K tokens custa o mesmo por token que uma de 9K. O modo rápido não está disponível; é apenas para Opus. A inferência apenas nos EUA (inference_geo: "us") custa 1.1x. O aumento planejado do Sonnet 5 para US$3/US$15 em 1º de setembro foi cancelado, então US$2/US$10 é a taxa padrão do Sonnet.
Onde o Sonnet 5.5 se posiciona na linha Claude
| Modelo | Entrada / saída por MTok | Contexto / saída máxima | No Claude Gratuito? | Função |
|---|---|---|---|---|
| Claude Fable 5.1 | US$10 / US$50 | 1M / 128K | Não | Raciocínio exigente, trabalho agêntico de longo alcance |
| Claude Opus 5.5 | US$4 / US$20 | 1M / 128K | Não | Trabalho complexo e aberto |
| Claude Sonnet 5.5 | US$2 / US$10 | 1M / 128K | Sim (chat) | Trabalho diário bem delimitado |
| Claude Haiku 4.5 | US$1 / US$5 | 200K / 64K | Sim | Camada de menor custo |
A Anthropic posiciona o Sonnet 5.5 para tarefas diárias bem delimitadas, correção de bugs e documentos, slides e planilhas polidos, e afirma que o Opus 5.5 "continua sendo claramente mais forte em trabalhos complexos e abertos". O Haiku 5.5 deve ser lançado "nas próximas semanas". Para o nível acima, leia o que é Claude Opus 5.5.
O que há de novo em comparação com o Sonnet 5
Preço e tokenizador permanecem inalterados. O contrato da API não. O guia de migração lista cinco mudanças que quebram a compatibilidade:
thinking: {"type": "disabled"}foi removido. Use{"type": "between_tools"}, aceito apenas em esforçolow,mediumouhigh.- O uso forçado de ferramentas foi removido. `tool_choice` de `any` ou `tool` falha. Envie `auto` com ferramentas `strict: true` e indique no prompt quando usá-las.
- Os blocos de pensamento estão vinculados à conversa. Para contas criadas em ou após 31/08/2026, reproduzir um bloco após editar o histórico anterior falha. Mantenha as conversas apenas com anexação.
computer_20251124é rejeitado na API Claude e no Google Cloud. Usecomputer_toolset_20260801.- Os emparelhamentos de Advisor são restritos a Opus 5, Opus 5.5, Sonnet 5.5, Fable 5, Fable 5.1, Mythos 5 ou Mythos 5.1.
Uma sexta mudança não causa falha, mas altera a forma da resposta: o texto entre as chamadas de ferramenta agora chega como blocos de `thinking` de atualização de progresso, vazios sob o `display: "omitted"` padrão, para que sua UI possa ficar silenciosa no meio da tarefa. Defina `display: "updates"` (cabeçalho beta `thinking-display-updates-2026-08-18`) ou `"summarized"` para vê-los.
Também novo:
- Esforço recalibrado. Não copie as configurações do Sonnet 5. Comece com
high(oumediumpara codificação agêntica bem especificada) e execute uma nova varredura. - Salvaguardas cibernéticas. É o primeiro Sonnet com elas: tarefas cibernéticas de alto risco “visivelmente voltarão para o Sonnet 5” nos aplicativos da Anthropic; na API, o fallback é opcional (
fallbacks: "default", beta). - Pensamento vinculado à conta. O pensamento não pode se mover entre contas, o que importa se você troca de conta no meio da sessão no Claude Code.
- Esforço por mensagem. A alteração do esforço de nível superior entre as requisições invalida o cache de prompt; a alteração de esforço por mensagem beta evita isso.
- Mínimo de cache mais baixo. O menor prompt cacheável é de 512 tokens, abaixo dos 1.024.
O guia Sonnet 5.5 vs Sonnet 5 contém os erros exatos e o JSON antes/depois para cada correção.
Benchmarks do Claude Sonnet 5.5
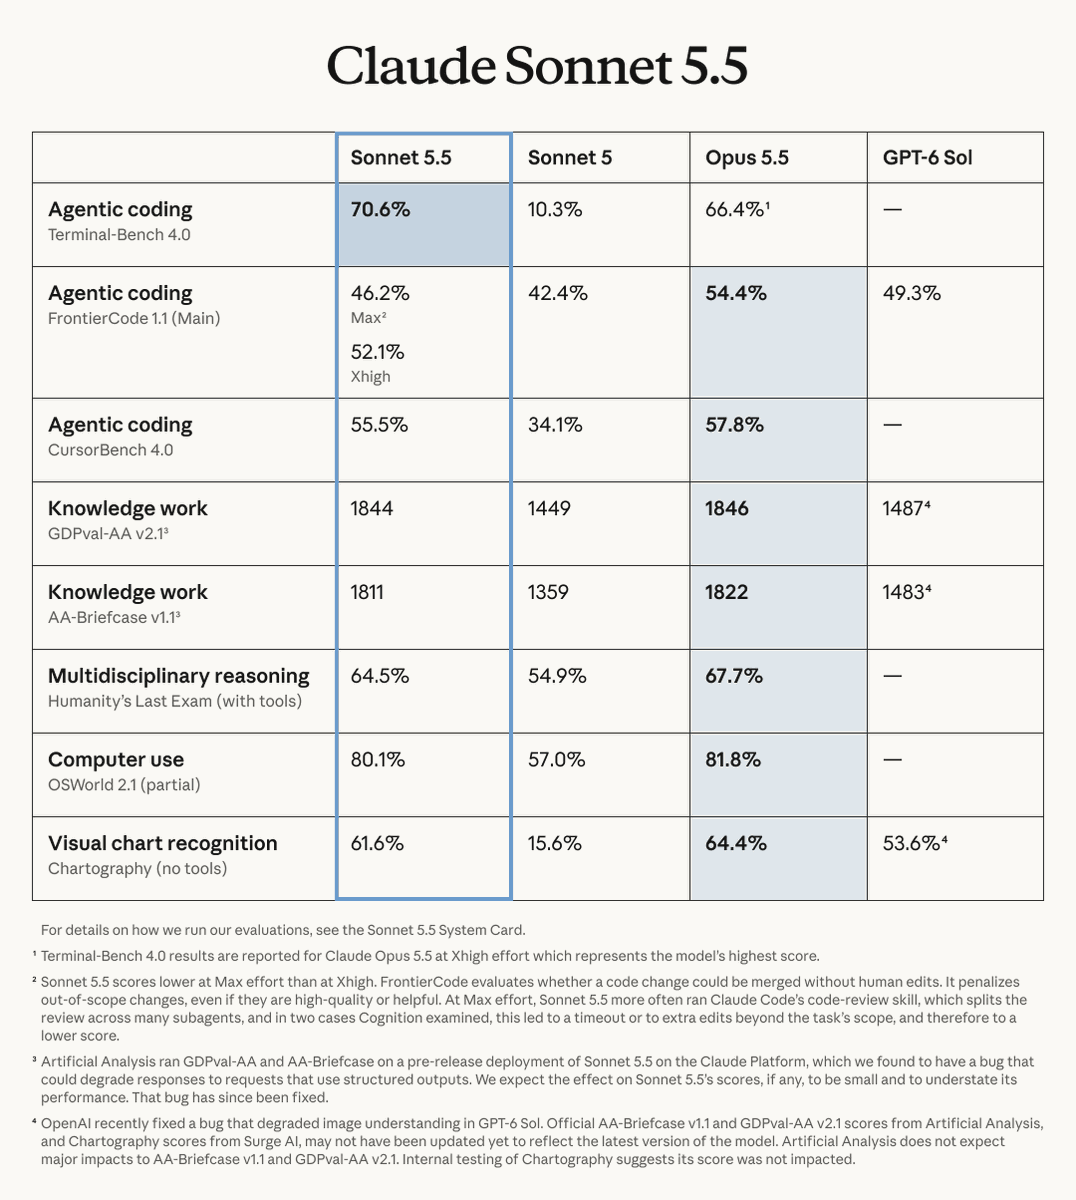
A tabela de lançamento compara o Sonnet 5.5 com o Sonnet 5, Opus 5.5 e GPT-6 Sol. O Sonnet 5.5 foi executado com esforço máximo, a menos que a linha indique o contrário.
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4% (xhigh) | n/i |
| FrontierCode 1.1 Principal (máx) | 46.2% | 42.4% | 54.4% | 49.3% |
| FrontierCode 1.1 Principal (xhigh) | 52.1% | 42.7% | 51.4% | 48.4% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | n/i |
| GDPval-AA v2.1 (Elo) | 1844 | 1449 | 1846 | 1487 |
| Humanity’s Last Exam (ferramentas) | 64.5% | 54.9% | 67.7% | n/i |
| OSWorld 2.1 (parcial) | 80.1% | 57.0% | 81.8% | n/i |
n/i: não informado. A linha FrontierCode xhigh é do gráfico por esforço da página de lançamento.
A Anthropic executou o Terminal-Bench, Humanity’s Last Exam e OSWorld ela mesma. A Cognition executou o FrontierCode, onde o Sonnet 5.5 obteve pontuação mais baixa no máximo: ele frequentemente dispersava subagentes de revisão, o que, nos casos examinados pela Cognition, causava um timeout ou edições fora do escopo. O Cursor executou o CursorBench; a Artificial Analysis executou o GDPval-AA. Leia a liderança do Terminal-Bench sobre o Opus com cuidado: a Artificial Analysis mediu o Sonnet 5.5 em 63.6% em sua própria execução, e o cartão do sistema diz que o fallback afetou 10% das tentativas do Opus contra 1.5% das do Sonnet.
O Sonnet 5.5 atinge 56 no Índice de Inteligência da Artificial Analysis, #3 de 216, atrás de dois endpoints do Opus 5.5 (o Sonnet 5 marcou 38). O problema é a verbosidade: o índice custou US$8.977 para ser executado com esforço máximo versus US$1.176 com esforço alto. A análise aprofundada dos benchmarks possui as tabelas por esforço.
Onde você pode usar o Claude Sonnet 5.5
| Interface | Acesso | Observações |
|---|---|---|
| API Claude | claude-sonnet-5-5 |
Créditos pré-pagos |
| Amazon Bedrock | anthropic.claude-sonnet-5-5 |
Inferência global entre Regiões apenas (Regiões comerciais); sem ferramentas estritas |
| Google Cloud, Microsoft Foundry, Plataforma Claude na AWS | claude-sonnet-5-5 |
Mesmo ID da API Claude |
| Claude.ai (web, iOS, Android) | Chat | Qualquer pessoa, incluindo Gratuito |
| Claude Code | claude --model claude-sonnet-5-5 |
Planos pagos, v2.1.284+; o padrão permanece Opus 5.5 |
| GitHub Copilot | VS Code, JetBrains, Copilot CLI e mais | Pro, Pro+, Max, Business, Enterprise |
| Cursor | claude-sonnet-5-5 |
Conjunto de Outros Modelos (Pro e superiores) |
| OpenRouter, Vercel AI Gateway | anthropic/claude-sonnet-5.5 |
US$2 / US$10; sem variante gratuita |
No Claude Code, o alias sonnet mapeia para Sonnet 5.5 apenas na API da Anthropic; no Bedrock, Google Cloud e Foundry, ele ainda resolve para Sonnet 4.5, então fixe o ID completo. Veja Sonnet 5.5 no Claude Code para planos e esforço. O changelog do Copilot do GitHub diz que a implantação é gradual.
Qualquer pessoa pode conversar com o Sonnet 5.5 no plano Claude Gratuito, mas um plano de chat não inclui uma chave de API, e o uso da API é pré-pago. Veja como usar o Sonnet 5.5 gratuitamente e se existe uma API Sonnet 5.5 gratuita.
Quem deve mudar para o Sonnet 5.5
- Você usa o Sonnet 5: mude. Preço e tokenizador são os mesmos, e o Sonnet 5.5 supera o Sonnet 5 em todas as linhas da tabela de lançamento. Reserve tempo para as mudanças que quebram a compatibilidade e uma varredura de esforço.
- Você usa o Opus 5.5 para tudo: direcione o trabalho bem delimitado (correções de bugs, documentos, revisões de código simples, tarefas de subagente) para o Sonnet 5.5 pela metade do preço de tabela, e mantenha o Opus para problemas abertos. A comparação entre Sonnet 5.5 e Opus 5.5 detalha isso por carga de trabalho.
- Você planeja operar com esforço alto ou superior: teste o Opus 5.5 com esforço mais baixo também. No Terminal-Bench 4.0, o Sonnet 5.5 com esforço alto pontua 43.0% por US$1.94 por tentativa; o Opus 5.5 com esforço médio pontua 57.6% por US$2.94. Os 70.6% do Sonnet no máximo custam US$12.54 por tentativa. Muitos comentaristas do Hacker News interpretam os gráficos desta forma: o nicho do Sonnet é esforço baixo ou médio, ou trabalho de subagente sob um orquestrador Opus.
- Seu trabalho é focado em segurança: a Anthropic alerta para um aumento de recusas "mesmo em tarefas benignas relacionadas à cibersegurança".
O que clientes iniciais relatam
Alegações de clientes da página de lançamento da Anthropic, não testes independentes:
- Slack: superou o Sonnet 5 em quase todas as avaliações offline do Slackbot sem mudanças de prompt e com cerca de 14% menos tokens de saída.
- Base44: em 118 compilações de aplicativos, igualou a qualidade do Opus 5 com 3.6 iterações por compilação versus 7.7 para o Opus 5.
- Balyasny Asset Management: em 2.441 tarefas financeiras, usou cerca de 121K tokens por resposta versus 497K para o Sonnet 5.
Envie sua primeira requisição Sonnet 5.5
curl https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-sonnet-5-5",
    "max_tokens": 16000,
    "output_config": {"effort": "medium"},
    "messages": [
      {"role": "user", "content": "List three risks of retrying a POST request without an idempotency key."}
    ]
  }'
O pensamento está ativado por padrão, então ignore o campo thinking. Omita temperature, top_p e top_k: valores não padrão retornam um 400. Recusas retornam como HTTP 200 com stop_reason: "refusal" e uma categoria stop_details, então verifique o corpo, não apenas o status.
No Apidog, cole o comando curl em uma nova requisição, mova a chave para uma variável de ambiente ANTHROPIC_API_KEY e afirme que stop_reason não é refusal nem max_tokens. Duplique-o com esforço low e high para comparar o usage. O guia da API Sonnet 5.5 aborda streaming, ferramentas e cache; nosso guia de chave API da Anthropic ajuda se você precisar de uma chave.
FAQ
Quando o Claude Sonnet 5.5 foi lançado? 28 de setembro de 2026, seis dias após o Opus 5.5.
Qual é a janela de contexto do Claude Sonnet 5.5? 1M tokens, com 128K de saída máxima (300K na API Batch com um cabeçalho beta). Prompts longos custam o mesmo por token que os curtos.
O Claude Sonnet 5.5 é gratuito? No aplicativo de chat Claude.ai, sim, incluindo no plano Gratuito. A API é pré-paga e o Claude Code requer um plano pago. Veja todas as rotas gratuitas.
Qual é a data de corte do conhecimento do Claude Sonnet 5.5? Junho de 2026.
O Sonnet 5.5 é o modelo padrão no Claude Code? Não. O padrão permanece Opus 5.5 em todos os planos pagos. Mude com /model ou claude --model claude-sonnet-5-5.
Próximo passo
Pegue uma carga de trabalho que você executa no Sonnet 5 ou Opus 5.5 hoje. Envie-a para claude-sonnet-5-5 em esforço low, medium e high, compare a qualidade e o usage, e mantenha a configuração mais barata que passe em suas verificações. Baixe o Apidog para manter essas requisições e afirmações em um único projeto, então use o detalhamento de preços para converter a contagem de tokens em uma fatura mensal.