
Claude Opus 5.5 é o mais novo modelo da linha Opus da Anthropic, lançado em 22 de setembro de 2026. Ele chegou no mesmo dia em que a OpenAI lançou o GPT-6 Sol e o GPT-6 Luna, e é por isso que seu feed passou aquela semana discutindo preço por token em vez de ler qualquer uma das páginas de lançamento.
Se você tem claude-opus-5 parado em um arquivo de configuração, aqui está a versão curta do que a mudança de id lhe rende. Opus 5.5 custa US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de tokens de saída, abaixo dos US$ 5 e US$ 25 do Opus 5. Ele carrega uma janela de contexto de 1.000.000 de tokens e uma saída máxima de 128.000 tokens. A Anthropic diz que ele roda 40% mais barato que o Opus 5, produz saída 30% mais rápido e permanece em uma única tarefa por 18 horas ou mais. No Artificial Analysis Intelligence Index, ele ocupa o primeiro lugar entre 212 modelos com uma pontuação de 58, embora esse índice seja uma medição de terceiros e não uma alegação do fornecedor.
Este guia cobre a ficha técnica, as oito pontuações de benchmark publicadas pela Anthropic, a aritmética de cache que decide sua conta real e as comparações que você deveria se recusar a fazer. Toda requisição abaixo é HTTP simples com JSON, então você pode montá-la e inspecioná-la no Apidog. Para o contexto mais amplo de três lançamentos de fronteira em dois dias, veja a guerra de preços de modelos de setembro de 2026.
Claude Opus 5.5 em resumo
| Especificação | Valor |
|---|---|
| ID do modelo na API | claude-opus-5-5 |
| Lançado em | 22 de setembro de 2026 |
| Preço de entrada | US$ 4 por milhão de tokens |
| Preço de saída | US$ 20 por milhão de tokens |
| Leitura de entrada em cache | US$ 0,20 por milhão de tokens |
| Gravação em cache | US$ 5 por milhão de tokens |
| Modo rápido | US$ 8 de entrada / US$ 40 de saída por milhão de tokens |
| Janela de contexto | 1.000.000 de tokens |
| Saída máxima | 128.000 tokens |
| Custo de execução vs. Opus 5 | 40% menos, segundo a Anthropic |
| Velocidade de saída vs. Opus 5 | 30% mais rápido, segundo a Anthropic |
| Duração sustentada da tarefa | 18+ horas na tarefa |
| Segurança | 85% menos tentativas bem-sucedidas de contornar limites |
| Disponibilidade | Plataforma Claude, AWS, Google Cloud, Azure |
| Artificial Analysis Intelligence Index | 58, classificado em 1º de 212 (terceiros) |
Duas linhas merecem uma segunda olhada. A taxa de leitura em cache de US$ 0,20 é 5% da taxa padrão de entrada, o que muda quais arquiteturas são acessíveis. E o número de 18 horas é uma alegação sobre persistência de tarefa, não sobre timeout de requisição. Esses são problemas de engenharia muito diferentes.
O que mudou em relação ao Opus 5
O id do modelo é a quebra óbvia. A Anthropic usa um nome de produto com ponto e um id de API sem ponto, então Claude Opus 5.5 é claude-opus-5-5. Uma substituição de string no seu config é o primeiro passo de migração.
| Claude Opus 5 | Claude Opus 5.5 | |
|---|---|---|
| ID do modelo na API | claude-opus-5 |
claude-opus-5-5 |
| Entrada por milhão | US$ 5 | US$ 4 |
| Saída por milhão | US$ 25 | US$ 20 |
Isso é um corte de 20% nos dois lados do medidor. A Anthropic diz separadamente que o Opus 5.5 custa 40% menos para rodar que o Opus 5, o que é uma medição diferente e vale manter em mente. Um corte de preço por token somado a menos tokens gastos para terminar o mesmo trabalho se acumula em uma queda maior no custo por tarefa. Custo por token é o que você verifica em uma fatura. Custo por tarefa é o que o fornecedor mediu em suas próprias avaliações, então reproduza isso na sua carga de trabalho antes de orçar com base nisso.
O restante do delta é comportamental: saída 30% mais rápida, 18 horas ou mais de trabalho sustentado em uma tarefa e 85% menos tentativas bem-sucedidas de contornar limites. Esse último número é uma alegação de segurança restrita, não um selo genérico de “mais seguro”. Nosso artigo sobre injeção de prompt e segurança de API explica o que ele mede. Para a ficha técnica da geração anterior, veja o que é o Claude Opus 5.
As oito pontuações de benchmark publicadas pela Anthropic
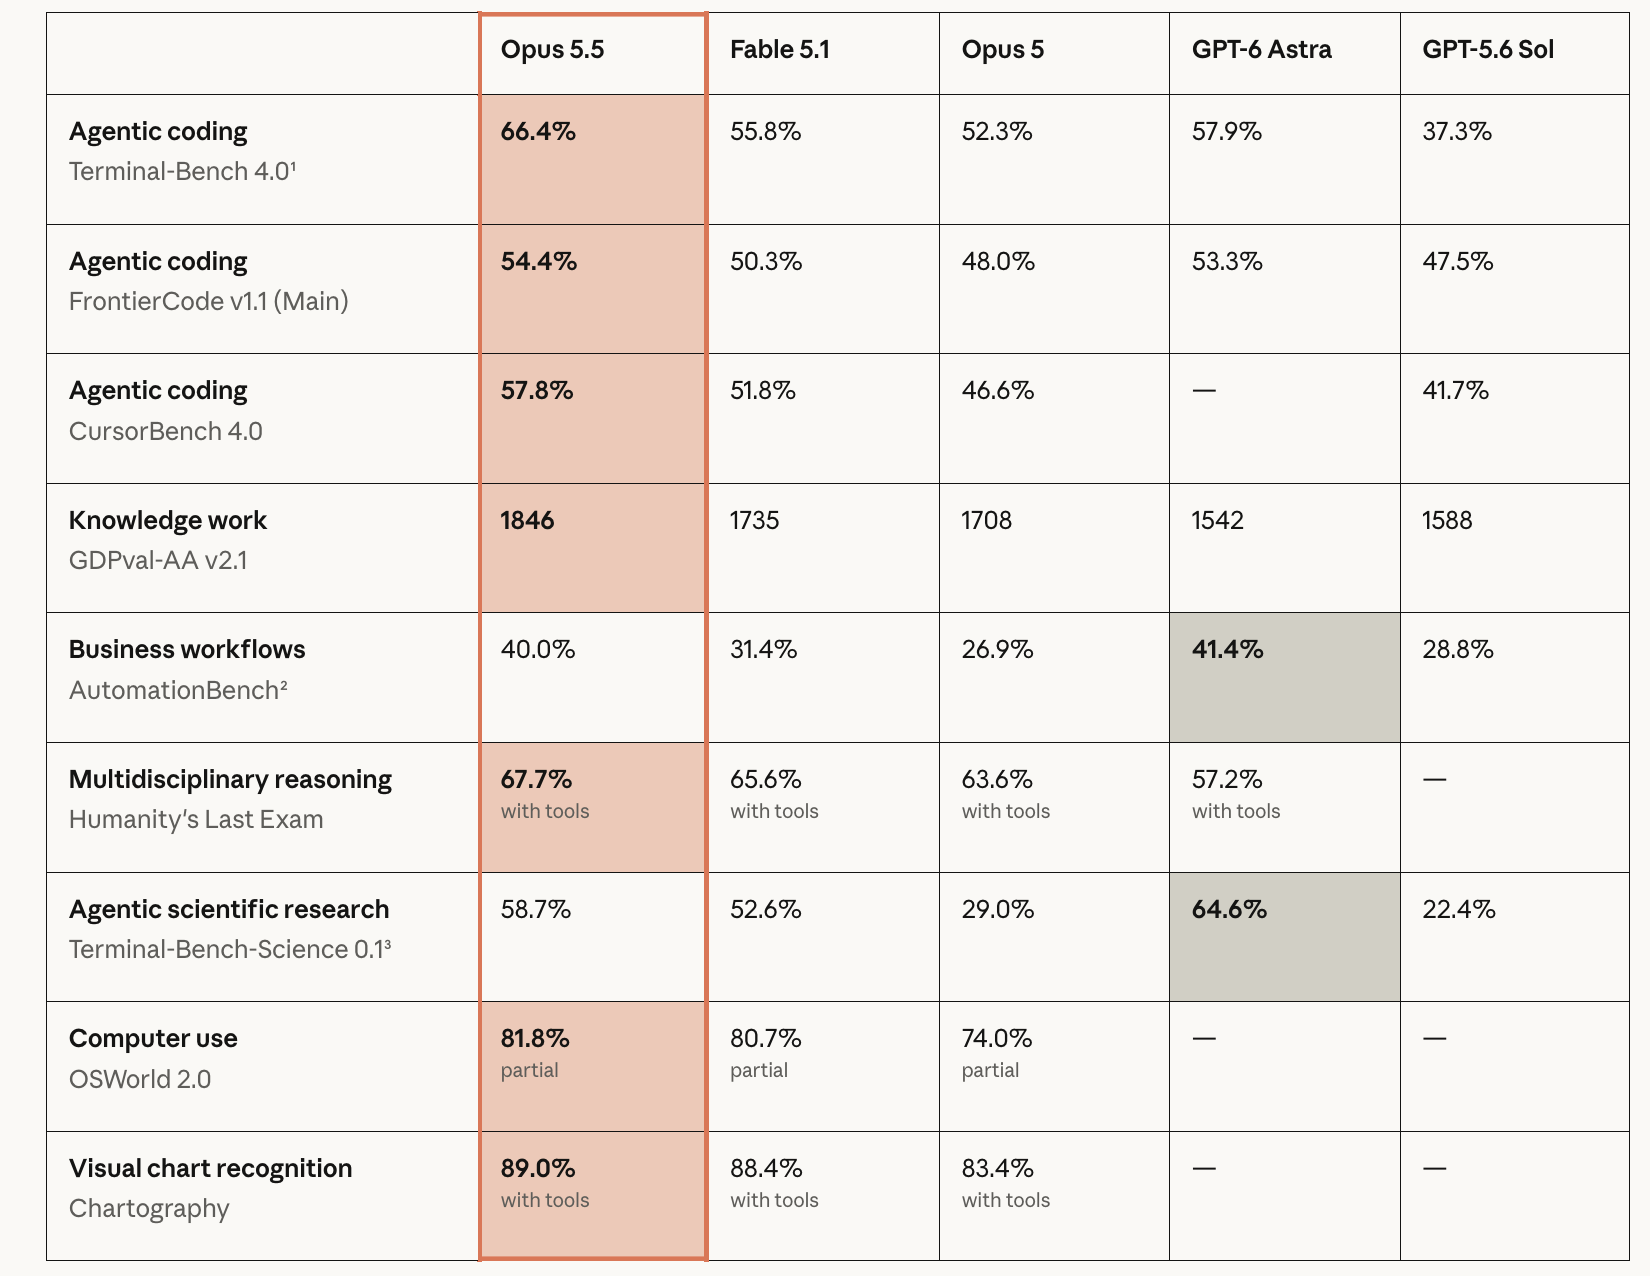
Estes são números executados pela Anthropic em seu próprio material de lançamento.
| Benchmark | Claude Opus 5.5 |
|---|---|
| Terminal-Bench 4.0 | 66,4% |
| FrontierCode v1.1 | 54,4% |
| CursorBench 4.0 | 57,8% |
| GDPval-AA v2.1 | 1846 Elo |
| AutomationBench | 40,0% |
| Humanity’s Last Exam, com ferramentas | 67,7% |
| OSWorld 2.0 | 81,8% |
| Chartography | 89,0% |
Observe o que está faltando: colunas opostas. A Anthropic publicou pontuações, não uma grade comparativa direta contra o GPT-6, então qualquer pessoa que lhe mostrar uma tabela organizada de Opus 5.5 versus Astra montada a partir dessas linhas a montou por conta própria.
AutomationBench é a armadilha, porque aparece nos materiais de lançamento dos dois fornecedores. Os números da OpenAI são do AutomationBench 1.0.6 e colocam o GPT-6 Sol com raciocínio extra-alto em 33,2%, o GPT-6 Astra no baixo em 30,3%, e o Claude Opus 5 no máximo em 26,9%. Os 40,0% da Anthropic para o Opus 5.5 vêm de sua própria execução, e a versão e o nível de esforço não são declarados no material que verificamos. Dois fornecedores, dois harnesses, dois ajustes de esforço, possivelmente duas versões de benchmark. Não subtraia um do outro e chame a diferença de vantagem.
Onde o Opus 5.5 se posiciona no cenário de 22 de setembro
| Modelo | ID da API | Entrada $/M | Saída $/M | Contexto | Índice AA |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5-5 |
US$ 4 | US$ 20 | 1M | 58 |
| GPT-6 Sol | gpt-6-sol |
US$ 2 | US$ 10 | 872k | 48 |
| GPT-6 Luna | gpt-6-luna |
US$ 0,10 | US$ 0,50 | 1M | 37 |
| GPT-6 Astra | n/a | US$ 10 | US$ 50 | n/a | n/a |
| Claude Opus 5 | claude-opus-5 |
US$ 5 | US$ 25 | n/a | n/a |
| Grok 4.7 | n/a | US$ 2 | US$ 6 | n/a | n/a |
A coluna Artificial Analysis é um índice de terceiros, não uma alegação de fornecedor, e um único número composto representa muitas tarefas bem diferentes. Trate-o como uma ordem de classificação, não como um veredito.
Há uma coisa genuinamente útil a notar sobre o timing. O post de lançamento da OpenAI compara Sol e Luna com o Claude Opus 5, porque o Opus 5.5 não existia quando aquele post foi escrito. A Anthropic lançou o Opus 5.5 horas depois, 20% abaixo do preço do Opus 5. Então a frase amplamente citada de que o Sol em extra-alto supera o Opus 5 no máximo por 9% do custo por tarefa é verdadeira como escrita e medida contra um modelo que foi superado no mesmo dia. Ninguém publicou a nova execução.
A afirmação inversa é igualmente sem suporte. A OpenAI declara que o Astra “continua sendo nosso melhor modelo em todos os aspectos”, e nenhum dos fornecedores publicou uma comparação Astra versus Opus 5.5. Os números específicos de confronto direto circulando no X são tweets, não dados de fornecedor. Se você precisa dessa resposta, a única fonte honesta é seu próprio harness de avaliação nas suas próprias tarefas.
A aritmética de cache que decide sua conta
Com US$ 4 de entrada e US$ 0,20 por uma leitura em cache, um acerto de cache custa 5% de uma leitura nova. Gravações em cache são cobradas a US$ 5 por milhão, um prêmio de 25% sobre a taxa padrão de entrada. Essa proporção torna o ponto de equilíbrio raso.
Considere um prefixo de sistema de 200.000 tokens, um schema de ferramenta mais um trecho do seu codebase ou spec. Sem cache, cada chamada cobra 200.000 tokens a US$ 4 por milhão, ou seja, US$ 0,80 cada. Dez chamadas custam US$ 8,00 só de entrada.
Com cache, você paga a gravação uma vez a US$ 5 por milhão, ou seja, US$ 1,00, depois cada leitura subsequente é cobrada a US$ 0,20 por milhão, ou seja, US$ 0,04. Dez chamadas custam US$ 1,00 mais nove leituras a US$ 0,04, o que dá US$ 1,36. O prêmio de gravação é pago na primeira releitura, e na décima chamada você paga cerca de 17% da conta sem cache.
No topo da faixa, enviar a janela completa de 1.000.000 de tokens custa US$ 4,00 como entrada nova e US$ 0,20 como leitura em cache. Essa é a diferença entre uma estratégia de contexto que você pode executar em loop e uma que você não pode. O modelo completo de custo de cache percorre loops de agente e prefixos multilocatário.
O modo rápido é cobrado a US$ 8 de entrada e US$ 40 de saída, exatamente o dobro da taxa padrão. Precifique-o como uma compra de latência para caminhos interativos, não como padrão.
O que 18 horas na tarefa faz com sua camada de API
Um modelo que trabalha por 18 horas não é uma requisição mais longa. É um formato de integração diferente, e a maior parte do código de API escrito para chat completions vai quebrar com isso.
Quatro coisas precisam de atenção. Timeouts no balanceador de carga, gateway e cliente devem tolerar streams de longa duração, ou você precisa de um design de job mais polling. Retentativas devem ser idempotentes, porque repetir uma requisição que já queimou três horas de chamadas de ferramenta é caro de um jeito que um GET repetido nunca é. Streaming precisa de tratamento de keepalive para que uma conexão aparentemente ociosa não seja encerrada no meio da tarefa. E a retomabilidade importa mais que a vazão: se o processo morre na hora 11, você precisa saber qual estado era durável. O artigo de design de API para tarefas de 18 horas cobre cada um com padrões concretos.
Chamando o Claude Opus 5.5
O formato da API Messages não mudou. Troque o id e dê espaço real a max_tokens.
curl https://api.anthropic.com/v1/messages \
  --header "x-api-key: $ANTHROPIC_API_KEY" \
  --header "anthropic-version: 2023-06-01" \
  --header "content-type: application/json" \
  --data '{
    "model": "claude-opus-5-5",
    "max_tokens": 16384,
    "messages": [
      {"role": "user", "content": "Review this handler and list the failure modes."}
    ]
  }'
Dois hábitos compensam imediatamente. Mantenha a chave em uma variável de ambiente para que ela nunca acabe em uma coleção compartilhada. E leia o bloco usage em cada resposta, porque é ali que você confirma que as leituras em cache estão acontecendo, em vez de serem silenciosamente recobradas a US$ 4 por milhão. Um cache que erra silenciosamente parece exatamente uma integração funcionando até a fatura chegar.
É aqui que um cliente de API se paga. No Apidog, você pode salvar uma requisição Messages de linha de base, duplicá-la para streaming e não streaming, executar ambas com o mesmo prompt e fazer asserções nos campos usage para que uma regressão de cache falhe em um teste em vez de surpreendê-lo no fim do mês. O visualizador de SSE também mostra onde um stream longo realmente parou. Baixe o Apidog e importe a requisição acima para acompanhar.
Disponibilidade
A Anthropic lista o Opus 5.5 na Plataforma Claude, AWS, Google Cloud e Azure. Os níveis do app de consumidor e o corte de conhecimento não estão no material que verificamos, então não estamos imprimindo nenhum dos dois. Verifique a página do modelo da Anthropic antes de escrever uma data de corte em um prompt de sistema.
Você deve migrar?
Migre se você está no claude-opus-5 hoje. Mesmo nível, 20% menos por token nos dois lados, números publicados melhores, e o único custo é a troca de id mais uma execução de regressão. As notas de migração cobrem os detalhes visíveis ao chamador.
Pense com mais cuidado se sua carga de trabalho é barata e de alto volume. O preço do nível Opus não é onde classificação ou extração em massa pertence, e os lançamentos de setembro colocaram uma janela de contexto de 1M no nível abaixo de um dólar. Compare com esse nível antes de usar o Opus por padrão.
E meça antes de acreditar em qualquer alegação entre fornecedores daquela semana, incluindo a tabela acima. Dois laboratórios lançaram três modelos de fronteira no mesmo dia, toda comparação publicada foi escrita contra um modelo que já havia sido substituído, e o único benchmark que resolve sua decisão é o que executa suas próprias requisições.