
Together AI, Fireworks AI e Groq vendem o mesmo discurso: aponte seu cliente OpenAI existente para uma nova URL base, troque a chave e obtenha modelos de pesos abertos por uma fração do custo. Esse discurso é verdadeiro. O que não é verdade é que comparar seus níveis gratuitos seja tão simples quanto alinhar três números lado a lado, porque dois dos três provedores não publicam um número fixo.
Groq é a exceção: sua página de limites de taxa realmente publica números reais do Plano Gratuito, por modelo, em uma aba que a maioria dos leitores ignora a caminho da aba do Plano Desenvolvedor ao lado. A Together AI nos disse claramente, em sua própria documentação, que não tem limites fixos por modelo para publicar; seu teto se move com seu uso. A Fireworks AI vincula seu acesso gratuito a um saldo de crédito único em vez de um nível de plano. Três designs diferentes, e um artigo do tipo “qual nível gratuito é maior” ainda não consegue reduzir isso a um único número.
TL;DR
Groq, Together AI e Fireworks AI todos expõem um endpoint compatível com OpenAI, então alternar entre eles é uma URL base e uma chave de API, não uma reescrita. A Groq divide o acesso em um Plano Gratuito e um Plano Desenvolvedor pago e, diferentemente das outras duas, publica números reais do Plano Gratuito por modelo, como 30 RPM / 1K RPD / 8K TPM / 200K TPD em gpt-oss-120b e gpt-oss-20b. A Together AI não publica números fixos do nível gratuito; sua documentação diz que os limites se movem dinamicamente com sua capacidade ativa e uso bem-sucedido recente. A Fireworks AI dá a novas contas um saldo de crédito único (US$ 1, conforme sua página de preços) em vez de uma cota gratuita recorrente. A decisão que importa mais do que o número principal é quais modelos você realmente precisa e como o teto de cada provedor se comporta quando você o atinge. O Apidog permite que você salve uma requisição e troque a URL base e a chave por ambiente, para que você possa medir todos os três por conta própria em vez de confiar em uma tabela.
Uma forma de API, três chaves
Todos os três provedores espelham deliberadamente o esquema de Chat Completions da OpenAI. É por isso que os guias de migração para essas ferramentas leem sempre da mesma forma: mude base_url, mude o cabeçalho Authorization, mantenha o resto do seu código. A base compatível com OpenAI da Groq é https://api.groq.com/openai/v1/. A da Together AI é https://api.together.ai/v1, confirmada diretamente em seus documentos de início rápido. A da Fireworks AI é https://api.fireworks.ai/inference/v1, conforme seu guia de compatibilidade com OpenAI.
Essa forma compartilhada é o motivo pelo qual um teste comparativo vale a pena: adicionar um quarto ou quinto provedor custa minutos, não um redesenho. Cobrimos a mecânica de gerenciar esse tipo de configuração multiprovedor em como gerenciar URLs base entre ambientes no Apidog, e se você está avaliando opções de roteamento de forma mais ampla, nossa análise de alternativas ao OpenRouter cobre onde cada um desses três se encaixa nesse cenário.
O que você pode realmente verificar sobre cada nível gratuito
Aqui está a comparação construída apenas com o que cada provedor declara publicamente em setembro de 2026. Onde um provedor não divulga um número, a tabela diz isso em vez de adivinhar.
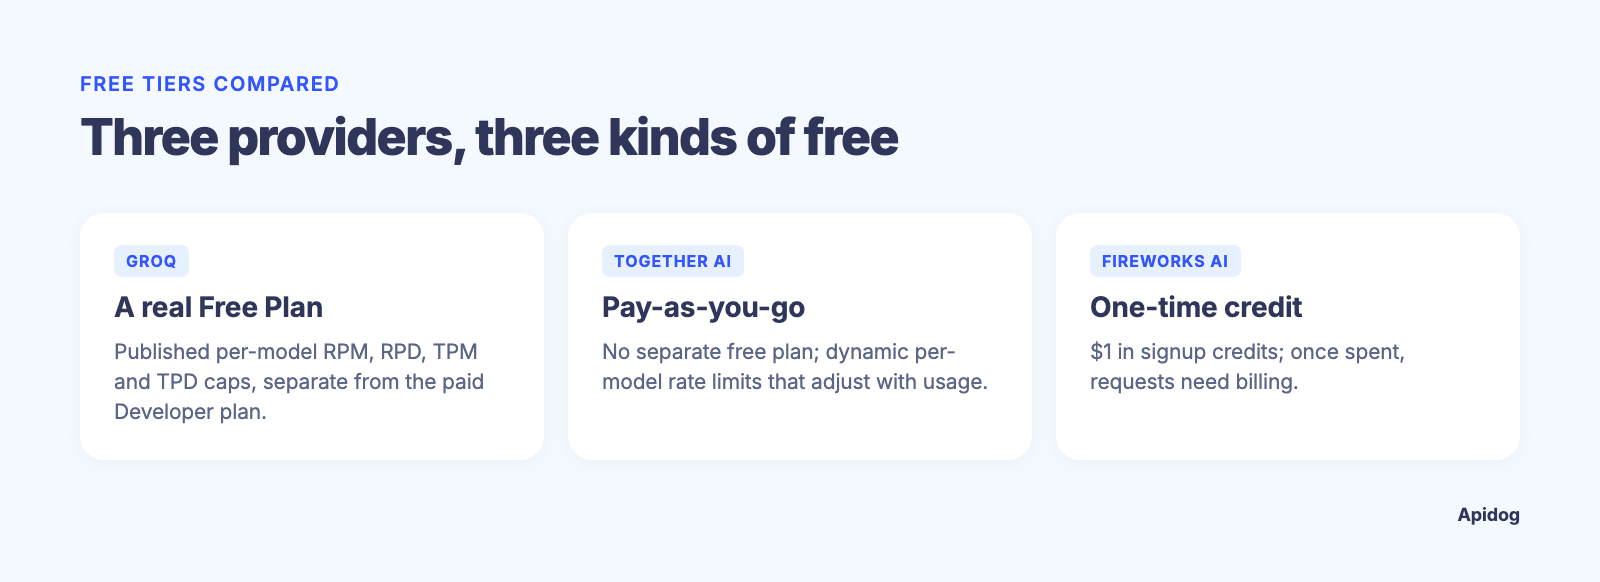
| Groq | Together AI | Fireworks AI | |
|---|---|---|---|
| Modelo de acesso gratuito | Plano Gratuito (separado do Plano Desenvolvedor pago) | Pagamento conforme o uso desde a inscrição; sem nome separado de “plano gratuito” | Crédito único de inscrição |
| Cota gratuita documentada | Publicada por modelo: gpt-oss-120b/gpt-oss-20b 30 RPM, 1K RPD, 8K TPM, 200K TPD; compound 30 RPM, 250 RPD, 70K TPM (conforme limites de taxa da Groq, lido em 2026-09-15) |
Não publicada como números fixos; descrita como dinâmica por organização | US$ 1 em créditos gratuitos conforme preços da Fireworks |
| Como os limites são moldados | Limites por modelo de RPM/RPD/TPM/TPD, aplicados no nível da organização | Taxa dinâmica por modelo, ajusta-se com sua capacidade ativa e uso bem-sucedido recente | Baseado em gastos; uma vez usado o crédito, as requisições precisam de cobrança habilitada |
| Onde verificar seus próprios números | console.groq.com/settings/limits |
Cabeçalhos de resposta em chamadas ativas, por exemplo x-ratelimit-reset |
Painel da conta e página de cobrança |
| Tokens em cache contam contra os limites? | Não, conforme a própria documentação da Groq | Não declarado nas páginas que verificamos | Não declarado nas páginas que verificamos |
Duas coisas se destacam quando você realmente lê as páginas de origem em vez de um resumo de especificações. Primeiro, os números do Plano Gratuito da Groq acima são padrões publicados; a mesma página também traz uma aba do Plano Desenvolvedor com tetos mais altos, e console.groq.com/settings/limits é a autoridade se os seus forem diferentes. Segundo, a limitação de taxa da Together AI não é uma tabela. Sua própria página de limites de taxa afirma claramente que “não há limites fixos por modelo publicados”, e que seu teto aumenta com “tráfego sustentado e bem-sucedido”. Esse é um modelo significativamente diferente de uma linha estática de nível gratuito, e significa que a resposta honesta para “qual é o RPM gratuito da Together” é “verifique seus cabeçalhos de resposta”, não um número tirado de uma tabela.
Se você quer os aprofundamentos de um único provedor com números verificáveis para um produto de cada vez, veja nossos artigos complementares sobre o nível gratuito da API Groq e o nível gratuito da API Cerebras. Este artigo é o hub; aqueles dois fazem a investigação por provedor em profundidade.
Requisições vs tokens, fixo vs dinâmico
A verdadeira diferença de design entre esses três não é o tamanho da cota gratuita, é a forma do teto.
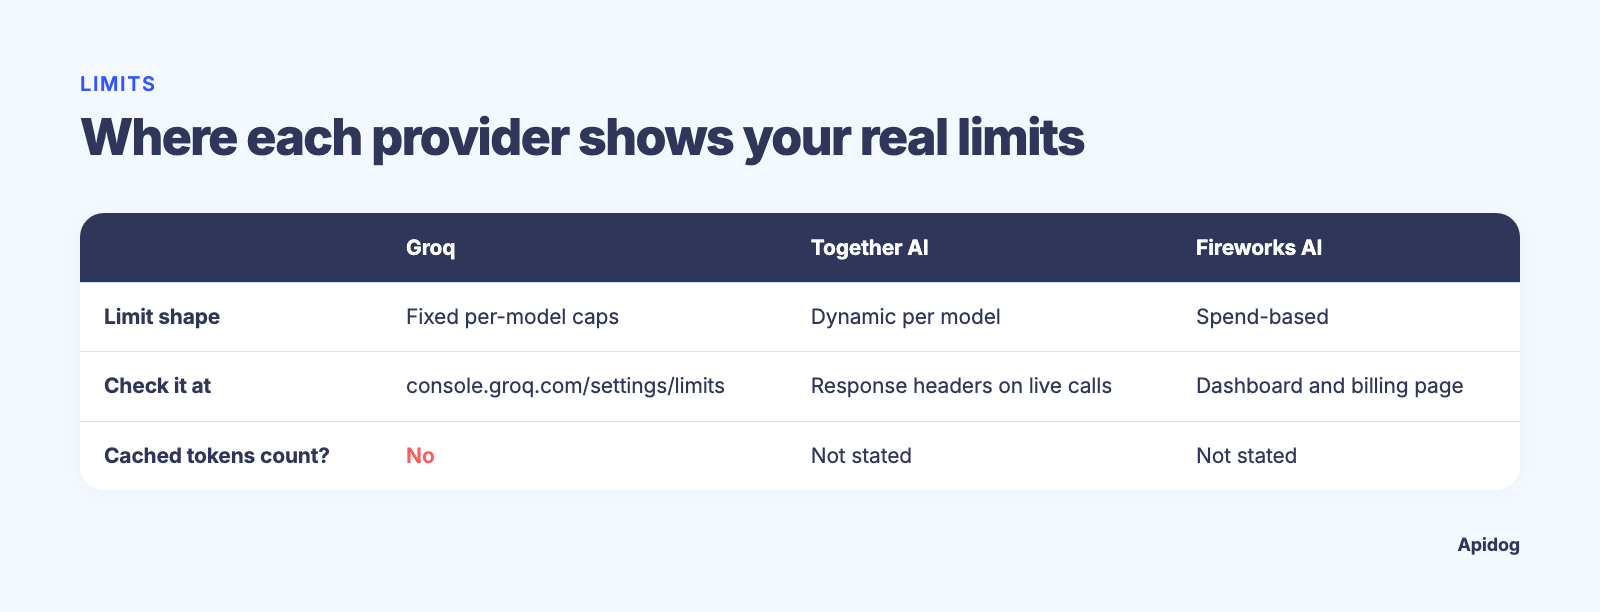
O modelo da Groq é o que a maioria dos desenvolvedores já conhece por trabalhar com limites de taxa em outros lugares: um teto fixo por janela de tempo, dividido por RPM, RPD, TPM e TPD, e aplica-se no nível da organização em vez de por chave de API. Isso significa que se você criar três chaves para três serviços sob uma conta Groq, elas compartilham um único pool. Nosso guia geral sobre limites de taxa da API GPT cobre essa mesma estrutura de RPM/TPM com mais profundidade, caso você ainda não tenha trabalhado com limites baseados em tokens antes.
O modelo da Together AI recompensa tráfego constante e bem-sucedido em vez de punir tráfego em rajadas com uma parede rígida. Uma conta quieta e uma conta pesada e bem comportada não recebem o mesmo teto, porque o teto se ajusta ao histórico recente da sua própria conta e à capacidade ativa do modelo naquele momento. Isso é uma boa notícia se sua carga de trabalho é confiável, e uma incógnita genuína se seu tráfego é em rajadas por natureza.
A Fireworks AI contorna quase totalmente o design de limites de taxa para novos usuários ao vincular o período gratuito a um saldo em dólares em vez de uma janela de taxa de requisições. Você não é limitado pela velocidade com que chama a API; você é limitado por quanto suas chamadas custam antes que o saldo acabe. Isso muda a pergunta de planejamento de “quantas requisições por minuto” para “quantos tokens US$ 1 pode comprar ao preço por token deste modelo”, o que depende inteiramente de qual modelo você escolher.
Eles são apostas diferentes sobre que tipo de uso um nível “gratuito” deve proteger: volume sustentado, picos de rajada ou gasto total. Qualquer um contra o qual você esteja construindo, você eventualmente atingirá um 429, e como um provedor sinaliza esse momento importa tanto quanto o número que o acionou. Nosso guia de solução de problemas de limite de taxa excedido explica como ler esses cabeçalhos de resposta e construir lógica de retentativa que não piore o problema.
Comprove você mesmo em cinco minutos
Dado quanto desses dados fica atrás de uma tela de login ou de um cabeçalho de resposta ativo, o caminho mais rápido para uma resposta real não é outro artigo de especificações, é um teste que seu agente de codificação executa contra todos os três. Com o Apidog CLI isso é um prompt. Configure uma vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
O token vem do Apidog em Configurações da Conta, Token de Acesso à API. Então dê um prompt ao agente:
Use Apidog CLI on project <id>. Create Groq, Together and Fireworks environments
with the OpenAI-compatible base URLs from this article and a comparable model id
in a MODEL variable. Add POST /chat/completions with Bearer auth from {{API_KEY}}
and one test case with an identical prompt and max_tokens. Run it once per
environment with that provider's key, then compare status, latency and the
x-ratelimit headers.
Os comandos que ele executa, verificados com o Apidog CLI 2.2.7:
apidog environment create Groq --project <id> --base-url https://api.groq.com/openai/v1
apidog environment create Together --project <id> --base-url https://api.together.ai/v1
apidog environment create Fireworks --project <id> --base-url https://api.fireworks.ai/inference/v1
apidog cli-schema validate test-case-create --file chat-case.json
apidog test-case create --project <id> --file chat-case.json
apidog run --test-case <caseId> --project <id> -e <togetherEnvId> \
  --env-var "API_KEY=$TOGETHER_API_KEY" -r cli,json
Alternar provedores agora é um ID de ambiente, não uma reescrita. Os cabeçalhos são onde o teto dinâmico da Together AI aparece em tempo real e onde você pode confirmar que sua organização Groq corresponde à tabela publicada do Plano Gratuito. Mantenha a latência na comparação também: um modelo que é tecnicamente gratuito mas lento não é realmente mais barato quando você conta o tempo gasto contornando-o. Isso transforma três páginas de marketing em um conjunto de dados comparável da sua própria conta. Executando a comparação continuamente dentro de uma construção de agente maior? Nosso guia sobre ferramentas de teste de API para agentes de IA cobre isso, e Apidog CLI no Cursor mostra a configuração do agente.
Qual nível gratuito se adapta ao seu caso de uso
Com base apenas no que é verificável hoje, algumas recomendações honestas:
- Limites previsíveis por modelo que você pode ler sem fazer login: A Groq publica números reais do Plano Gratuito (30 RPM / 1K RPD / 8K TPM / 200K TPD nos modelos
gpt-oss), e sua janela de contexto de 131.072 tokens emllama-3.1-8b-instant,llama-3.3-70b-versatilee os modelosopenai/gpt-osscobre uma ampla variedade de cargas de trabalho de pesos abertos em um único endpoint. - Tráfego constante e bem comportado, sem interesse em rastrear limites de taxa: O modelo dinâmico da Together AI se encaixa nesse padrão; uso sustentado bem-sucedido eleva seu próprio teto ao longo do tempo em vez de limitá-lo a um número definido no primeiro dia.
- Zero atrito de configuração, confortável em atingir uma parede de gastos: O acesso gratuito baseado em crédito da Fireworks AI testa o preço real por token desde a primeira chamada, útil quando a pergunta real é o custo em escala e não a contagem de requisições.
Todos os três hospedam subconjuntos diferentes de modelos de pesos abertos, e um modelo que se adapta à sua tarefa em um provedor pode não existir em outro.
FAQ
A Together AI, Fireworks AI e Groq usam todas o SDK da OpenAI? Sim. Todos os três documentam endpoints compatíveis com OpenAI, então a biblioteca cliente openai padrão funciona com qualquer um deles depois que você muda a URL base e a chave.
Qual provedor tem o maior nível gratuito? Não de uma forma que você possa comparar diretamente. A Groq publica números reais do Plano Gratuito por modelo (30 RPM / 1K RPD / 8K TPM / 200K TPD em gpt-oss-120b/gpt-oss-20b), a Together AI não define um número fixo, e a Fireworks AI vincula o acesso gratuito a um saldo de crédito único em vez de uma cota. Verifique console.groq.com/settings/limits se os seus forem diferentes.
Os limites de taxa se aplicam por chave de API ou por conta? Para a Groq, os limites se aplicam no nível da organização, então múltiplas chaves sob uma conta compartilham o mesmo pool, conforme sua própria documentação de limites de taxa. A Together AI e a Fireworks AI não declaram isso explicitamente nas páginas que verificamos; verifique em seu próprio painel antes de assumir o contrário.
O que acontece quando atinjo um limite de taxa em qualquer um desses provedores? Você receberá uma resposta HTTP 429. Os detalhes diferem; veja nosso guia de limite de taxa excedido para saber como ler os cabeçalhos de retentativa que a maioria das APIs compatíveis com OpenAI retorna, e construir lógica de backoff em vez de adivinhar.
Há uma maneira mais rápida de comparar esses do que ler cada página de documentação? Faça seu agente de codificação executar um caso de teste do Apidog CLI contra três ambientes, como descrito acima. Vinte minutos com o Apidog CLI lhe dirão mais sobre sua carga de trabalho real do que qualquer tabela de comparação, incluindo esta.