
Para executar o Qwen 3.8 27B localmente, instale o Ollama e execute ollama pull qwen3.8:27b, depois ollama run qwen3.8:27b. O build padrão é um download de 18 GB em 4 bits, então você vai querer uma GPU com 24 GB de VRAM ou um Mac com 32 GB de memória unificada. Os pesos são Apache-2.0, ou seja, o modelo em si não custa nada. Seu único custo é hardware e eletricidade.
Essa é a versão curta. O restante deste guia cobre os quatro runners que valem a pena usar (Ollama, LM Studio, llama.cpp e MLX), quanta memória cada quantização exige, que velocidade esperar em hardware real e como fazer seu agente de código testar o endpoint local com a Apidog CLI depois que ele estiver no ar.
Novo na família? O que é o Qwen 3.8 cobre o modelo Max flagship de 2,4 trilhões de parâmetros. Este guia é sobre o seu irmão menor e denso, que cabe na sua mesa.
O que é o Qwen 3.8 27B?
O Qwen 3.8 27B é um modelo de visão-linguagem denso de 27 bilhões de parâmetros da equipe Qwen da Alibaba, lançado em agosto de 2026 sob licença Apache-2.0. Ele lê texto, imagens e vídeo, raciocina antes de responder por padrão e tem uma janela de contexto nativa de 262.144 tokens que se estende até 1 milhão de tokens com escalonamento YaRN.
A ficha oficial do modelo lista estas especificações:
| Especificação | Qwen 3.8 27B |
|---|---|
| Parâmetros | 27B denso (o Hub lista 28B incluindo o codificador de visão) |
| Camadas | 64, um híbrido de blocos Gated DeltaNet e Gated Attention |
| Contexto | 262.144 nativo, até 1.000.000 com YaRN |
| Entradas | Texto, imagem, vídeo |
| Raciocínio | Ativo por padrão, reasoning_effort de xhigh, medium ou low |
| Extras | Camadas de predição multi-token (MTP) |
| Licença | Apache-2.0 |
Na própria tabela de benchmarks da Qwen, ele pontua 61,7 no SWE-bench Pro, 73,0 no Terminal Bench 2.1 e 89,2 no GPQA Diamond. Esses são números do fornecedor. Nossa análise dos benchmarks do Qwen 3.8 explica como ler essa tabela, incluindo quais linhas a Qwen construiu internamente.
Por que isso importa localmente: um modelo denso de 27B em 4 bits cabe em uma única GPU de consumo, com chamadas de ferramentas, visão e raciocínio no mesmo arquivo.
Quanta RAM e VRAM você precisa para o Qwen 3.8 27B?
Planeje com base no tamanho do arquivo da sua quantização mais 3 a 6 GB para o cache KV e o runtime. Para o Q4_K_M padrão, isso significa 24 GB de VRAM em uma GPU ou um Mac de 32 GB.
Aqui estão os tamanhos dos arquivos GGUF do repositório de quantizações da unsloth, verificados em 9 de novembro de 2026:
| Quantização | Tamanho do arquivo | Hardware realista |
|---|---|---|
| UD-IQ2_XXS | 7,27 GB | Mac de 16 GB ou GPU de 12 GB, perda de qualidade perceptível |
| UD-Q3_K_XL | 13,1 GB | GPU de 16 GB, Mac de 24 GB |
| UD-Q4_K_M | 16,5 GB | GPU de 24 GB, Mac de 32 GB (o ponto ideal) |
| UD-Q5_K_M | 19,8 GB | GPU de 24 GB com contexto curto, Mac de 32 GB |
| UD-Q6_K | 22 GB | GPU de 32 GB, Mac de 48 GB |
| Q8_0 | 29 GB | GPU de 48 GB, Mac de 64 GB |
O projetor de visão (mmproj-F16.gguf) adiciona 928 MB se você quiser entrada de imagens. A tag padrão qwen3.8:27b do Ollama tem 18 GB porque inclui visão.
O comprimento do contexto é o custo oculto. O cálculo de planejamento do llm-speed coloca o Q4_K_M em cerca de 21,9 GB com um contexto de 32.000 tokens. É por isso que placas de 24 GB são o piso prático para Q4, e por que você não deveria carregar a janela completa de 262K a menos que tenha memória de sobra.
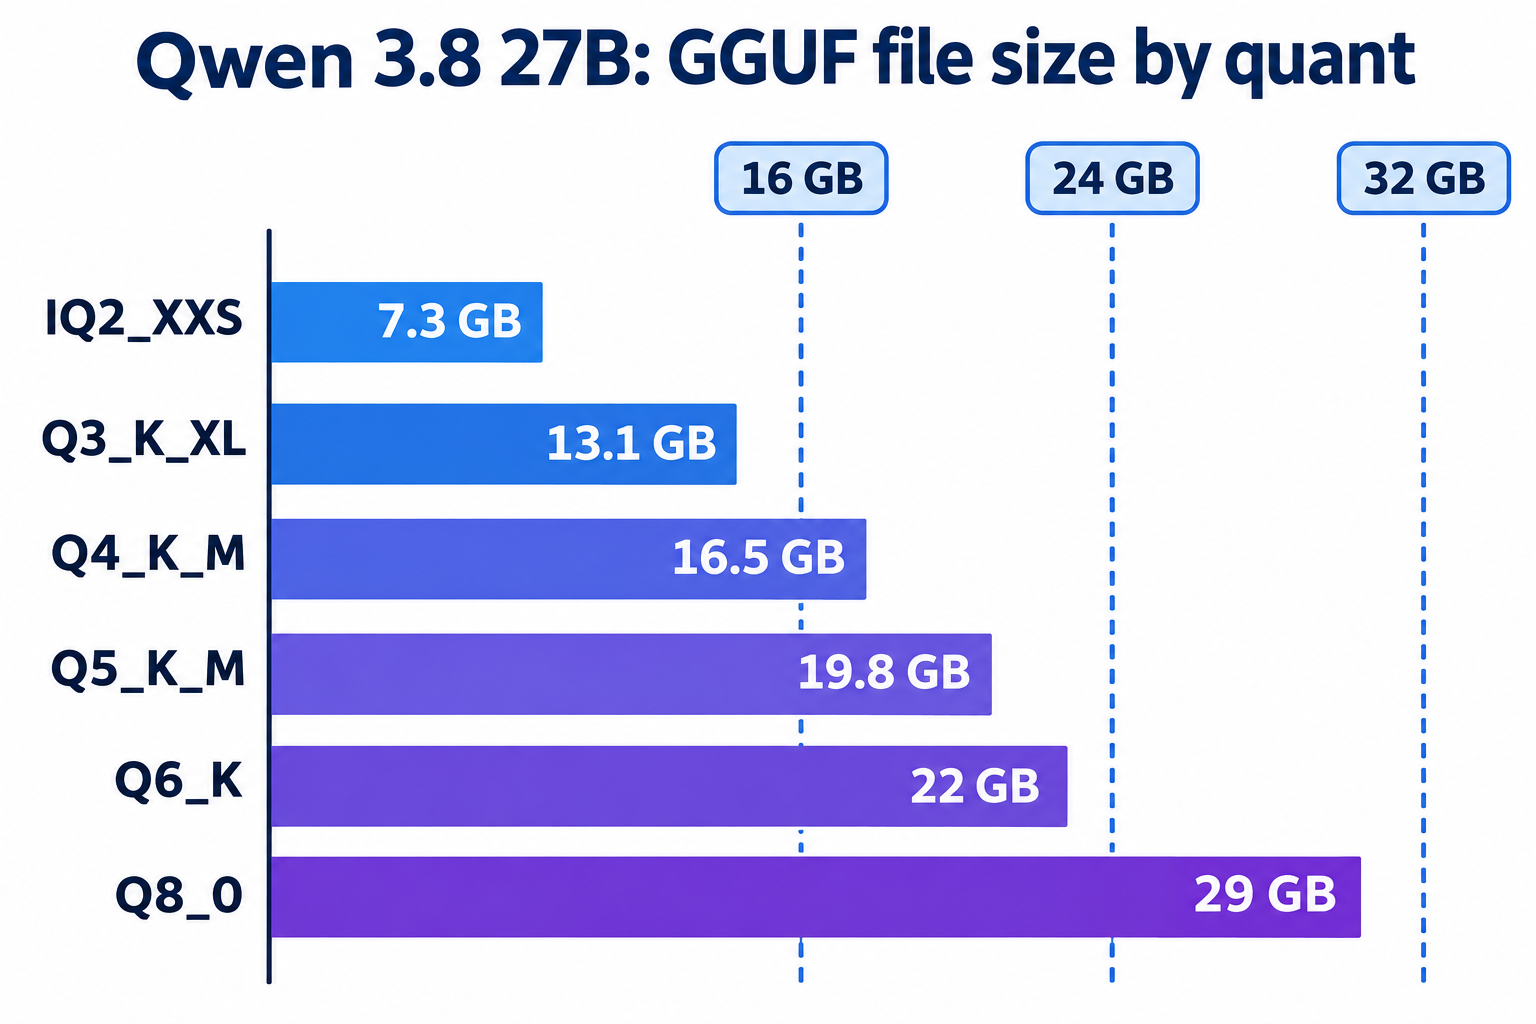
Em Macs, lembre-se de que o macOS reserva parte da memória unificada para o sistema. Um Mac de 24 GB tecnicamente consegue carregar o Q4_K_M, mas sobrar pouco espaço para contexto ou seu navegador. Nesse caso, escolheríamos o Q3_K_XL.
Quão rápido o Qwen 3.8 27B roda localmente?
Espere cerca de 38 a 44 tokens por segundo em uma RTX 3090 ou 4090 no Q4_K_M com llama.cpp, e 65 a 75 em uma RTX 5090. Um Mac Studio com M3 Ultra decodifica cerca de 25 a 27 tokens por segundo.
Não fizemos esses benchmarks nós mesmos. Estes são testes medidos publicados pelo llm-speed, com o hardware e runtime que eles informaram:
| Hardware | Quantização / runtime | Decodificação tok/s | Prefill tok/s |
|---|---|---|---|
| RTX 3090 24 GB | Q4_K_M, llama.cpp | 38,6 (chat curto, contexto 4K) | 482 |
| RTX 4090 24 GB | Q4_K_M, llama.cpp | 43,4 (chat curto, contexto 4K) | 448 |
| RTX 5090 32 GB | Q4_K_M, llama.cpp | 75,2 (chat curto, contexto 4K) | 563 |
| L40S 45 GB | Q4_K_M, llama.cpp | 34,3 (chat curto) | 569 |
| M3 Ultra 96 GB | Q4_K_M, llama.cpp | 25,2 (chat curto) | 45 |
| M3 Ultra 96 GB | 4 bits, MLX 0.31.3 | 27,3 (chat curto) | 12 |
A velocidade de decodificação quase não cai com contexto nas GPUs: a 4090 ainda fez 39,0 tok/s após um prompt de 33.133 tokens. O prefill é onde os Macs ficam para trás. Em um prompt de 11.827 tokens, o M3 Ultra processou cerca de 283 tok/s, contra aproximadamente 2.000 a 3.000 na 4090, então uma base de código grande significa dezenas de segundos antes do primeiro token.
O raciocínio também consome seu orçamento de tempo. Quando Simon Willison pediu a um Qwen 3.8 27B local para identificar jogos a partir de pesos de modelo brutos, uma resposta levou 46 minutos e 43.506 tokens de raciocínio. Para tarefas do dia a dia, reduza o reasoning_effort para low ou desative o raciocínio.
Executar o Qwen 3.8 27B com Ollama
O Ollama é o caminho mais rápido em qualquer sistema operacional. Instale-o a partir de ollama.com, depois:
ollama pull qwen3.8:27b
ollama run qwen3.8:27b
No Apple Silicon, experimente a tag qwen3.8:27b-mlx, que usa o backend MLX com os mesmos 18 GB.
O contexto padrão do Ollama é pequeno, o que quebra sessões longas de agentes. Aumente-o antes de iniciar o servidor:
OLLAMA_CONTEXT_LENGTH=32768 ollama serve
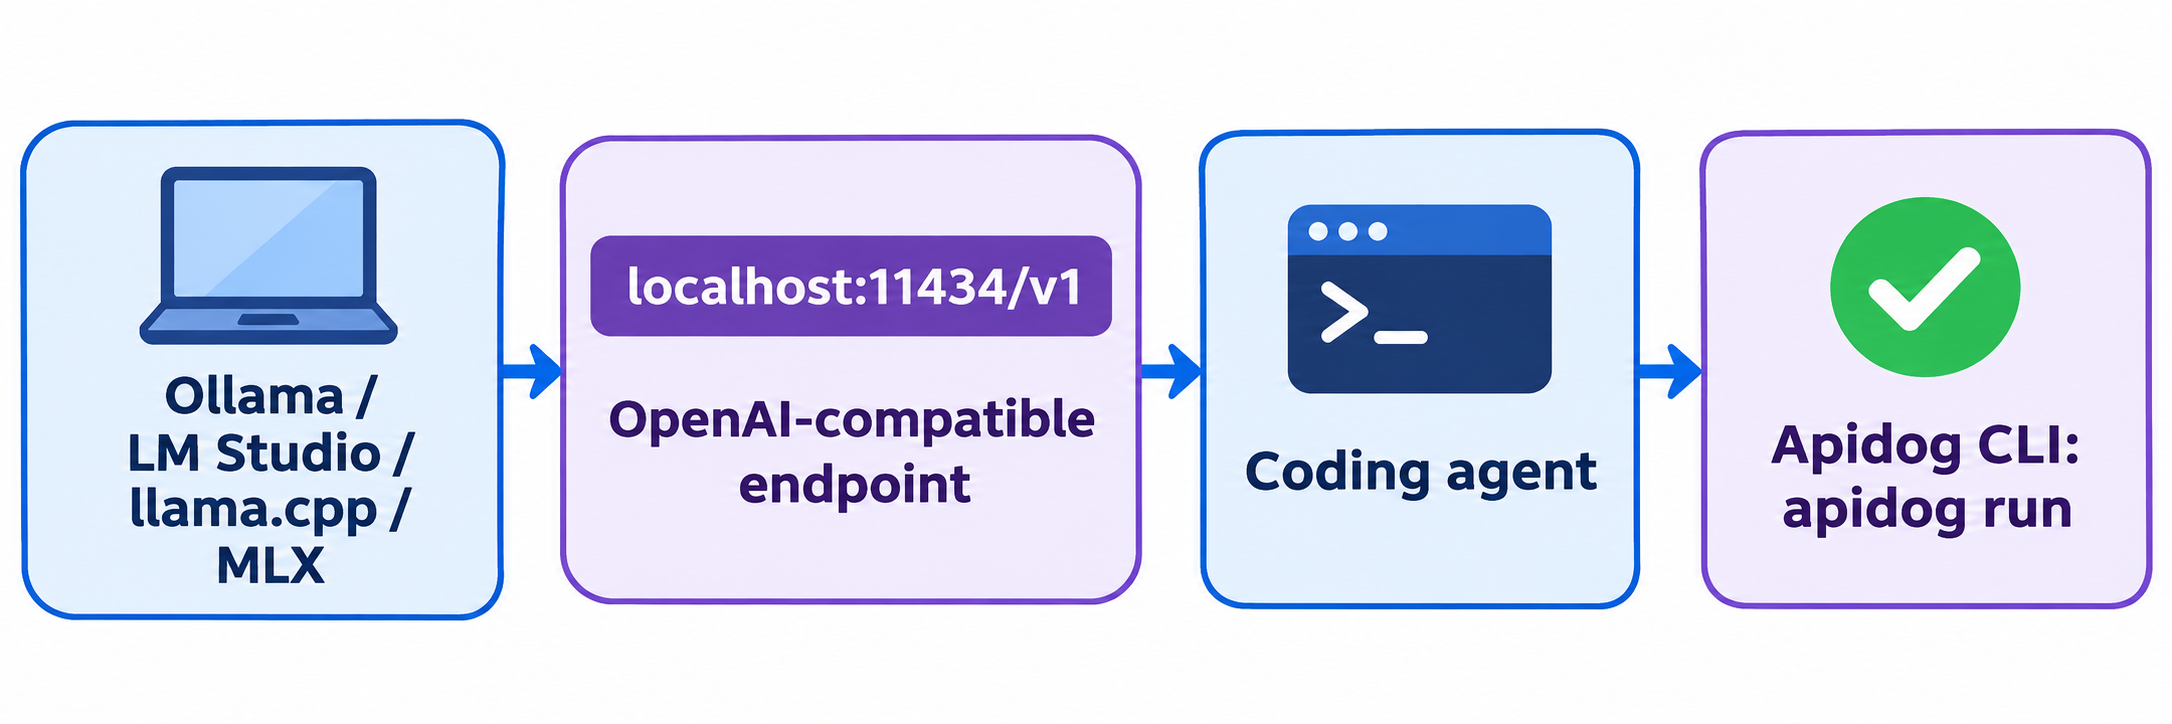
O Ollama também expõe uma API compatível com OpenAI em http://localhost:11434/v1, então qualquer SDK da OpenAI funciona apenas mudando a URL base:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8:27b",
       "messages": [{"role": "user", "content": "Write a Python function that validates an email address."}]}'
Quer usá-lo dentro de um agente de código? O Ollama traz atalhos de inicialização: ollama launch claude --model qwen3.8 inicia o Claude Code com o modelo local, e ollama launch opencode --model qwen3.8 faz o mesmo para o OpenCode.
Executá-lo com LM Studio
O LM Studio é a escolha se você quer uma interface gráfica e configurações de carregamento por modelo. Busque por Qwen 3.8 27B, baixe o build lmstudio-community/Qwen3.8-27B-GGUF no Q4_K_M (16,8 GB) e carregue-o.
Uma configuração importa: aumente o comprimento do contexto ao carregar o modelo. Simon Willison descobriu que o contexto padrão de 8.192 tokens falhava com erros em seu prompt longo e teve que carregar uma janela maior.
Depois, abra a aba Developer e inicie o servidor local, ou execute lms server start em um terminal. O endpoint compatível com OpenAI fica em http://localhost:1234/v1.
Executá-lo com llama.cpp
O llama.cpp dá o maior controle e alimenta a maioria das execuções de benchmark acima. No macOS ou Linux:
brew install llama.cpp

llama-server -hf unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_M \
  --jinja -c 32768 -ngl 99 \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  --port 8080
-hf baixa a quantização direto do Hugging Face, --jinja aplica o template de chat do modelo (necessário para chamadas de ferramentas e raciocínio), -c define o contexto e -ngl 99 coloca todas as camadas na GPU. Os valores de amostragem são as recomendações da Qwen para o modo de raciocínio. Para o modo sem raciocínio, a ficha do modelo sugere temperatura 0,7, top_p 0,8, top_k 20 e presence_penalty 1,5.
Para desativar o raciocínio em uma única requisição, envie "chat_template_kwargs": {"enable_thinking": false} no corpo.
Executá-lo com MLX em um Mac
O MLX é o framework de arrays da própria Apple e geralmente é o runtime mais rápido no Apple Silicon para decodificação. Instale o mlx-lm e use a conversão 4-bit da mlx-community:
pip install mlx-lm

mlx_lm.generate --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain the difference between a mutex and a semaphore." \
  --max-tokens 1024

mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
O mlx_lm.server expõe uma rota /v1/chat/completions compatível com OpenAI. A organização mlx-community também publica variantes 8-bit, mxfp4 e MTP, caso você queira trocar memória por qualidade ou velocidade.
Deixe seu agente de código testar o endpoint local com a Apidog CLI
Cada runner serve o mesmo formato compatível com OpenAI, mas cada um trata blocos de raciocínio, chamadas de ferramentas e timeouts de forma diferente. Antes de apontar um aplicativo para o localhost, faça seu agente de código construir um teste repetível com a Apidog CLI, para que um template quebrado ou um limite de contexto apareça em segundos, e não no meio de uma tarefa.
Configure uma vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # escolha seu agente quando solicitado
Depois, dê ao Claude Code, Codex ou Cursor um único prompt:
In Apidog project <projectId>, create an environment "qwen-local" with base URL
http://localhost:11434/v1. Add a POST /chat/completions endpoint for model
qwen3.8:27b, then a test case that asserts status 200, a non-empty
choices[0].message.content, usage.completion_tokens > 0, and a second request
with a tools array that returns a tool_calls entry. Run it and summarize failures.
O agente lê o schema de cada payload, valida o JSON, cria os recursos e executa o caso de teste:
apidog environment create qwen-local --project <projectId> --base-url http://localhost:11434/v1
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 300000
O --timeout-request longo importa aqui: um modelo de 27B em modo de raciocínio pode levar minutos em um Mac. Troque a URL base para http://localhost:1234/v1 ou :8080/v1 e o mesmo caso de teste verifica o LM Studio, llama.cpp ou MLX. Para mais configurações de agentes, veja a Apidog CLI no Claude Code e a referência do comando apidog run. O plano gratuito da Apidog cobre até 4 usuários.
Local vs. a API hospedada do Qwen 3.8
Executar localmente mantém os prompts na sua máquina, funciona offline e não custa nada por token. A contrapartida é velocidade e escala: um endpoint hospedado serve o muito maior Qwen 3.8-Max com contexto de 1M e sem espera de prefill. Se você precisa do flagship, leia nosso guia da API do Qwen 3.8 ou as formas de acesso gratuito. Para codificação agêntica com qualquer um dos dois tamanhos, o Qwen 3.8 para codificação compara configurações de harness.
FAQ
O Qwen 3.8 27B é gratuito para executar localmente? Sim. Os pesos são Apache-2.0 no Hugging Face, e o Ollama, LM Studio, llama.cpp e MLX são gratuitos. Você paga apenas pelo hardware e pela energia.
Posso executar o Qwen 3.8 27B em um Mac de 16 GB? Apenas com quantizações de 2 bits como a UD-IQ2_XXS (7,27 GB) e com contexto curto, e a qualidade cai perceptivelmente. Um Mac de 32 GB executando o Q4_K_M é a configuração confortável.
O Qwen 3.8 27B roda em uma RTX 3090? Sim. O Q4_K_M cabe em 24 GB com espaço para um contexto de 16K a 32K, e o llm-speed mediu cerca de 38 tokens por segundo no llama.cpp.
Como desativo o modo de raciocínio? Envie "chat_template_kwargs": {"enable_thinking": false} no llama.cpp ou vLLM, ou reduza o reasoning_effort para low. A Qwen recomenda temperatura 0,7 e top_p 0,8 para o modo sem raciocínio.
O modelo local suporta imagens? Sim. A tag de 18 GB do Ollama inclui visão. Com o llama.cpp, baixe o arquivo mmproj-F16.gguf junto com o modelo.
Qual a diferença entre o Qwen 3.8 27B e o Qwen 3.8-Max? O Max é um flagship mistura-de-especialistas de 2,4 trilhões de parâmetros servido pela API da Alibaba. O 27B é um modelo denso pequeno o suficiente para uma única GPU ou um Mac de 32 GB.