
Você pode executar o novo Nemotron 3.5 Transcribe da NVIDIA em uma única GPU e transcrever gravações de uma hora em 40 idiomas sem pagar por minuto ou enviar áudio para ninguém. É o principal modelo de pesos abertos no Hugging Face Open ASR Leaderboard, é distribuído sob a licença OpenMDW-1.1, amigável para uso comercial, e a NVIDIA publicou os pesos BF16, FP8 e NVFP4 no dia do lançamento, 28 de outubro de 2026.
Este guia aborda o hardware necessário, as três formas de executá-lo (vLLM, SGLang-Omni e Transformers), os comandos exatos do model card oficial e as configurações que costumam causar problemas. Todos os comandos foram copiados do card em 29 de outubro de 2026.
Novo no modelo? Nosso guia gratuito explica o que ele faz e como ele se classifica. Não tem uma GPU? A API hospedada custa US$ 0,002 por minuto.
Por que executá-lo localmente
- Sem cobrança por minuto. A US$ 0,002 por minuto da DeepInfra, 10.000 horas custam US$ 1.200. Na sua própria GPU, custa eletricidade.
- Privacidade. Chamadas de clientes, ditados médicos e gravações jurídicas nunca saem da sua rede.
- Conjunto completo de recursos. O caminho via vLLM oferece timestamps por palavra, diarização de locutores, tradução e prompts de contexto. Alguns endpoints hospedados expõem apenas parte disso.
- Ajuste fino. O post de lançamento da NVIDIA mostra um ajuste fino médico reduzindo o WER de 30,8% para 11,8%. Você só pode fazer isso com os pesos.
Hardware: o que o executa
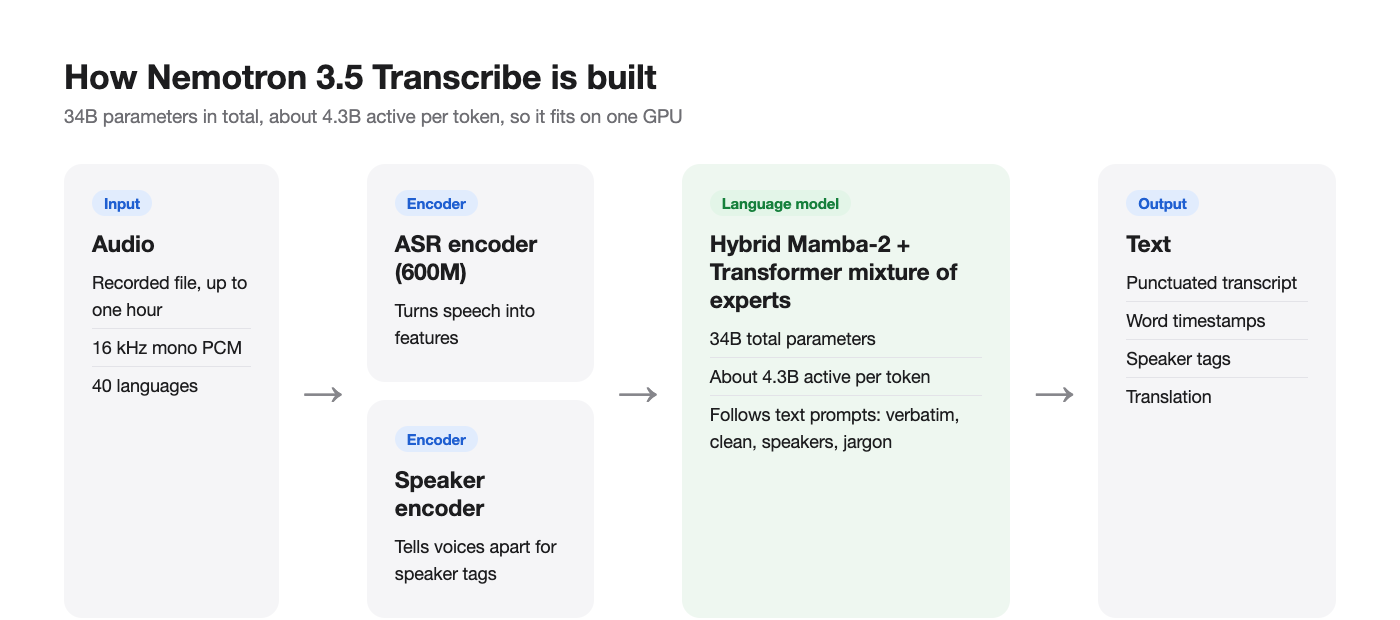
O modelo tem 34B parâmetros no total e cerca de 4,3B ativos, então os pesos são grandes mesmo que o cálculo por token seja pequeno. O alvo de referência da NVIDIA é uma H100 80 GB em BF16. A tabela de compatibilidade do model card:
| GPU | Precisões | Runtimes |
|---|---|---|
| H100, H200 | BF16, FP8 | vLLM 0.32.0, Transformers, SGLang-Omni 0.2.0 (H100) |
| A100 80 GB | BF16 | vLLM 0.32.0, Transformers |
| L40S 48 GB | FP8 | vLLM 0.32.0, Transformers |
| B200, GB200, GB300 DGX Station | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| DGX Spark (GB10), Jetson Thor | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| RTX PRO 6000 Blackwell Server | BF16, FP8, NVFP4 | vLLM, Transformers, SGLang-Omni, GGML |
| RTX 5090 (32 GB) | Apenas NVFP4 | vLLM 0.32.0, Transformers, GGML |
Escolha o checkpoint para a sua placa:
nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B(BF16)nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-FP8nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-NVFP4
Uma placa de 24 GB como a RTX 4090 não está na lista, e o Apple Silicon não é suportado. Os sistemas operacionais são Linux, ou Windows por meio do WSL2. O GGML também roda no Windows nativo, mas o post de lançamento da NVIDIA diz que a compilação local do NeMo-Speech.cpp ainda está “em breve”.
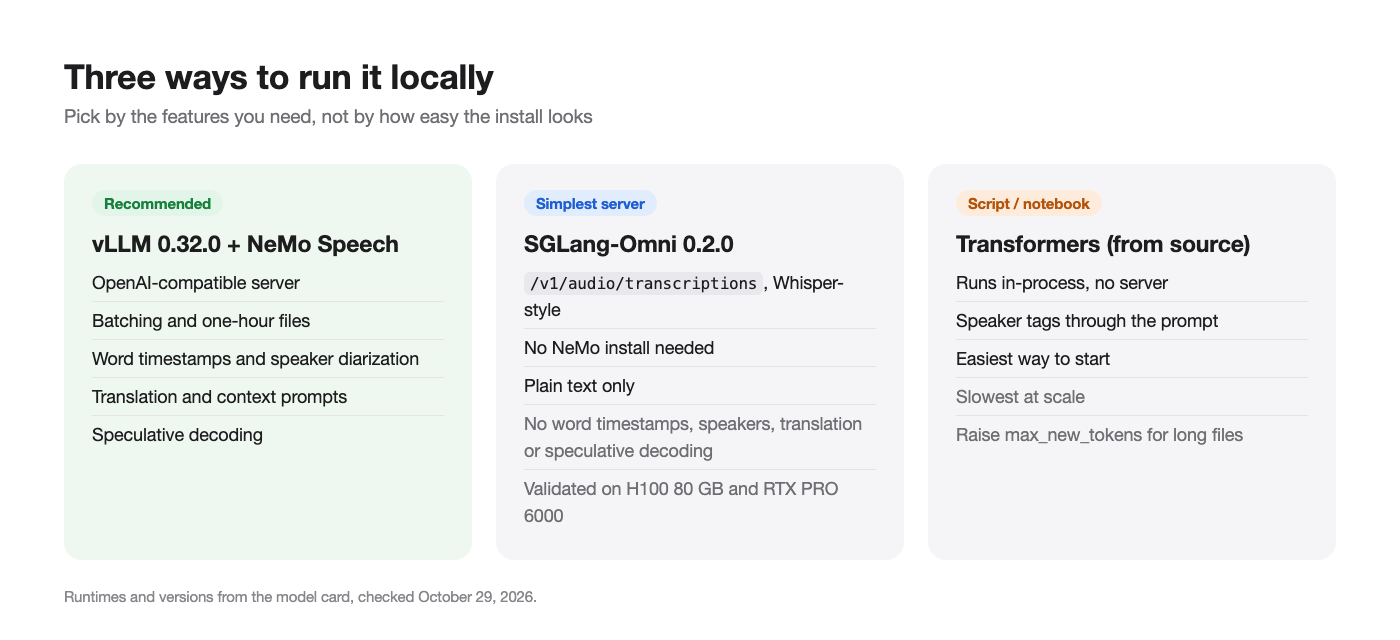
Opção 1: servidor vLLM (recomendado)
O vLLM oferece um endpoint compatível com OpenAI com batching, arquivos de uma hora, decodificação especulativa e timestamps por palavra. Ele precisa do vLLM 0.32.0 mais a branch main mais recente do NeMo Speech, que fornece o plugin vLLM do modelo.
Instalação
O card usa uv e Python 3.13:
git clone https://github.com/NVIDIA-NeMo/Speech.git nemo-speech
cd nemo-speech
uv venv --python 3.13 .venv
UV_PROJECT_ENVIRONMENT=$PWD/.venv uv sync --extra asr --extra vllm --locked --no-install-project
uv pip install --python .venv/bin/python --no-deps -e .
uv pip install --python .venv/bin/python --no-deps av==19.0.2
uv pip install --python .venv/bin/python --no-deps opencv-python-headless==5.0.0.93
source .venv/bin/activate
hf download nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B --local-dir ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
O PyAV (av) permite decodificar M4A e outros formatos comprimidos sem um FFmpeg do sistema. O OpenCV está lá porque o vLLM precisa dele e as configurações de dependências do NeMo o deixam de fora.
Inicie o servidor
export VLLM_PLUGINS=nemo_speechlm
export VLLM_MAX_AUDIO_DECODE_DURATION_S=3600
export VLLM_MAX_AUDIO_CLIP_FILESIZE_MB=180
export VLLM_USE_V2_MODEL_RUNNER=0
vllm serve ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --served-model-name nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --trust-remote-code --dtype bfloat16 --gpu-memory-utilization 0.94 \
  --max-model-len 65536 --max-num-batched-tokens 4096 --max-num-seqs 192 \
  --enable-chunked-prefill --no-enable-prefix-caching \
  --use-replayssm --mamba-backend flashinfer --mamba-cache-mode none \
  --mm-processor-cache-gb 0 --no-async-scheduling \
  --limit-mm-per-prompt '{"audio":{"count":6,"length":120000000}}' \
  --speculative-config '{"method":"mtp","num_speculative_tokens":8}' \
  --reasoning-parser nemotron_v3 \
  --trust-request-mm-kwargs \
  --middleware nemo.collections.speechlm2.vllm.salm.ctc_serving.ctc_timestamp_middleware
As flags que vale a pena entender:
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600eleva o limite de áudio do vLLM de 600 segundos para uma hora. Esqueça isso e arquivos longos falham.VLLM_USE_V2_MODEL_RUNNER=0mantém o runner V1, do qual os timestamps por palavra precisam.--speculative-configativa a previsão de múltiplos tokens com oito tokens de rascunho (MTP8). Em uma H100, a NVIDIA mediu RTFx em lote para inglês de 270 com MTP8 e 410 com MTP2, então tente"num_speculative_tokens":2se você se importa mais com throughput do que com latência.--middleware ... ctc_timestamp_middlewaree--trust-request-mm-kwargspermitem que as requisições peçam timestamps por palavra.- As configurações têm como alvo uma H100 de 80 GB. Em outras placas, reduza
--gpu-memory-utilization,--max-model-lenou--max-num-seqs.
O servidor escuta em 127.0.0.1:8000. Adicione --host 0.0.0.0 para acessá-lo de outras máquinas na sua rede.
Envie um arquivo
import base64
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
audio = base64.b64encode(open("standup.wav", "rb").read()).decode()

response = client.chat.completions.create(
    model="nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B",
    messages=[{"role": "user", "content": [
        {"type": "text", "text": "Transcribe the following audio."},
        {"type": "audio_url", "audio_url": {"url": f"data:audio/wav;base64,{audio}"}},
    ]}],
    temperature=0,
    extra_body={"chat_template_kwargs": {"enable_thinking": False}, "skip_special_tokens": False},
)
print(response.choices[0].message.content)
Substitua a instrução de texto por qualquer prompt de tarefa. Para uma reunião com várias vozes:
Transcribe verbatim, including fillers. Write numbers as spoken, without punctuation or capitalization. Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. Output only the speaker-tagged transcript.
As requisições de timestamp por palavra têm regras: uma gravação por requisição, stream=false e n=1. A resposta então inclui um objeto ctc_timestamps com palavras, tempos de início e fim em segundos e tags de locutor.
Opção 2: SGLang-Omni para transcrição simples
Se você só precisa de texto a partir de arquivos inteiros, o SGLang-Omni 0.2.0 é mais simples e não precisa do NeMo. Ele é validado em uma H100 80 GB e uma RTX PRO 6000 Blackwell com o checkpoint BF16 ou FP8.
sgl-omni serve \
  --model-path nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --model-name nemotron-transcribe \
  --mem-fraction-static 0.85 \
  --port 8000

curl http://localhost:8000/v1/audio/transcriptions \
  -F model=nemotron-transcribe \
  -F file=@audio.wav
Essa rota /v1/audio/transcriptions corresponde ao formato que a API Whisper da OpenAI usa, então o código de cliente Whisper existente muitas vezes precisa apenas de uma nova URL base. A contrapartida: sem timestamps por palavra, rótulos de locutor, tradução ou decodificação especulativa nesta integração.
Opção 3: Transformers em um script
Para notebooks e tarefas pontuais, execute-o em processo com o Hugging Face Transformers instalado a partir do código-fonte:
pip install git+https://github.com/huggingface/transformers
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")

prompt = ("Transcribe this audio with punctuation and capitalization. Include all spoken words "
          "and verbal fillers. Put speaker tags <spk:0> <spk:1> <spk:2> <spk:3> on the transcription.")
inputs = processor.apply_transcription_request(["podcast.mp3"], prompt=[prompt]).to(model.device)
outputs = model.generate(**inputs, max_new_tokens=4096)
print(processor.decode(outputs[:, inputs.input_ids.shape[1]:], skip_special_tokens=False))
É a forma mais fácil de começar e a mais lenta de executar em escala. Aumente max_new_tokens para arquivos longos: uma hora densa pode produzir cerca de 20.000 tokens.
Quão rápido é na sua própria GPU?
O número de destaque da NVIDIA é de 2.238 segundos de áudio por segundo em uma RTX PRO 6000 Blackwell, com pesos NVFP4 e decodificação especulativa DFlash2, e 0,13 segundos para retornar um clipe de 30 segundos. Leia a nota de rodapé: esses números vêm do NIM otimizado, cujas mudanças de serving ainda não são de código aberto. O card diz que a integração aberta com vLLM deve ser cerca de duas vezes mais lenta.
Para transcrição em inglês em lote na H100 em BF16, o card lista estes números de RTFx (segundos de áudio por segundo de computação):
| Decodificação especulativa | RTFx |
|---|---|
| MTP2 | 410 |
| DFlash2, K=7 | 340 |
| MTP8 | 270 |
| DFlash2, K=15 | 260 |
Até a linha mais lenta processa uma hora de áudio em menos de 15 segundos de tempo de GPU em trabalho em lote. Se você quiser o modelo de rascunho DFlash2, note que o vLLM 0.32.0 precisa de um pequeno patch do card, o DFlash2 desativa os timestamps por palavra, e você não deve combiná-lo com MTP.
Problemas comuns e correções
- Arquivos longos cortados em 10 minutos. Você pulou
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600. - Sem timestamps na resposta. Verifique
VLLM_USE_V2_MODEL_RUNNER=0, a flag--middlewaree se a requisição temstream=falsee uma única gravação. - Sem memória em placas menores. Mude para o checkpoint FP8 ou NVFP4 e reduza
--max-num-seqs. - Frases repetidas no final de uma transcrição. O card recomenda uma proteção contra loops de geração nas saídas finais. Limite
max_tokense corte as repetições. - Grafia errada de nomes. Adicione
Context terms: <names>ao prompt. - Vozes de fundo na transcrição. Tente o prompt experimental de campo próximo do card, que reduziu o WER em áudio misto de 27,32% para 4,78% no teste da NVIDIA.
Se você é novo no próprio vLLM, nosso explicador sobre vLLM aborda como ele faz batching de requisições e gerencia a memória da GPU.
Deixe seu agente de programação testar o servidor local com o Apidog CLI
Um modelo local só é útil se seu endpoint permanecer correto ao longo de atualizações do vLLM, ajustes de prompt e trocas de checkpoint. Deixe seu agente de programação cuidar disso com o Apidog CLI, executando verificações contra http://127.0.0.1:8000 na mesma máquina.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Então dê ao seu agente um prompt:
In Apidog project <id>, add POST {{baseUrl}}/v1/chat/completions for my local
Nemotron 3.5 Transcribe server. Create test cases that send samples/en.wav and
samples/two-speakers.wav as base64 audio_url content with temperature 0, and assert
status 200, a non-empty choices[0].message.content, and at least two distinct <spk:N>
tags for the two-speaker file. Run them against the local environment and report failures.
O agente lê o schema, valida seu payload, escreve os casos e os executa:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Execute-o após cada atualização do servidor, ou integre apidog run ... -r junit no CI como mostrado em Apidog CLI em um pipeline de CI/CD. Para configuração de agente, veja Apidog CLI no Claude Code.
Perguntas frequentes
Posso executar o Nemotron 3.5 Transcribe em uma RTX 4090? Ela não está na lista de compatibilidade da NVIDIA. A menor placa de consumo listada é a RTX 5090 com o checkpoint NVFP4.
Ele roda em um Mac? Nenhum runtime oficial suporta Apple Silicon até 29 de outubro de 2026.
O uso local é gratuito para produtos comerciais? A licença OpenMDW-1.1 permite uso comercial e não comercial. Leia o texto da licença para os termos de atribuição antes de lançar.
Ele pode transcrever áudio ao vivo? Não. É um modelo offline para arquivos gravados. A NVIDIA oferece um modelo separado, o Nemotron 3.5 ASR Streaming, para uso ao vivo.
Qual é mais rápido, vLLM ou SGLang-Omni? A NVIDIA não publica uma comparação direta. Use o vLLM quando precisar de timestamps, locutores ou tradução, e o SGLang-Omni para o servidor mais simples, apenas de texto.
Como ele se classifica em relação a outros modelos locais? Ele lidera todos os modelos de pesos abertos no Open ASR Leaderboard de 28 de outubro. Nossa lista dos melhores modelos de fala para texto de código aberto o compara com Qwen3-ASR, Granite Speech, Canary-Qwen, Voxtral e Whisper.
Execute-o
Baixe o checkpoint que se encaixa na sua GPU, inicie o vLLM com o limite de áudio de uma hora e o middleware de timestamp, e envie um arquivo WAV pelo cliente OpenAI. Depois deixe seu agente executar verificações do Apidog contra o endpoint local para que cada atualização prove que ele ainda transcreve antes de você confiar nele com gravações reais.