
Desenvolvedores e entusiastas de IA buscam constantemente modelos eficientes que apresentem bom desempenho sem exigir recursos massivos. O Google apresenta o Gemma 3 270M, um modelo de linguagem compacto com 270 milhões de parâmetros. Este modelo se destaca como o menor da família Gemma 3, otimizado para tarefas em dispositivos. Você obtém capacidades em geração de texto, resposta a perguntas, sumarização e raciocínio, tudo enquanto mantém as operações locais.
O Gemma 3 270M suporta um comprimento de contexto de 32.000 tokens, o que lhe permite lidar com entradas substanciais de forma eficaz. Além disso, ele incorpora técnicas de quantização como o Q4_0 Quantization Aware Training (QAT), reduzindo as necessidades de recursos sem sacrificar a qualidade. Como resultado, você obtém um desempenho próximo ao de modelos de precisão total, mas com menores demandas de memória e computação.
No entanto, o que torna o Gemma 3 270M particularmente atraente reside em sua acessibilidade. Você o executa em hardware padrão, incluindo laptops ou até mesmo dispositivos móveis, promovendo privacidade e aplicações de baixa latência. A seguir, considere como este modelo se encaixa nas tendências mais amplas de desenvolvimento de IA, onde a eficiência impulsiona a inovação.
Compreendendo a Arquitetura do Gemma 3 270M
O Google constrói o Gemma 3 270M sobre uma arquitetura baseada em transformadores, apresentando 170 milhões de parâmetros para embeddings com um vocabulário de 256.000 tokens e 100 milhões para blocos de transformadores. Essa configuração permite suporte multilíngue e manipulação de tarefas de nicho. Você se beneficia de técnicas como quantização INT4, embeddings de posição rotacional e atenção de consulta de grupo, que aprimoram a velocidade e a leveza da inferência.
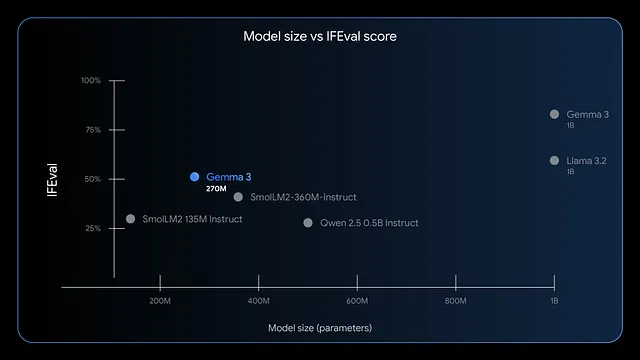
Além disso, o modelo se destaca no seguimento de instruções e na extração de dados. Os benchmarks mostram altas pontuações F1 no IFEval, indicando forte desempenho em tarefas de avaliação. Comparado a modelos maiores como GPT-4 ou Phi-3 Mini, o Gemma 3 270M prioriza a eficiência, usando menos de 200MB no modo de 4 bits em dispositivos como o M4 Max da Apple.
Consequentemente, você o implanta para cenários que exigem respostas rápidas, como análise de sentimento em tempo real ou extração de entidades de saúde. No entanto, seu pequeno tamanho não limita a criatividade; você o aplica em escrita criativa ou verificações de conformidade financeira. Seguindo em frente, avalie as vantagens de executar este modelo localmente.
Benefícios de Executar o Gemma 3 270M Localmente
Você aumenta a privacidade mantendo os dados em seu dispositivo, evitando transmissões na nuvem que arriscam a exposição. O Gemma 3 270M reduz a latência, entregando respostas em milissegundos em vez de segundos. Além disso, ele reduz custos, pois você evita taxas de assinatura para APIs baseadas em nuvem.
Adicionalmente, a eficiência energética do modelo se destaca. Ele consome apenas 0,75% da bateria de um Pixel 9 Pro para 25 conversas no modo quantizado INT4. Essa característica é adequada para computação móvel e de borda, onde a energia é importante. Você também personaliza o modelo facilmente por meio de fine-tuning com ferramentas como LoRA, exigindo dados mínimos.
No entanto, a execução local capacita pequenas equipes ou desenvolvedores individuais. Você experimenta livremente, iterando em aplicações como roteamento de consultas de e-commerce ou estruturação de texto legal. Ao prosseguir, verifique se seu sistema atende aos requisitos.
Requisitos do Sistema para Inferência do Gemma 3 270M
O Gemma 3 270M exige hardware modesto, tornando-o acessível. Para inferência apenas com CPU, você precisa de pelo menos 4GB de RAM e um processador moderno como Intel Core i5 ou equivalente. No entanto, a aceleração por GPU melhora a velocidade; uma placa NVIDIA com 2GB de VRAM é suficiente para versões quantizadas.
Especificamente, no modo de 4 bits, o modelo se encaixa em 200MB de memória, permitindo execuções em dispositivos com recursos limitados. Usuários de Apple silicon se beneficiam do MLX-LM, alcançando mais de 650 tokens por segundo em um M4 Max. Para fine-tuning, aloque 8GB de RAM e uma GPU com 4GB de VRAM para lidar com pequenos conjuntos de dados de forma eficiente.
Importante, sistemas operacionais como Windows, macOS ou Linux funcionam, mas garanta Python 3.10+ para compatibilidade de biblioteca. O armazenamento requer cerca de 1GB para os arquivos do modelo. Com isso em vigor, você instala e executa sem problemas. Agora, explore os métodos de instalação.
Escolhendo a Ferramenta Certa para Executar o Gemma 3 270M Localmente
Várias estruturas suportam o Gemma 3 270M, cada uma oferecendo pontos fortes únicos. O Hugging Face Transformers oferece flexibilidade para script Python e integração. O LM Studio oferece uma interface amigável para gerenciamento de modelos.
Além disso, o llama.cpp permite inferência eficiente baseada em C++, perfeita para otimização de baixo nível. Para dispositivos Apple, o MLX otimiza o desempenho em chips da série M. Você seleciona com base em sua experiência; iniciantes preferem o LM Studio, enquanto desenvolvedores se inclinam para o Transformers.
Assim, essas ferramentas democratizam o acesso. Nas seções seguintes, siga guias passo a passo para métodos populares.
Guia Passo a Passo: Executando o Gemma 3 270M com Hugging Face Transformers
Você começa instalando as bibliotecas necessárias. Abra seu terminal e execute:
pip install transformers torch
Este comando busca o Transformers e o PyTorch. Em seguida, importe os componentes em um script Python:
from transformers import AutoTokenizer, AutoModelForCausalLM
Carregue o modelo e o tokenizador:
model_name = "google/gemma-3-270m"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name, device_map="auto")
O `device_map="auto"` coloca o modelo na GPU, se disponível. Prepare sua entrada:
input_text = "Explain quantum computing in simple terms."
inputs = tokenizer(input_text, return_tensors="pt").to(model.device)
Gere a saída:
outputs = model.generate(**inputs, max_new_tokens=200)
response = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(response)
Isso produz uma explicação coerente. Para otimizar, adicione quantização:
from transformers import BitsAndBytesConfig
quant_config = BitsAndBytesConfig(load_in_4bit=True)
model = AutoModelForCausalLM.from_pretrained(model_name, quantization_config=quant_config)
A quantização reduz o uso de memória. Você lida com erros garantindo o login do Hugging Face para modelos restritos:
from huggingface_hub import login
login(token="your_hf_token")
Obtenha o token de sua conta Hugging Face. Com esta configuração, você executa inferências repetidamente. No entanto, para usuários não-Python, considere o LM Studio a seguir.
Guia Passo a Passo: Executando o Gemma 3 270M com LM Studio
O LM Studio oferece uma interface intuitiva. Baixe-o em lmstudio.ai e instale.
Inicie o aplicativo e, em seguida, procure por "gemma-3-270m" no hub de modelos.
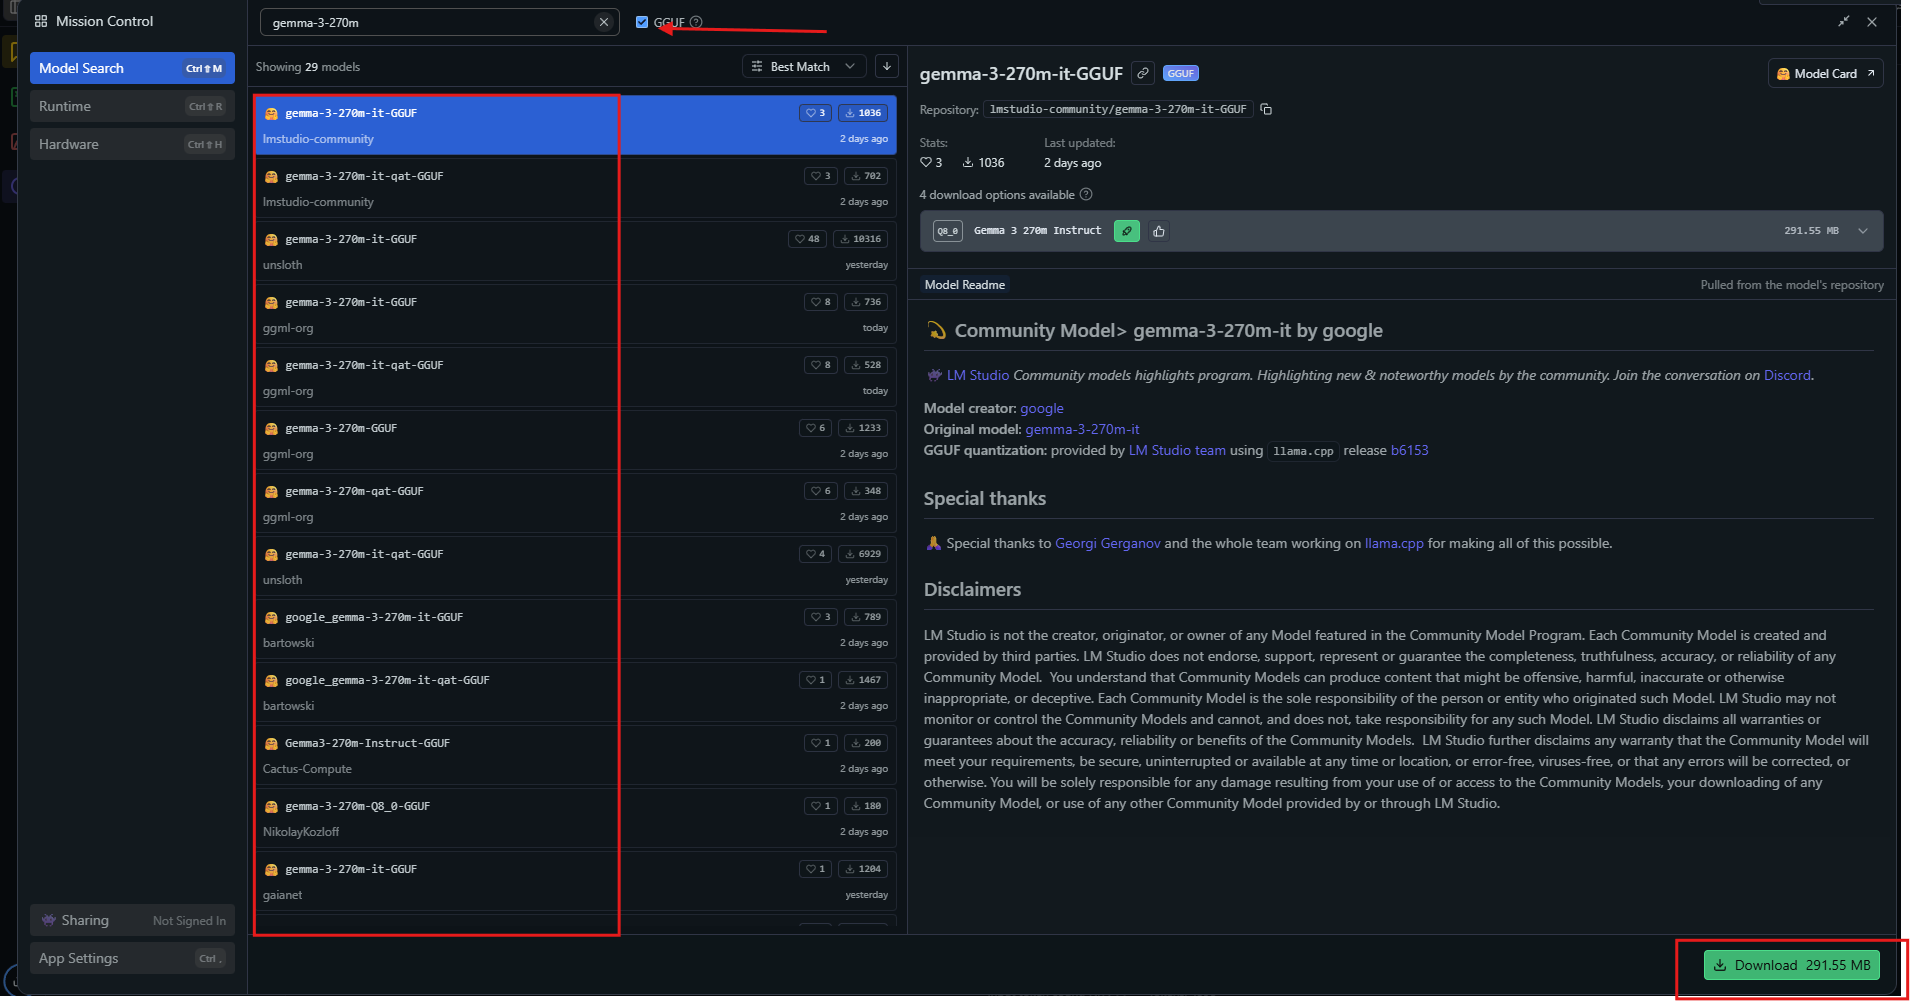
Selecione uma variante quantizada como Q4_0 e faça o download. Uma vez pronto, carregue o modelo na barra lateral. Ajuste as configurações: defina o contexto para 32k, temperatura para 1.0.
Digite um prompt na janela de chat e clique em enviar. O LM Studio exibe as respostas com as velocidades de token. Exporte chats ou faça fine-tuning por meio de ferramentas integradas.
Para uso avançado, ative o descarregamento de GPU nas configurações. O LM Studio seleciona automaticamente as fontes ideais, garantindo compatibilidade. Este método é adequado para aprendizes visuais. Além disso, explore o llama.cpp para ajustes de desempenho.
Guia Passo a Passo: Executando o Gemma 3 270M com llama.cpp
O llama.cpp oferece inferência de alta eficiência. Clone o repositório:
git clone https://github.com/ggerganov/llama.cpp
Construa-o:
make -j
Baixe os arquivos GGUF do Hugging Face:
huggingface-cli download unsloth/gemma-3-270m-it-GGUF --include "*.gguf"
Execute a inferência:
./llama-cli -m gemma-3-270m-it-Q4_K_M.gguf -p "Build a simple AI app."
Especifique parâmetros como `--n-gpu-layers 999` para uso total da GPU. O llama.cpp suporta níveis de quantização, equilibrando velocidade e precisão. Você compila com CUDA para GPUs NVIDIA:
make GGML_CUDA=1
Isso acelera o processamento. O llama.cpp se destaca em sistemas embarcados. Agora, aplique o modelo em exemplos práticos.
Exemplos Práticos de Uso do Gemma 3 270M Localmente
Você cria um analisador de sentimento. Insira avaliações de clientes, e o modelo as classifica como positivas ou negativas. Codifique-o em Python:
prompt = "Classify: This product is amazing!"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(**inputs)
print(tokenizer.decode(outputs[0]))
O Gemma 3 270M gera "Positive". Estenda para sumarização:
text = "Long article here..."
prompt = f"Summarize: {text}"
# Generate summary
Ele condensa o conteúdo de forma eficaz. Para resposta a perguntas, consulte:
"What causes climate change?"
O modelo explica os gases de efeito estufa. Na área da saúde, extraia entidades de notas. Esses usos demonstram versatilidade. Além disso, faça fine-tuning para especialização.
Fine-Tuning do Gemma 3 270M Localmente
O fine-tuning adapta o modelo. Use a biblioteca PEFT do Hugging Face:
pip install peft
Carregue com a configuração LoRA:
from peft import LoraConfig, get_peft_model
lora_config = LoraConfig(r=16, lora_alpha=32, target_modules=["q_proj", "v_proj"])
model = get_peft_model(model, lora_config)
Prepare um conjunto de dados e, em seguida, treine:
from transformers import Trainer, TrainingArguments
trainer = Trainer(model=model, args=TrainingArguments(output_dir="./results"))
trainer.train()
LoRA requer poucos dados, terminando rapidamente em hardware modesto. Salve e recarregue o adaptador. Isso aumenta o desempenho em tarefas personalizadas, como previsão de movimentos de xadrez. No entanto, monitore o overfitting.
Dicas de Otimização de Desempenho para o Gemma 3 270M
Você maximiza a velocidade quantizando para 4 bits ou 8 bits. Use o processamento em lote para múltiplas inferências. Defina a temperatura para 1.0, top_k=64, top_p=0.95 conforme recomendado.
Em GPUs, ative a precisão mista. Para contextos longos, gerencie o cache KV cuidadosamente. Monitore a VRAM com ferramentas como nvidia-smi. Atualize as bibliotecas regularmente para otimizações.
Consequentemente, esses ajustes rendem mais de 130 tokens por segundo em hardware adequado. Evite armadilhas comuns como tokens BOS duplos em prompts. Com a prática, você alcança execuções eficientes.
Conclusão
Você agora possui o conhecimento para executar o Gemma 3 270M localmente. Da configuração à otimização, cada etapa constrói capacidade. Experimente, faça fine-tuning e implante para realizar seu potencial. Modelos pequenos como este causam grandes impactos na acessibilidade da IA.