
Para executar o ERNIE 5.5 Flash localmente, instale o vLLM 0.32.0 junto com o plugin vLLM-ERNIE da Baidu e, em seguida, execute vllm serve baidu/ERNIE-5.5-Flash-Base com paralelismo de dados e de especialistas em um nó multi-GPU. Você obtém um servidor compatível com OpenAI na porta 8000. O porém: os pesos abertos de hoje são do modelo Base, um checkpoint de pré-treinamento que continua texto, e não um modelo de chat.
Abaixo: o que você pode baixar, o hardware que a Baidu lista, os comandos exatos de serve e como testar o endpoint. Todos os comandos e números abaixo vêm do model card no Hugging Face e do repositório vLLM-ERNIE, verificados em 12 de novembro de 2026.
Primeira vez com o modelo? Comece por o que é o ERNIE 5.5 Flash. Se você quer o modelo de chat sem um cluster de GPUs, o guia da API do ERNIE 5.5 Flash é o caminho mais rápido.
O que você pode executar localmente hoje?
Você pode executar o ERNIE 5.5 Flash Base, lançado no Hugging Face em FP8 e BF16. É um modelo esparso mixture-of-experts de 280 bilhões de parâmetros, com 14 bilhões de parâmetros ativos por token, treinado em 33,5 trilhões de tokens. O ERNIE 5.5 Flash Preview ajustado para chat, por enquanto, está disponível apenas via API; a Baidu diz que seus pesos chegarão "em breve" sob Apache 2.0.
Veja como as duas versões se comparam para auto-hospedagem:
| ERNIE 5.5 Flash Base | ERNIE 5.5 Flash Preview | |
|---|---|---|
| O que é | Checkpoint ao final do pré-treinamento | Primeiro modelo pós-treinado (chat, raciocínio, agente) |
| Pesos | Hugging Face e ModelScope, FP8 e BF16 | Não lançados até 12 de novembro de 2026 |
| Endpoint que você chama | /v1/completions (continuação de texto) |
Chat completions com raciocínio e ferramentas |
| Licença | ERNIE 5.5 Flash Base Model License v1.0 | Apache 2.0 prometido no lançamento |
| Onde usar agora | Suas próprias GPUs | API Qianfan, OpenRouter |
Hoje, a coleção ERNIE-5.5-Flash da Baidu contém apenas os dois checkpoints Base, e o README do vLLM-ERNIE marca o modelo de chat como "Coming soon". O post de lançamento do Preview não dá data.
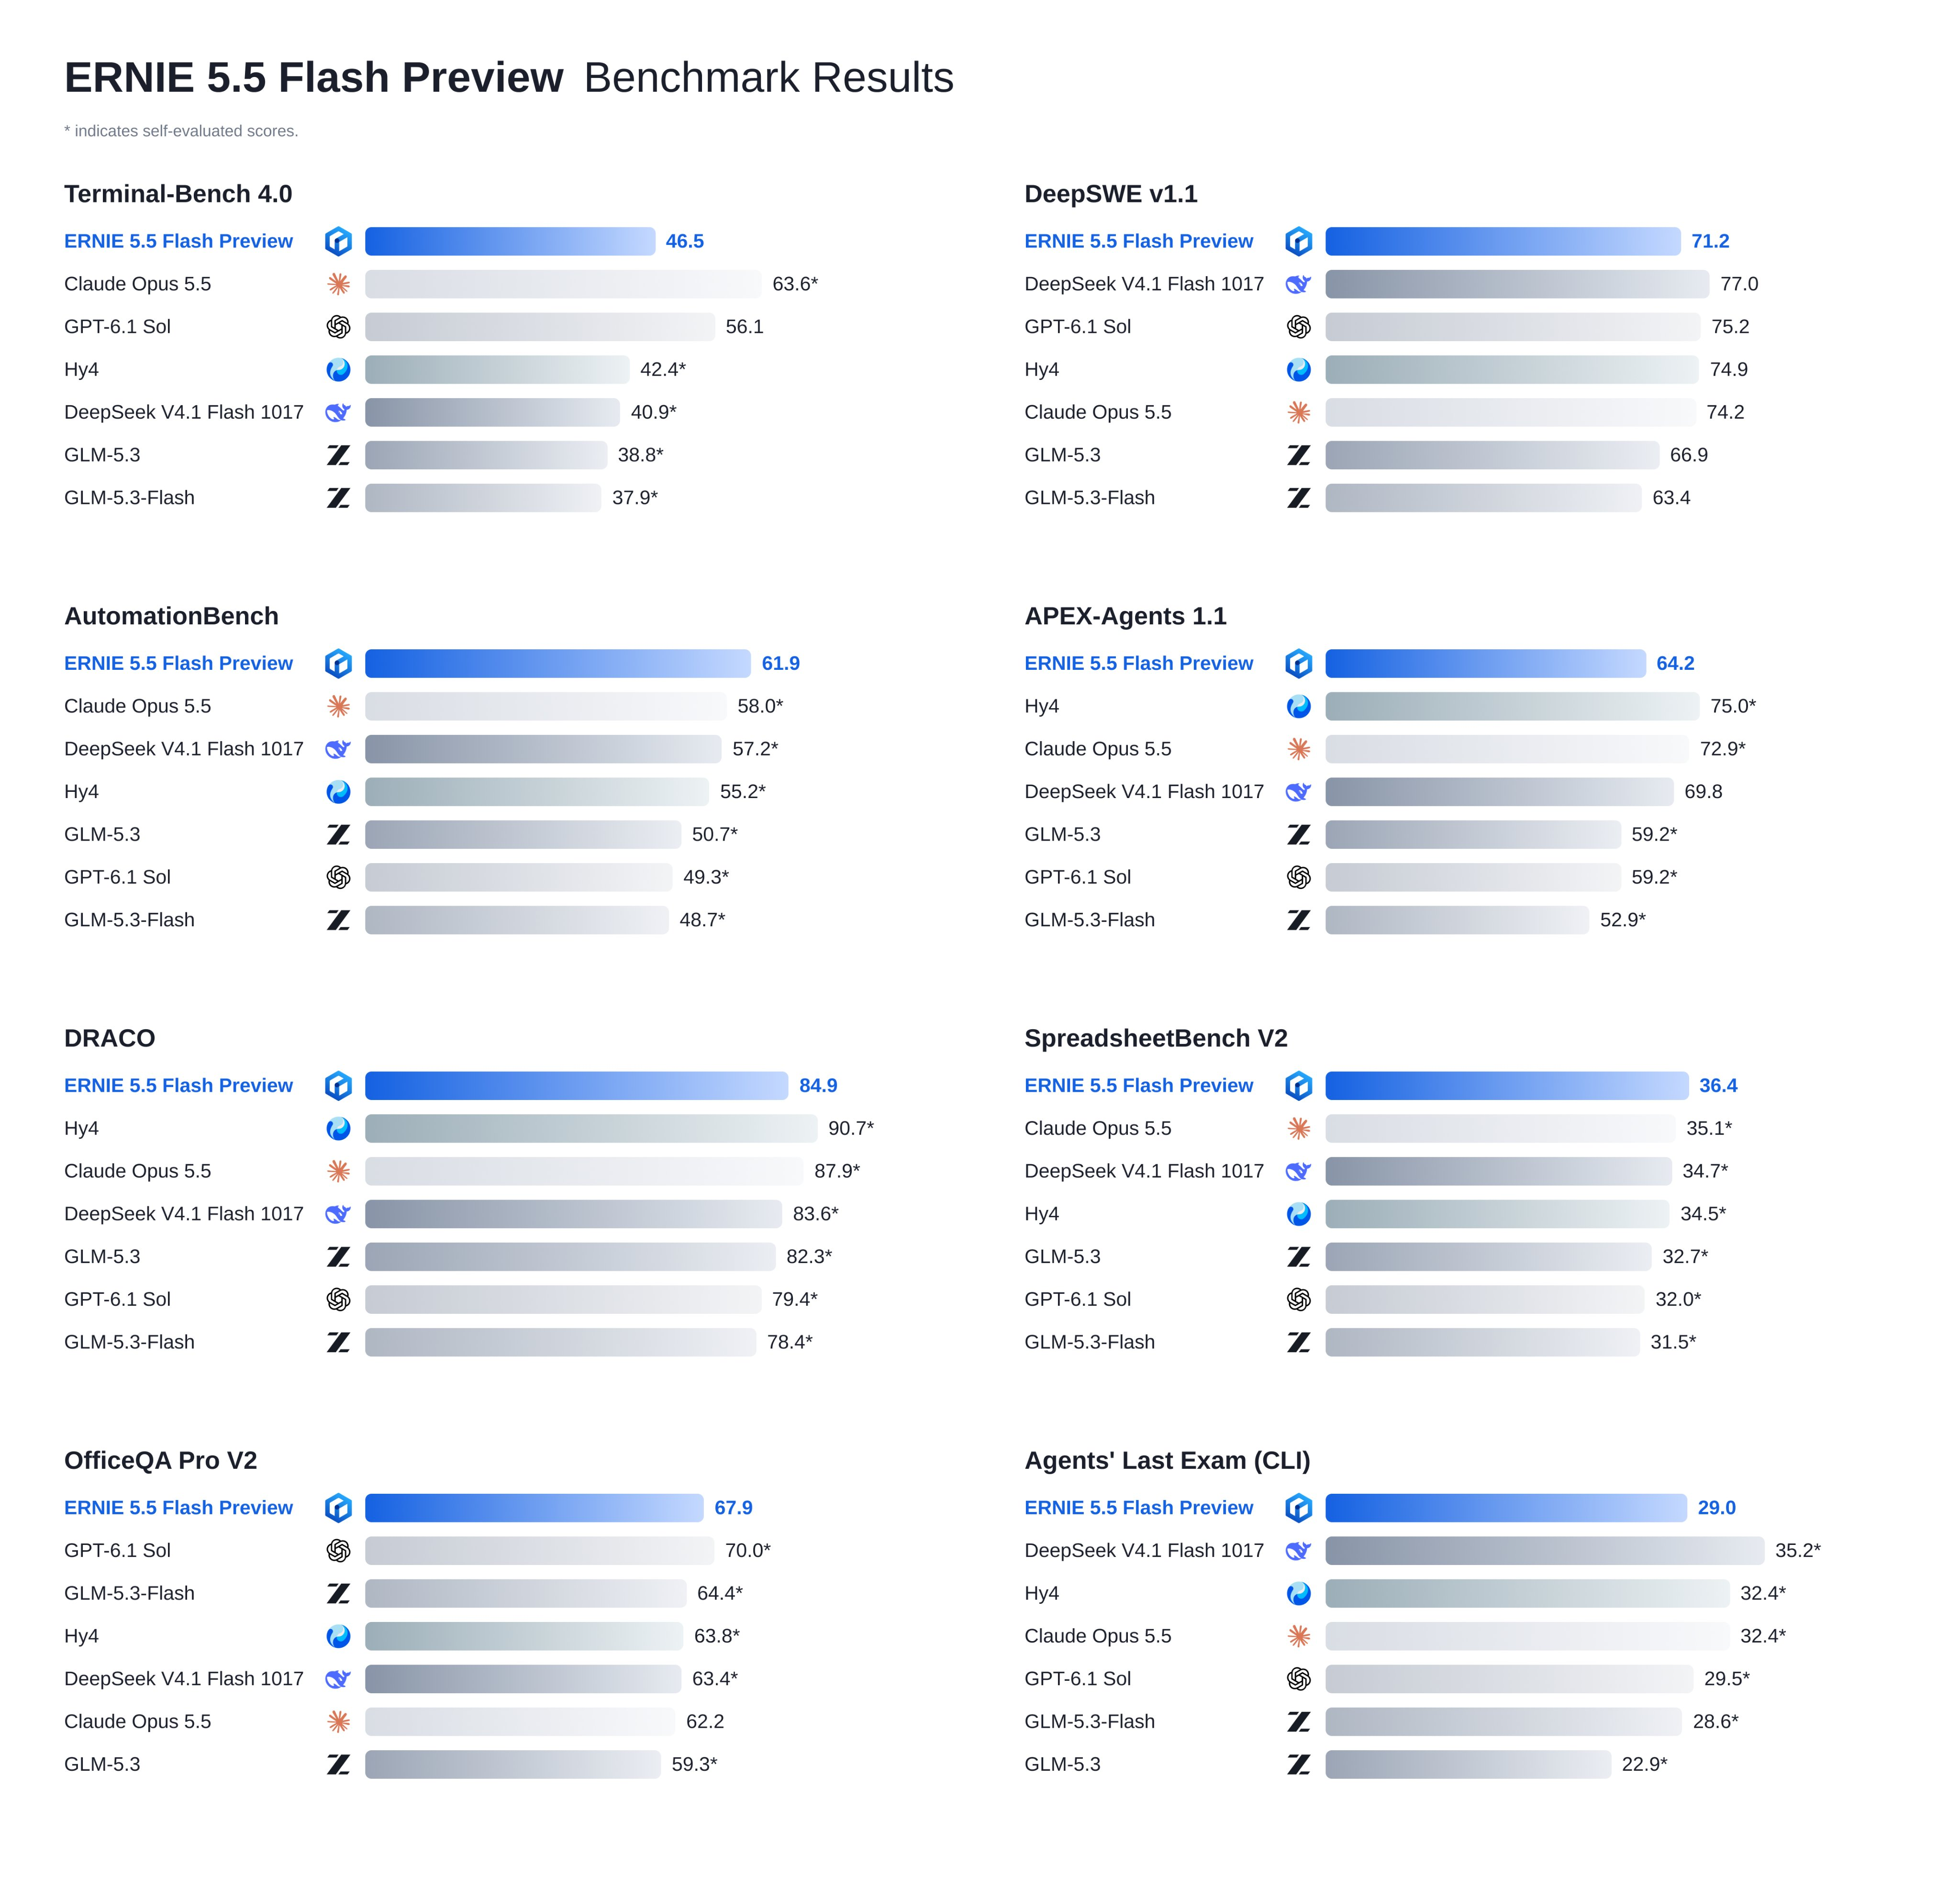
Se você quer um assistente de programação hoje, um modelo Base local não vai lhe dar um. Se você quer um ponto de partida para fine-tuning ou pesquisa com few-shot, é exatamente para isso que a Baidu construiu o Base.
Requisitos de hardware do ERNIE 5.5 Flash
Os pesos em FP8 ocupam cerca de 280 GB de memória de GPU e os em BF16 cerca de 560 GB, então esta é uma tarefa para servidor multi-GPU, não para laptop. O README do vLLM-ERNIE lista as quantidades mínimas de GPUs que comportam os pesos, e o plugin roda apenas em GPUs NVIDIA.
| Memória de GPU por placa | FP8 (~280 GB de pesos) | BF16 (~560 GB de pesos) |
|---|---|---|
| 288 GB | 2 GPUs | 4 GPUs |
| 192 GB | 4 GPUs | 8 GPUs (ou 2 nós x 4 GPUs) |
| 80 GB | 8 GPUs | 2 nós x 8 GPUs |
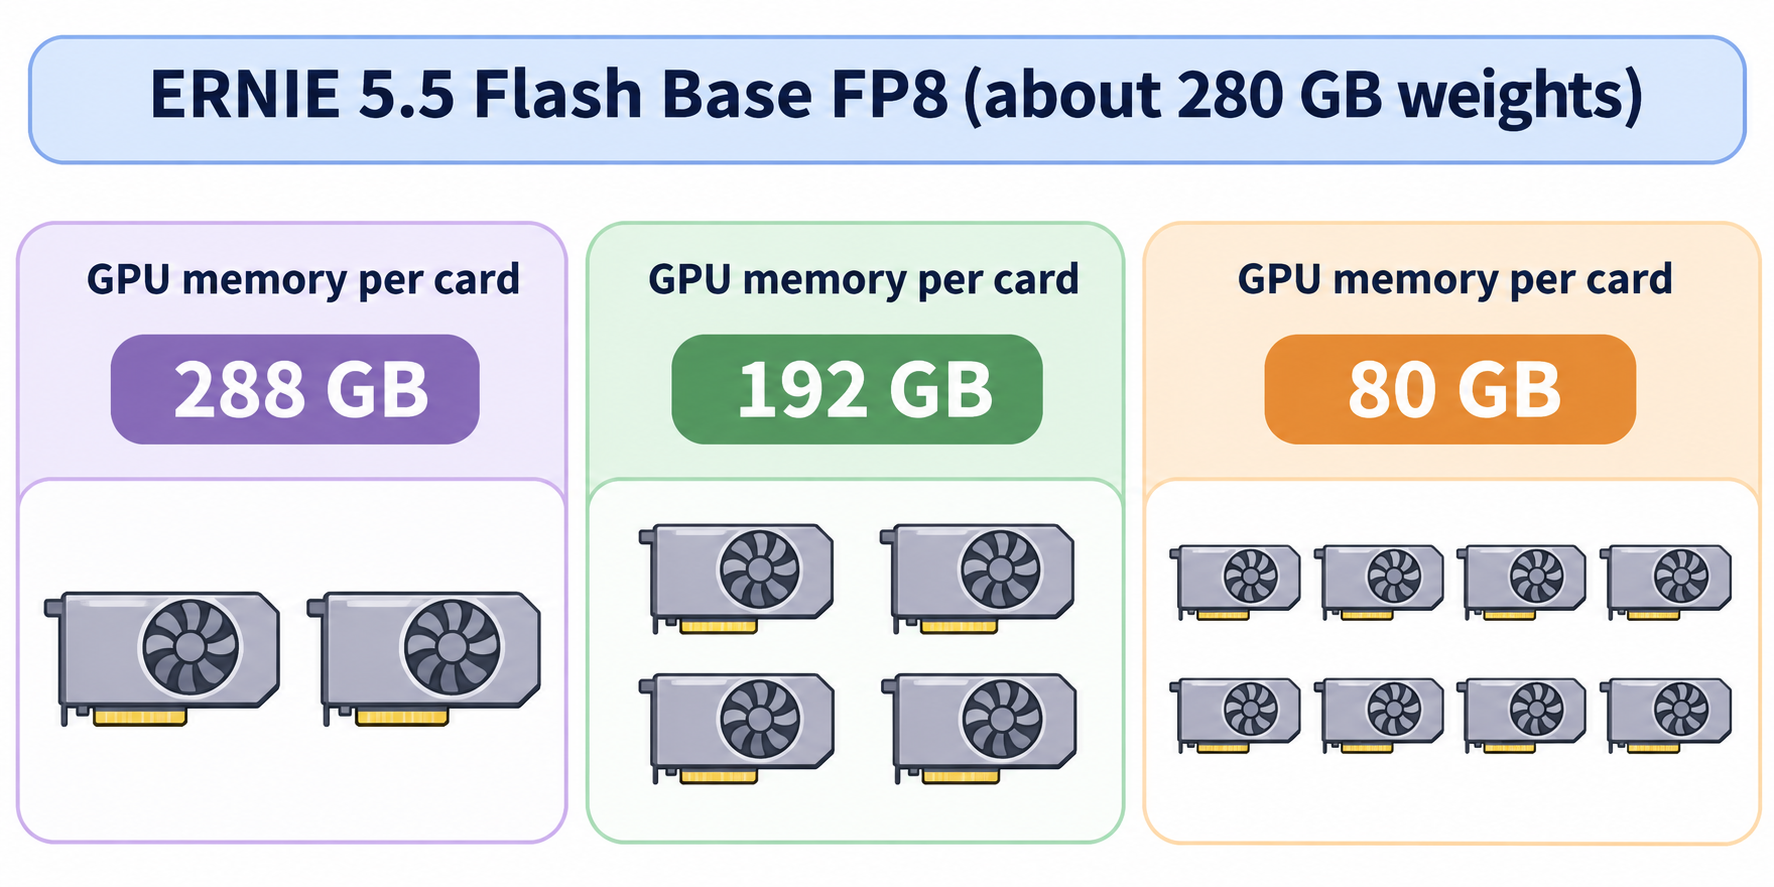
Esses são os mínimos para carregar os pesos. O cache KV precisa de espaço adicional, e é por isso que o comprimento de contexto que você consegue servir depende das suas placas:
- GPUs de 80 GB: sirva FP8 em 8 GPUs com
--data-parallel-size 8e--gpu-memory-utilization 0.93. Até 262.144 tokens cabem; 1 milhão não. - Contexto de 1 milhão de tokens: os valores da Baidu são para GPUs com 184 GiB de memória, com utilização reduzida para 0,85, porque um prefill de 1 milhão de tokens exige dezenas de GB de memória temporária.
- A arquitetura importa: os comandos FP8 passam
--moe-backend humming, que suporta a ativação SiTU do modelo com pesos FP8 em GPUs Blackwell. Em GPUs Hopper, remova essa flag e mantenha o kernel MoE padrão do vLLM.
"Localmente" significa hardware que você controla: um nó de 8 GPUs alugado, um servidor on-premise ou um cluster de laboratório.
Instale o vLLM e o plugin ERNIE
O vLLM não suporta a arquitetura ERNIE 5.5 (Ernie5_5_MoeForCausalLM) nativamente. A Baidu a distribui como um plugin que roda sobre a wheel vLLM 0.32.0 oficial, sem modificações. Crie um ambiente Python 3.12 e instale ambos:
uv venv --python 3.12
source .venv/bin/activate
uv pip install vllm==0.32.0
uv pip install git+https://github.com/baidu/vLLM-ERNIE.git
O plugin é carregado pelo entry point vllm.general_plugins do vLLM em todos os processos vLLM. Se o vllm serve disser depois Model architectures ['Ernie5_5_MoeForCausalLM'] are not supported, o plugin não está instalado no ambiente que executa o vllm, ou VLLM_PLUGINS está definido sem ernie.
Para baixar os pesos do ModelScope em vez do Hugging Face, defina VLLM_USE_MODELSCOPE=True. Os nomes dos repositórios são os mesmos nos dois hubs. Se você é novo no vLLM, nossa visão geral do vLLM explica o servidor e sua API compatível com OpenAI.
O comando vllm serve para o ERNIE 5.5 Flash
Este é o comando FP8 do README do vLLM-ERNIE, para um nó de 4 GPUs no contexto de treinamento de 128K, com decodificação especulativa ECHO ativada:
export VLLM_ENGINE_READY_TIMEOUT_S=3600
vllm serve baidu/ERNIE-5.5-Flash-Base \
    --host 0.0.0.0 \
    --port 8000 \
    --data-parallel-size 4 \
    --enable-expert-parallel \
    --moe-backend humming \
    --kv-cache-dtype fp8 \
    --max-model-len 131072 \
    --speculative-config '{"method":"mtp","num_speculative_tokens":2}'
O que cada escolha faz, segundo as notas da Baidu:
- Atenção em paralelismo de dados mais MoE em paralelismo de especialistas (
--data-parallel-size 4 --enable-expert-parallel) comportam o maior cache KV e entregam o maior throughput. O paralelismo de tensores (--tensor-parallel-size2, 4 ou 8) reduz a latência em baixa concorrência, mas comporta menos cache KV. - Cache KV em FP8 (
--kv-cache-dtype fp8) armazena o cache em FP8;autoo mantém em BF16. - Decodificação especulativa ECHO reutiliza a própria última camada do modelo como um draft embutido. Aqui ela antecipa 2 passos; 1 ou 3 também funcionam. Remova
--speculative-configpara servir sem draft.
O model card mostra uma variante mais curta na porta 30000, sem a configuração especulativa.
Proteja o servidor. Esses comandos fazem bind em 0.0.0.0 sem autenticação. O README da Baidu recomenda adicionar --api-key <key> ou fazer bind em 127.0.0.1, a menos que a rede seja confiável. Faça um dos dois antes de expor a porta.
BF16 e contexto de 1M
O BF16 roda em dois nós de 4 GPUs (DP8 mais EP8) com --data-parallel-size 8, --data-parallel-size-local 4, --data-parallel-address ${HEAD_IP} e --data-parallel-hybrid-lb; o segundo nó adiciona --data-parallel-start-rank 4. Copie o comando completo do README; ele também define a interface de rede entre os nós.
Para a janela completa de 1.048.576 tokens, passe --max-model-len 1048576 e --gpu-memory-utilization 0.85, e reduza --max-num-seqs para que o cache KV de cada rank comporte requisições inteiras de 1 milhão de tokens.
Chame o endpoint compatível com OpenAI
O vLLM expõe rotas no estilo OpenAI, mas um modelo base não tem template de chat, então você chama /v1/completions com um prompt bruto. Para uso few-shot, coloque os exemplos no prompt e interrompa no fim de uma resposta:
curl http://127.0.0.1:8000/v1/completions \
    -H 'Content-Type: application/json' \
    -d '{
        "model": "baidu/ERNIE-5.5-Flash-Base",
        "prompt": "Question: What is 15% of 240?\nAnswer:",
        "max_tokens": 64,
        "temperature": 0,
        "stop": ["\n"]
    }'
O README da Baidu diz que o texto da completion retorna como 36. Três detalhes pegam muita gente:
- Use
"temperature": 0para decodificação greedy. Ogeneration_config.jsondo modelo definedo_sample=false,temperature=1.0etop_p=0.95. O vLLM aplica a temperatura e o top_p, mas ignorado_sample, então haverá amostragem se você não sobrescrever. - Não adicione
<|ERNIE_MASK|>você mesmo. O tokenizer o insere no início (token id 2) nos prompts de completion. - Use o nome correto do modelo. Use
baidu/ERNIE-5.5-Flash-Base-BF16quando servir os pesos BF16.
Qualquer SDK da OpenAI funciona se você apontar base_url para http://<host>:8000/v1 e chamar completions, não chat completions.
Base vs Preview: qual você deve usar?
Use o Base quando planeja treinar por cima dele; use o Preview quando precisar de um assistente funcional agora. O Base lhe dá controle total e dados que nunca saem dos seus servidores. O Preview oferece chat, raciocínio e chamadas de ferramentas, apenas via Qianfan ou OpenRouter.
Quando os pesos do Preview chegarem, o plugin já estará pronto para eles. O README documenta as flags extras, marcadas como "Coming soon": --reasoning-parser ernie5 --tool-call-parser ernie5 --enable-auto-tool-choice, além de um draft model DSpark para decodificação especulativa. O raciocínio aparecerá em reasoning_content e as chamadas de ferramentas em message.tool_calls, então o mesmo servidor que você monta hoje se torna um backend de chat com uma troca de pesos e três flags.
A licença é a outra diferença. O Base é distribuído sob o ERNIE 5.5 Flash Base Model License Agreement v1.0, e não sob Apache 2.0. Leia a licença completa antes de construir um produto sobre ele. Em 12 de novembro de 2026, ela dizia:
- O uso não comercial é gratuito, sem necessidade de aviso.
- O uso comercial em produtos que faturam até US$ 50 milhões por ano está isento de cobranças de licença, mas você deve exibir "Powered by ERNIE" e enviar à Baidu um aviso único.
- Acima de US$ 50 milhões por ano, é necessária primeiro uma autorização por escrito da Baidu.
- O "Território" da licença exclui a União Europeia, o Reino Unido e a Coreia do Sul.
Para um modelo open-weights menor que você pode auto-hospedar com menos GPUs, veja nosso guia sobre auto-hospedagem do GLM-5.3.
Deixe seu agente de código testar o endpoint com o Apidog CLI
Uma implantação nova do vLLM precisa de um smoke test que você possa reexecutar após cada mudança de flag: status, schema da resposta e tokens por segundo. Deixe isso para o seu agente de código e para o Apidog CLI, em vez de redigitar curl.
Configure o CLI uma vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois, dê ao Claude Code, Codex ou Cursor um único prompt:
In Apidog project <projectId>, create an environment "ernie-local" with base URL
http://<gpu-host>:8000. Add a test case for POST /v1/completions with model
baidu/ERNIE-5.5-Flash-Base, prompt "Question: What is 15% of 240?\nAnswer:",
max_tokens 64, temperature 0. Assert status 200, that choices[0].text exists,
and that usage.completion_tokens > 0; log completion_tokens divided by the
response time in seconds as tokens/s. Run it and summarize the result.
O agente lê o schema do payload, valida-o, cria o caso de teste e o executa:
apidog environment create ernie-local --project <projectId> --base-url http://<gpu-host>:8000
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
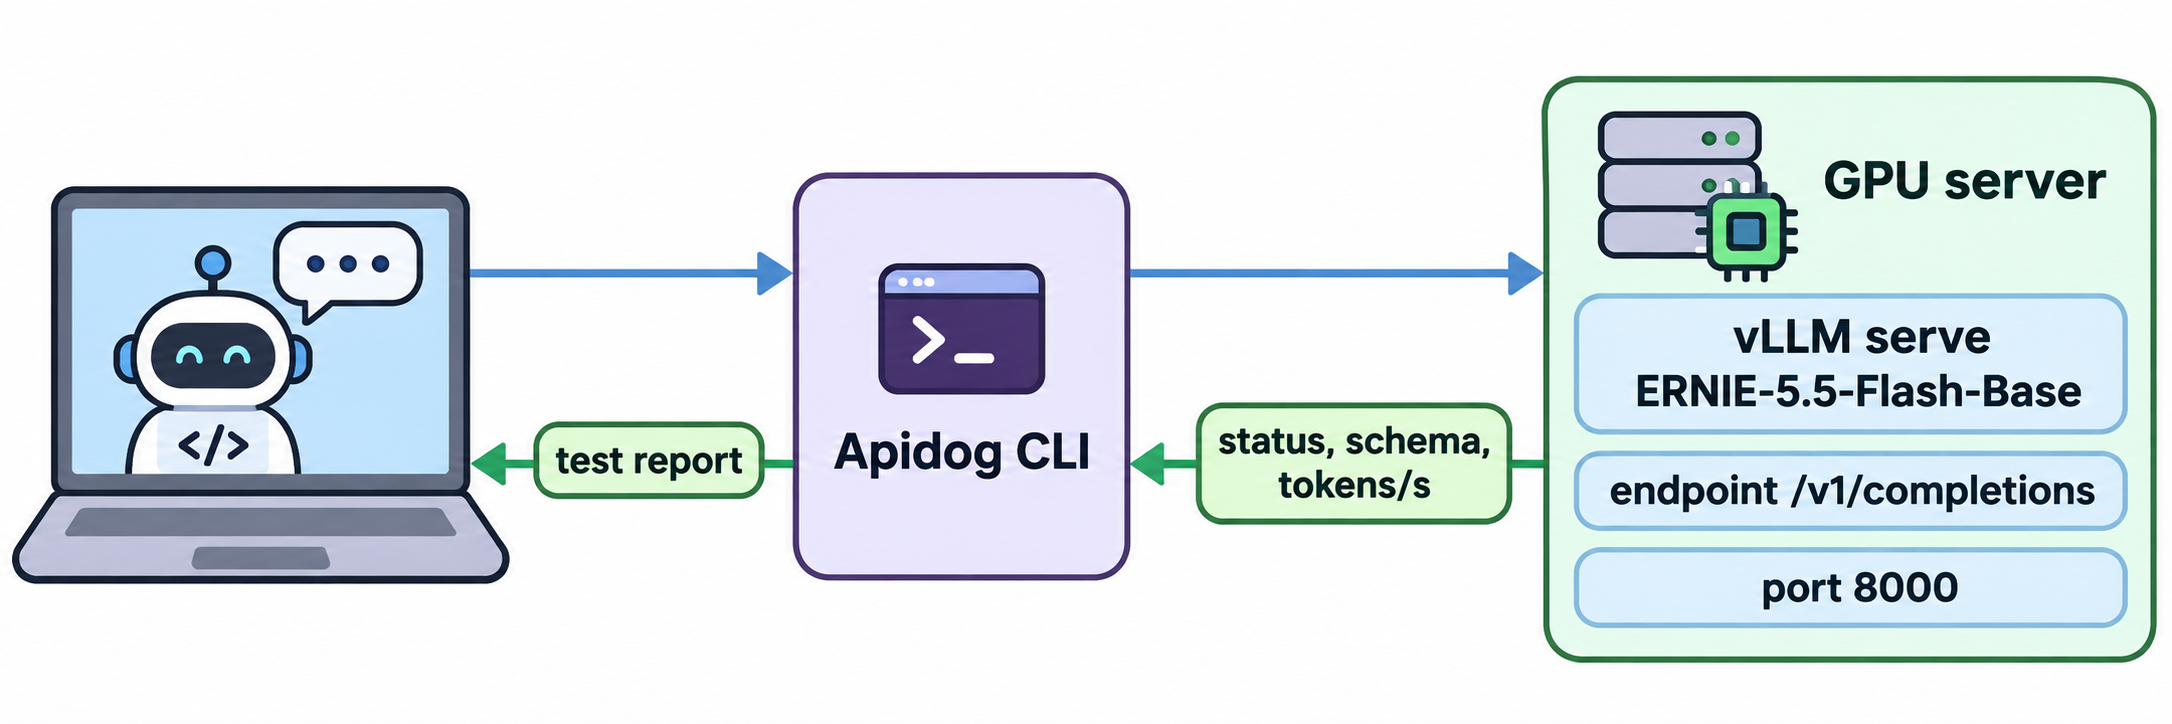
Execute o CLI a partir de uma máquina que alcance a porta 8000. Se você definir --api-key no servidor, peça ao agente para armazená-la como variável de ambiente e enviá-la como token Bearer. Reexecute o mesmo caso de teste após trocar --tensor-parallel-size, desativar a decodificação especulativa ou aumentar --max-model-len, e você terá uma comparação justa. Adicione -r junit e a mesma execução entra no CI. Para a configuração do agente passo a passo, veja Apidog CLI no Claude Code. O plano gratuito do Apidog cobre até 4 usuários.
FAQ
Posso rodar o ERNIE 5.5 Flash em uma única GPU de consumidor? Não. Os pesos em FP8 têm cerca de 280 GB, e a menor configuração listada pela Baidu são 2 GPUs com 288 GB cada. Com placas de 80 GB, você precisa de 8 delas. Use o Preview via API se não tiver esse hardware.
Os pesos do ERNIE 5.5 Flash Preview estão disponíveis? Não, até 12 de novembro de 2026. A Baidu diz que serão open-source sob Apache 2.0 em breve, e o plugin vLLM-ERNIE lista o modelo de chat como "Coming soon". Apenas os pesos do Base (FP8 e BF16) estão no Hugging Face.
Por que o /v1/chat/completions falha no modelo Base? O Base não tem treinamento para chat nem template de chat. A Baidu o serve via /v1/completions com um prompt de texto bruto. Coloque exemplos few-shot no prompt e use uma sequência de parada.
O vLLM suporta o ERNIE 5.5 nativamente? Não no núcleo do vLLM. Você precisa do plugin vLLM-ERNIE da Baidu sobre o vLLM 0.32.0. Ele roda apenas em GPUs NVIDIA. O SGLang também serve o modelo por meio de uma imagem Docker dedicada, citada no model card.
Posso usar o ERNIE 5.5 Flash Base comercialmente? Sim, sob condições. Produtos que faturam até US$ 50 milhões por ano podem usá-lo sem cobranças de licença, com a atribuição "Powered by ERNIE" e um aviso único à Baidu. Acima disso, é necessária autorização por escrito, e o território da licença exclui a UE, o Reino Unido e a Coreia do Sul.