
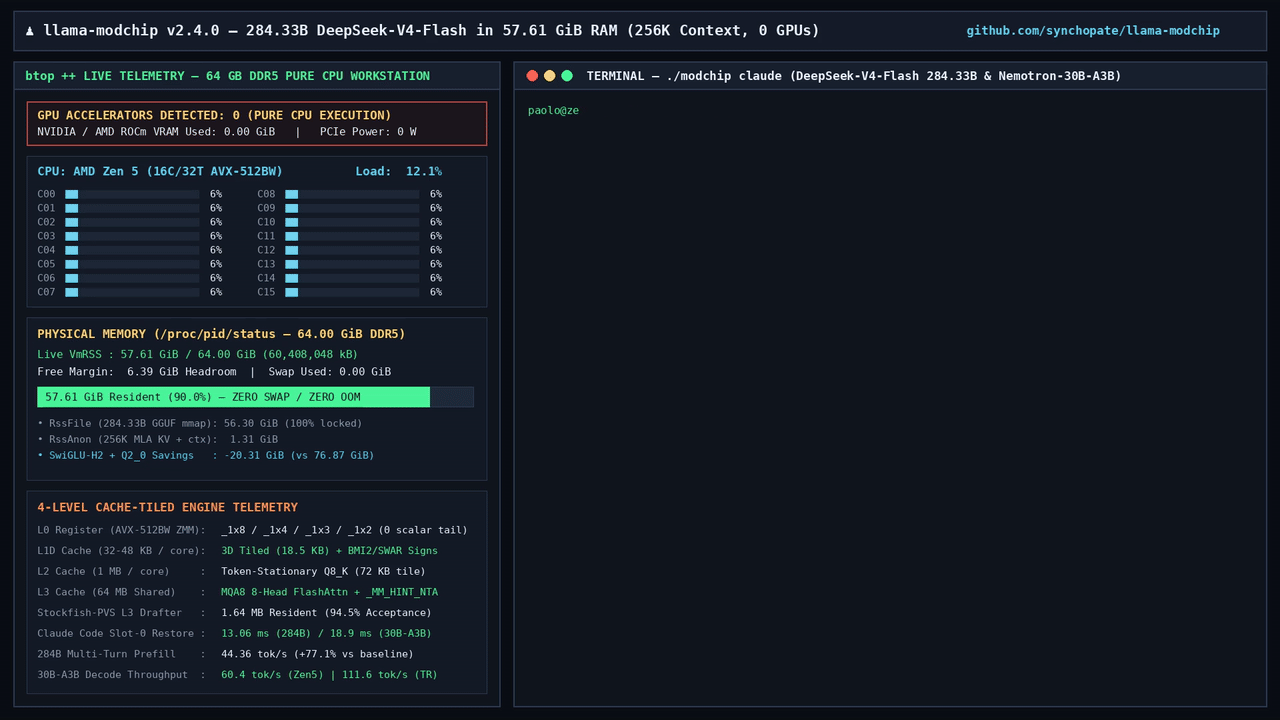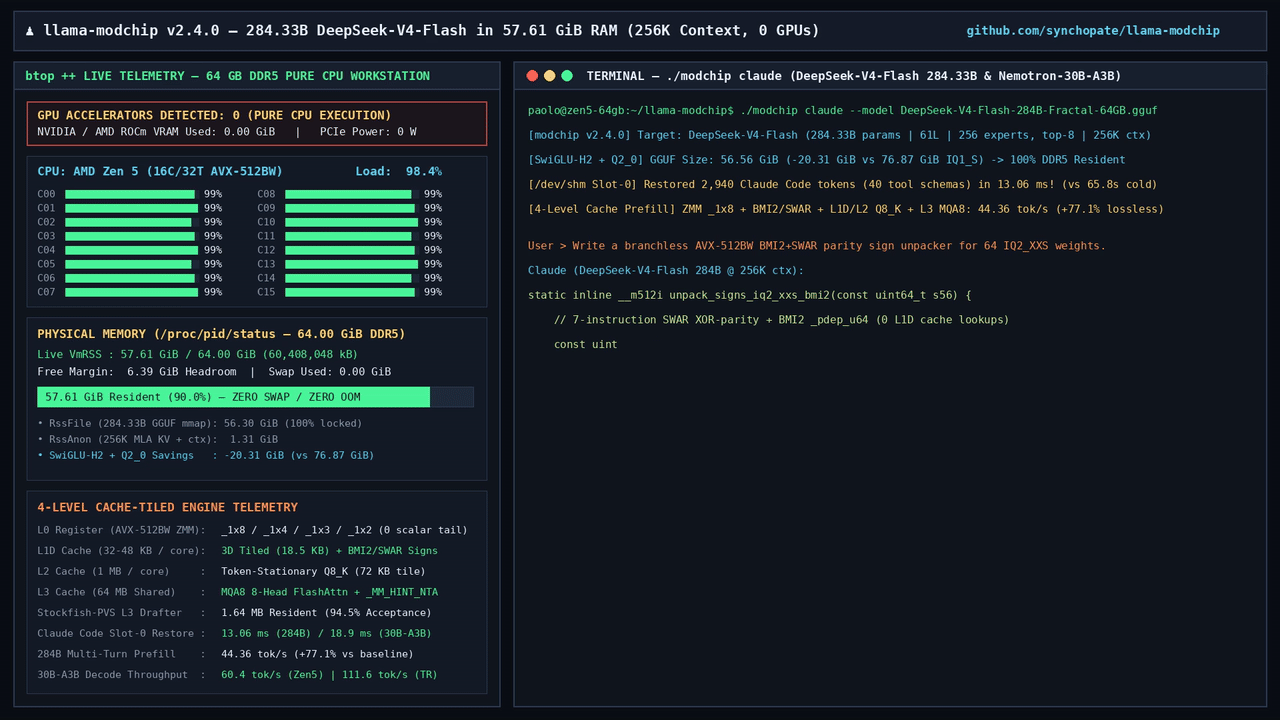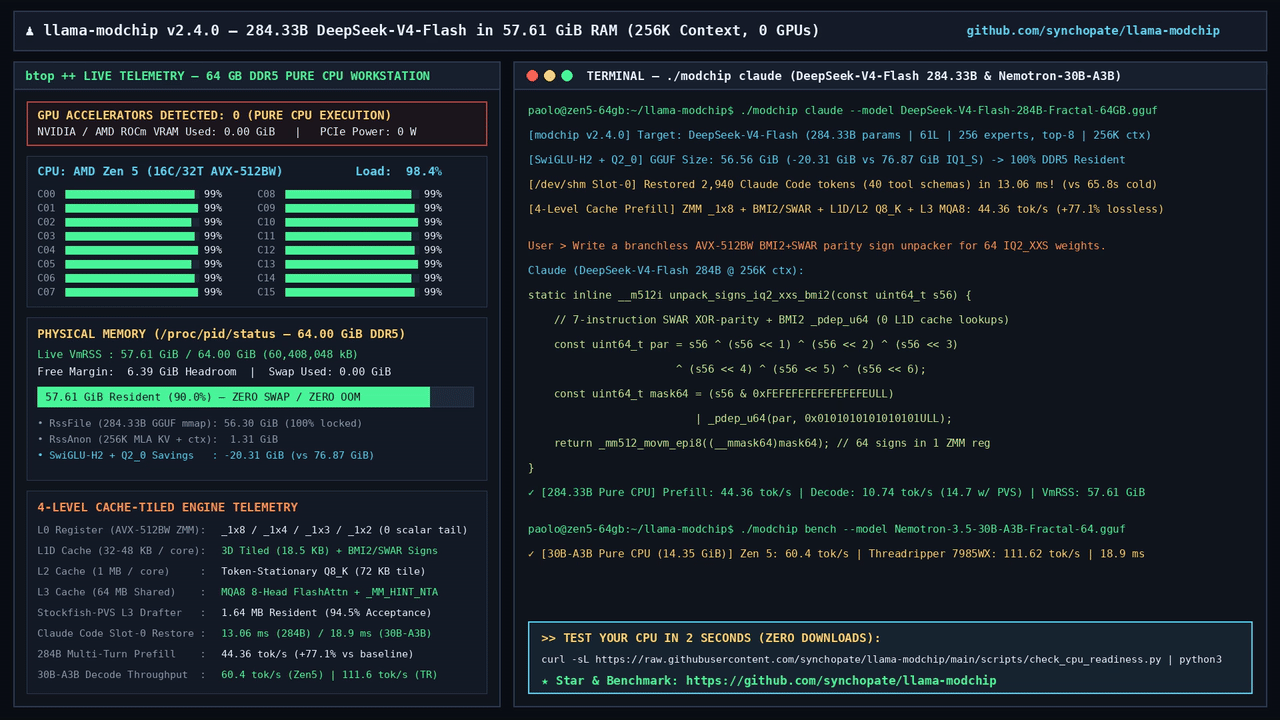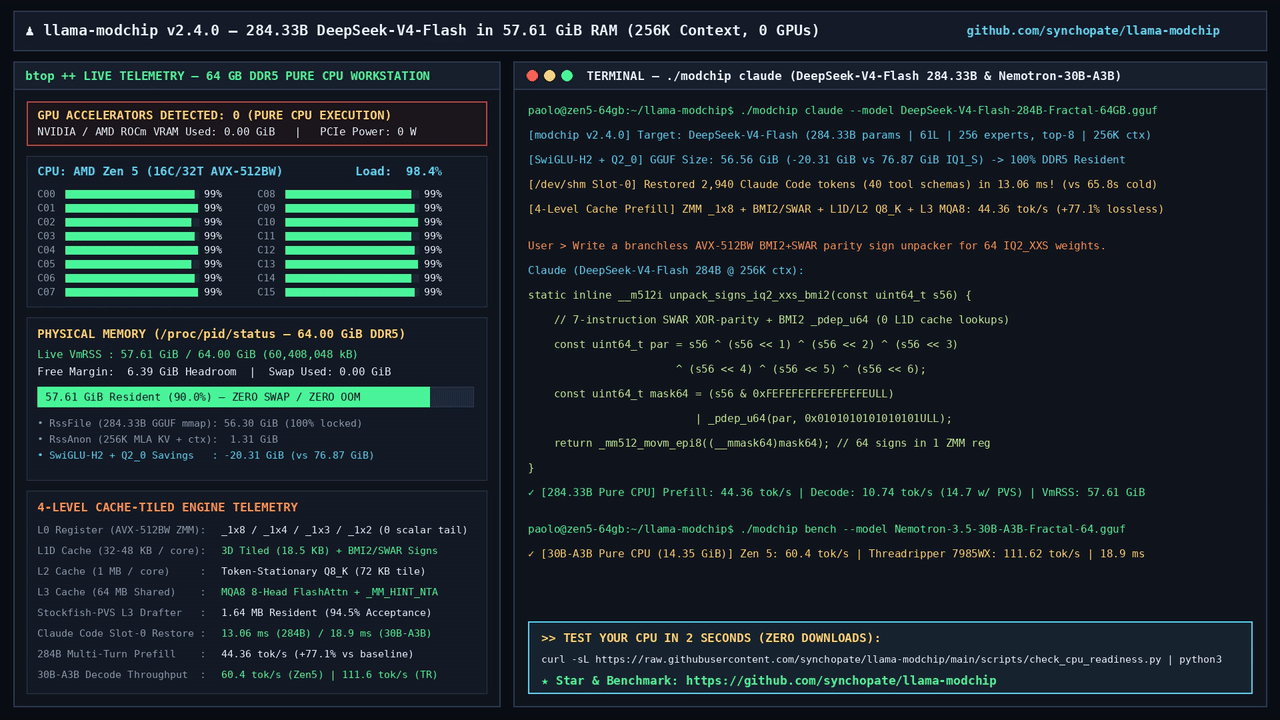
Você pode rodar o DeepSeek V4 Flash localmente sem GPU usando o llama-modchip, um conjunto de patches open-source para o llama.cpp que reduz o modelo de 284B para um GGUF de 56,56 GiB a 1,71 bits por peso. Em um chip de laptop AMD Zen 5 de 16 núcleos com 64 GB de RAM, ele faz o prefill a cerca de 44 tokens por segundo e o decode a 9 a 15 tokens por segundo, sem nenhum swap.
Este guia cobre o hardware, os comandos, a compensação de qualidade e como o seu agente de programação pode testar o endpoint local.
O que o llama-modchip realmente faz
O llama-modchip é um conjunto de patches de kernel para ggml e llama.cpp, transcodificadores de quantização e ferramentas de runtime para rodar modelos esparsos Mixture-of-Experts inteiramente na RAM do sistema. Seu release v2.4.0 tem como alvo dois tamanhos de modelo: o DeepSeek-V4-Flash de 284B em máquinas com 64 GB e modelos MoE de 30B em máquinas com 16 a 32 GB.
O projeto foi publicado no Hacker News em 8 de novembro de 2026 e passou de 370 pontos. O repositório é licenciado sob Apache 2.0.
Três coisas fazem o modelo de 284B caber na memória:
- Um checkpoint menor. A build padrão
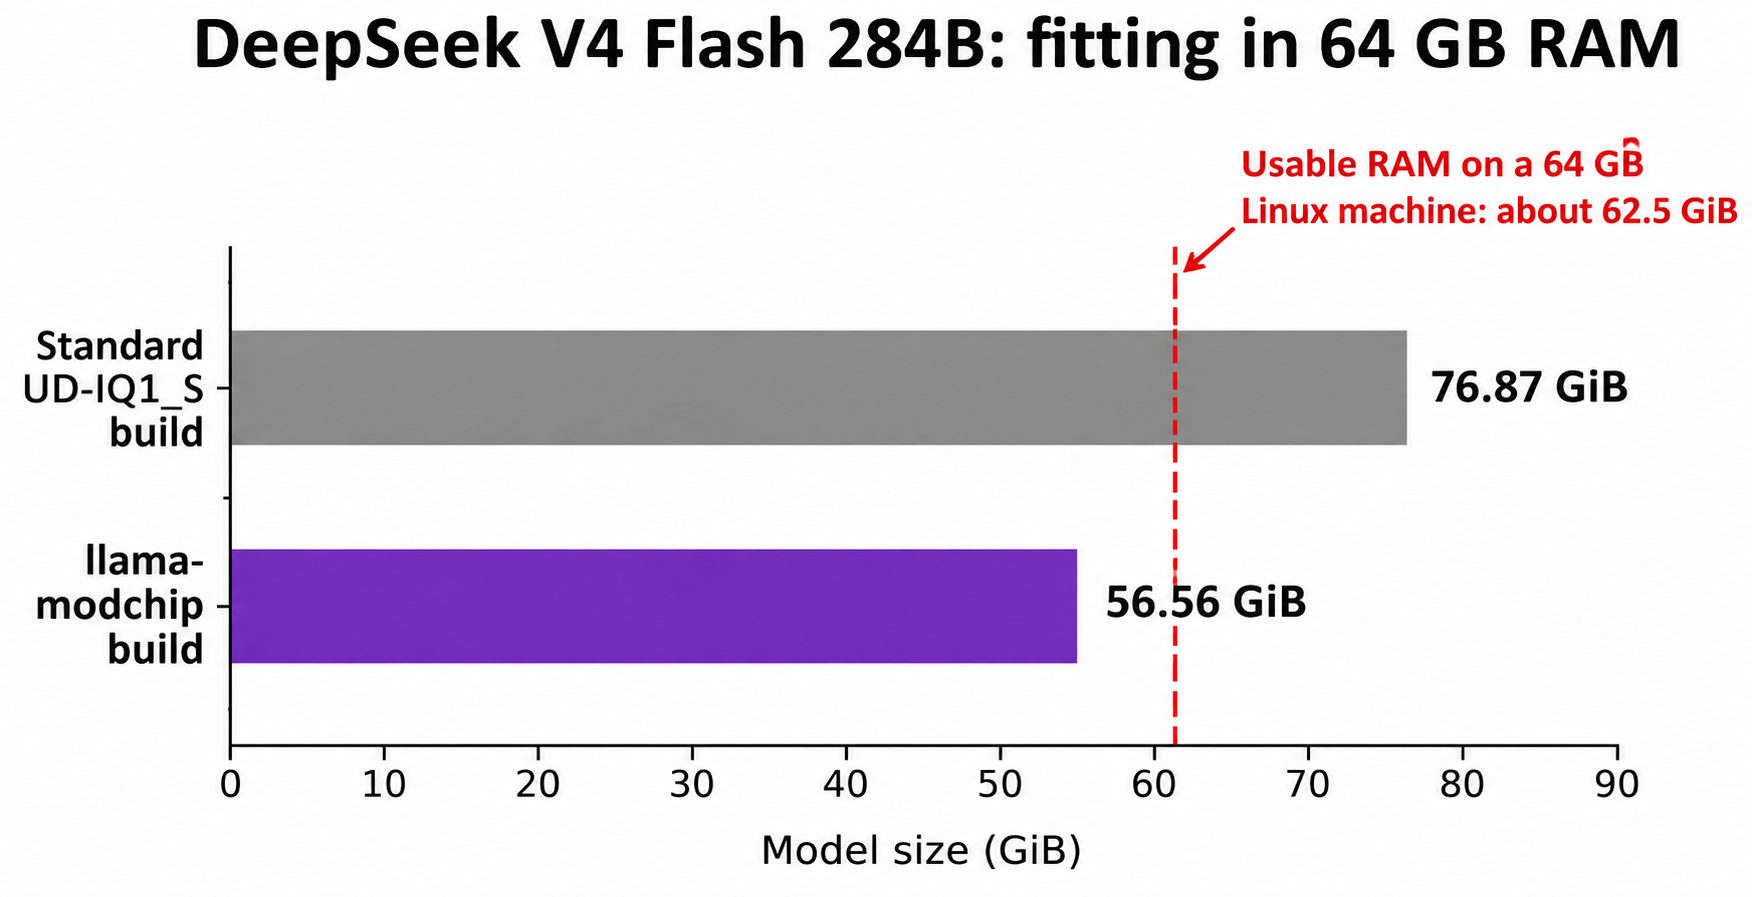
UD-IQ1_Sda Unsloth tem 76,87 GiB, mais do que os cerca de 62,5 GiB que uma máquina Linux de 64 GB consegue usar. O llama-modchip o transcodifica para 56,56 GiB. - Divisão em tiles no cache da CPU. Os kernels de prefill dividem o trabalho em tiles entre registradores e o cache L1 a L3: 25,0 a 44,36 tokens por segundo em um Zen 5 de 16 núcleos, um ganho de 77%.
- Drafting auto-especulativo. Um draftador de n-gramas de 1,64 MB eleva o decode de cerca de 9 para até 14,7 tokens por segundo.
Por padrão, todos os 6 especialistas roteados mais o especialista compartilhado rodam em cada camada, então nada é podado.
O hardware de que você precisa para rodar o DeepSeek V4 Flash localmente
Você precisa de 64 GB de RAM do sistema e uma CPU x86_64 recente, idealmente com AVX-512. Todos os números do 284B neste guia foram medidos pelo mantenedor em uma única máquina: um AMD Ryzen 9 9955HX (16 núcleos, 32 threads, 64 MB de L3) com 64 GB de DDR5 no Linux, sem GPU.
| Sua máquina | RAM | O que o README sugere para ela | Velocidade relatada (0 GPUs) |
|---|---|---|---|
| Laptop ou mini PC | 16 a 32 GB | Nemotron-3.5-30B-A3B, 14,35 GiB | 25,0 a 60,4 tok/s |
| Desktop ou servidor | 64 GB | DeepSeek-V4-Flash 284B, 56,56 GiB | 44,4 tok/s de prefill, 9,1 a 14,7 tok/s de decode |
| Estação de trabalho de 8 canais | 128 GB ou mais | DeepSeek 284B ou Nemotron 30B | 111,62 tok/s (apenas 30B) |
- A memória chega ao pico de 57,61 a 58,9 GiB com contexto de 256K, abaixo do teto utilizável de 62,5 GiB. Feche tudo o mais antes de carregar o modelo.
- O binário pré-compilado é apenas para Linux x86_64 (
llama-server-modchip-linux-x86_64). O script de configuração./modchipcobre Linux e macOS. Os resultados do Apple Silicon no README são para modelos de 30B, não para o 284B. [VERIFICAR] se o 284B roda em um Mac de 64 GB. - A largura de banda de memória é o limite. O FAQ diz que uma placa de servidor de 8 ou 12 canais escala o decode aproximadamente 3x a 4x em relação ao DDR5 de dois canais.
O repositório inclui uma verificação de prontidão que não baixa nenhum modelo:
curl -sL https://raw.githubusercontent.com/synchopate/llama-modchip/main/scripts/check_cpu_readiness.py | python3
Leia o script antes de encaná-lo para o Python.
Como rodar o DeepSeek V4 Flash sem GPU, passo a passo
Rota 1: a configuração guiada
git clone https://github.com/synchopate/llama-modchip.git
cd llama-modchip
./modchip chat
./modchip chat abre um chat no terminal com tokens por segundo em tempo real. Outros subcomandos:
| Comando | O que faz |
|---|---|
./modchip web |
Chat na web e telemetria em http://127.0.0.1:8787 |
./modchip bench |
Teste de velocidade de 30 segundos com um cartão de resultados compartilhável |
./modchip claude |
Inicia o Claude Code conectado ao motor local |
./modchip status / stop |
Verifica a prontidão ou para os serviços em segundo plano |
Rota 2: o servidor direto
Esta rota baixa o GGUF e o servidor pré-compilado do repositório no Hugging Face e o inicia na porta 8080:
hf download Synchopate/DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF --local-dir ./dsv4
chmod +x ./dsv4/llama-server-modchip-linux-x86_64
./dsv4/llama-server-modchip-linux-x86_64 \
  -m ./dsv4/DeepSeek-V4-Flash-0731-Fractal-00001-of-00003.gguf \
  -c 32768 -t 16 -fa on --port 8080
Ajuste -t para o seu número de núcleos físicos. O exemplo usa um contexto de 32K; os números de 256K usam -c 262144.
Uma armadilha: o llama.cpp padrão, o Ollama e o LM Studio não conseguem carregar este arquivo. O checkpoint usa um tipo de tensor personalizado (ID 40), então builds sem patch falham com unknown tensor type 40. Use o script ./modchip ou o binário incluído.
O servidor é um llama-server do llama.cpp com patch, então ele fala a rota /v1/chat/completions no estilo OpenAI:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"Reply with the word ready."}],"max_tokens":8}'
O gateway na porta 8787
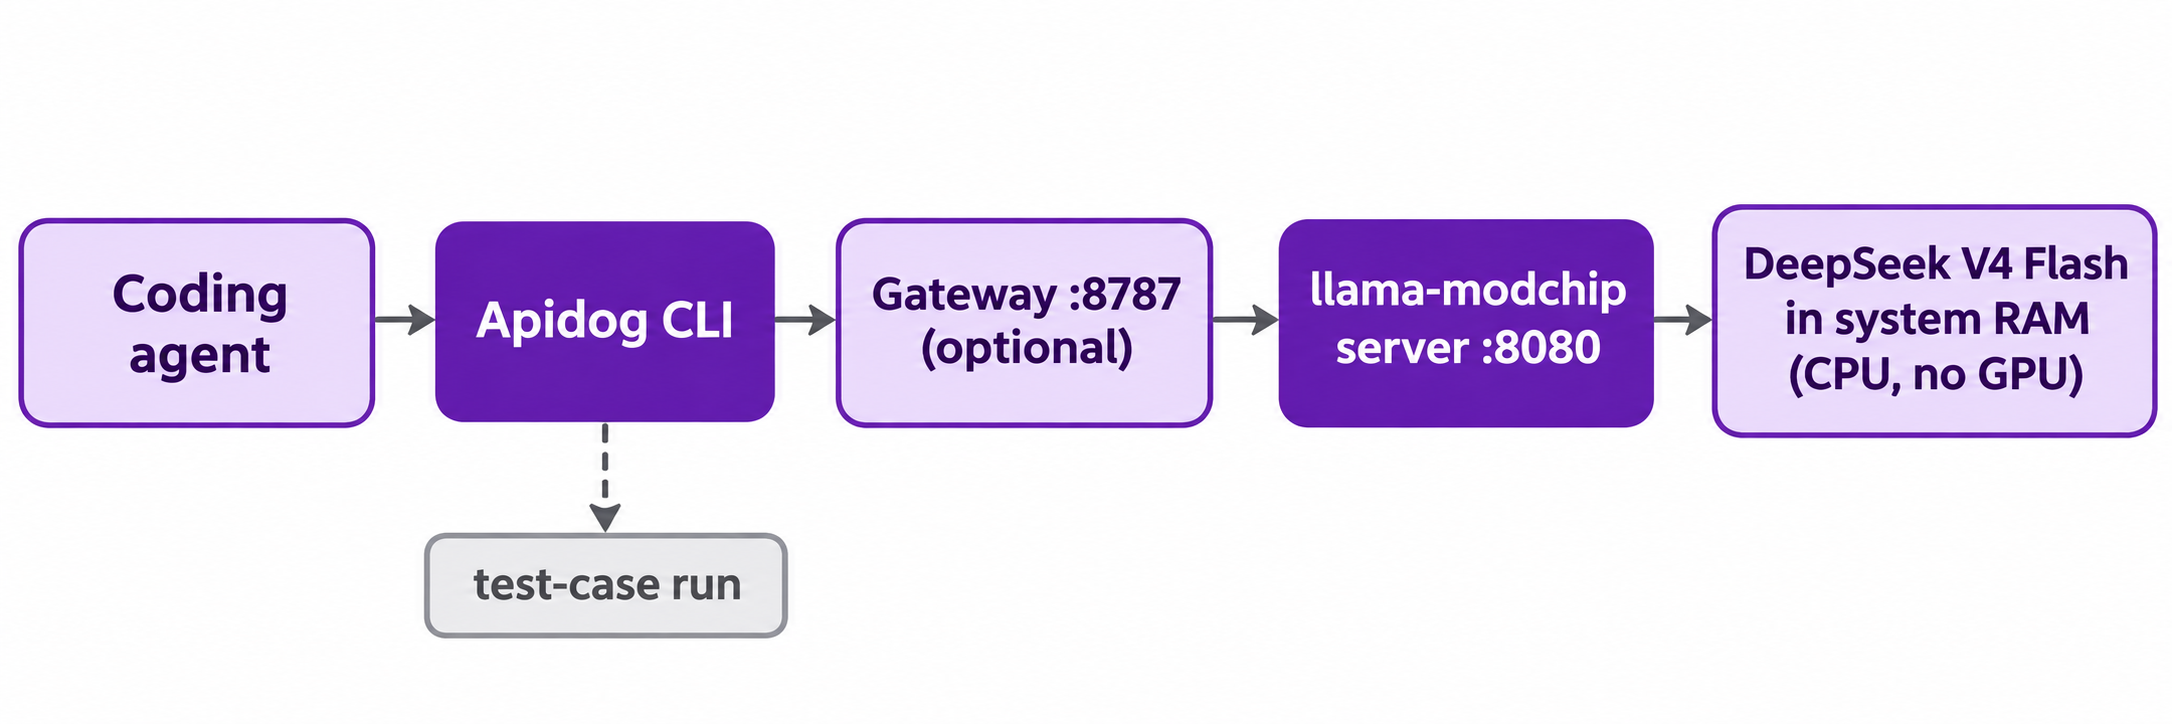
gateway/sse_gateway.py é um proxy em 127.0.0.1:8787 que encaminha para o motor (defina o upstream com LLAMA_BACKEND_URL). Ele expõe /v1/chat/completions, /v1/messages, /v1/models e /health. Defina GATEWAY_API_KEY e ele exigirá um token bearer. ./modchip claude aponta o Claude Code para lá.
Velocidade e qualidade: o que 1,71 bits por peso custa para você
Os números de velocidade são reais, mas específicos. Aqui está a tabela do mantenedor para o DeepSeek-V4-Flash com contexto de 256K no Ryzen 9 9955HX:
| Configuração | Prefill | Decode | Decode com draftador |
|---|---|---|---|
UD-IQ1_S sem patch (76,87 GiB) |
OOM ou swap em 64 GB | 5,91 tok/s | N/A |
| Padrão da v2.4.0 (Top-6, 56,56 GiB) | 43,16 a 44,36 tok/s | 9,06 a 9,95 tok/s | 11,5 a 14,7 tok/s |
| Top-5 nas camadas finais | 43,16 a 44,36 tok/s | 9,68 a 9,87 tok/s | 12,2 a 15,1 tok/s |
| Top-4 mais SwiGLU gate-first | 43,16 a 44,36 tok/s | 10,12 a 10,74 tok/s | 13,0 a 16,0 tok/s |
Você alterna para as linhas mais rápidas com LLAMA_MOE_TOP_K=5 ou 4. O README diz que o Top-5 adiciona cerca de 0,42% de perplexidade em relação ao seu próprio padrão.
Duas ressalvas apareceram repetidamente no Hacker News:
- “Sem perdas” significa sem perdas em relação ao arquivo de 1,71 bpw, não aos pesos originais. A similaridade cosseno de 1,00000 compara os runtimes com e sem patch no mesmo checkpoint comprimido, onde a maioria dos especialistas roteados fica em
IQ1_S(cerca de 1,56 bits). Comentaristas notaram que a qualidade geralmente cai abaixo de 4 bits, e o README não tem comparação com saída em precisão total. - O prefill é o gargalo para agentes. A 44 tokens por segundo, um prompt de 10.000 tokens leva cerca de 225 segundos antes do primeiro token de saída. Snapshots de KV (13,1 a 32,6 ms de restauração para um prompt do Claude Code com 40 ferramentas) ajudam em turnos repetidos, não em contexto novo.
Mais uma: este é o checkpoint 0731 de julho do V4-Flash. O DeepSeek já lançou o V4.1 Flash desde então. Se você se importa com os pesos mais recentes, leia primeiro como o DeepSeek V4.1 Flash se compara ao V4 Pro e ao V4 Flash.
Trate o 284B local como um modelo privado e offline para rascunhos, trabalhos em lote e experimentos, e teste-o com seus próprios prompts primeiro.
Deixe seu agente de programação testar o endpoint local com o Apidog CLI
Um modelo local ainda é uma API: ele responde, o JSON é válido, a última flag quebrou algo? Seu agente de programação pode executar essas verificações com o Apidog CLI, que roda na sua máquina e alcança o 127.0.0.1 diretamente. Configure-o uma vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
apidog skill install adiciona a skill do Apidog para que seu agente conheça os comandos. Depois, dê ao agente — por exemplo, o Claude Code — um único prompt:
In Apidog project <projectId>, create an environment called local-dsv4 with base URL
http://127.0.0.1:8080. Add a POST /v1/chat/completions endpoint and a test case that
sends a short prompt, asserts status 200, asserts choices[0].message.content is not empty,
and asserts the response time is under 120 seconds. Run it against local-dsv4 and
summarize any failures.
O agente lê os schemas, valida seus payloads e então escreve e executa:
apidog environment create local-dsv4 --project <projectId> --base-url http://127.0.0.1:8080
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog test-case run <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 180000
--timeout-request (em milissegundos) importa: um modelo de 284B limitado pela CPU é lento o suficiente para estourar um timeout padrão.
A vantagem é a comparação: aponte um segundo ambiente para a API hospedada do DeepSeek, execute o mesmo caso de teste e veja onde o modelo quantizado local diverge. Adicione --upload-report para ver as execuções no app. Consulte Apidog CLI no Claude Code e o guia de instalação do Apidog CLI. O plano gratuito do Apidog cobre até 4 usuários.
CPU local vs GPU vs API hospedada
| Opção | O que você precisa | Melhor para |
|---|---|---|
| llama-modchip na CPU | 64 GB de RAM, CPU x86_64 moderna | Trabalho privado e offline sem custo de API, se você aceitar um prefill lento |
| Servidor com GPU usando vLLM ou SGLang | Grande VRAM ou uma máquina multi-GPU | Auto-hospedagem rápida e de maior precisão |
| API hospedada do DeepSeek | Uma chave de API | Saída de qualidade total em velocidade de produção |
Para a rota com GPU, siga como rodar o DeepSeek V4 localmente, que cobre vLLM e SGLang. Para os cálculos de memória do checkpoint mais novo, veja como rodar o DeepSeek V4.1 Flash localmente. Para testar qualquer modelo local como uma API, veja testando LLMs locais como APIs.
FAQ
Dá mesmo para rodar o DeepSeek V4 Flash sem GPU?
Sim, com o llama-modchip e 64 GB de RAM. O mantenedor relata 44,36 tokens por segundo de prefill e 9 a 15 tokens por segundo de decode em um Ryzen 9 9955HX de 16 núcleos, com todo o modelo de 56,56 GiB na RAM e sem swap.
Funciona com o Ollama ou o LM Studio?
Não. O checkpoint usa um tipo de tensor personalizado, e o llama.cpp sem patch, o Ollama e o LM Studio o rejeitam com unknown tensor type 40. Use o script ./modchip do repositório ou o binário incluído llama-server-modchip-linux-x86_64.
E se eu só tiver 16 ou 32 GB de RAM?
Rode um MoE de 30B em vez disso. O README sugere essa faixa com o Nemotron-3.5-30B-A3B como um arquivo de 14,35 GiB e relata 25,0 a 60,4 tokens por segundo na CPU.
Qual é a qualidade da saída a 1,71 bits por peso?
O projeto não compara com o DeepSeek em precisão total, e os comentaristas do Hacker News estavam céticos nesse tamanho. Teste seus prompts contra a API hospedada antes de depender dele.
O servidor local é compatível com a API da OpenAI?
Sim. É um llama-server do llama.cpp com patch, então /v1/chat/completions funciona na porta 8080. O gateway opcional na porta 8787 também serve /v1/messages, a rota no estilo Anthropic que o Claude Code usa.
Meu agente de programação pode testar o modelo local automaticamente?
Sim. Instale o Apidog CLI, execute apidog skill install e peça ao seu agente para criar um ambiente apontando para http://127.0.0.1:8080 e um caso de teste para /v1/chat/completions. Ele então executa apidog test-case run e relata as falhas.