
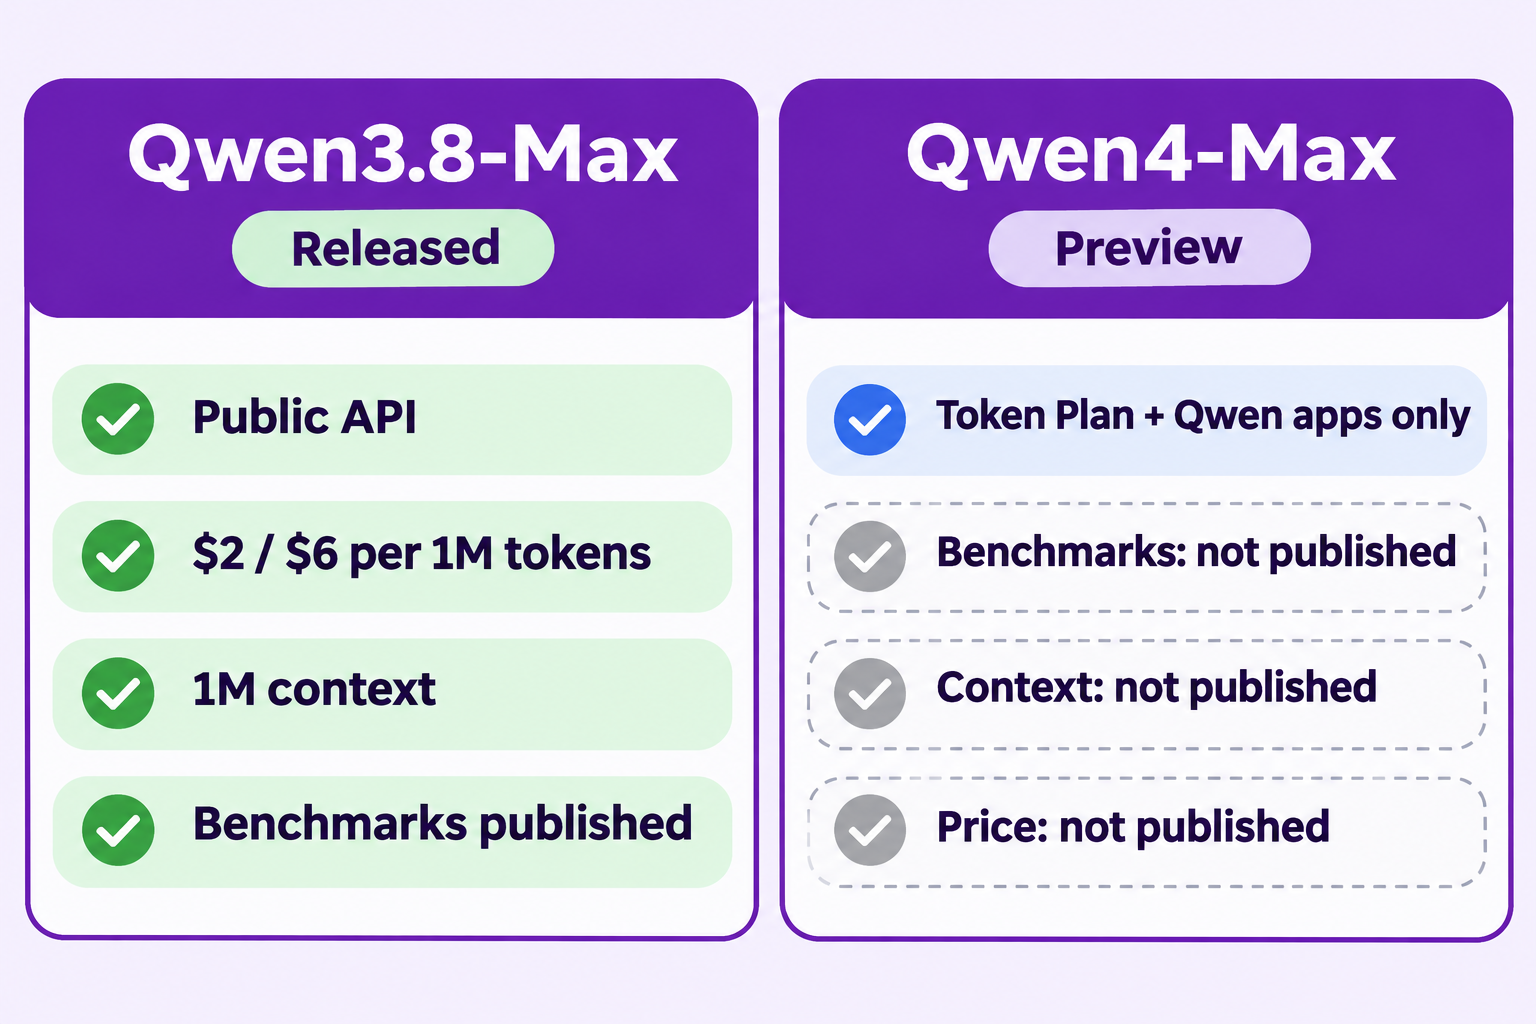
Qwen4-Max vs Qwen 3.8 se resume a isto: o Qwen4-Max é uma prévia que você só pode usar por meio do Token Plan da Alibaba e dos seus próprios aplicativos, sem benchmarks, tamanho de contexto ou preço por token publicados. O Qwen3.8-Max é um modelo lançado com uma API pública a US$ 2/US$ 6 por milhão de tokens, contexto de 1 milhão de tokens e limite de saída de 131K. Escolha o Qwen 3.8 para produção. Teste o Qwen4-Max no seu próprio trabalho.
Esse é o cenário em 11 de novembro de 2026, o dia em que a equipe do Qwen, da Alibaba, colocou o Qwen4-Max em prévia. Abaixo: o que há de novo, o que você pode verificar, o que ainda não pode, e um teste prático. Primeira vez com algum dos modelos? Comece com o que é o Qwen4-Max e o que é o Qwen 3.8.
Qwen4-Max vs Qwen 3.8 em resumo
Cada linha vem das próprias páginas da Alibaba, verificadas em 11 de novembro de 2026.
| Qwen4-Max (prévia) | Qwen3.8-Max | |
|---|---|---|
| Status | Prévia, anunciado em 11 de novembro de 2026 | Lançado, disponível para todos desde agosto de 2026 |
| ID do modelo | qwen4-max-preview (Token Plan) |
qwen3.8-max |
| API pay-per-token | Não publicada | Sim, compatível com OpenAI e Anthropic |
| Preço por token | Não publicado | US$ 2 entrada / US$ 6 saída por 1M de tokens |
| Janela de contexto | Não publicada | 1M de tokens |
| Saída máxima | Não publicada (padrão do Qwen Code: 32.768) | 131K de tokens |
| Entradas | Texto e imagens (tags do Token Plan) | Texto, imagens e vídeo |
| Parâmetros | Não publicados | 2,4T no total, Mixture-of-Experts |
| Benchmarks oficiais | Nenhum | Tabela do fornecedor publicada no lançamento |
| No Token Plan | Sim, “Limited-Time 80% Off” | Sim, “40% Off Nights” |
Fontes: a página do modelo Qwen3.8-Max e a página de preços do Token Plan. O Qwen4-Max ainda não tem página de modelo; a URL retornou um 404 quando verificamos.
O que a Alibaba diz que mudou no Qwen4-Max
O anúncio no X começa com “Qwen4 is coming” e lista quatro melhorias. Estas são afirmações da equipe do Qwen, não resultados medidos:
- Conhecimento mais profundo. Melhores respostas em temas especializados.
- Compreensão de mundo mais rica. Melhor raciocínio sobre contextos do mundo real.
- Capacidades de programação e agênticas mais fortes. Melhor planejamento, uso de ferramentas e trabalho em várias etapas.
- Feito para tarefas do mundo real. A publicação cita “programação complexa e trabalho com conhecimento”, “construção de front-ends” e “fluxos de trabalho profissionais de software”.
Repare em como isso é parecido com a própria proposta do Qwen 3.8. A página do modelo Qwen3.8-Max já descreve “um salto abrangente em programação e trabalho profissional” e projetos autônomos “com duração de mais de 10 dias”. A direção não mudou; o Qwen4-Max afirma ir mais longe pelo mesmo caminho. A publicação termina com “Coloque-o à prova em um problema real”, o que é justo, porque ainda não existe nenhuma ficha técnica.
O que você realmente pode comparar hoje
Cinco diferenças são verificáveis hoje.
1. Estágio de lançamento. O Qwen3.8-Max é um modelo lançado, com limites de taxa documentados (2.000.000 de tokens por minuto, segundo sua página de modelo). O Qwen4-Max é uma prévia. Seu comportamento, limites ou ID podem mudar antes do lançamento geral.
2. Como você o chama. O Qwen 3.8 roda na API padrão pay-as-you-go do Qwen Cloud, então você pode colocá-lo atrás de um backend em produção. O Qwen4-Max roda apenas por meio de endpoints do Token Plan e dos aplicativos da Alibaba. O FAQ do Token Plan diz que o plano Individual é para “desenvolvimento interativo pessoal por meio de ferramentas designadas” e proíbe automação em produção, scripts em lote e tarefas agendadas em segundo plano.
3. Comprimento de saída na prática. O Qwen3.8-Max lista uma saída máxima de 131K. Para o Qwen4-Max, o único número registrado é um padrão de cliente: o guia de configuração do Qwen Code diz que o qwen4-max-preview tem como padrão um limite de saída de 32.768 tokens, que você pode aumentar com generationConfig.samplingParams.max_tokens. Isso é uma configuração de ferramenta, não um teto do modelo.
4. Tipos de entrada. O Token Plan marca o Qwen4-Max com Text Generation, Reasoning Model e Visual Understanding. A página do modelo do Qwen3.8-Max lista entrada de texto, imagem e vídeo.
5. Recursos de API. O Qwen3.8-Max documenta function calling, saídas estruturadas, cache de contexto, arquivos em lote e fine-tuning. Nada disso está documentado para o Qwen4-Max ainda.
O que ainda não dá para comparar
Quatro comparações que as pessoas vão querer fazer não são possíveis em 11 de novembro de 2026.
- Benchmarks. A Alibaba não publicou pontuações do Qwen4-Max. Para ver os números do fornecedor do Qwen 3.8, consulte nossa análise dos benchmarks do Qwen 3.8.
- Janela de contexto. Alguns relatos dizem que o Qwen4-Max tem um contexto de 1 milhão de tokens. As páginas da própria Alibaba não dizem isso, e a análise detalhada da Kie.ai observa que o número de 1M pertence ao Qwen3.8-Max.
- Preço por token. Não existe tabela pay-as-you-go, então não há nada para colocar ao lado dos US$ 2/US$ 6 do Qwen 3.8. O Token Plan não diz quantos Credits custa uma requisição ao Qwen4-Max.
- Tamanho e arquitetura. A Alibaba não publicou a contagem de parâmetros do Qwen4-Max. O Qwen3.8-Max é um modelo Mixture-of-Experts de 2,4T de parâmetros.
Trate qualquer artigo que preencher essas lacunas como especulação. Para detalhes de acesso, veja como usar o Qwen4-Max.
Acesso e preços: Qwen4-Max vs Qwen 3.8
O Token Plan é o único plano que oferece os dois modelos. Em 11 de novembro de 2026, sua página da região de Singapura exibia estes preços mensais do plano Individual em dólares:
| Plano | Preço de evento | Preço de tabela | Credits por mês | Agentes simultâneos |
|---|---|---|---|---|
| Lite | US$ 3,00 | US$ 8,00 | 20.000 | 1-2 |
| Essential | US$ 5,00 | US$ 16,00 | 45.000 | 2-3 |
| Standard | US$ 18,00 | US$ 25,00 | 80.000 | 3-4 |
| Pro | US$ 43,00 | US$ 51,00 | 200.000 | 6-8 |
O preço de evento vale para novos clientes, e a página diz que o preço final é o que o checkout mostrar após o login. Ambos os modelos usam o mesmo pool de Credits. O qwen4-max-preview traz a tag “Limited-Time 80% Off”, e o qwen3.8-max traz “40% Off Nights”.
O Qwen 3.8 tem uma tabela completa de preços pay-as-you-go: US$ 2 de entrada, US$ 6 de saída, US$ 0,25 para acertos de cache implícito e US$ 1 / US$ 3 para arquivos em lote, por milhão de tokens. Para a matemática completa dos custos do Qwen 3.8, leia nosso guia da API do Qwen 3.8.
Para um backend que chama um modelo, o Qwen 3.8 é a única opção entre os dois. Para você programar com um agente, o Token Plan permite experimentar ambos em uma única assinatura.
Faça seu próprio teste de Qwen4-Max vs Qwen 3.8
Sem benchmark oficial, o seu próprio teste é a melhor evidência. Trabalho com APIs se encaixa bem, porque um endpoint passa nos testes ou não passa.
O exemplo de configuração do guia do Qwen Code já lista os dois modelos no mesmo endpoint do Token Plan, então alternar entre eles é escolher uma opção no menu:
{
  "$version": 4,
  "env": { "QWENCLOUD_TOKEN_PLAN_API_KEY": "YOUR_API_KEY" },
  "modelProviders": {
    "openai": [
      { "id": "qwen4-max-preview", "baseUrl": "https://token-plan.maas.qwencloudapi.com/compatible-mode/v1", "envKey": "QWENCLOUD_TOKEN_PLAN_API_KEY" },
      { "id": "qwen3.8-max", "baseUrl": "https://token-plan.maas.qwencloudapi.com/compatible-mode/v1", "envKey": "QWENCLOUD_TOKEN_PLAN_API_KEY" }
    ]
  }
}
Coloque isso em ~/.qwen/settings.json. Depois, monte o teste justo:
- Escreva o contrato uma vez. Crie um
openapi.jsonpara uma API pequena, por exemploPOST /orderseGET /orders/{id}com regras de validação e autenticação. Nenhum modelo escreve a especificação, então nenhum modelo corrige o próprio dever de casa. - Crie duas pastas vazias,
build-qwen4ebuild-qwen38, cada uma com uma cópia da especificação. - Envie o prompt de construção idêntico em cada pasta, com
qwen4-max-previewselecionado em uma eqwen3.8-maxna outra: “Implemente a API do openapi.json com Express. Rode na porta 3001 (ou 3002). Não altere a especificação.” - Registre o básico: tempo até o servidor rodar, arquivos escritos e se você precisou intervir.
Depois, teste as duas construções contra a mesma suíte. É aí que entra o Apidog CLI.
Avalie as duas construções com o Apidog CLI
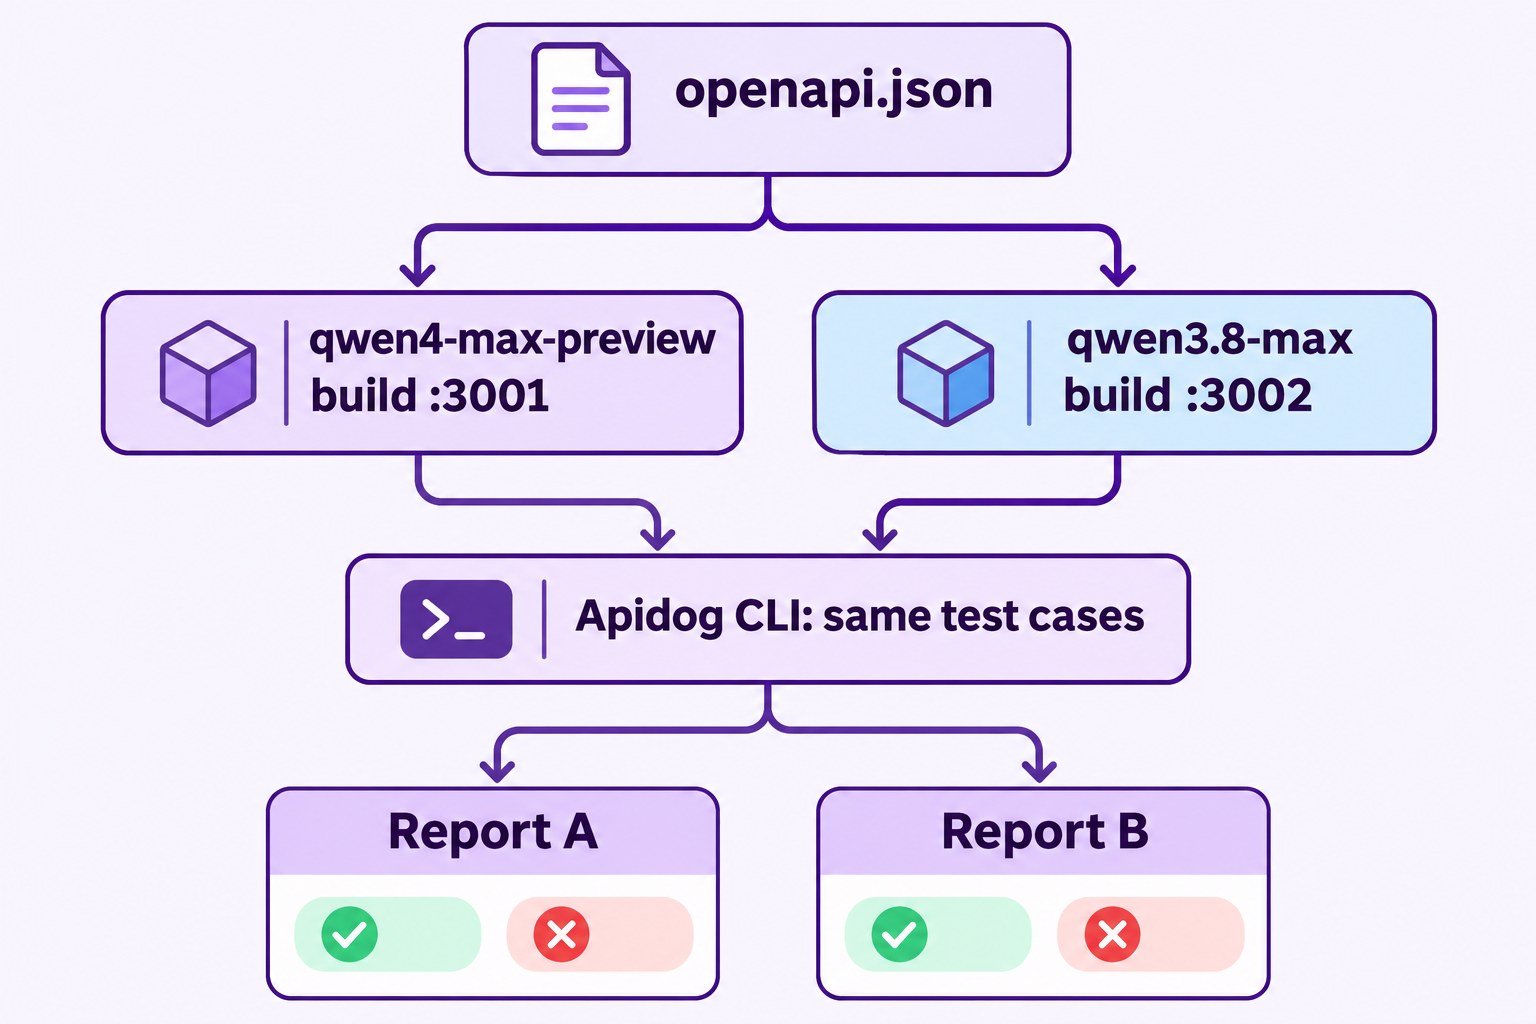
Seu agente de programação comanda o Apidog CLI: ele importa a especificação compartilhada, cria um conjunto de casos de teste a partir dela e executa esse conjunto contra cada construção. Os mesmos testes, dois alvos, dois relatórios.
Configure o Apidog CLI uma vez
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
O apidog skill install ensina a CLI ao seu agente. O guia de instalação cobre os tokens.
Dê um único prompt ao seu agente
Qualquer agente pode arbitrar; não precisa ser um modelo Qwen.
Import ./openapi.json into Apidog project <projectId>. Create two environments:
qwen4 at http://localhost:3001 and qwen38 at http://localhost:3002. From the spec,
create test cases for POST /orders: 201 on a valid order, 400 on a missing
customerId, 401 without a token, plus a GET /orders/{id} 404 case. Run every case
against both environments, save JSON reports, and give me a pass/fail table per model.
Don't modify either build.
Os comandos apidog que ele executa
Cada flag abaixo vem de apidog <command> --help no Apidog CLI 2.2.12:
apidog import --project <projectId> --format openapi --file ./openapi.json
apidog environment create qwen4 --project <projectId> --base-url http://localhost:3001
apidog environment create qwen38 --project <projectId> --base-url http://localhost:3002
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case-201.json
apidog test-case create --project <projectId> --file ./case-201.json
apidog run --test-case <caseId> --project <projectId> -e <qwen4EnvId> -r cli,json --out-file qwen4-{GENERATE_TIME}
apidog run --test-case <caseId> --project <projectId> -e <qwen38EnvId> -r cli,json --out-file qwen38-{GENERATE_TIME}
O cli-schema get entrega ao agente o formato JSON exato de um caso de teste, e o cli-schema validate verifica cada arquivo antes de qualquer coisa ser escrita. O agente repete o test-case create e as duas linhas de apidog run para cada caso. O relator cli imprime um resumo de aprovação/reprovação, e o json salva um relatório em apidog-reports, que o agente lê para montar sua tabela. Adicione --upload-report para visualizar uma execução no aplicativo Apidog.
O que observar nos relatórios
Conte três coisas por modelo: casos aprovados na primeira construção, rodadas de correção necessárias para chegar a tudo verde e qualquer caso em que o modelo alterou o contrato em vez do código. Execute tudo duas ou três vezes, porque uma única execução de um modelo em prévia diz pouco. Para mais padrões orientados a agentes, veja o fluxo de trabalho do Apidog CLI com agentes e o Apidog CLI no Claude Code. O plano Free do Apidog cobre até 4 usuários.
Qual usar hoje?
Combine o modelo com a tarefa:
- Aplicativo ou backend em produção: Qwen 3.8. Ele tem uma API pública, um preço publicado e limites documentados. As regras do Token Plan descartam o Qwen4-Max aqui.
- Programar com um agente: experimente ambos no Token Plan. Rode o teste acima em uma tarefa do seu backlog real, não em algo brinquedo.
- Decisões que precisam de números: espere. Benchmarks, tamanho de contexto e preço do Qwen4-Max ainda não saíram.
Mantenha o ID do modelo em um único valor de configuração, para que o ID estável do Qwen4-Max seja uma mudança de uma linha. Veja também Qwen 3.8 para programação e nosso guia dos melhores modelos Qwen.
FAQ
O Qwen4-Max é melhor que o Qwen 3.8? A Alibaba diz que ele tem conhecimento mais profundo e habilidades de programação e agênticas mais fortes, mas não publicou benchmarks. Nenhum dado oficial prova isso ainda, então teste ambos na sua própria tarefa.
Posso chamar o Qwen4-Max pela API como o Qwen 3.8? Não no pay-as-you-go. O Qwen4-Max está disponível por meio de endpoints do Token Plan com o ID qwen4-max-preview, para uso interativo em ferramentas de programação. O Qwen3.8-Max (qwen3.8-max) tem uma API padrão.
O Qwen4-Max tem contexto de 1 milhão de tokens como o Qwen 3.8? A Alibaba não disse. O Qwen3.8-Max tem um contexto de 1M documentado. O número de 1M para o Qwen4-Max vem apenas de relatos de terceiros.
Quanto custa o Qwen4-Max em comparação com o Qwen 3.8? O Qwen 3.8 custa US$ 2 de entrada e US$ 6 de saída por milhão de tokens. O Qwen4-Max ainda não tem preço por token. Pelo Token Plan, ambos compartilham um pool de Credits em planos a partir de US$ 3 (preço de evento do Lite, tabela de US$ 8) por mês.
Devo migrar meu aplicativo do Qwen 3.8 para o Qwen4-Max? Ainda não. Uma prévia pode mudar sem aviso, e o Token Plan proíbe automação em produção. Mantenha o Qwen 3.8 em produção e rode o Qwen4-Max em paralelo no desenvolvimento.