
O preço do Qwen4-Max na API pay-per-token do QwenCloud é de US$ 1,50 por 1M de tokens de entrada e US$ 4,50 por 1M de tokens de saída na região de Singapura, com entrada em cache a US$ 0,075 por 1M. Os modos thinking e non-thinking custam o mesmo, e não há faixas por tamanho de entrada. Se preferir pagar uma mensalidade fixa para ferramentas de código, o mesmo modelo está disponível no Token Plan, a partir de US$ 6 por mês.
Abaixo: a tabela de preços, custos reais de tarefas, economia com cache, Token Plan vs pay-per-token e preços dos concorrentes. Conhecendo pouco o modelo? Comece por o que é o Qwen4-Max.
Preço da API do Qwen4-Max por 1M de tokens
O Qwen4-Max é cobrado por milhão de tokens, com tarifas separadas para entrada, saída, gravação e leitura de cache. A saída cobre tanto os tokens de raciocínio (“thinking”) quanto a resposta. A Alibaba publica uma coluna para Singapura (Internacional) e outra, mais barata, para Pequim/Global.
| Item cobrado (por 1M de tokens) | Singapura (Internacional) | Pequim / Global |
|---|---|---|
| Entrada | US$ 1,50 | US$ 1,413 |
| Saída (thinking + resposta) | US$ 4,50 | US$ 4,24 |
| Gravação em cache, TTL de 5 minutos | US$ 1,875 | US$ 1,767 |
| Gravação em cache, TTL de 1 hora | US$ 3,00 | US$ 2,827 |
| Leitura de cache (acerto explícito ou implícito) | US$ 0,075 | US$ 0,071 |
Fonte: a documentação de preços do QwenCloud e a página do modelo Qwen4-Max, ambas consultadas em 16 de novembro de 2026. A documentação lista o deployment Global em Frankfurt, Hong Kong, Tóquio e EUA (Virgínia).
Algumas regras moldam a conta:
- Tokens de thinking são saída. Ao ativar o
enable_thinking, cada token de raciocínio é cobrado a US$ 4,50 por 1M. - Não há sobretaxa por contexto longo. Uma requisição de 900K tokens custa o mesmo por token que uma de 9K.
- Leituras de cache custam 5% do preço de entrada. US$ 0,075 contra US$ 1,50 é um desconto de 95% em prefixos repetidos.
- Limites: contexto de 1M de tokens, até 991K de entrada (983K com thinking), até 393K de saída e 5.000.000 de tokens por minuto.
O id do modelo é qwen4-max. Se você ainda não fez uma chamada, nosso guia da API do Qwen4-Max cobre chaves, URLs base e a primeira requisição.
Quanto custa uma tarefa real no Qwen4-Max
Preços por token são difíceis de dimensionar. A Alibaba dá um número concreto no post de lançamento: no benchmark de agentes Work360, o custo médio por tarefa caiu de US$ 4,43 com o Qwen3.8-Max para US$ 1,67 com o Qwen4-Max, 62% menos. A Alibaba também relata que o Qwen4-Max usou cerca de 24% menos tokens no nível de esforço Xhigh e cerca de 35% menos no High no Work360. São números do fornecedor, então trate-os como uma direção, não como uma cotação para a sua carga de trabalho.
Você pode estimar seu próprio custo com aritmética simples. Aqui estão três exemplos calculados com os preços de tabela de Singapura:
- Chamada curta de chat. 2.000 tokens de entrada e 500 de saída: 2.000 x US$ 1,50/1M + 500 x US$ 4,50/1M = US$ 0,003 + US$ 0,00225 = US$ 0,0053. Isso dá cerca de US$ 5,25 por 1.000 chamadas.
- A mesma chamada com thinking ativado. Suponha que o modelo raciocine por 6.000 tokens antes da resposta de 500 tokens. A saída passa a ser 6.500 tokens, então a chamada custa US$ 0,003 + US$ 0,02925 = US$ 0,032, cerca de seis vezes mais.
- Pergunta sobre documento longo. 300.000 tokens de entrada e 2.000 de saída: US$ 0,45 + US$ 0,009 = US$ 0,459 sem cache, ou cerca de US$ 0,032 se o documento de 300K for um acerto de cache.
O exemplo 2 costuma surpreender: o thinking pode dominar a conta mesmo quando a resposta é curta. Para números mais detalhados sobre qualidade por dólar, veja a análise de benchmarks do Qwen4-Max.
Como as tarifas de cache mudam a conta do Qwen4-Max
O cache de contexto é onde o preço do Qwen4-Max realmente se diferencia. O QwenCloud oferece dois modos para o qwen4-max na API pay-per-token, e nas APIs Chat Completions, DashScope e compatível com Anthropic eles são mutuamente exclusivos por requisição.
| Modo | Como funciona | Preço | Acerto garantido? |
|---|---|---|---|
| Cache implícito | Automático, não pode ser desativado, reutiliza um prefixo comum de 1.024+ tokens | US$ 0,075 por 1M em caso de acerto | Não. A validade é indeterminada |
| Cache explícito | Você marca um ponto de interrupção com cache_control |
US$ 1,875 (5 min) ou US$ 3 (1 h) para gravar, US$ 0,075 para ler | Sim, enquanto o cache for válido |
A documentação do cache de contexto diz que um cache explícito de 5 minutos reinicia seu temporizador a cada acerto, então um loop de agente intenso o mantém sempre ativo.
Agora considere uma sessão de agente: um prompt de sistema de 200K tokens mais definições de ferramentas e contexto do repositório, reutilizados ao longo de 50 turnos, com 2K de entrada nova e 3K de saída por turno.
- Sem acertos de cache: 10,1M tokens de entrada x US$ 1,50 + 150K de saída x US$ 4,50 = US$ 15,83.
- Acertos de cache implícito a partir do turno 2: os primeiros 202K a preço cheio (US$ 0,30), 9,8M tokens em cache a US$ 0,075 (US$ 0,74), 98K tokens novos (US$ 0,15) e a saída (US$ 0,68) = US$ 1,86.
- Cache explícito de 5 minutos: uma gravação de US$ 0,375 em vez do primeiro prefixo a preço cheio, as mesmas leituras e saída = cerca de US$ 1,94, com acerto garantido.
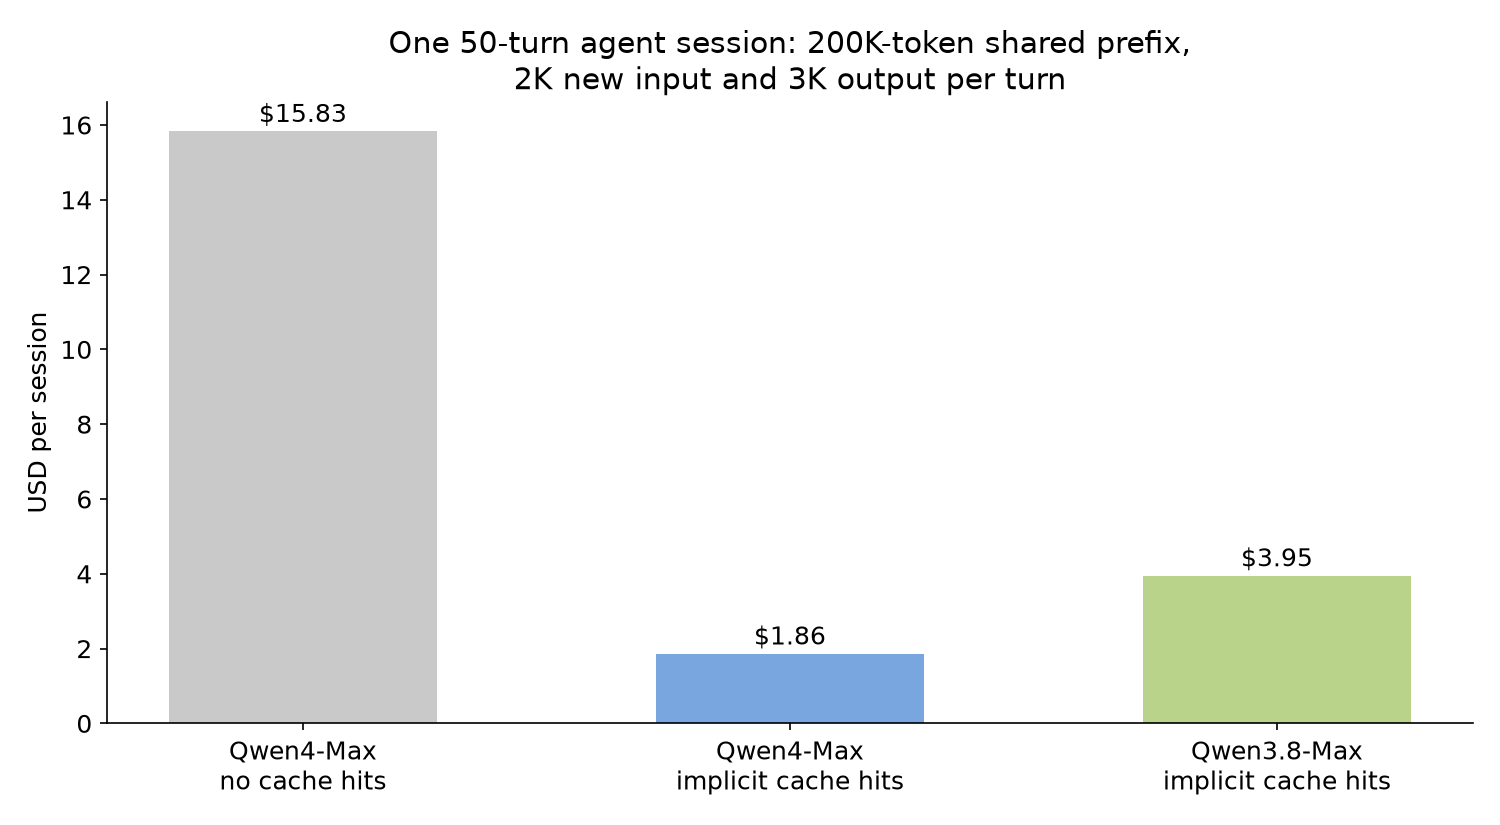
A mesma sessão no Qwen3.8-Max, com suas tarifas de US$ 2 de entrada, US$ 0,25 de cache implícito e US$ 6 de saída, chega a US$ 3,95. É aí que aparece a afirmação da Alibaba sobre o “maior corte na entrada em cache”: o Qwen3.8-Max cobra US$ 0,25 por um acerto implícito, o Qwen4-Max cobra US$ 0,075.
Use cache explícito quando precisar de um acerto previsível e cache implícito para todo o resto. Verifique o que recebeu em usage.prompt_tokens_details.cached_tokens e cache_creation_input_tokens. Se você está comparando a economia de cache entre fornecedores, nossa matemática do prompt caching do Claude Opus 5.5 usa o mesmo método.
Existe desconto batch no Qwen4-Max?
Sim, mas apenas em uma região. A API Batch do QwenCloud normalmente cobra entrada e saída a 50% do preço em tempo real. Para o qwen4-max, a documentação do batch o lista apenas em China North 2 (Pequim), a US$ 0,707 de entrada e US$ 2,12 de saída por 1M de tokens para Batch File. O Batch Chat em Pequim está listado a US$ 1,413 / US$ 4,24.
O batch não suporta cache de contexto, não se acumula com outros descontos e não é coberto pela cota gratuita. Com taxas altas de acerto de cache, a API em tempo real pode sair mais barata que o batch.
Qwen4-Max pay-per-token vs Token Plan
O Token Plan é a assinatura mensal do QwenCloud para ferramentas de código e agentes como Claude Code, Cursor, Qwen Code, Codex e Qoder. Ele é cobrado em Credits, não em tokens, e usa chaves de API próprias sk-sp-. O qwen4-max está na lista de modelos suportados. Planos individuais, conforme a documentação do Token Plan em 16 de novembro de 2026:
| Plano | Preço por mês | Credits por mês | Agentes concorrentes |
|---|---|---|---|
| Lite | US$ 6 (US$ 3, preço promocional por tempo limitado para novos usuários) | 20.000 | 1-2 |
| Essential | US$ 10 (US$ 5, preço promocional por tempo limitado para novos usuários) | 45.000 | 2-3 |
| Standard | US$ 18 | 80.000 | 3-4 |
| Pro | US$ 43 | 200.000 | 6-8 |
Pacotes extras de Credits custam US$ 15 por 20.000 Credits (até 5 por vez). Quando os Credits acabam, as chamadas são bloqueadas; não há fallback para pay-per-token.
Como escolher:
- Escolha o Token Plan se uma única pessoa usa o modelo por meio de um agente de código todos os dias e quer um custo mensal fixo.
- Escolha pay-per-token para produtos, jobs de backend, batch, fine-tuning ou tráfego irregular. Você paga pelo que usa e mantém o limite de 5.000.000 TPM.
Os Credits por requisição do Qwen4-Max não seguem uma proporção fixa de tokens, então confira o console após um dia de uso real. Cobrimos o plano em profundidade, incluindo até onde os Credits rendem, em Qwen4-Max Token Plan: quanto custa e vale a pena?.
Preço do Qwen4-Max vs Qwen3.8-Max e flagships concorrentes
O Qwen4-Max é mais barato que seu antecessor em entrada, saída, leituras de cache e gravação de cache de 5 minutos (o Qwen3.8-Max lista um único preço de gravação de cache, US$ 2,50; a gravação de 1 hora do Qwen4-Max é US$ 3). Veja como ele se posiciona frente a outros flagships a preços de tabela padrão, cada um consultado na página do próprio fornecedor em 16 de novembro de 2026.
| Modelo | Entrada / 1M | Entrada em cache / 1M | Saída / 1M |
|---|---|---|---|
| Qwen4-Max (Singapura) | US$ 1,50 | US$ 0,075 | US$ 4,50 |
| Qwen3.8-Max | US$ 2,00 | US$ 0,25 (implícito), US$ 0,17 (leitura explícita) | US$ 6,00 |
| DeepSeek V4 Pro (pico / fora de pico) | US$ 1,32 / US$ 0,66 | US$ 0,044 / US$ 0,022 | US$ 3,96 / US$ 1,98 |
| OpenAI gpt-5.6-sol | US$ 4,00 | US$ 0,40 | US$ 20,00 |
| Claude Opus 5.5 | US$ 4,00 | US$ 0,20 | US$ 20,00 |
Fontes: página do modelo Qwen3.8-Max, preços da DeepSeek, preços da API da OpenAI e preços do Claude.
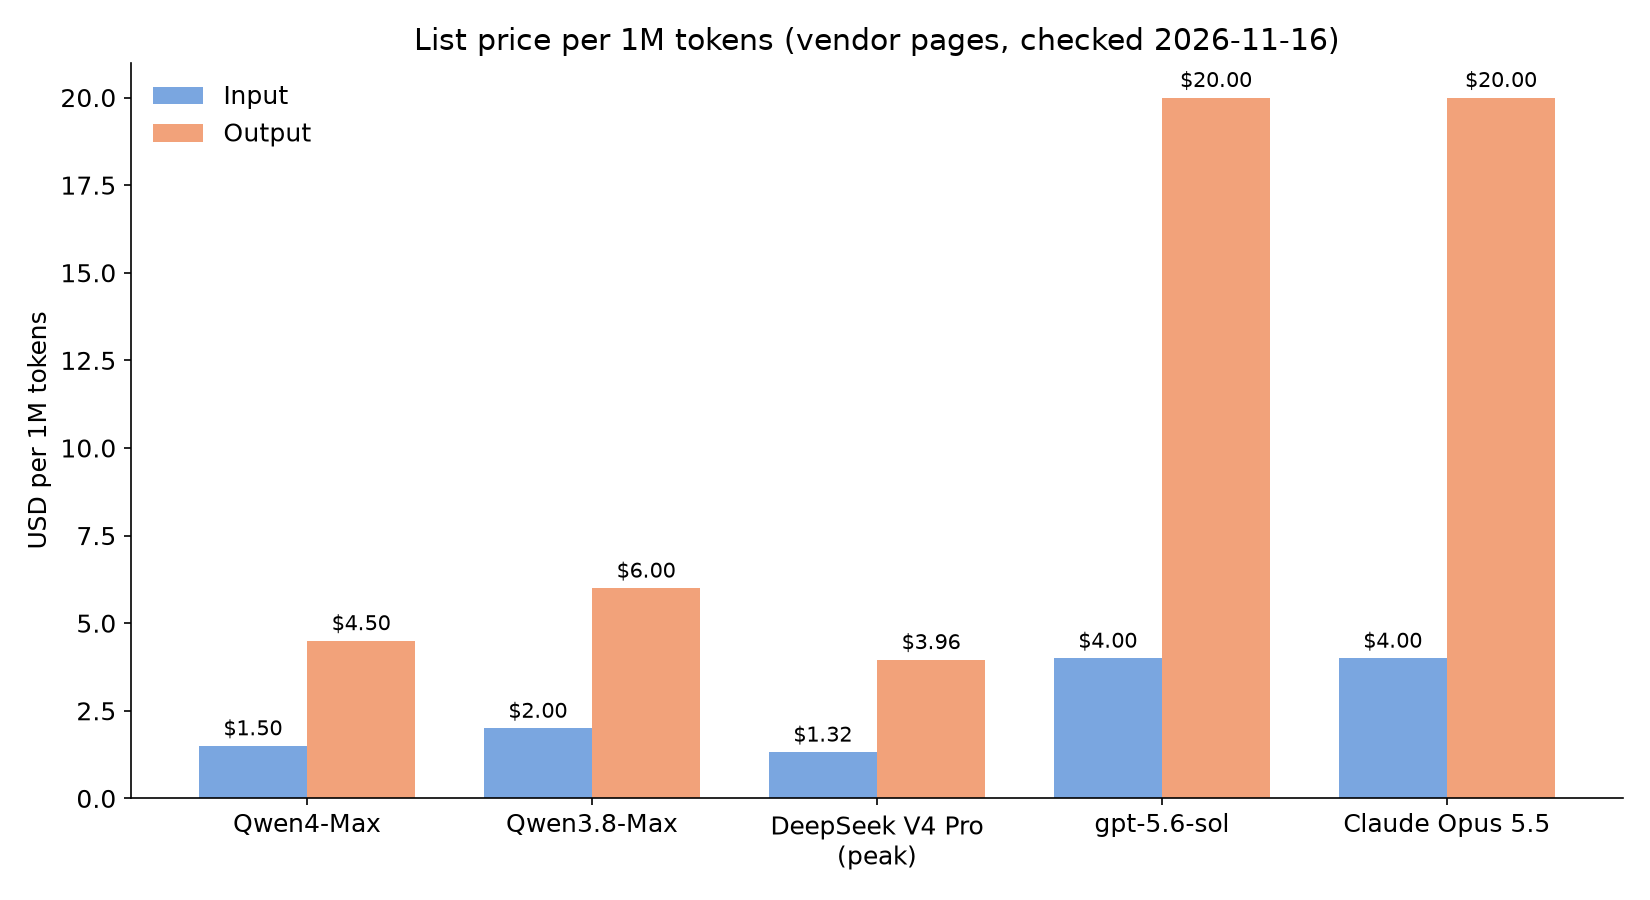
Para agentes, a saída costuma ser a maior linha da conta, e os US$ 4,50 de saída do Qwen4-Max ficam bem abaixo dos US$ 20 cobrados pelo gpt-5.6-sol e pelo Claude Opus 5.5. O DeepSeek V4 Pro é mais barato por token, especialmente fora do horário de pico. O custo por tarefa concluída depende de quantos tokens cada modelo gasta na sua carga de trabalho. Para detalhes sobre o Qwen3.8-Max, veja nosso guia de preços do Qwen 3.8 e a comparação Qwen4-Max vs Qwen 3.8.
Deixe seu agente de código medir os custos do Qwen4-Max com o Apidog CLI
A única estimativa de custo confiável é o usage medido nos seus próprios prompts. Deixe seu agente de código (Claude Code, Codex, Cursor ou similar) montar e executar essa verificação com o Apidog CLI. Configure uma vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
Depois, dê ao seu agente um único prompt:
In Apidog project <projectId>, create an environment "qwencloud-sg" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 and a secret
variable for my DashScope API key. Add a POST /chat/completions endpoint for model
qwen4-max and two test cases: one with enable_thinking true, one false. Assert
status 200, a non-empty choices array and a usage object. Run both and report
prompt_tokens, completion_tokens and cached_tokens side by side.
O agente verifica cada formato de payload contra o schema do CLI antes de escrever qualquer coisa, e então executa os casos:
apidog environment create qwencloud-sg --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case-thinking.json
apidog test-case create --project <projectId> --file case-thinking.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Compare os dois números de completion_tokens e multiplique por US$ 4,50 por 1M: esse é o seu sobrecusto de thinking, nos seus próprios prompts. Adicione --upload-report ao comando apidog run para visualizar a execução no app do Apidog, ou coloque o mesmo comando no CI com -r junit, como mostrado em executando o Apidog CLI em CI/CD. Novato no CLI? O guia de instalação do Apidog CLI e o Apidog CLI no Codex deixam você rodando em minutos. O plano Free do Apidog cobre até 4 usuários.
FAQ
Quanto custa o Qwen4-Max por 1M de tokens? US$ 1,50 de entrada e US$ 4,50 de saída na região de Singapura, com leituras de cache a US$ 0,075. A coluna Pequim/Global é um pouco mais baixa, com US$ 1,413 e US$ 4,24.
O modo thinking custa mais no Qwen4-Max? A tarifa é a mesma, mas os tokens de raciocínio são cobrados como saída a US$ 4,50 por 1M, então raciocínios longos multiplicam o custo de uma chamada.
O Qwen4-Max é mais barato que o Qwen3.8-Max? Sim. A entrada cai de US$ 2 para US$ 1,50, a saída de US$ 6 para US$ 4,50, e um acerto de cache implícito de US$ 0,25 para US$ 0,075 por 1M de tokens. A Alibaba também relata queda no custo por tarefa no Work360, de US$ 4,43 para US$ 1,67.
Posso usar o Qwen4-Max de graça? O QwenCloud oferece uma cota gratuita para modelos novos na região de Singapura, normalmente 1M de tokens válido por 90 dias, após você adicionar dados de pagamento. Confira a página do Free Tier no console para o qwen4-max e veja nosso guia de acesso gratuito ao Qwen4-Max para todas as rotas a US$ 0.
O Qwen4-Max suporta preço batch? Apenas na região de Pequim: o Batch File custa US$ 0,707 de entrada e US$ 2,12 de saída por 1M de tokens, sem cache de contexto.
Devo escolher Token Plan ou pay-per-token para o Qwen4-Max? O Token Plan serve para uma pessoa que usa ferramentas de código diariamente, a partir de US$ 6 por mês. O pay-per-token serve para apps, jobs de backend e trabalho em batch.