
Os benchmarks do Qwen4-Max, em uma frase: o gráfico da Alibaba coloca o Qwen4-Max à frente do Qwen3.8-Max em todos os 15 testes em que ambos aparecem, e em primeiro lugar geral em 4 de 16, mas a maioria desses números vem de execuções da própria Alibaba. No Work360, ele pontua 52,69 contra 47,74, e o custo médio por tarefa cai de US$ 4,43 para US$ 1,67.
Um benchmark só é útil quanto melhor for a resposta à pergunta “quem executou o teste, e como?”. Este guia cobre todas as pontuações publicadas pela Alibaba em 16 de novembro de 2026, as classifica entre auto-relatadas e de terceiros, e termina com uma forma de executar sua própria verificação contra a API do Qwen4-Max. Para o básico, comece com o que é o Qwen4-Max e como obter acesso.
Pontuações de benchmark do Qwen4-Max em resumo
O post de lançamento da Alibaba compara o Qwen4-Max com o Qwen3.8-Max-0902, Opus 5.5, GPT-6.1 Sol, GPT-6 Astra e Kimi K3.1 em 16 benchmarks.
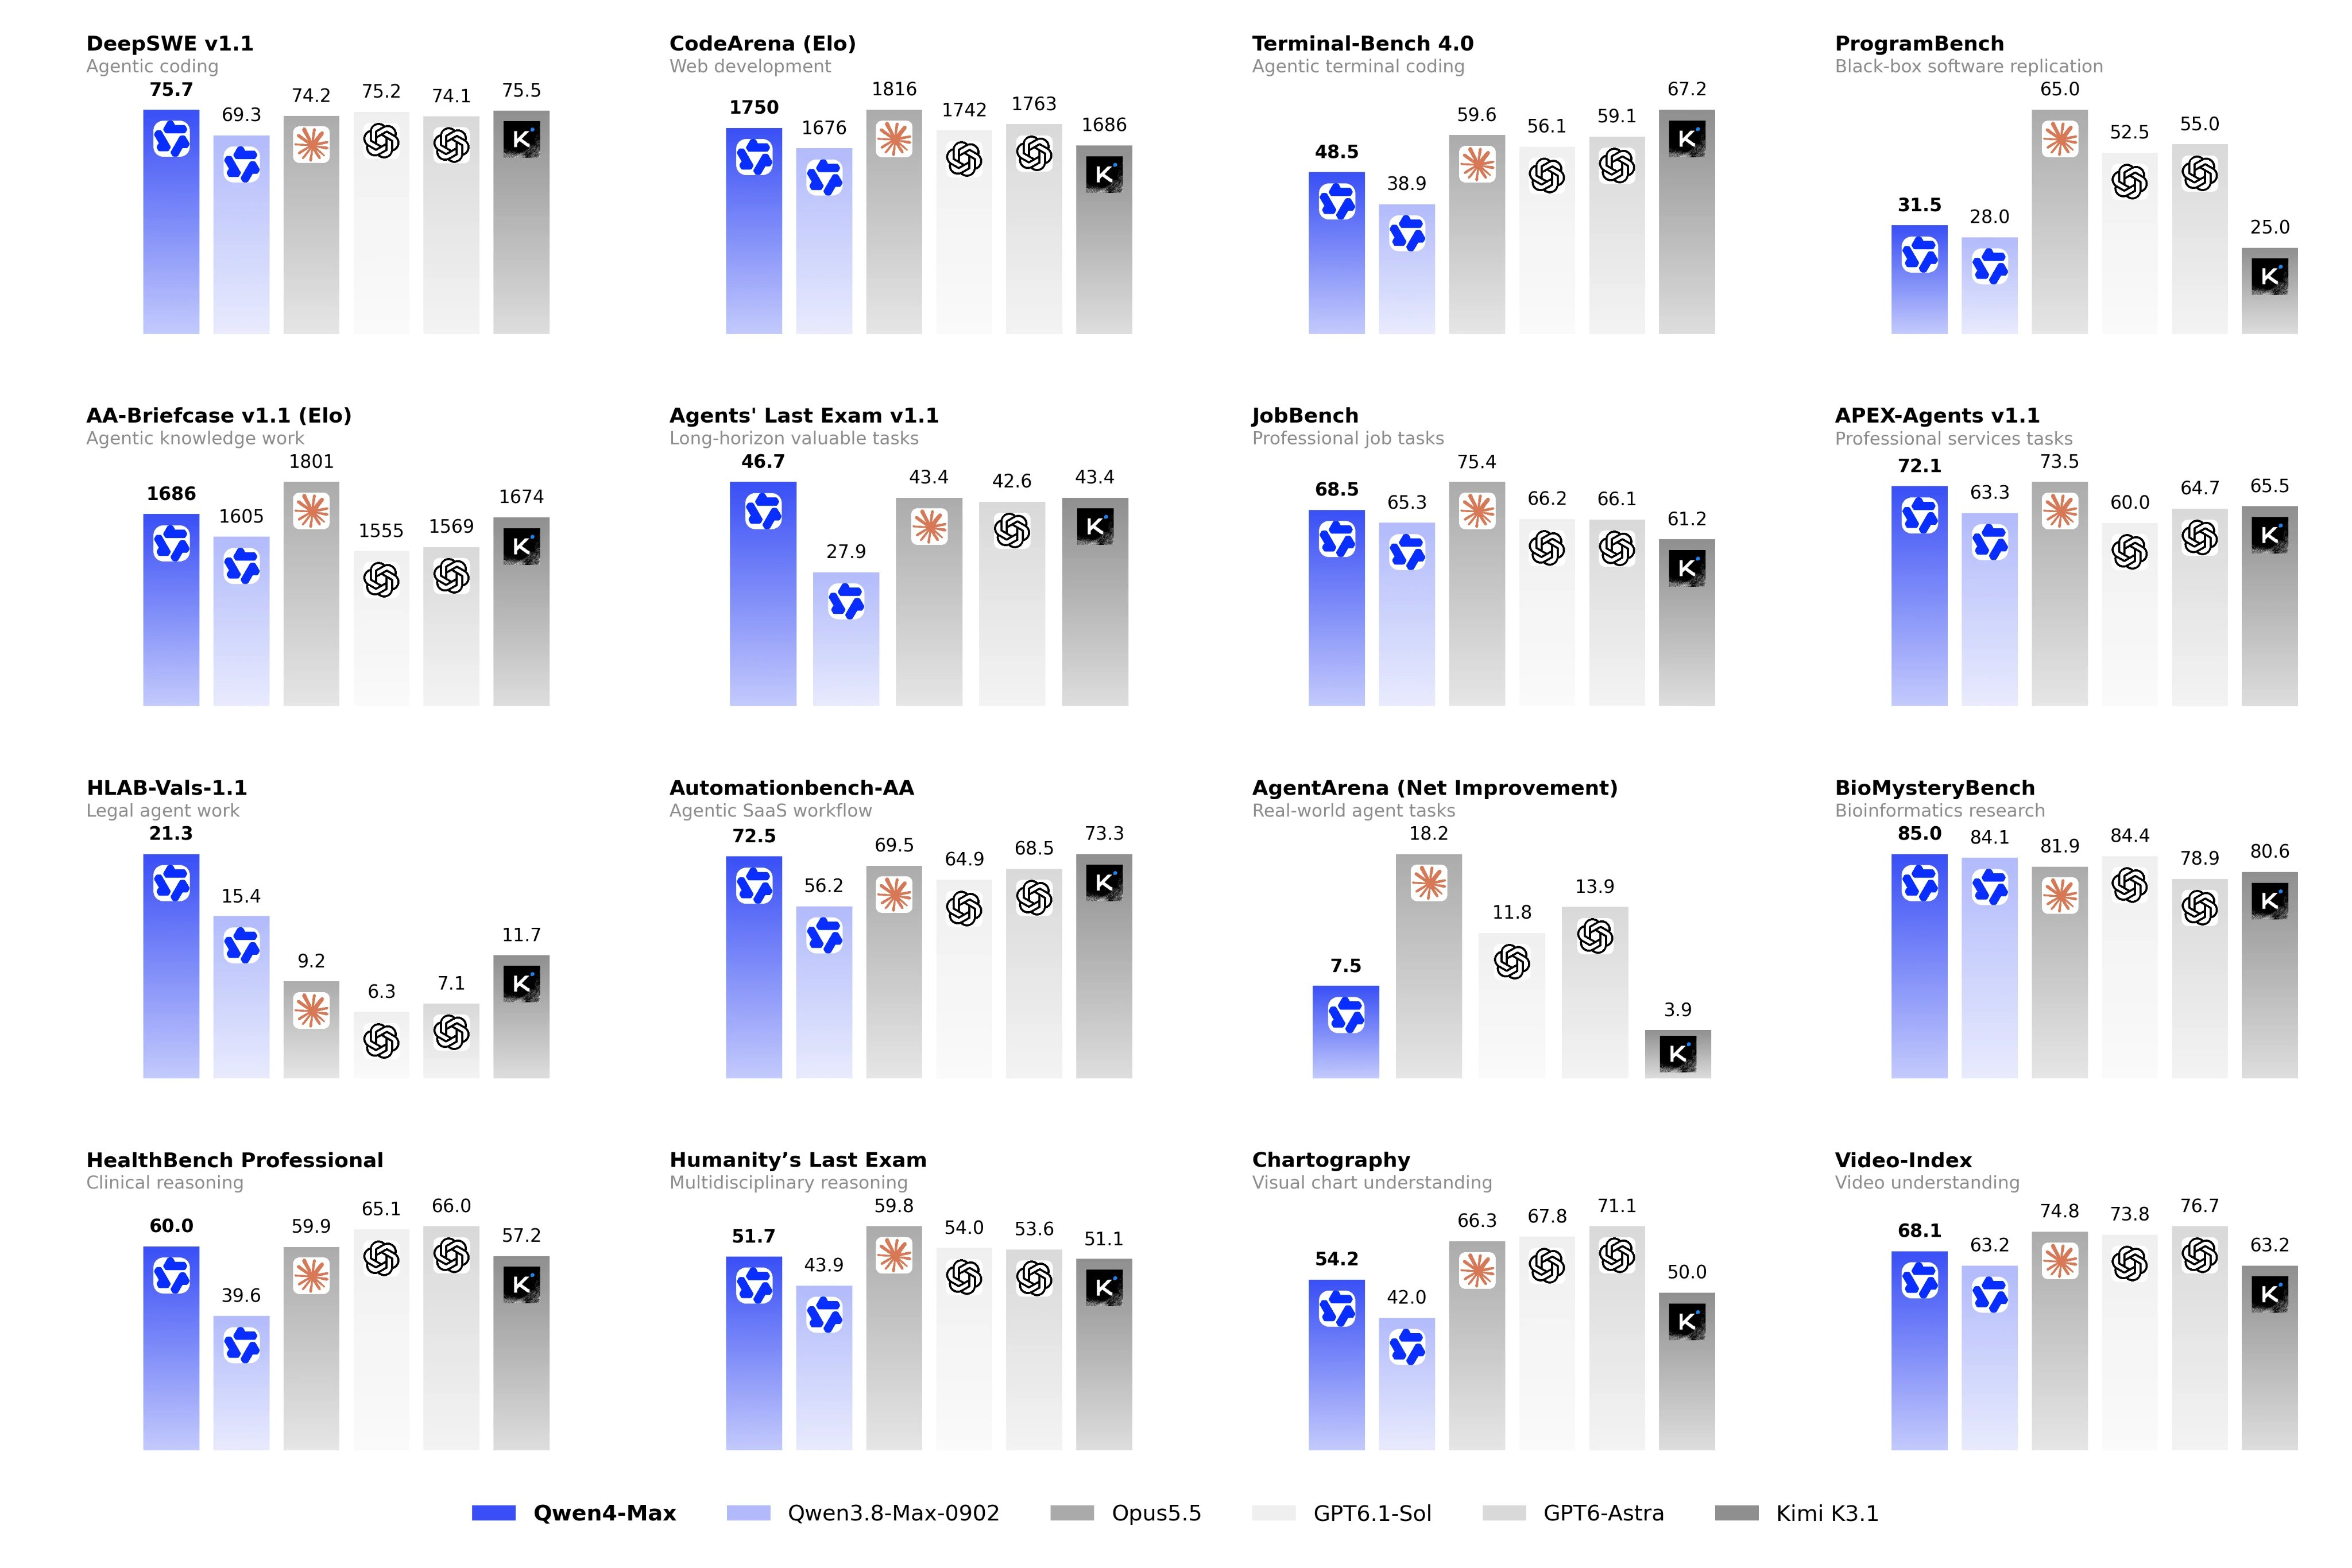
O negrito marca a melhor pontuação do gráfico. “Alibaba” significa que as notas de rodapé não citam nenhum leaderboard externo para aquele teste, então trate-o como uma execução da própria Alibaba (as notas de rodapé de JobBench e Chartography apenas descrevem a configuração da Alibaba).
Auto-relatado vs. terceiros: quem executou cada teste
Dez das 16 pontuações são auto-relatadas. Seis são citadas de leaderboards públicos mantidos por terceiros. Essa divisão é o filtro mais útil que você pode aplicar.
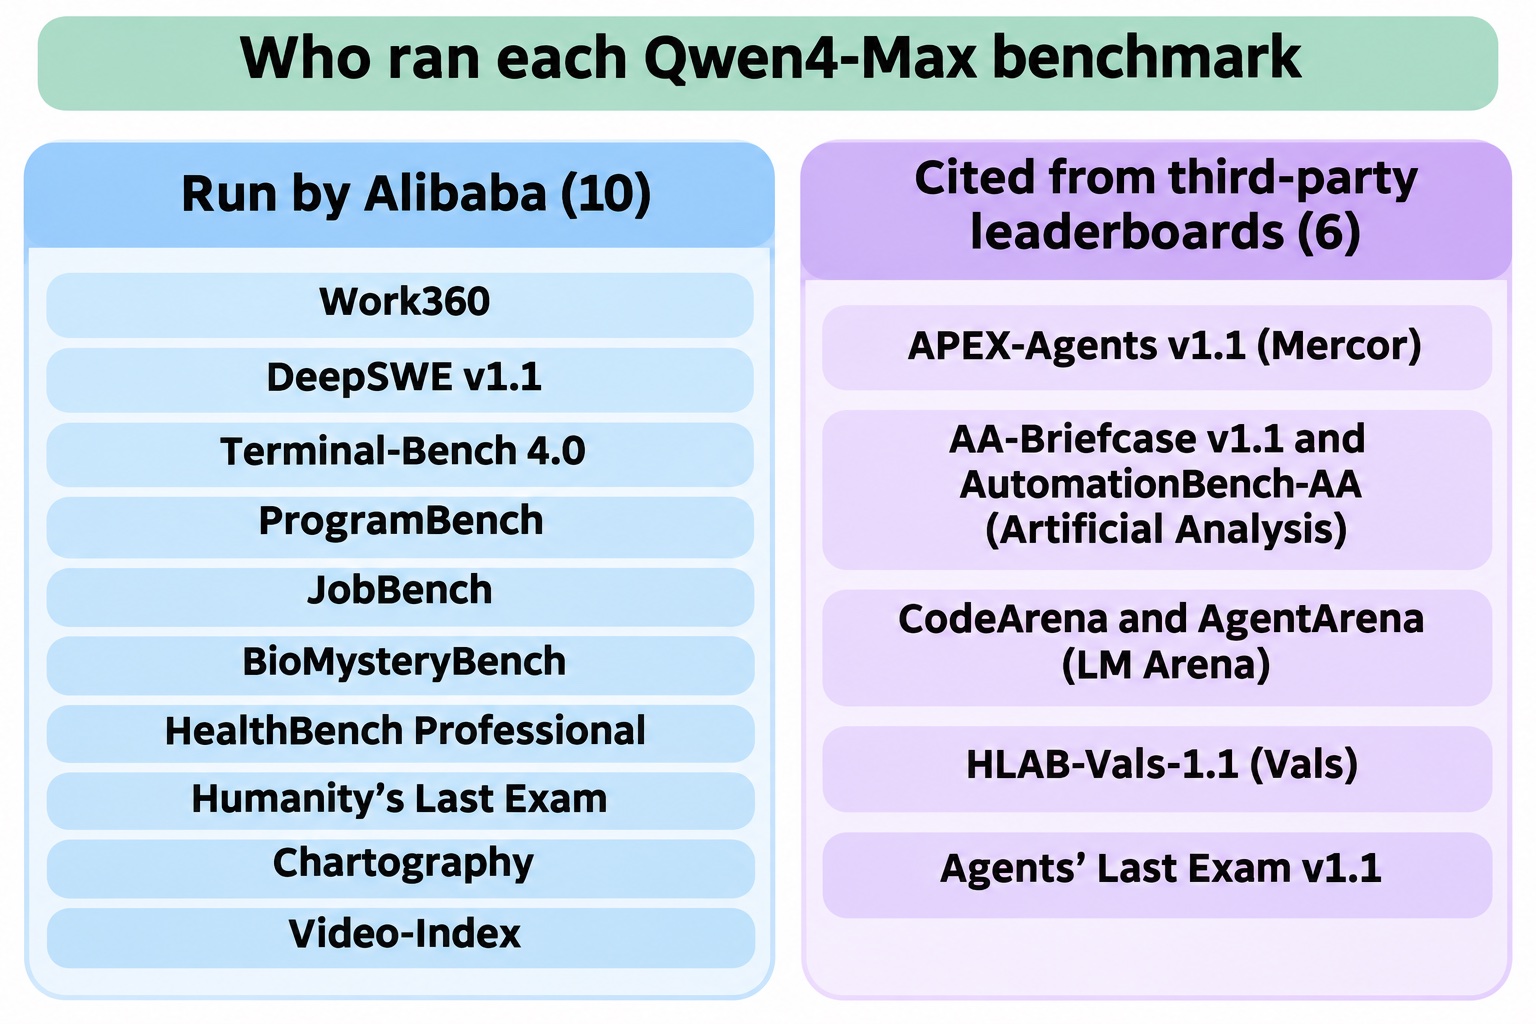
O grupo de terceiros, conforme as notas de rodapé do post de lançamento:
- APEX-Agents v1.1: citado do leaderboard APEX-Agents da Mercor
- AA-Briefcase v1.1 e AutomationBench-AA: citados da Artificial Analysis
- CodeArena e AgentArena: citados do LM Arena
- HLAB-Vals-1.1: citado do Vals Index
- Agents’ Last Exam v1.1: citado do seu próprio leaderboard
Um número independente que você pode conferir hoje: o Vals Index (versão 2.2, atualizado em 15 de novembro de 2026) lista o Qwen 4 Max com 63,20% no geral, na 11ª posição, a US$ 9,33 por teste. Isso o coloca atrás de dez modelos, liderados pelo Claude Fable 5.2 com 71,31%, e logo à frente do Kimi K3.1 Pro (62,52%) e do Qwen 3.8 Max 0902 (59,05%). É um cenário mais modesto do que o gráfico principal sugere.
Work360: o benchmark corporativo da própria Alibaba
O Work360 é o benchmark da Alibaba para tarefas industriais complexas, abrangendo 26 domínios, 182 subdomínios e 721 áreas especializadas. O Qwen4-Max pontuou 52,69, acima dos 47,74 do Qwen3.8-Max.
Interprete com cautela: a Alibaba desenhou o benchmark e executou os modelos, sua comparação publicada cobre apenas o Qwen4-Max e o Qwen3.8-Max, e ainda não há um leaderboard público para ele. É um número de geração para geração, não um ranking contra outros laboratórios.
O que o Work360 realmente oferece é um dado de custo: o custo médio por tarefa caiu de US$ 4,43 para US$ 1,67, uma redução de 62%, resultado da combinação de menos tokens por tarefa e preços menores. O Qwen4-Max custa US$ 1,50 por 1 milhão de tokens de entrada e US$ 4,50 por 1 milhão de tokens de saída, conforme a página do modelo no QwenCloud. Detalhamento completo no nosso guia de preços do Qwen4-Max.
Terminal-Bench 4.0 e eficiência de tokens
O Terminal-Bench mede agentes completando tarefas reais em um terminal. A Alibaba relata 48,5 para o Qwen4-Max na versão 4.0, acima dos 38,9 do Qwen3.8-Max. No gráfico da própria Alibaba, os quatro modelos não-Qwen ficam entre 56,1 e 67,2, todos acima dele.
A afirmação maior é sobre eficiência. A Alibaba diz que o uso de tokens cai cerca de 48% no nível Xhigh e 49% no High no Terminal-Bench 4.0, e cerca de 24% (Xhigh) e 35% (High) no Work360. Seu gráfico de pontuação versus tokens mostra a forma dessa tendência:
- No Work360, o Qwen4-Max no nível High já ultrapassa o Qwen3.8-Max no Xhigh, com cerca de 96K tokens por tarefa contra aproximadamente 165K (lido do gráfico, portanto aproximado).
- No Terminal-Bench 4.0, o Qwen4-Max no Xhigh atinge 48,5 com cerca de 150K tokens por tarefa, enquanto o Qwen3.8-Max no Xhigh chega a cerca de 38 com aproximadamente 290K.
Menos tokens para uma pontuação melhor é a direção certa se você paga por token. Mas também é auto-relatado.
Uma verificação que vale conhecer: o leaderboard público do Terminal-Bench agora tem como padrão a versão 4.1, e o Qwen4-Max não está listado lá em 16 de novembro. O Qwen3.8-Max-0902 mostra 27,0% na 4.1 (executado com Claude Code no esforço máximo), contra 38,9 no gráfico 4.0 da Alibaba. Versão e harness diferentes, então não subtraia um do outro, mas isso mostra o quanto uma pontuação varia conforme a configuração.
Onde o Qwen4-Max lidera, e onde fica atrás
Contra os outros modelos de fronteira no gráfico, o cenário é misto:
Lideranças (4 de 16): DeepSWE v1.1 (75,7, uma vantagem de 0,2 ponto sobre o Kimi K3.1), Agents’ Last Exam v1.1 (46,7), HLAB-Vals-1.1 (21,3) e BioMysteryBench (85,0, menos de um ponto à frente do GPT-6.1 Sol).
Segundo lugar por pouco: APEX-Agents v1.1 (72,1 vs. 73,5), AutomationBench-AA (72,5 vs. 73,3) e AA-Briefcase (1686 vs. 1801 Elo).
Claramente atrás: ProgramBench (31,5 vs. 65,0), Terminal-Bench 4.0 (48,5 vs. 67,2), AgentArena (7,5 vs. 18,2), Chartography (54,2 vs. 71,1) e Humanity’s Last Exam (51,7 vs. 59,8).
Duas das quatro lideranças, Agents’ Last Exam e HLAB-Vals, vêm de leaderboards de terceiros, o que as torna as afirmações mais fortes do gráfico. Em programação, o resultado se divide: uma vantagem estreita no DeepSWE, diferenças amplas no ProgramBench e no Terminal-Bench. Se você executa agentes longos em terminal, teste antes de migrar. Para saber o que mudou desde a geração anterior, veja Qwen4-Max vs. Qwen 3.8.
Números de codificação segura e pré-treinamento
Codificação segura. No Last Secure Code Bench, na configuração “reconstrução de código sem dica de segurança”, com funcionalidade e vulnerabilidades verificadas, a taxa de aprovação no nível de função subiu de 22,0% no Qwen3.8-Max para 31,8%. A parcela de código aprovada nos três níveis (função, arquivo e repositório) subiu de 8% para 14,7%. Cerca de dois terços das saídas no nível de função ainda falham em alguma verificação, então a revisão de segurança continua sendo responsabilidade sua.
Pré-treinamento. Em avaliações internas de conhecimento, código, QA e STEM, o Qwen4-Max-Base mostra cerca de 5% a 13% menos bits por byte que o Qwen3.8-Max-Base, ativando 25% menos parâmetros. A Alibaba observa que dois checkpoints nessa comparação (GLM-5.3 e Kimi-K3.1-Pro) passaram por pós-treinamento, o que pode distorcer o resultado.
O que ainda falta
- Configurações de avaliação para a maioria dos testes. O post de lançamento não informa qual nível de esforço (High ou Xhigh) nem qual agent harness produziu cada barra.
- Variância. Sem barras de erro nem contagens de execuções. Leaderboards como o Terminal-Bench relatam margens de cerca de 3 a 4 pontos, maiores que algumas das diferenças acima.
- Execuções independentes do Terminal-Bench e do Work360. Nenhum dos dois está em um leaderboard público ainda.
Execute seu próprio benchmark do Qwen4-Max com a Apidog CLI
Nenhum benchmark público usa seus prompts ou seus schemas. A verificação mais rápida e honesta é uma pequena suíte das suas próprias requisições, executada sempre da mesma forma, com registro do uso de tokens para que você possa calcular seu próprio custo por tarefa.
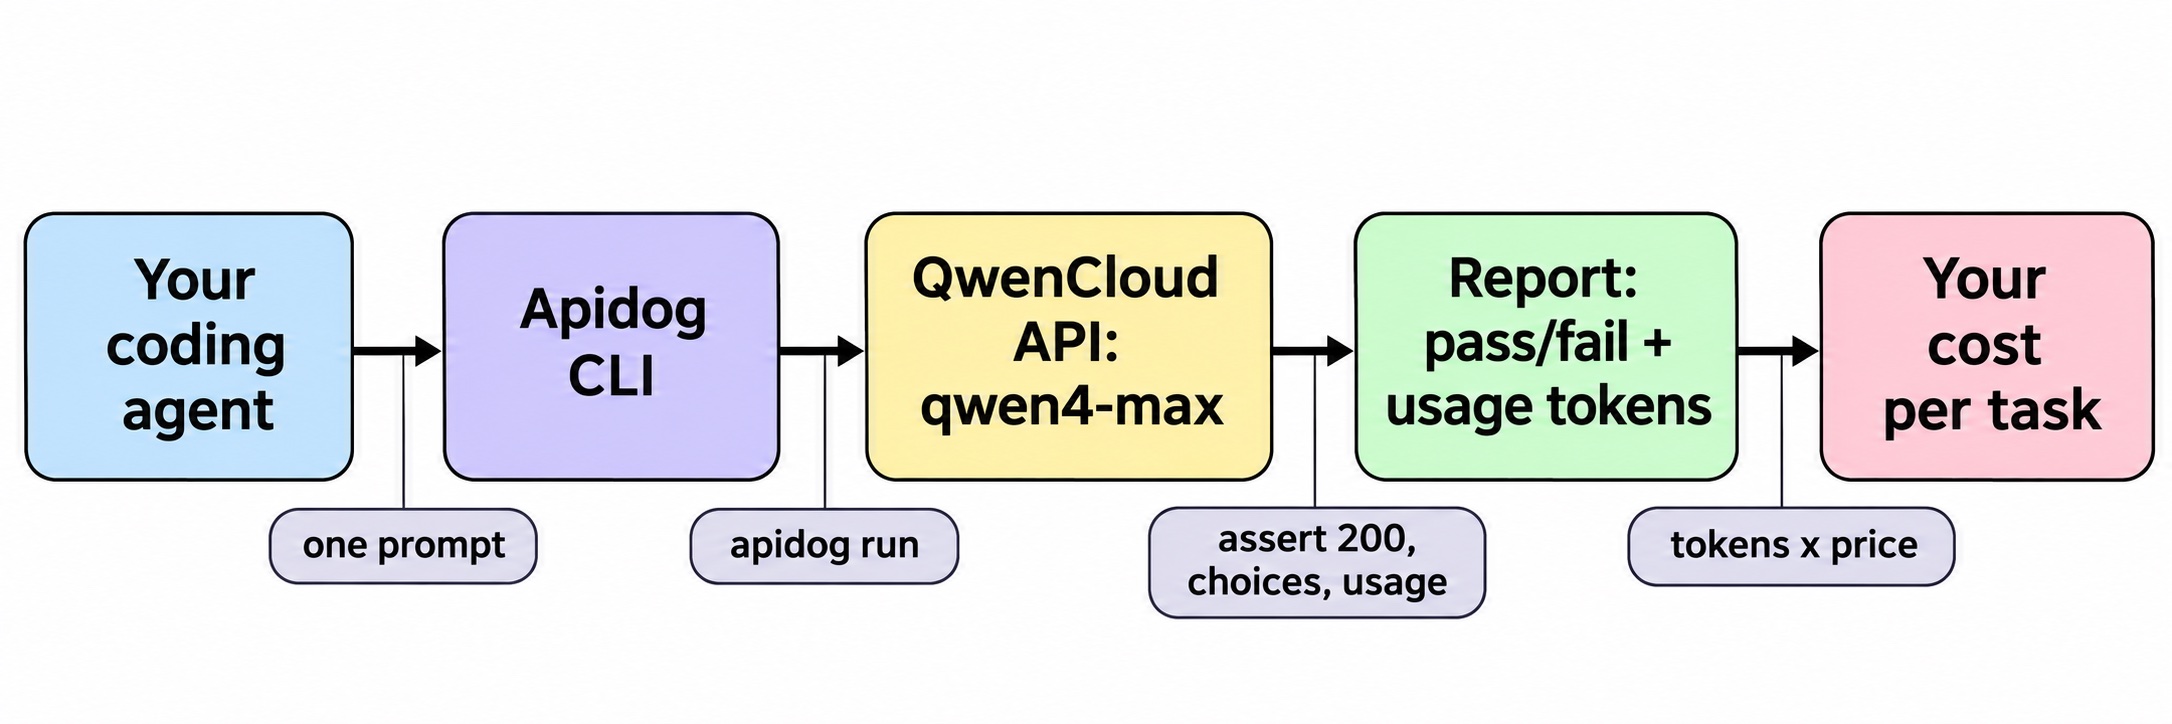
Deixe seu agente de programação fazer a configuração com a Apidog CLI. Instale-a uma vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
O comando apidog skill install ensina a CLI ao seu agente; o guia de instalação cobre os tokens. Depois, dê a ele um único prompt:
In Apidog project <projectId>, add POST /chat/completions for the QwenCloud
OpenAI-compatible API (model qwen4-max, Bearer auth from {{DASHSCOPE_API_KEY}}).
Create an environment "qwencloud-sg" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1.
Create a test case that asserts status 200, a non-empty choices array and a
usage object. Run it once per row of ./prompts.csv, save a JSON report, and
give me pass rate plus total prompt and completion tokens.
O agente verifica a forma de cada payload antes de escrever qualquer coisa. Todas as flags abaixo vêm de apidog <command> --help na Apidog CLI 2.2.12:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file ./qwen-chat.json
apidog endpoint create --project <projectId> --file ./qwen-chat.json
apidog environment create qwencloud-sg --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -d ./prompts.csv --env-var "DASHSCOPE_API_KEY=$DASHSCOPE_API_KEY" -r cli,json
A flag -d executa uma iteração por linha do seu arquivo de prompts, e --env-var passa a chave em tempo de execução, para que ela nunca fique armazenada no projeto. O agente lê cada bloco usage do relatório JSON em apidog-reports. Multiplique os tokens de prompt por US$ 1,50 e os tokens de conclusão por US$ 4,50 por milhão, e você terá seu próprio custo por tarefa para comparar com os US$ 1,67 da Alibaba.
Troque o ambiente para rodar a mesma suíte contra o seu modelo atual, e repita duas ou três vezes para ver a variância que o gráfico de lançamento não mostra. A mesma linha apidog run vai para o CI com -r junit; veja o guia de CI/CD. Para uma configuração passo a passo com agente, veja Apidog CLI no Claude Code. O plano gratuito da Apidog cobre até 4 usuários.
Perguntas frequentes
Os benchmarks do Qwen4-Max são independentes? Em grande parte, não. Dez das 16 pontuações no gráfico da Alibaba são execuções próprias. Seis são citadas de leaderboards de terceiros: APEX-Agents (Mercor), AA-Briefcase e AutomationBench-AA (Artificial Analysis), CodeArena e AgentArena (LM Arena), HLAB-Vals (Vals) e Agents’ Last Exam.
O que é o Work360? O benchmark da própria Alibaba para tarefas industriais complexas em 26 domínios. O Qwen4-Max pontuou 52,69 contra 47,74 do Qwen3.8-Max; apenas esses dois modelos aparecem na comparação publicada.
Como o Qwen4-Max se sai no Terminal-Bench 4.0? A Alibaba relata 48,5, acima dos 38,9, com cerca de metade dos tokens. Os outros modelos de fronteira no gráfico pontuam entre 56,1 e 67,2.
O Qwen4-Max é mais barato de executar que o Qwen3.8-Max? Na avaliação Work360 da Alibaba, o custo médio por tarefa caiu de US$ 4,43 para US$ 1,67. Os preços de tabela são US$ 1,50 de entrada e US$ 4,50 de saída por 1 milhão de tokens. Veja o guia do Token Plan para opções de assinatura e Qwen4-Max de graça para caminhos sem custo.
O que é o Live Delivery no lançamento do Qwen4-Max? Um fluxo de trabalho de agente que entrega uma primeira versão utilizável cedo e a melhora enquanto você conduz o processo. Não é um benchmark. Nosso guia do plugin Qwen Live Delivery cobre o assunto.