
A Alibaba lançou o Qwen 3.8-Max no início de agosto de 2026, e se você já está usando o qwen3.7-max em produção, tem uma decisão importante a tomar. O novo modelo apresenta grandes ganhos em benchmarks de agência e pesquisa, adiciona entrada de imagem, é lançado a um preço de tabela mais baixo e vem com uma promessa que a Alibaba nunca fez para seu predecessor: pesos abertos.
Mas a decisão não é tão simples quanto "o novo modelo vence". O Qwen 3.7-Max está atualmente com um desconto limitado de 50% que o torna mais barato que o 3.8-Max em termos absolutos. Algumas diferenças de benchmark são dramáticas. Outras são praticamente nulas. Este artigo detalha todas as mudanças importantes, para que você possa decidir se deve mudar agora, esperar ou descer um nível.
Se você quer ter a visão completa do novo modelo primeiro, comece com nosso explicativo do Qwen 3.8-Max. Para saber mais sobre o carro-chefe anterior, veja o que o Qwen 3.7 trouxe de novo.
Uma observação sobre a metodologia antes dos números. Cada valor de benchmark abaixo vem da própria tabela da Alibaba na postagem oficial de lançamento do Qwen 3.8. Isso é realmente útil aqui: ambos os modelos foram avaliados na mesma execução do fornecedor, então as diferenças são internamente consistentes, mesmo que a verificação independente ainda esteja pendente. A maioria das linhas de codificação foi executada no harness Claude Code, e vários benchmarks são internos da Qwen.
A versão resumida
| O que mudou | Qwen 3.7-Max | Qwen 3.8-Max |
|---|---|---|
| Terminal Bench 2.1 | 74.5 | 86.6 |
| SWE-bench Pro | 60.6 | 67.7 |
| PaperBench | 64.8 | 93.0 |
| IFBench | 79.1 | 82.8 |
| GPQA Diamond | 92.4 | 92.6 |
| HLE | 41.4 | 43.6 |
| Preço de tabela (por 1M tokens) | $2.5 entrada / $7.5 saída | $2 entrada / $6 saída |
| Preço atual (promoção) | $1.25 entrada / $3.75 saída | $2 entrada / $6 saída |
| Entrada de imagem | Não | Sim |
| Arquitetura divulgada | Não divulgada | 2.4T total, 95B MoE ativo |
| Pesos abertos | Nunca lançado | Prometido "próxima semana" (~10 de agosto) |
| Janela de contexto | 1M tokens | 1M tokens |
Agora os detalhes.
Diferenças de benchmark: onde o salto é real
As melhorias principais se concentram em trabalhos de agência: tarefas de longo prazo onde o modelo planeja, executa e se autocorrige.
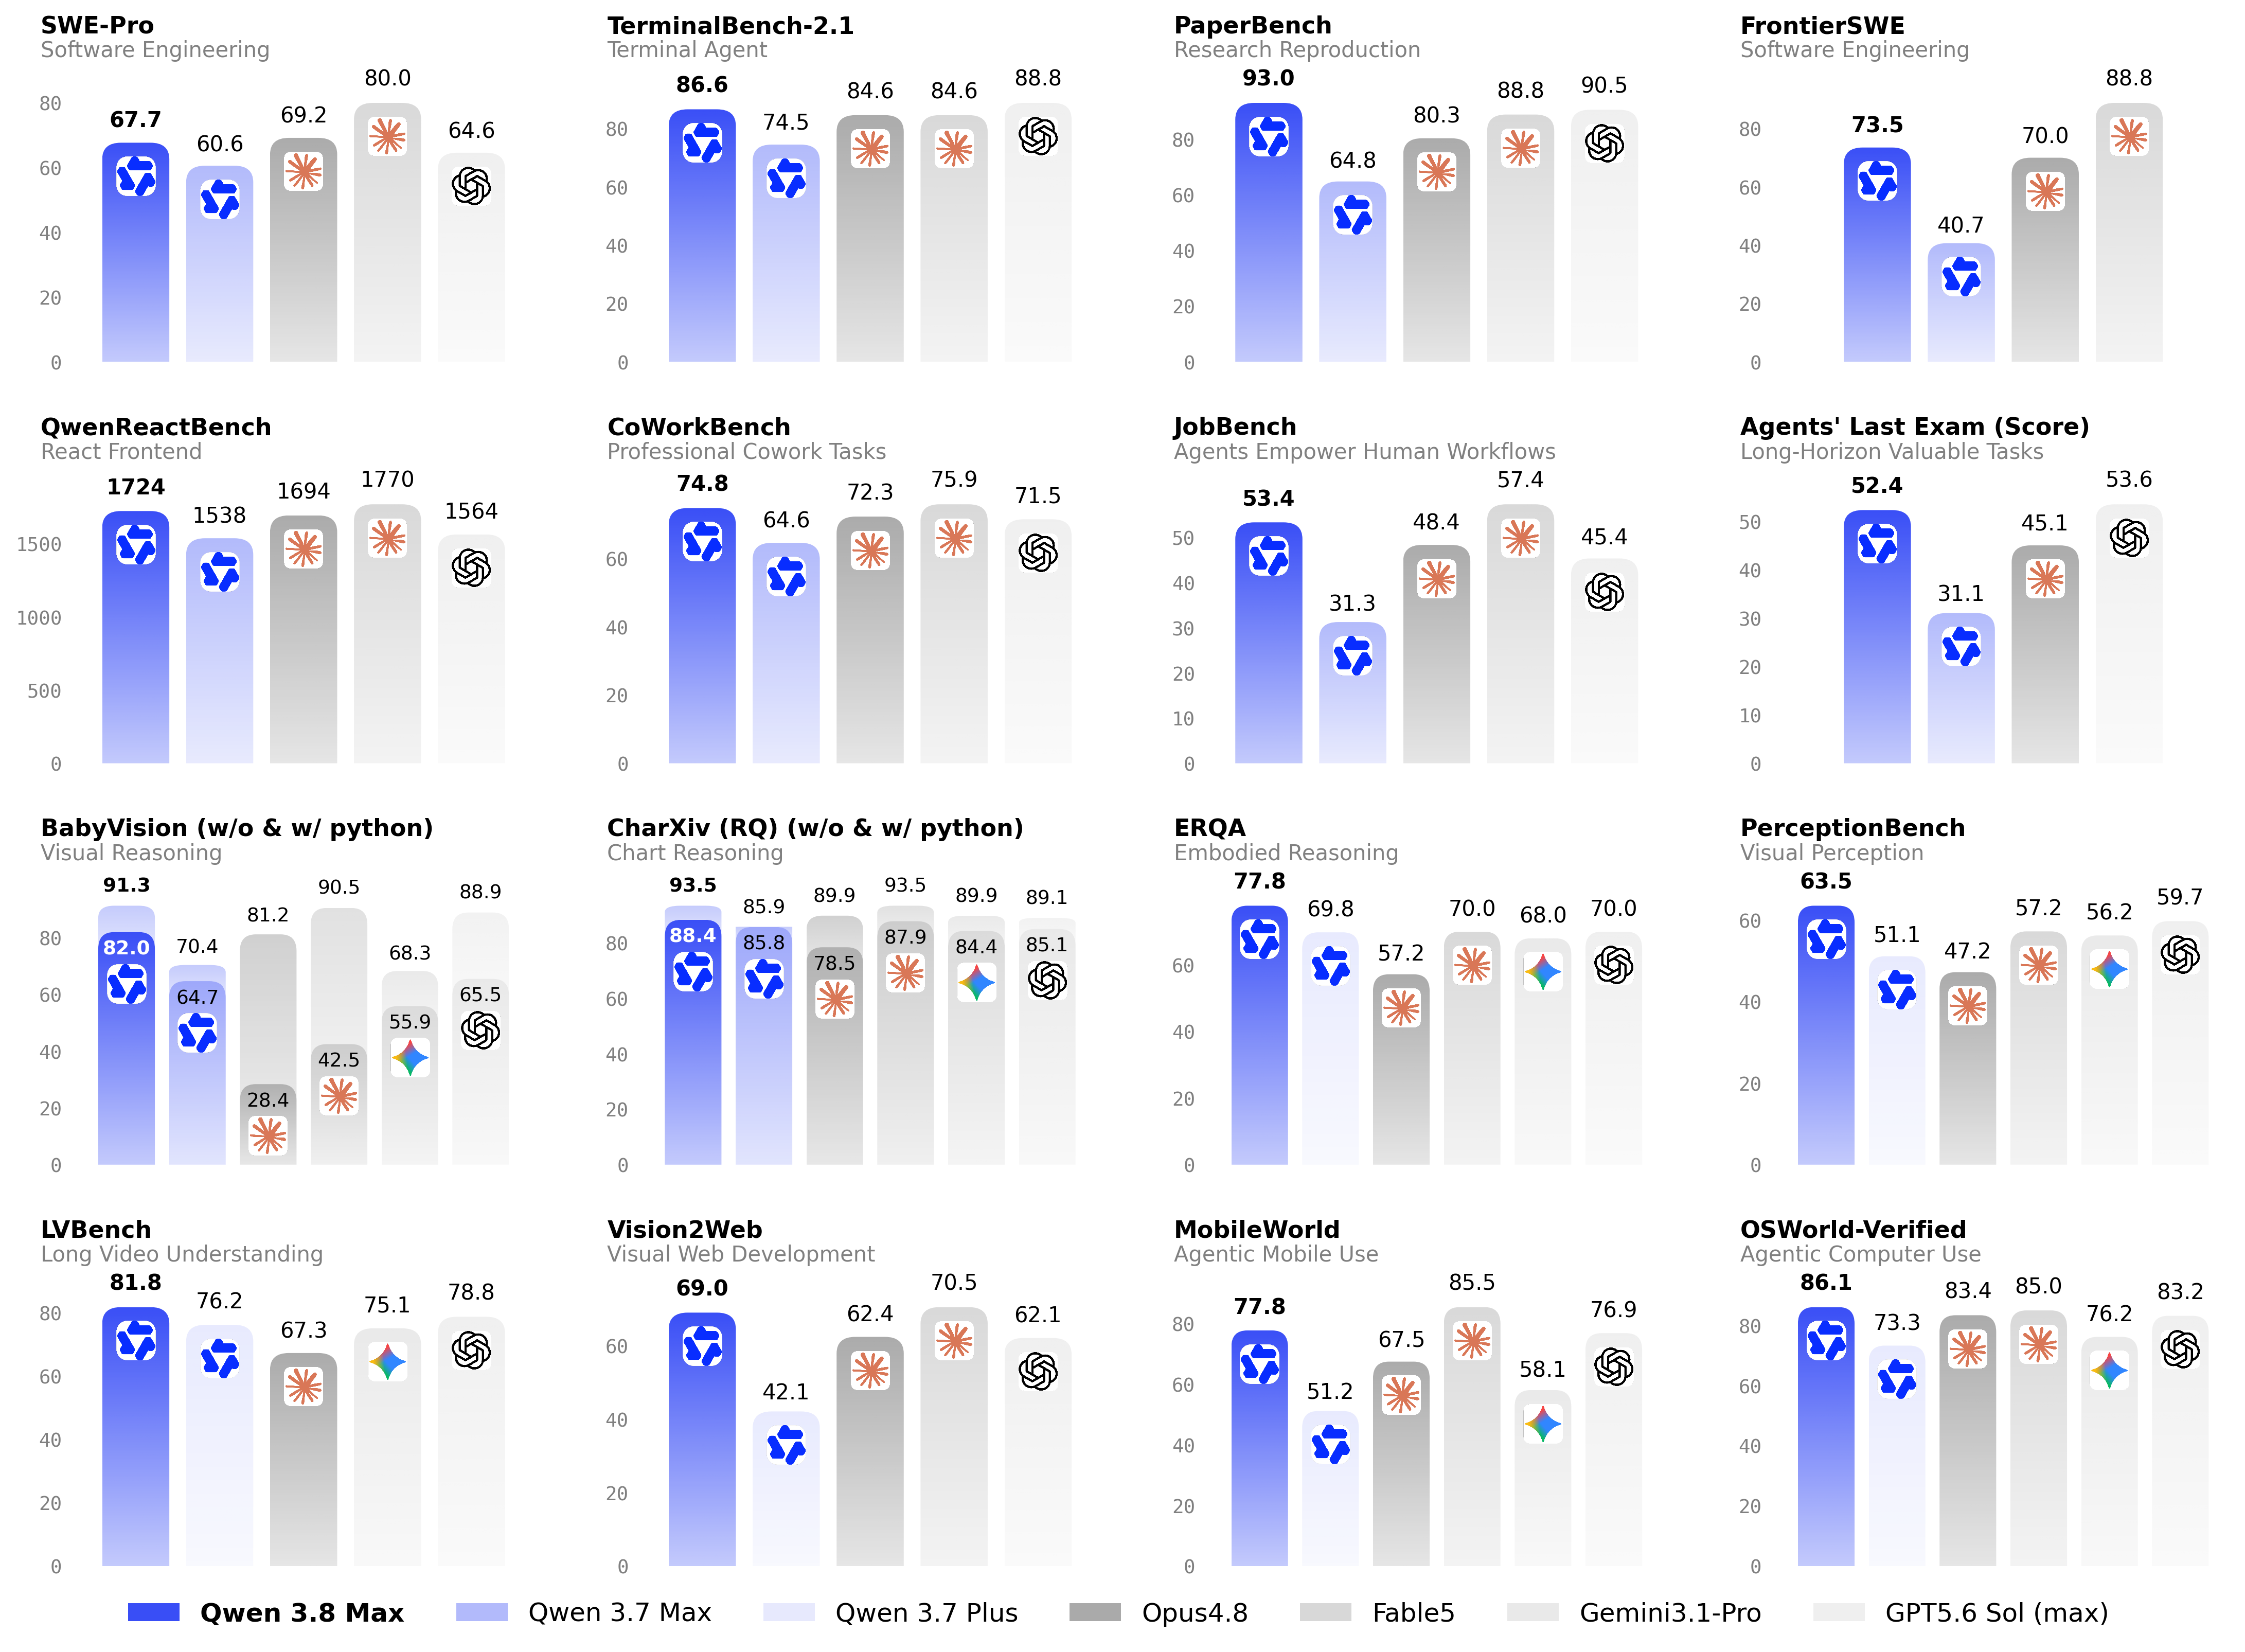
Terminal Bench 2.1: 74.5 para 86.6. Este é um salto de 12 pontos em tarefas de agência baseadas em terminal, e move o Qwen de claramente atrasado para genuinamente competitivo. Na mesma tabela, a Alibaba pontua Claude Opus 4.8 e Fable 5 em 84.6 cada, o que coloca o 3.8-Max à frente de ambos nesta linha. O GPT-5.6 Sol ainda lidera com 88.8.
SWE-bench Pro: 60.6 para 67.7. Um ganho de 7 pontos em tarefas de engenharia de software do mundo real. Significativo, mas sejamos honestos: o Fable 5 está em 80.0 na mesma tabela, então isso é um avanço, não uma ultrapassagem. Se o desempenho do SWE-bench Pro é seu principal critério de compra, a fronteira ainda está em outro lugar.
PaperBench: 64.8 para 93.0. A maior diferença única na tabela, um salto de 28 pontos na reprodução de artigos de pesquisa de IA. É também a melhor linha principal do 3.8-Max, à frente de todos os rivais na comparação da Alibaba. Se sua carga de trabalho envolve reprodução de pesquisa, documentos técnicos longos ou raciocínio científico multi-etapas, este é o número que deve chamar sua atenção.
IFBench: 79.1 para 82.8. A capacidade de seguir instruções melhora em quase 4 pontos. Notavelmente, o 3.7-Max já era forte aqui (79.1 superou o Opus 4.8 e o Fable 5 na mesma execução), então isso estende uma liderança existente em vez de corrigir uma fraqueza.
GPQA Diamond: 92.4 para 92.6. Praticamente estável. A QA científica de nível de pós-graduação já estava perto da saturação para o 3.7-Max, e o novo modelo não a move. Se sua carga de trabalho se assemelha ao GPQA, a atualização não lhe trará nada em termos de qualidade.
HLE: 41.4 para 43.6. O Humanity's Last Exam melhora 2 pontos, mas ainda está atrás da fronteira: o Fable 5 registra 53.3 e o GPT-5.6 Sol registra 47.2 na mesma tabela. O Qwen 3.8-Max fecha lacunas em muitos lugares. Este não é um deles.
O padrão: ganhos massivos em benchmarks de agência e pesquisa, ganhos incrementais em seguir instruções, nenhum movimento em benchmarks de conhecimento saturados e uma lacuna persistente nas avaliações de raciocínio mais difíceis. Para uma análise mais aprofundada da tabela completa, incluindo as letras miúdas sobre harnesses e benchmarks internos, consulte nossa análise dos benchmarks do Qwen 3.8.
Arquitetura: Alibaba finalmente mostra seus números
O Qwen 3.8-Max é um modelo de mistura de especialistas com 2.4 trilhões de parâmetros, com 95B de parâmetros ativos por passagem de inferência, construído sobre a fundação arquitetônica do Qwen 3.5. Isso representa aproximadamente uma taxa de ativação de 4%, o que é importante para os custos de serviço: você paga o processamento por 95B, não por 2.4T.
O contraste com o 3.7-Max é a própria divulgação. A Alibaba nunca publicou números de escala comparáveis para o Qwen 3.7-Max. Contagem de parâmetros, taxas de ativação, configuração de especialistas: tudo não divulgado. Com o 3.8-Max, a documentação do modelo Model Studio e a postagem de lançamento detalham a arquitetura, o que torna o planejamento de capacidade e a modelagem de custos muito menos um jogo de adivinhação.
Para contexto na corrida de pesos abertos: o Kimi K3 opera com 2.8T no total e 104B ativos. O Qwen 3.8-Max é menor em ambos os eixos.
Multimodal: a capacidade que o 3.7-Max nunca teve
O Qwen 3.7-Max é um modelo de texto. O Qwen 3.8-Max aceita entrada de imagem nativamente, e a Alibaba publicou uma tabela separada de benchmarks multimodais onde ele lidera a maioria das linhas contra o Gemini 3.1 Pro e o GPT-5.6 Sol.
Os resultados de destaque da tabela multimodal da Alibaba: MathVision em 95.2, LogicVista em 91.9 e OSWorld-Verified em 86.1 para tarefas de uso de computador. Não há coluna para o 3.7-Max nesta tabela para comparar, porque não poderia haver: o modelo mais antigo não aceita imagens.
Na prática, isso significa que cargas de trabalho que você anteriormente tinha que direcionar para um modelo de visão separado (entendimento de capturas de tela, imagens de documentos, automação de UI, extração de gráficos) agora podem ser executadas no mesmo ID de modelo que seu tráfego de texto. A postagem de lançamento também demonstra o entendimento de documentos longos e vídeos, embora essas sejam capacidades demonstradas em blogs, em vez de tipos de entrada de API distintos, então verifique os documentos da API para o seu caso específico.
Preços: o novo modelo é mais barato, exceto agora
É aqui que a matemática da atualização fica interessante.
O Qwen 3.8-Max é lançado a $2 entrada / $6 saída por 1M de tokens, um único nível fixo em todo o contexto de 1M. O Qwen 3.7-Max custa $2.5 / $7.5. Assim, o novo modelo, mais capaz, tem um preço de tabela 20% menor que o de seu predecessor. Isso quase nunca acontece em uma mudança de geração de carro-chefe.
Mas há um detalhe: a Alibaba está atualmente realizando uma promoção por tempo limitado de 50% no 3.7-Max, o que eleva sua taxa efetiva para $1.25 / $3.75. Aos preços de hoje, o modelo mais antigo custa 38% menos que o novo. Todas as taxas estão na página oficial de preços do Model Studio.
Duas coisas a ter em mente:
- A promoção pode acabar. A Alibaba a rotula como por tempo limitado e não publicou uma data de término. Se você arquitetar com base em $1.25 / $3.75, sua suposição de orçamento tem uma validade que você não pode ver. A preços de tabela, o 3.8-Max é o modelo mais barato.
- "Tokens de pensamento" inflacionam as contas reais. O Qwen 3.8-Max assume
reasoning_effort: xhighpor padrão, e os "tokens de pensamento" são cobrados como saída. Seu custo efetivo por requisição pode ser bem acima do que o preço indicado sugere. Nosso guia de preços do Qwen 3.8 detalha a economia de cache e o cálculo de custo por tarefa.
E se nenhum modelo Max se encaixa no seu orçamento, o qwen3.7-plus a $0.4 / $1.6 (atualmente com 20% de desconto) permanece como a opção de valor. A comparação Plus vs Max aborda quando o Plus é suficiente.
Pesos abertos: uma novidade para a classe Max
Nenhum modelo da classe Qwen-Max jamais foi lançado com pesos abertos. O Qwen 3.7-Max não foi, e a Alibaba nunca sugeriu que seria. O Qwen 3.8-Max quebra esse padrão: a postagem de lançamento promete pesos no Hugging Face e no ModelScope "na próxima semana", o que aponta para aproximadamente 10 de agosto.
Até a data desta escrita (3 de agosto de 2026), os pesos não estão disponíveis para download. Trate a promessa como uma promessa. O precedente é encorajador: os pesos do Kimi K3 chegaram 11 dias após o lançamento, e a Alibaba tem um longo histórico de pesos abertos com modelos Qwen menores. Mas um download de 2.4T de parâmetros é um projeto de auto-hospedagem multi-nó, mesmo quantizado, então para a maioria das equipes o impacto prático será o acesso hospedado por terceiros e a pressão sobre os preços, não um modelo rodando em seu próprio rack.
Se os pesos abertos são importantes para sua história de aquisição ou conformidade, isso por si só pode resolver a questão 3.7 vs 3.8. Um modelo (provavelmente) os terá. O outro nunca terá.
O que não mudou
Vale a pena declarar claramente, porque as postagens de atualização tendem a exagerar:
- Janela de contexto: 1M tokens em ambos. Sem expansão. Se você escolheu o 3.7-Max para contexto longo, o 3.8-Max mantém a linha no mesmo 1M com um preço fixo em toda a janela.
- Caminho de acesso: o mesmo. Ambos os modelos são servidos através do Alibaba Cloud Model Studio com endpoints compatíveis com OpenAI. A mudança é uma alteração do ID do modelo (de
qwen3.7-maxparaqwen3.8-max), não um projeto de migração. O 3.8-Max adiciona adicionalmente uma superfície de API compatível com Anthropic, que vale a pena experimentar em um cliente como o Apidog se sua ferramenta fala esse protocolo. - Controles de raciocínio: agora oficiais.
reasoning_efforté um parâmetro documentado e suportado no 3.8-Max com três níveis (xhigh por padrão, medium, low), juntamente comenable_thinkingepreserve_thinking. Se você ajustou prompts em torno do comportamento de raciocínio implícito no 3.7-Max, agora você tem um controle explícito em seu lugar.
Você deve fazer o upgrade? Três caminhos honestos
Faça o upgrade agora se sua carga de trabalho for de agência ou de pesquisa intensiva. As diferenças do Terminal Bench (74.5 para 86.6) e PaperBench (64.8 para 93.0) são o tipo de salto que você pode sentir em produção, e você ganha entrada de imagem mais o preço de tabela mais baixo como bônus. Se você está construindo agentes que operam terminais, reproduzem trabalho técnico ou processam capturas de tela, o caso é claro.
Aproveite a promoção do 3.7-Max se sua carga de trabalho estiver nas zonas de estabilidade. As tarefas de conhecimento no estilo GPQA moveram 0.2 pontos. Se seu tráfego é de Q&A, sumarização ou bate-papo geral, e o 3.7-Max já atende ao seu padrão de qualidade, $1.25 / $3.75 é a melhor oferta por token que qualquer modelo Max já ofereceu. Defina um lembrete no calendário para verificar o status da promoção mensalmente e saiba que seu preço de contingência é o 3.8-Max a $2 / $6, e não o 3.7-Max ao preço de tabela.
Mude para o qwen3.7-plus se você é guiado pelo preço e suas tarefas são rotineiras. A $0.4 / $1.6, é 5x mais barato que o 3.8-Max na entrada, e para classificação, extração e geração de modelos, a capacidade da classe Max é frequentemente um gasto desnecessário.
Teste a mudança antes de se comprometer
Os benchmarks do fornecedor, mesmo os internamente consistentes, não preveem como um modelo se comportará com seus prompts. A maneira barata de resolver isso é uma comparação lado a lado em sua carga de trabalho real.
No Apidog, você pode configurar isso em poucos minutos: aponte uma coleção para o endpoint compatível com OpenAI do Model Studio, e então crie dois ambientes que diferem apenas na variável de ID do modelo, um configurado para qwen3.7-max e outro para qwen3.8-max. Execute o mesmo conjunto de requisições contra ambos, alterne os ambientes com um clique e compare as saídas, latência e uso de tokens no visualizador de respostas. Como ambos os modelos compartilham a mesma superfície de API, uma única coleção abrange ambos, e você pode salvar prompts de produção representativos como cenários de teste e executá-los novamente sempre que a Alibaba lançar uma atualização ou os preços promocionais mudarem.
Isso transforma "devemos fazer o upgrade?" de um debate de benchmarks em uma tarde de evidências. Baixe o Apidog gratuitamente e execute a comparação com seu próprio tráfego antes de alterar uma configuração de produção.
FAQ
O Qwen 3.8-Max é mais barato que o Qwen 3.7-Max?
Pelo preço de tabela, sim: $2 / $6 versus $2.5 / $7.5 por 1M de tokens. Pelos preços atuais, não: a promoção por tempo limitado de 50% do 3.7-Max o leva a $1.25 / $3.75, o que o torna 38% mais barato que o 3.8-Max. A promoção não tem data de término publicada. Detalhes completos dos custos estão em nosso guia de preços do Qwen 3.8.
Preciso mudar meu código para alternar de qwen3.7-max para qwen3.8-max?
Para uso básico, não. Ambos os modelos são servidos através dos mesmos endpoints compatíveis com OpenAI do Model Studio, então a troca é uma simples alteração do ID do modelo. Você pode querer definir reasoning_effort explicitamente, já que o 3.8-Max assume xhigh por padrão e os "tokens de pensamento" são cobrados como saída. Se você envia imagens, essa é uma capacidade exclusiva do 3.8-Max e requer o formato padrão de mensagem de entrada de imagem.
O Qwen 3.7-Max tem pesos abertos?
Não, e nunca terá, com base no histórico da Alibaba com esta linha. O Qwen 3.8-Max é o primeiro modelo da classe Max com pesos abertos prometidos, esperados no Hugging Face e ModelScope por volta de 10 de agosto de 2026. Em 3 de agosto, eles ainda não estão disponíveis para download.
O Qwen 3.8-Max é melhor que o Claude ou GPT agora?
Depende da linha, e lembre-se que estes são os próprios números da Alibaba. Em sua tabela, o 3.8-Max supera o Opus 4.8 e o Fable 5 no Terminal Bench 2.1 e lidera todos no PaperBench e IFBench. Ele fica bem atrás do Fable 5 no SWE-bench Pro (67.7 contra 80.0) e de todos na fronteira no HLE. Nenhuns números de benchmark independentes existem ainda, então reserve o julgamento final até que as avaliações de terceiros sejam publicadas.