
Em 20 de agosto de 2026, um modelo chamado ox-alpha apareceu em plataformas de inferência de terceiros. Sem fornecedor, sem anúncio, sem ficha de modelo. Tinha uma janela de contexto de 1 milhão de tokens e o seu uso era gratuito.
Em poucos dias, tornou-se um dos modelos mais usados nessas plataformas. Em cerca de 48 horas, a comunidade o identificou como um modelo Zhipu. Em 26 de agosto, a Z.ai confirmou: Ox Alpha era o GLM-5.3-Flash, e a semana gratuita tinha sido um teste deliberado.
Este é agora um passo padrão de lançamento de produto, em vez de uma curiosidade. Veja como o padrão funciona, como as pessoas o identificaram e o que significa se você é quem consome esses modelos.
A linha do tempo
20 de agosto. O ox-alpha aparece no OpenRouter e OpenCode como um modelo anônimo. Contexto de 1M, preço zero. Modelos anônimos não são incomuns nessas plataformas, mas a combinação de uma janela de contexto muito grande e acesso gratuito é um forte sinal de que alguém está subsidiando algo.
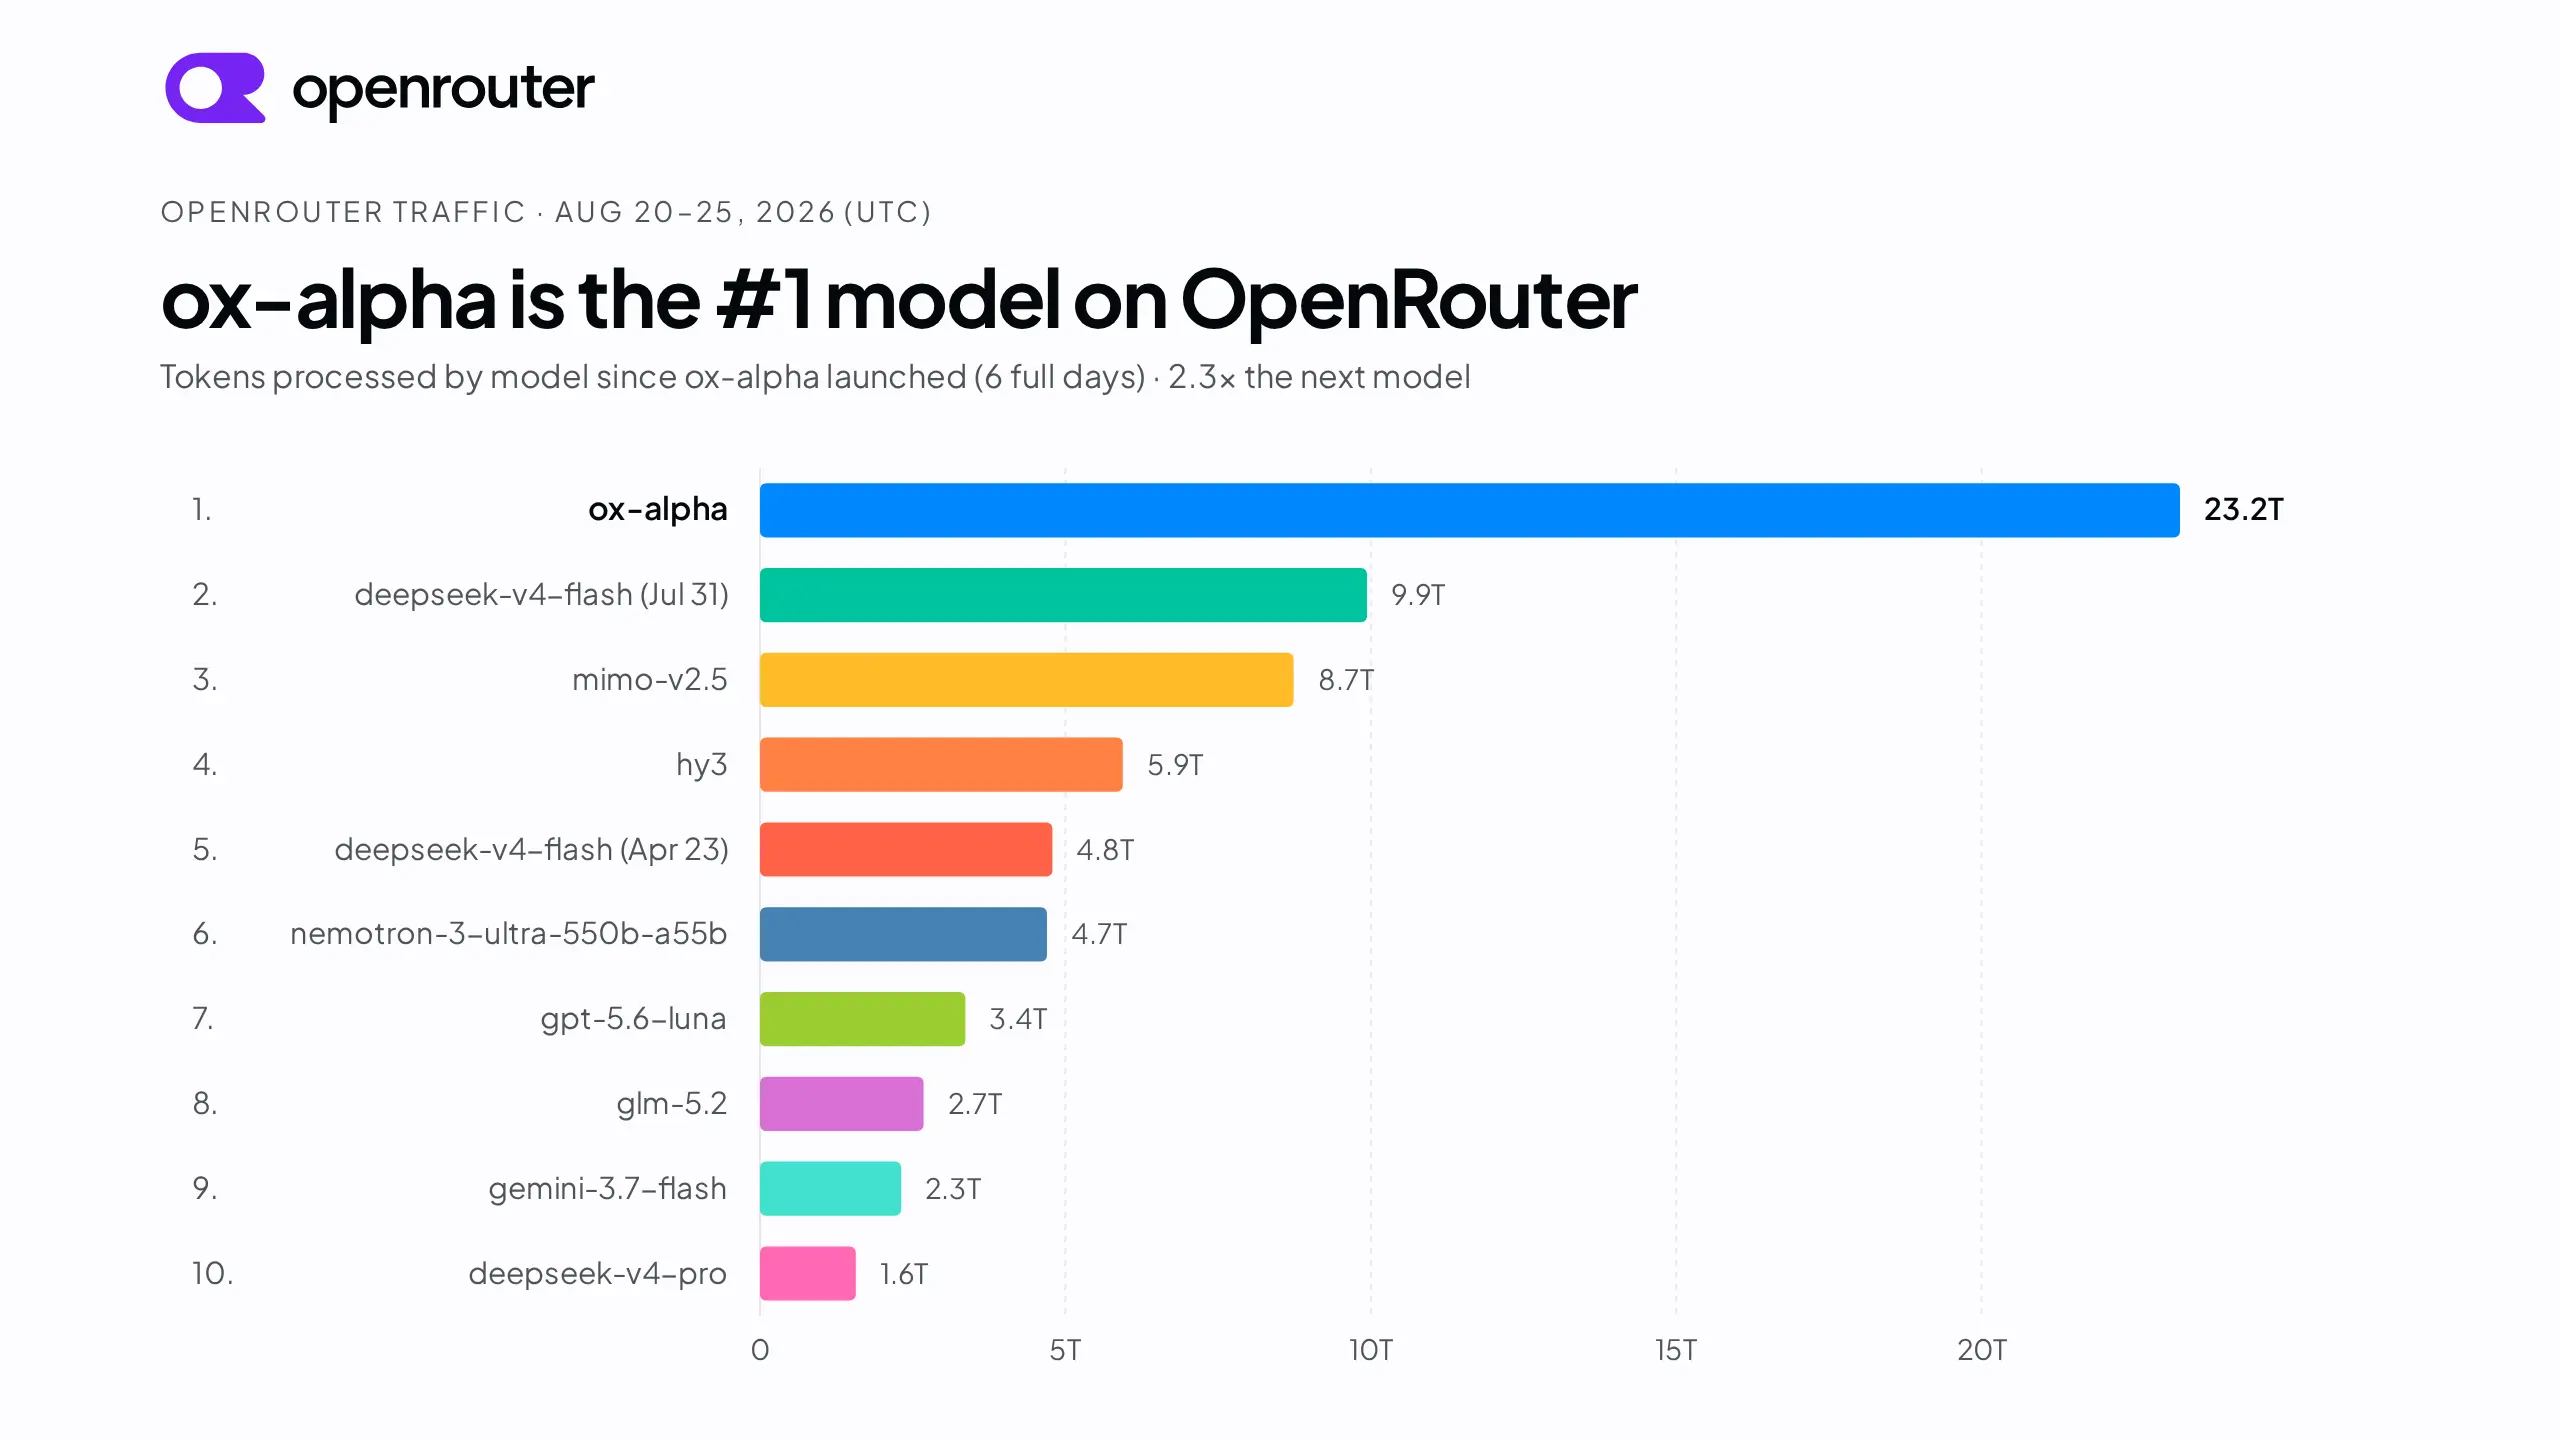
20 a 22 de agosto. O uso aumenta rapidamente. O acesso gratuito a um modelo capaz de longo contexto é fácil de vender, e a comunidade de desenvolvedores direciona trabalho real através dele. Enquanto isso, as pessoas começam a investigá-lo para descobrir de quem é.
Cerca de 48 horas depois. O consenso aponta para a Zhipu, com base nas características de saída, em vez de qualquer divulgação.
26 de agosto. A Z.ai anuncia o GLM-5.3-Flash e confirma que o Ox Alpha era ele. A empresa descreve a semana gratuita como um teste intencional.
Como você identifica um modelo anônimo
Nada disso requer acesso especial. É a correspondência de padrões de comportamento que as famílias de modelos carregam consigo.
Comportamento do Tokenizador. Diferentes famílias dividem o texto de maneiras distintas. Alimente um modelo com strings incomuns, sequências de emojis, scripts mistos, longas sequências de espaços em branco, código com indentação incomum e observe onde ele falha ou como as contagens de tokens se estabelecem. Os tokenizadores são herdados nas versões de uma família e são difíceis de disfarçar.
Autorrelatos sob pressão. Os modelos são treinados com dados que incluem descrições de si mesmos. Perguntas diretas obtêm respostas evasivas ou erradas, mas a solicitação oblíqua frequentemente revela vestígios dos dados de treinamento: frases características, um corte de conhecimento, um estilo próprio para recusas.
Estilo de recusa e formatação. Como um modelo recusa, como ele estrutura uma lista, se ele começa com um preâmbulo, se ele usa convenções de seção específicas. Estas são características pós-treinamento e tendem a ser consistentes dentro de um laboratório.
Comportamento multilíngue. Um modelo treinado intensamente em dados chineses e ingleses se comporta de forma diferente em prompts chineses do que um que tratou o chinês como uma língua de "cauda longa". Para um modelo Zhipu, isso é um forte indício.
Formato do Benchmark. Execute uma bateria rápida de avaliação e compare o perfil de pontos fortes e fracos com modelos conhecidos. As pontuações absolutas importam menos do que o formato: quais categorias são fortes em relação a outras.
Características de serviço. Padrões de latência, taxa de transferência, limites de contexto e quais parâmetros o endpoint aceita, tudo isso vaza informações sobre a pilha por trás dele.
Observamos o mesmo processo ocorrer quando o Pony Alpha se revelou um modelo DeepSeek ou GLM. A metodologia se generaliza.
Por que os fornecedores fazem isso
Um lançamento sigiloso consegue coisas que um beta fechado não pode.
Tráfego real em escala real. Avaliações internas e testadores amigáveis produzem uma fatia estreita do que as pessoas realmente fazem. Uma semana de tráfego público aberto revela a cauda longa: os prompts estranhos, os abusivos, os contextos enormes, os loops de chamada de ferramentas para os quais ninguém projetou.
Teste de carga honesto. Você aprende o que sua pilha de serviço faz sob concorrência genuína. A Z.ai afirma ter executado a semana do Ox Alpha inteiramente em aceleradores chineses domésticos usando uma pilha baseada em SGLang, e alega um custo de serviço por token comparável ao hardware NVIDIA mainstream. Essa é uma afirmação do fornecedor sobre sua própria infraestrutura sem verificação independente, mas é uma afirmação que você só pode fazer de forma crível depois de servir tráfego real.
Recepção sem marca. A reação das pessoas a "um bom modelo anônimo" é diferente da sua reação a um modelo com um logotipo anexado. O anonimato elimina os pré-conceitos de marca em ambas as direções.
Marketing gratuito na revelação. No dia do anúncio, uma população de desenvolvedores já havia usado o modelo e formado opiniões positivas. Isso é mais persuasivo do que qualquer tabela de benchmark.
O custo é o risco de boa vontade. Usuários que construíram algo durante uma semana gratuita descobrem que sua dependência agora tem um preço. Neste caso, a revelação veio com um desconto de lançamento de 50% válido até 9 de setembro de 2026, o que suaviza o impacto.
O que realmente estava por trás da cortina
GLM-5.3-Flash é um modelo de mistura de especialistas com 320 bilhões de parâmetros, com 18 bilhões ativos por token, lançado sob a licença MIT com pesos no Hugging Face. Ele usa atenção híbrida linear e esparsa, suporta 1.048.576 tokens de contexto e é o primeiro modelo nativamente multimodal da série GLM-5.
Medições independentes da Artificial Analysis o colocam em 57 no Índice de Inteligência, contra 60 para o GLM-5.3 maior e uma mediana de 27 para modelos de código aberto de tamanho similar.
A imagem completa está em nosso explicador do GLM-5.3-Flash.
Um detalhe explica a semana gratuita melhor do que qualquer teoria de marketing: a Z.ai relata que o modelo usa aproximadamente três vezes menos computação de atenção do que o GLM-5.3 e um cache KV cerca de 4,4 vezes menor. Distribuir um modelo tão barato de servir é uma aposta muito menor do que distribuir um carro-chefe de ponta. A economia da jogada foi incorporada à arquitetura.
O que isso significa para você
Modelos anônimos em roteadores são geralmente o carro-chefe não lançado de alguém. Um modelo sem marca, com uma janela de contexto incomumente grande e sem preço, não é um projeto de hobby. Alguém está pagando por essa inferência.
O acesso gratuito é temporário por design. Se você construir algo durante uma janela gratuita, espere que o preço chegue. O Ox Alpha passou de gratuito para $0.15 por milhão de tokens de entrada em seis dias, o que é barato, mas não é zero.
Não coloque modelos furtivos em produção. Sem ficha de modelo, sem garantia de versionamento, sem aviso de descontinuação, sem suporte. O modelo pode mudar sob você ou desaparecer. Avaliar um é aceitável. Depender de um não é.
Sua avaliação vale mais do que a revelação. No momento em que o anúncio for feito, você já pode ter uma semana de dados reais sobre como o modelo lida com sua carga de trabalho. Isso supera qualquer tabela de benchmark publicada pelo fornecedor.
Esse último ponto só é válido se você realmente capturou os dados. Prompts ad hoc durante uma semana gratuita produzem impressões; um conjunto salvo produz evidências. Manter seus prompts de avaliação como uma coleção no Apidog, com o ID do modelo e a URL base como variáveis de ambiente, significa que, da próxima vez que um modelo anônimo interessante aparecer, você poderá apontar o mesmo conjunto para ele e obter uma comparação em vez de uma sensação. Quando ele for revelado e precificado, você já saberá se vale a pena pagar por ele.
O que a semana gratuita realmente revelou
Remova o marketing e o episódio do Ox Alpha produziu três sinais genuinamente úteis.
O modelo é barato de servir, e isso é arquitetônico. Aproximadamente três vezes menos computação de atenção e um cache KV cerca de 4,4 vezes menor do que o GLM-5.3 não é uma decisão de precificação, é uma decisão de design. Isso torna o baixo preço de tabela mais propenso a persistir do que uma taxa promocional. Nossa análise de preços detalha o que isso significa na prática.
Pesos abertos seguiram o lançamento hospedado. O modelo foi disponibilizado no Hugging Face sob a licença MIT, então a semana de acesso gratuito hospedado não foi a única maneira de usá-lo gratuitamente. Qualquer pessoa com o hardware pode executá-lo indefinidamente. Executá-lo localmente aborda o que isso exige.
A multimodalidade foi a parte que ninguém sabia que deveria testar. Durante a semana anônima, a maioria das pessoas usou o Ox Alpha como um modelo de texto, porque não havia ficha de modelo informando que ele aceitava imagens. Uma capacidade que se revelou ser o recurso principal foi amplamente não exercitada pela própria população que supostamente o estava testando sob estresse. Essa é a fraqueza estrutural de um lançamento sem marca: você obtém volume, mas obtém volume direcionado ao que as pessoas presumem que o modelo faz. Nosso guia de visão aborda o caminho que ficou sem testar.
O padrão mais amplo
Ox Alpha não foi o primeiro e não será o último. A implantação sigilosa em roteadores de terceiros tornou-se uma etapa normal de pré-lançamento, situando-se entre a avaliação interna e o lançamento público.
Para os consumidores desses modelos, a postura prática é direta. Teste-os, aprenda com eles, mantenha registros do que encontrar e não construa nada de crítico em um modelo que não tem nome. A semana gratuita é uma oportunidade de pesquisa, não uma cadeia de suprimentos.
FAQ
O que foi o ox-alpha? GLM-5.3-Flash, o modelo de pesos abertos 320B-A18B nativamente multimodal da Z.ai, implantado anonimamente a partir de 20 de agosto de 2026 e revelado em 26 de agosto.
Ainda é gratuito? Não. O período gratuito terminou no anúncio. Um desconto de lançamento de 50% é válido até 9 de setembro de 2026, após o qual se aplica o preço de tabela de $0.15 por milhão de tokens de entrada e $0.50 por milhão de tokens de saída.
Como as pessoas descobriram que era da Zhipu? Comportamento do tokenizador, estilo de saída, tratamento multilíngue, padrões de recusa e formato do benchmark, comparados com lançamentos GLM conhecidos. Nenhuma informação interna foi necessária.
Por que distribuir um modelo gratuitamente? Tráfego real em escala, teste de carga honesto, feedback sem marca e uma base instalada de opiniões positivas no dia do lançamento.
Devo usar modelos anônimos no OpenRouter? Para avaliação, sim. Para produção, não. Eles não oferecem garantias de versionamento, suporte ou descontinuação.