
Jev é o Modelo Um de Sistema da TypeSafe AI: você envia o estado do programa mais perguntas digitadas, e ele retorna decisões com probabilidades calibradas em vez de prosa. (Este é Jev, o modelo, não FaZe Jev, o streamer, ou a vacina JEV.) São pesos fechados, apenas API, servidos em POST https://api.typesafe.ai/v1/systemone como jev-latest. Portanto, “rodar Jev localmente” não pode significar Jev. Significa um cluster de projetos comunitários de dias, liderados por OpenJev, que reproduzem a ideia com modelos abertos. Se você é novo no modelo em si, leia o que é Jev primeiro; este artigo cobre as imitações.
É um resumo e um teste de realidade: o que cada README afirma, quão fiel é, qual hardware ele precisa e como testar qualquer um deles através de um endpoint HTTP local no Apidog da mesma forma que você testaria a API TypeSafe. Nenhum é comparado por terceiros, e nenhum é da TypeSafe.
O que “rodar Jev localmente” pode significar
A publicação de lançamento da TypeSafe descreve um modelo treinado com Reinforcement Learning for Calibrated Decisions (RLCD), três primitivas (noul, choice, score), um tempo de resposta de 70ms a 500ms e $0,042 por milhão de tokens de entrada com saída gratuita. Essas são as alegações do fornecedor; a receita de treinamento não é publicada. Um tópico da comunidade diz que Jev foi treinado em 100% de dados sintéticos. Trate isso como um boato não verificado.
Como a receita é secreta, todo “Jev aberto” adota um dos três atalhos:
- Leia os logits de um modelo de chat congelado. Faça uma pergunta de múltipla escolha para um pequeno Qwen, pule a geração e transforme os logits do próximo token por opção em uma probabilidade. OpenJev e mini-jev fazem isso.
- Treine um pequeno pontuador do zero. Um modelo cujo único trabalho é pontuar N opções em relação a um contexto em uma única passagem. Isso é o jevlike.
- Altere o motor de decodificação. Mantenha o modelo base, avalie cada campo em paralelo sobre candidatos restritos. Esse é o motor Apple Silicon no Hugging Face e a pull request do vLLM.
Nenhum deles reproduz o RLCD. Essa é a manchete honesta.
OpenJev: logits de um Qwen congelado em uma 3090
OpenJev pergunta “Podemos rodar algo como Jev em uma 3090 em casa?” e responde com um pacote Python licenciado pelo MIT. O README é cuidadoso: ele “reproduz esse padrão de interface com modelos abertos; ele não reproduz o modelo ou treinamento não revelado de Jev.”
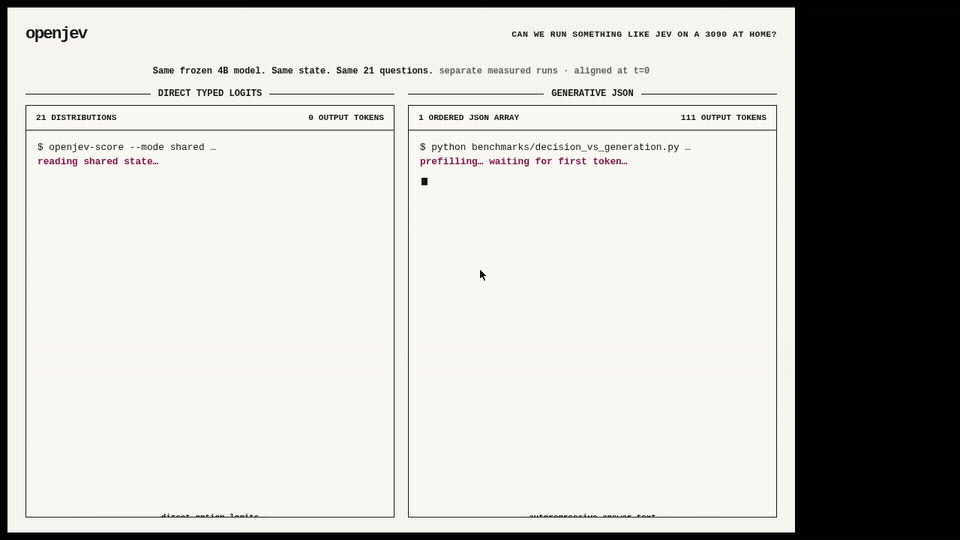
O mecanismo é uma passagem direta que lê os logits da opção declarada, sem nenhum token de resposta amostrado. Critérios e opções chegam a cada requisição, então nada é ajustado por tarefa. O modelo principal é Qwen3.5-4B.
Números que o README reporta em uma RTX 3090 com Qwen3.5-4B:
- Logits tipados diretos: 1,023 s para 21 pares de probabilidade, contra 5,332 s para um array JSON autorregressivo, ou 5,21x mais lento.
- Em um subconjunto TypeSafe de 102 linhas, concordância modal de 0,845, contra 0,883 para Jev publicado.
A entrada é JSONL com id, state, question e um array options de {id, description}; a saída é uma probabilidade por opção. Não há servidor HTTP no repositório: você executa openjev-score --mode direct --model Qwen/Qwen3.5-4B --input examples/decisions.jsonl, ou experimenta a demo WebGPU em openjev.com. Hardware: CUDA e uma GPU que armazene um modelo de 4B em BF16.
O que ele omite: sem primitiva noul ou score, e as probabilidades são um softmax sobre os logits da opção, não uma confiança calibrada por RLCD.
mini-jev: um estudo pré-registrado com um servidor local
mini-jev é mais um experimento do que um produto. Seu slogan: “Como é uma interface no estilo Jev em um Qwen3-4B congelado, lê os logits da letra da opção em vez de gerar JSON.” Ele executa Qwen3-4B-Instruct-2507 na classificação de intenções CLINC150 e compara a geração de JSON restrita por gramática com a leitura do logit de uma letra de opção.
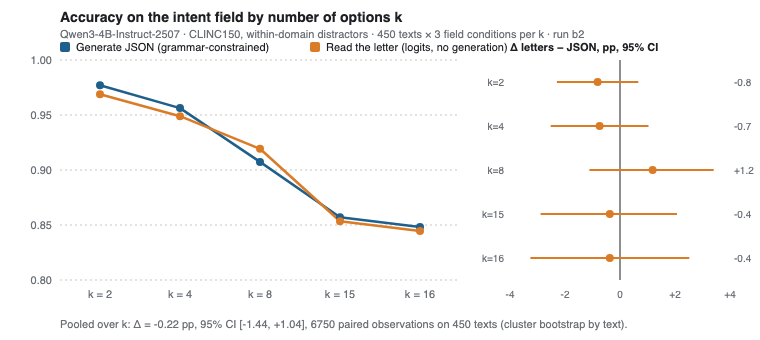
O resultado, de 6.750 observações pareadas: JSON 0,909 de acurácia, letras 0,907, uma diferença de -0,22 pontos dentro de um IC de 95% de [-1,44, +1,04]. A leitura de letras foi cerca de 4x mais rápida em textos de 32 tokens.
O README mapeia seus termos para os da TypeSafe: choice e noul são “o que este estudo mede em um modelo congelado, como a letra lida e o booleano; score (uma escala ordenada) não foi medido.” Ele chama isso de “uma correspondência de termos, não uma reprodução de seu modelo,” e adiciona o aviso que todo projeto aqui deveria copiar: “As ações de letras são um ranking com uma lacuna de confiança, não probabilidades calibradas.”
Ele vem com uma demonstração HTTP. MINIJEV_DEVICE=mps uv run python demo/server.py serve 127.0.0.1:8765 com POST /run, que recebe schema e text e retorna letter, p, gap e answer por campo. Ele precisa de cerca de 8,5 GB de memória em Apple Silicon ou uma GPU NVIDIA. MIT, 11 estrelas no momento da escrita.
jevlike: um pontuador de opções do zero
jevlike está sendo compartilhado como um “modelo tipo Jev com engenharia reversa”. O README diz o contrário: “A TypeSafe não publicou seu design. Este repositório é um modelo inicial independente com a mesma forma de entrada e saída.” Os autores acrescentam que “não mostraram qualidade igual à de Jev nem reproduziram o método de treinamento privado da TypeSafe.”
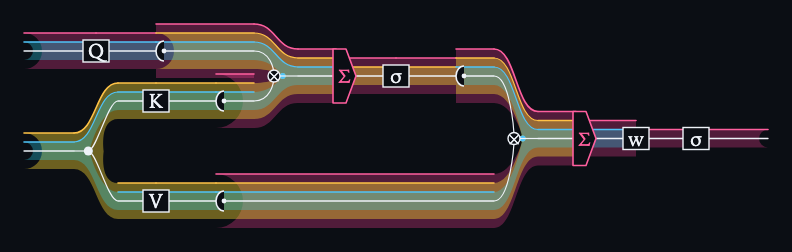
O design é pequeno. Cada opção recebe um vetor de consulta que atende aos tokens de contexto; um produto escalar compartilhado pontua cada par; softmax transforma as pontuações em probabilidades. O codificador padrão são embeddings de bytes aprendidos do zero, com um codificador Hugging Face opcional congelado.
Números reportados: cerca de 98% em menus sintéticos, 26% em Wikispeedia com um codificador Qwen2.5-0.5B congelado contra um controle embaralhado de 8%, e uma passagem “cerca de 100 vezes mais rápida do que um pequeno decodificador forçado a escrever 400 tokens.” Ele roda em CPU, MPS ou CUDA. MIT, 764 estrelas.
A fidelidade é a mais baixa do grupo. Você o treina com seus próprios rótulos, então é um classificador que você construiu, não um modelo de decisão ao qual você pode entregar critérios arbitrários. Sem noul ou score, sem alegação de calibração, sem servidor HTTP.
Decodificação paralela restrita: o motor Apple Silicon
O Space parallel-constrained-decoding do Hugging Face está circulando como uma “alternativa open source Jev do Typesafe.ai”, mas seu README nunca menciona Jev, TypeSafe ou RLCD. Seu título é “Decodificação Paralela Restrita para Apple Silicon”: um motor de inferência MLX para extração estruturada sobre mlx-community/Qwen2.5-1.5B-Instruct-4bit, com qualquer decodificador mlx-lm trocável.
O método: pré-preencher o contexto uma vez em um cache KV, transmiti-lo para cada campo do esquema, avaliar apenas os IDs de tokens candidatos válidos por campo, aplicar softmax sobre esse conjunto e montar o JSON no código. O README relata em um M4 Max: triagem de fraude de 4 campos 420 ms autorregressivo versus 75 ms paralelo (5,6x), e uma triagem de suporte de 28 campos 1.900 ms versus 270 ms (7,0x). Ele afirma 100% de validade do esquema, o que decorre de nunca amostrar texto livre.
Ele serve HTTP na porta 8000 via uvicorn, retornando parsed_json mais field_telemetry com confiança por campo. Requisitos: um Mac M1 ou posterior, macOS 14+. Apache 2.0. Sem números de precisão, apenas latência, e “calibrado” aqui significa um softmax exato sobre os candidatos, não uma calibração treinada.
vLLM PR 57250: um modo tipo Jev para DiffusionGemma
A pull request #57250 do vLLM, aberta em 16 de setembro e ainda em aberto, transforma DiffusionGemma no que o autor chama de “máquina de múltipla escolha calibrada”: um canvas semeado com slots de resposta de token único, lido em um limite de passos, com confiança de logprobs e entropia. Os novos campos vllm_xargs incluem diffusion_seed_canvas, diffusion_max_steps e diffusion_read_only, e um exemplo structured_server.py traduz um esquema em um canvas.
O PR relata 8,7 requisições por segundo em leituras de um único canvas, 54 em concorrência de 32 vias, e aproximadamente 90% de acurácia em um corpus de classificação de linguagem. Um revisor sinalizou um teste de condição de corrida ausente e a criação ilimitada de threads como impedimentos. Até que seja mesclado, é um design para ler, não para implementar.
Qual a fidelidade de cada um?
| Projeto | Base | Primitivas | Calibração | Servidor HTTP | Hardware |
|---|---|---|---|---|---|
| OpenJev | Qwen3.5-4B, congelado | choice | softmax sobre logits de opção | Não (CLI + demo de navegador) | Classe RTX 3090, CUDA |
| mini-jev | Qwen3-4B-Instruct, congelado | choice, noul | ranking com uma lacuna | Sim, porta 8765 | 8.5 GB de memória, MPS ou CUDA |
| jevlike | codificador que você treina | choice | nenhuma reivindicada | Não | CPU, MPS ou CUDA |
| Motor MLX | Qwen2.5-1.5B-Instruct-4bit | campos de esquema | softmax sobre candidatos | Sim, porta 8000 | Apple Silicon, macOS 14+ |
| vLLM PR | DiffusionGemma | sim/não, choice, escala | logprobs mais entropia | Sim, compatível com OpenAI | GPU classe vLLM, não mesclada |
Cada linha é um modelo congelado ou auto-treinado lendo logits. Isso lhe dá a forma de Jev: respostas tipadas, uma probabilidade por opção, uma passagem única. Não lhe dá a afirmação central de Jev, que o RLCD torna essas probabilidades honestas. Os 0,845 do OpenJev versus 0,883 são a única comparação com o modelo real, e é a própria avaliação do autor. A configuração corresponde ao nosso guia para rodar Kimi K3 localmente: pesos, uma GPU ou Mac da série M, uma porta local.
Teste qualquer um deles no Apidog como a API Jev real
O objetivo de uma reprodução local é trocá-la pela API real sem reescrever sua integração, então seus testes devem enviar o mesmo corpo para ambos. Nenhum desses projetos fala o esquema {model, state, questions} de Jev nativamente. Coloque um adaptador fino na frente de qualquer um que você execute: um aplicativo FastAPI de 40 linhas que aceita o corpo de Jev, chama a ferramenta e retorna {"answers": {...}} com as chaves choice, probabilities e confidence. Agora, o Apidog vê um único contrato.
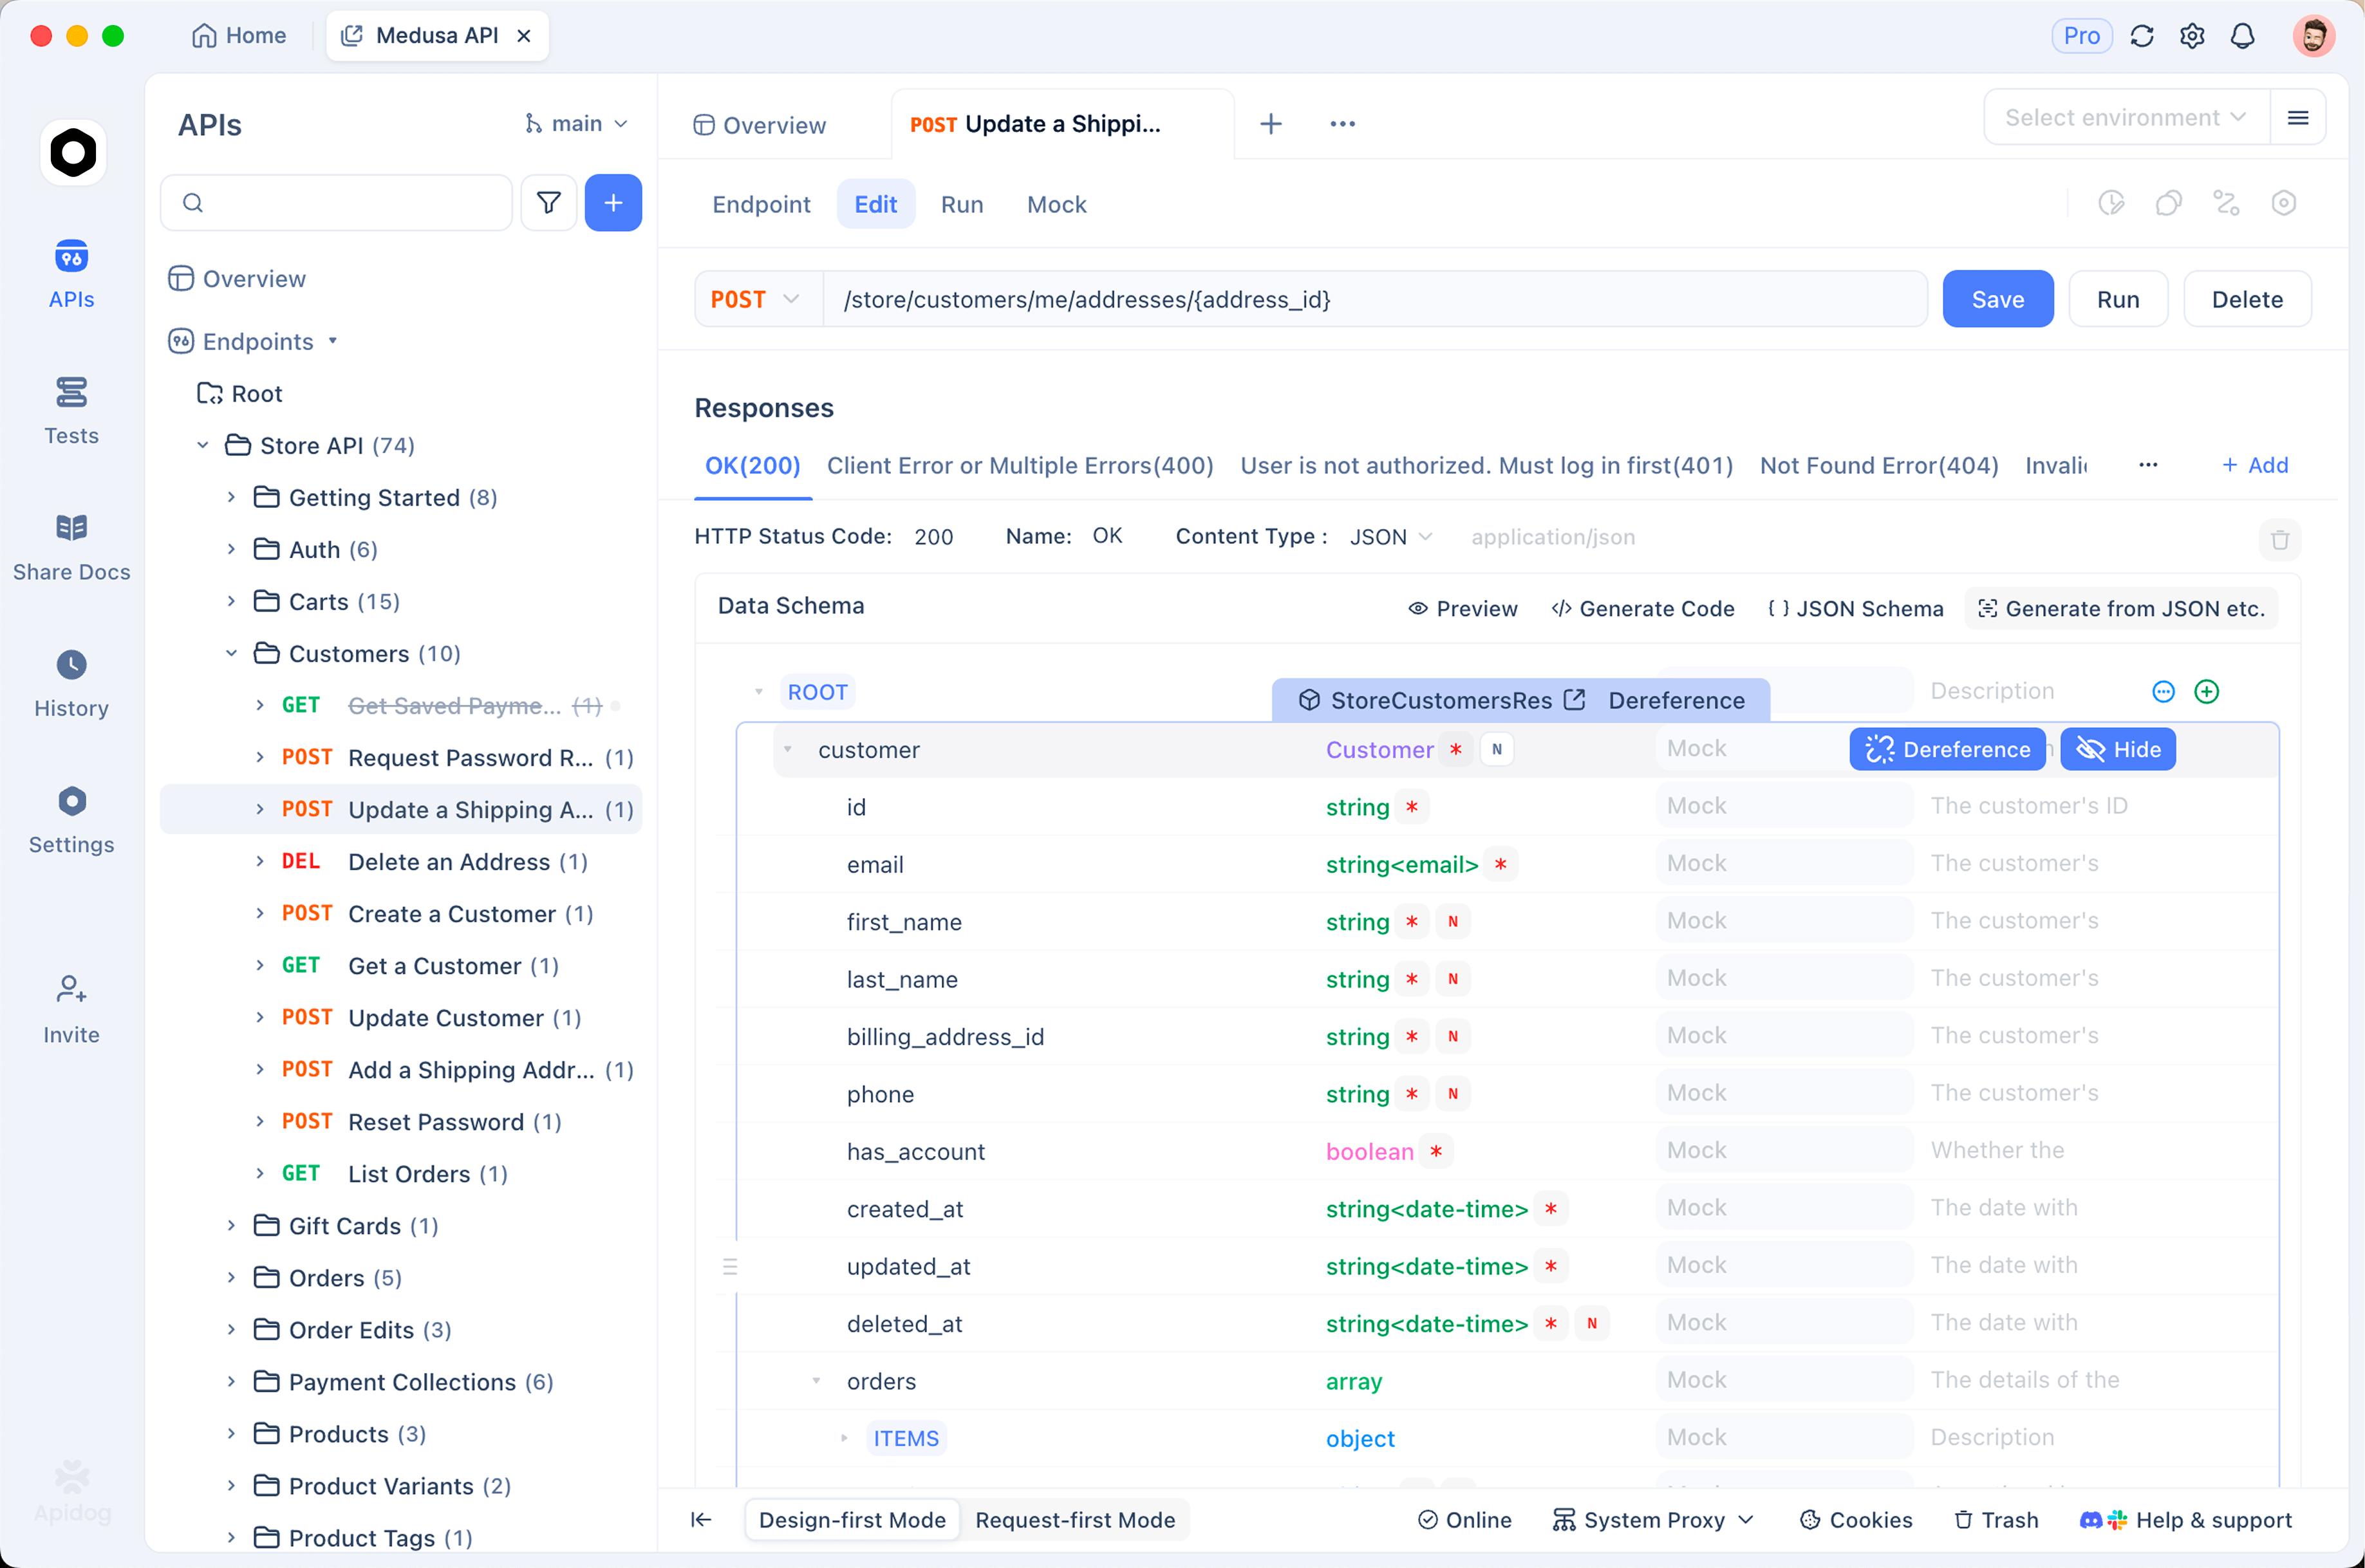
Dois ambientes, um conjunto de requisições. Crie Local reproduction com BASE_URL = http://localhost:8765 e sem chave, e TypeSafe API com BASE_URL = https://api.typesafe.ai mais TYPESAFE_API_KEY no campo local para que nunca sincronize com colegas de equipe (regras de escopo aqui). Cada requisição usa {{BASE_URL}}/v1/systemone e Bearer {{TYPESAFE_API_KEY}}; o servidor local ignora o cabeçalho.
Envie o corpo de Jev. POST {{BASE_URL}}/v1/systemone com o estado e as perguntas que você enviaria para jev-latest:
{
  "model": "jev-latest",
  "state": "My card was charged twice for one order and I need this fixed today.",
  "questions": {
    "department": { "type": "choice", "instructions": "Which team handles this?",
      "criteria": { "billing": "charges and refunds", "shipping": "delivery", "technical": "bugs" } },
    "wants_refund": { "type": "noul", "instructions": "Is the customer asking for money back?" }
  }
}
Afirme sobre os campos de probabilidade. Adicione asserções de pós-processamento: answers.department.choice é igual a billing; answers.department.probabilities.billing é maior que 0.7; answers.wants_refund.noul é maior que 0.8. Mude o menu suspenso de ambiente e execute o mesmo cenário contra a TypeSafe. A diferença entre as duas execuções é o seu número de fidelidade, que vale mais do que qualquer tabela de README.
Salve a execução local como um mock para que o frontend seja construído contra um objeto answers estável com tempo zero de GPU. Baixe o Apidog para configurá-lo; o plano gratuito cobre quatro usuários. O mesmo padrão para modelos de chat está em testar LLMs locais como APIs.
FAQ
OpenJev é o mesmo que Jev?
Não. OpenJev lê os logits de opções de um Qwen3.5-4B congelado e afirma isso em seu README. Jev é um modelo fechado que a TypeSafe treinou com RLCD. OpenJev relata 0,845 de concordância modal com Jev em um subconjunto de 102 linhas, de acordo com a própria avaliação do autor.
Qual devo tentar primeiro?
mini-jev se você usa Mac e quer um endpoint HTTP hoje; OpenJev se você tem uma GPU NVIDIA e quer a comparação publicada mais próxima de Jev. Escolha jevlike apenas se você tiver dados rotulados para treinar.
Posso obter probabilidades calibradas de um modelo congelado?
Não apenas lendo logits. Um softmax sobre tokens de opção é um ranking com uma lacuna, como o README do mini-jev afirma. A calibração precisa de treinamento ou uma etapa pós-hoc como escalonamento de temperatura em seu conjunto rotulado, o que nenhum desses modelos oferece.
É mais barato rodar um desses do que pagar a TypeSafe?
Com $0,042 por milhão de tokens de entrada com saída gratuita, Jev já se encontra no piso dos fornecedores de API LLM mais baratos. O uso local ganha em privacidade e uso offline, não em custo, uma vez que você contabiliza o tempo da GPU.
Onde isso te deixa
OpenJev, mini-jev, jevlike, o motor MLX e o PR do vLLM provam uma ideia: uma decisão não precisa de texto gerado, e ler logits em uma única passagem é mais rápido. Nenhum prova que são calibrados, e nenhum é Jev. Execute um por trás de um adaptador em forma de Jev, mantenha um segundo ambiente apontado para a TypeSafe e deixe suas asserções decidirem o quão distantes eles estão.