A OpenAI e a Anthropic cortaram drasticamente os preços da API desde julho de 2026, e os cortes estão em suas próprias páginas de preços. O GPT-5.6 Luna caiu 80% da noite para o dia, o GPT-6.1 Sol está listado a $2/$10 contra os $5/$30 do GPT-5.6 Sol, o Claude Opus 5.5 cortou as leituras de cache em 60%, e o Claude Haiku 5.5 está listado a um décimo do Haiku 4.5. Se seu modelo de custos, regras de roteamento ou alertas de orçamento são anteriores a setembro, eles estão errados agora, na maioria das vezes a seu favor. A seguir: preços antes/depois verificados, cálculos por requisição, as armadilhas que ainda inflam as faturas, e como deixar seu agente de programação transformar orçamentos de tokens em testes.
O gancho é o ensaio de Max Woolf OpenAI and Anthropic cut their LLM prices by up to 80% within a few months. Why? e sua thread no Hacker News. Cobrimos o lado de mercado em a guerra de preços de modelos de IA de setembro de 2026; este post é sobre o que uma equipe deve mudar.
Os preços antes/depois verificados
USD por milhão de tokens (entrada / saída / entrada em cache), camada padrão, abaixo dos limites de contexto longo. As linhas da OpenAI vêm da página de preços da API da OpenAI consultada em 26/10/2026, com os preços "antes" provenientes de cópias arquivadas dessa página. As linhas da Anthropic vêm da documentação de preços do Claude, que lista modelos antigos e novos lado a lado.
| Mudança de modelo | Antes | Depois | Mudança | Quando |
|---|---|---|---|---|
| GPT-5.6 Luna (corte de preço) | $1 / $6 / $0,10 | $0,20 / $1,20 / $0,02 | -80% em todos os itens | 30/07/2026 |
| GPT-5.6 Terra (corte de preço) | $2,50 / $15 / $0,25 | $2 / $12 / $0,20 | -20% | 30/07/2026 |
| GPT-5.6 Sol (promocional) | $5 / $30 / $0,50 | $4 / $20 / $0,40 | -20% entrada, -33% saída | 21/08/2026 |
| GPT-5.6 Sol de tabela para GPT-6.1 Sol | $5 / $30 / $0,50 | $2 / $10 / $0,10 | -60% entrada, -67% saída, -80% cache | 29/09/2026 |
| GPT-5.6 Luna para GPT-6 Luna | $0,20 / $1,20 / $0,02 | $0,10 / $0,50 / $0,01 | -50% entrada, -58% saída | 22/09/2026 |
| Claude Opus 5 para Opus 5.5 | $5 / $25 / $0,50 | $4 / $20 / $0,20 | -20% entrada/saída, -60% cache | 22/09/2026 |
| Claude Fable 5 para Fable 5.1 | $10 / $50 / $1 | $10 / $50 / $0,25 | -75% somente no cache | Set 2026 |
| Claude Sonnet 5 para Sonnet 5.5 | $2 / $10 / $0,20 | $2 / $10 / $0,10 | -50% somente no cache | Set-Out 2026 |
| Claude Haiku 4.5 para Haiku 5.5 | $1 / $5 / $0,10 | $0,10 / $0,50 / $0,01 | -90% (prompts até 100K) | Out 2026 |
Apenas as linhas do GPT-5.6 são cortes no mesmo modelo; o restante são sucessores mais baratos, então a qualidade e as contagens de tokens diferem. O preço de lançamento de $2/$10 do Sonnet 5 tornou-se permanente, e a documentação diz que a mudança planejada para $3/$15 "não ocorrerá". O desconto do GPT-5.6 Sol é promocional, "disponível pelo menos até 21 de novembro de 2026". Os preços de Luna e Terra antes do corte estão na página de preços arquivada da OpenAI de 29 de julho.
Detalhamentos por modelo: o corte de preço do GPT-5.6, preços do GPT-6 Sol, preços do Claude Haiku 5.5.
Por que os preços caíram
A única razão de primeira fonte vem da Anthropic: o anúncio do Claude Opus 5.5 diz que o modelo "requer menos computação para ser servido do que o Opus 5, e seu preço reflete isso", e estima um custo 40% menor em cargas de trabalho típicas. As páginas da OpenAI não dão razão alguma. O resto é opinião:
- Concorrência, baixos custos de troca. Woolf argumenta que os modelos agora são substitutos próximos: a troca é um toggle em um harness ou uma nova string de modelo através de um roteador. Modelos de pesos abertos servidos por muitos provedores (ele contou 29 para uma variante do DeepSeek Flash no OpenRouter em 24 de outubro) definem o piso.
- Ação e reação. Os cortes alternam entre as duas empresas, e ambas lançaram carros-chefe mais baratos em 22 de setembro.
- Momento do IPO. Woolf observa que ambas estão rumorejadas a se aproximar de IPOs e acha o momento estranho. Isso é especulação sobre o motivo.
- Eficiência. Muitos comentaristas do HN dão a história mais simples: melhor cache, modelos menores, serviço mais barato.
Woolf também cita dados do Vercel AI Gateway: o custo por token caiu para 43,3% do seu nível de abril de 2026 enquanto os gastos agregados aumentaram. Tokens mais baratos raramente reduzem uma fatura, a menos que você mude como os gasta.
O que os cortes mudam: cálculo prático por requisição
Um turno de agente com uso intenso de cache
Considere um turno de um agente de programação: 100.000 tokens de conversa lidos do cache, 2.000 novos tokens de entrada, 1.000 tokens de saída.
| Modelo | Leituras de cache | Nova entrada | Saída | Custo do turno |
|---|---|---|---|---|
| GPT-5.6 Sol (tabela) | $0,050 | $0,010 | $0,030 | $0,090 |
| GPT-5.6 Sol (promo) | $0,040 | $0,008 | $0,020 | $0,068 |
| GPT-6.1 Sol | $0,010 | $0,004 | $0,010 | $0,024 |
| Claude Opus 5 | $0,050 | $0,010 | $0,025 | $0,085 |
| Claude Opus 5.5 | $0,020 | $0,008 | $0,020 | $0,048 |
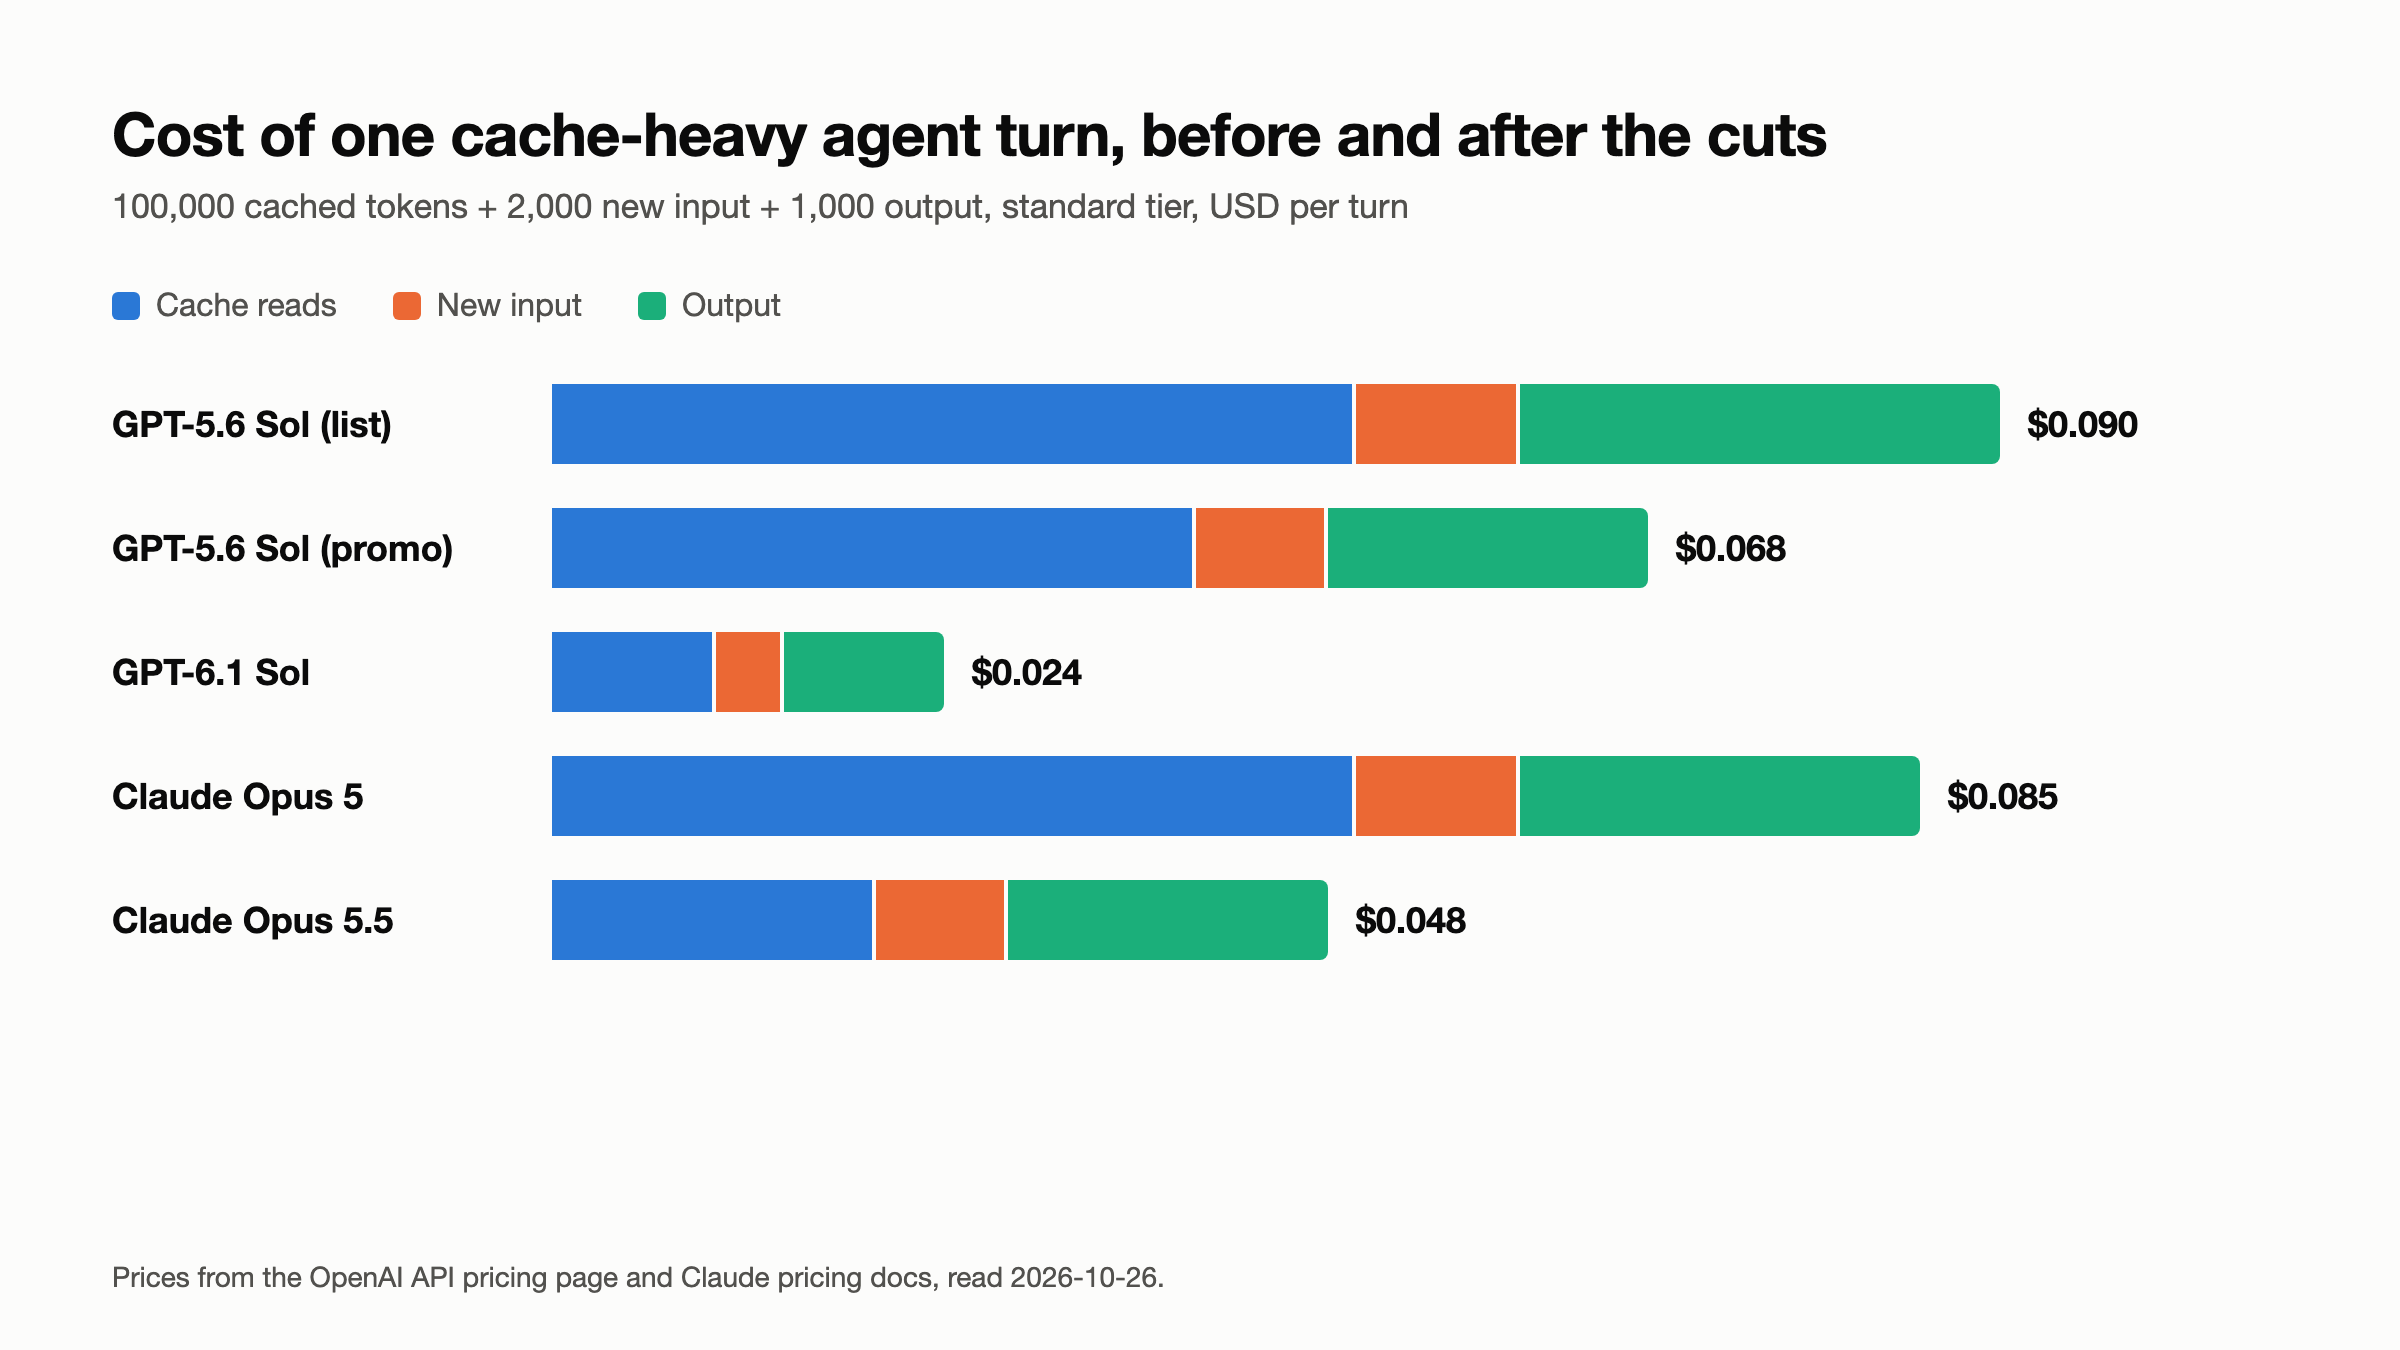
O GPT-6.1 Sol está 73% abaixo do preço de tabela do GPT-5.6 Sol neste turno, e o Opus 5.5 está 44% abaixo do Opus 5, próximo dos 40% da Anthropic. Nos modelos antigos, as leituras de cache eram mais da metade do turno, então o preço de leitura de cache é agora o número que importa para agentes. É por isso que o corte somente no cache do Fable 5.1 importa mais do que seu $10/$50 inalterado sugere. Veja nosso cálculo de ponto de equilíbrio do cache do Opus 5.5 e o guia de cache de prompt do GPT-6.
O que mudar: classifique os modelos por custo por turno na sua taxa real de acerto de cache, não pelo preço de entrada de tabela.
Um classificador de alto volume
Agora um roteador ou classificador: 1 milhão de requisições por dia, 1.500 tokens de entrada e 200 tokens de saída cada, sem cache.
- GPT-5.6 Luna antes de 30 de julho: 1,5B de entrada a $1 mais 200M de saída a $6 = $2.700/dia
- GPT-6 Luna: $150 + $100 = $250/dia
- Claude Haiku 4.5: $1.500 + $1.000 = $2.500/dia
- Claude Haiku 5.5: $150 + $100 = $250/dia
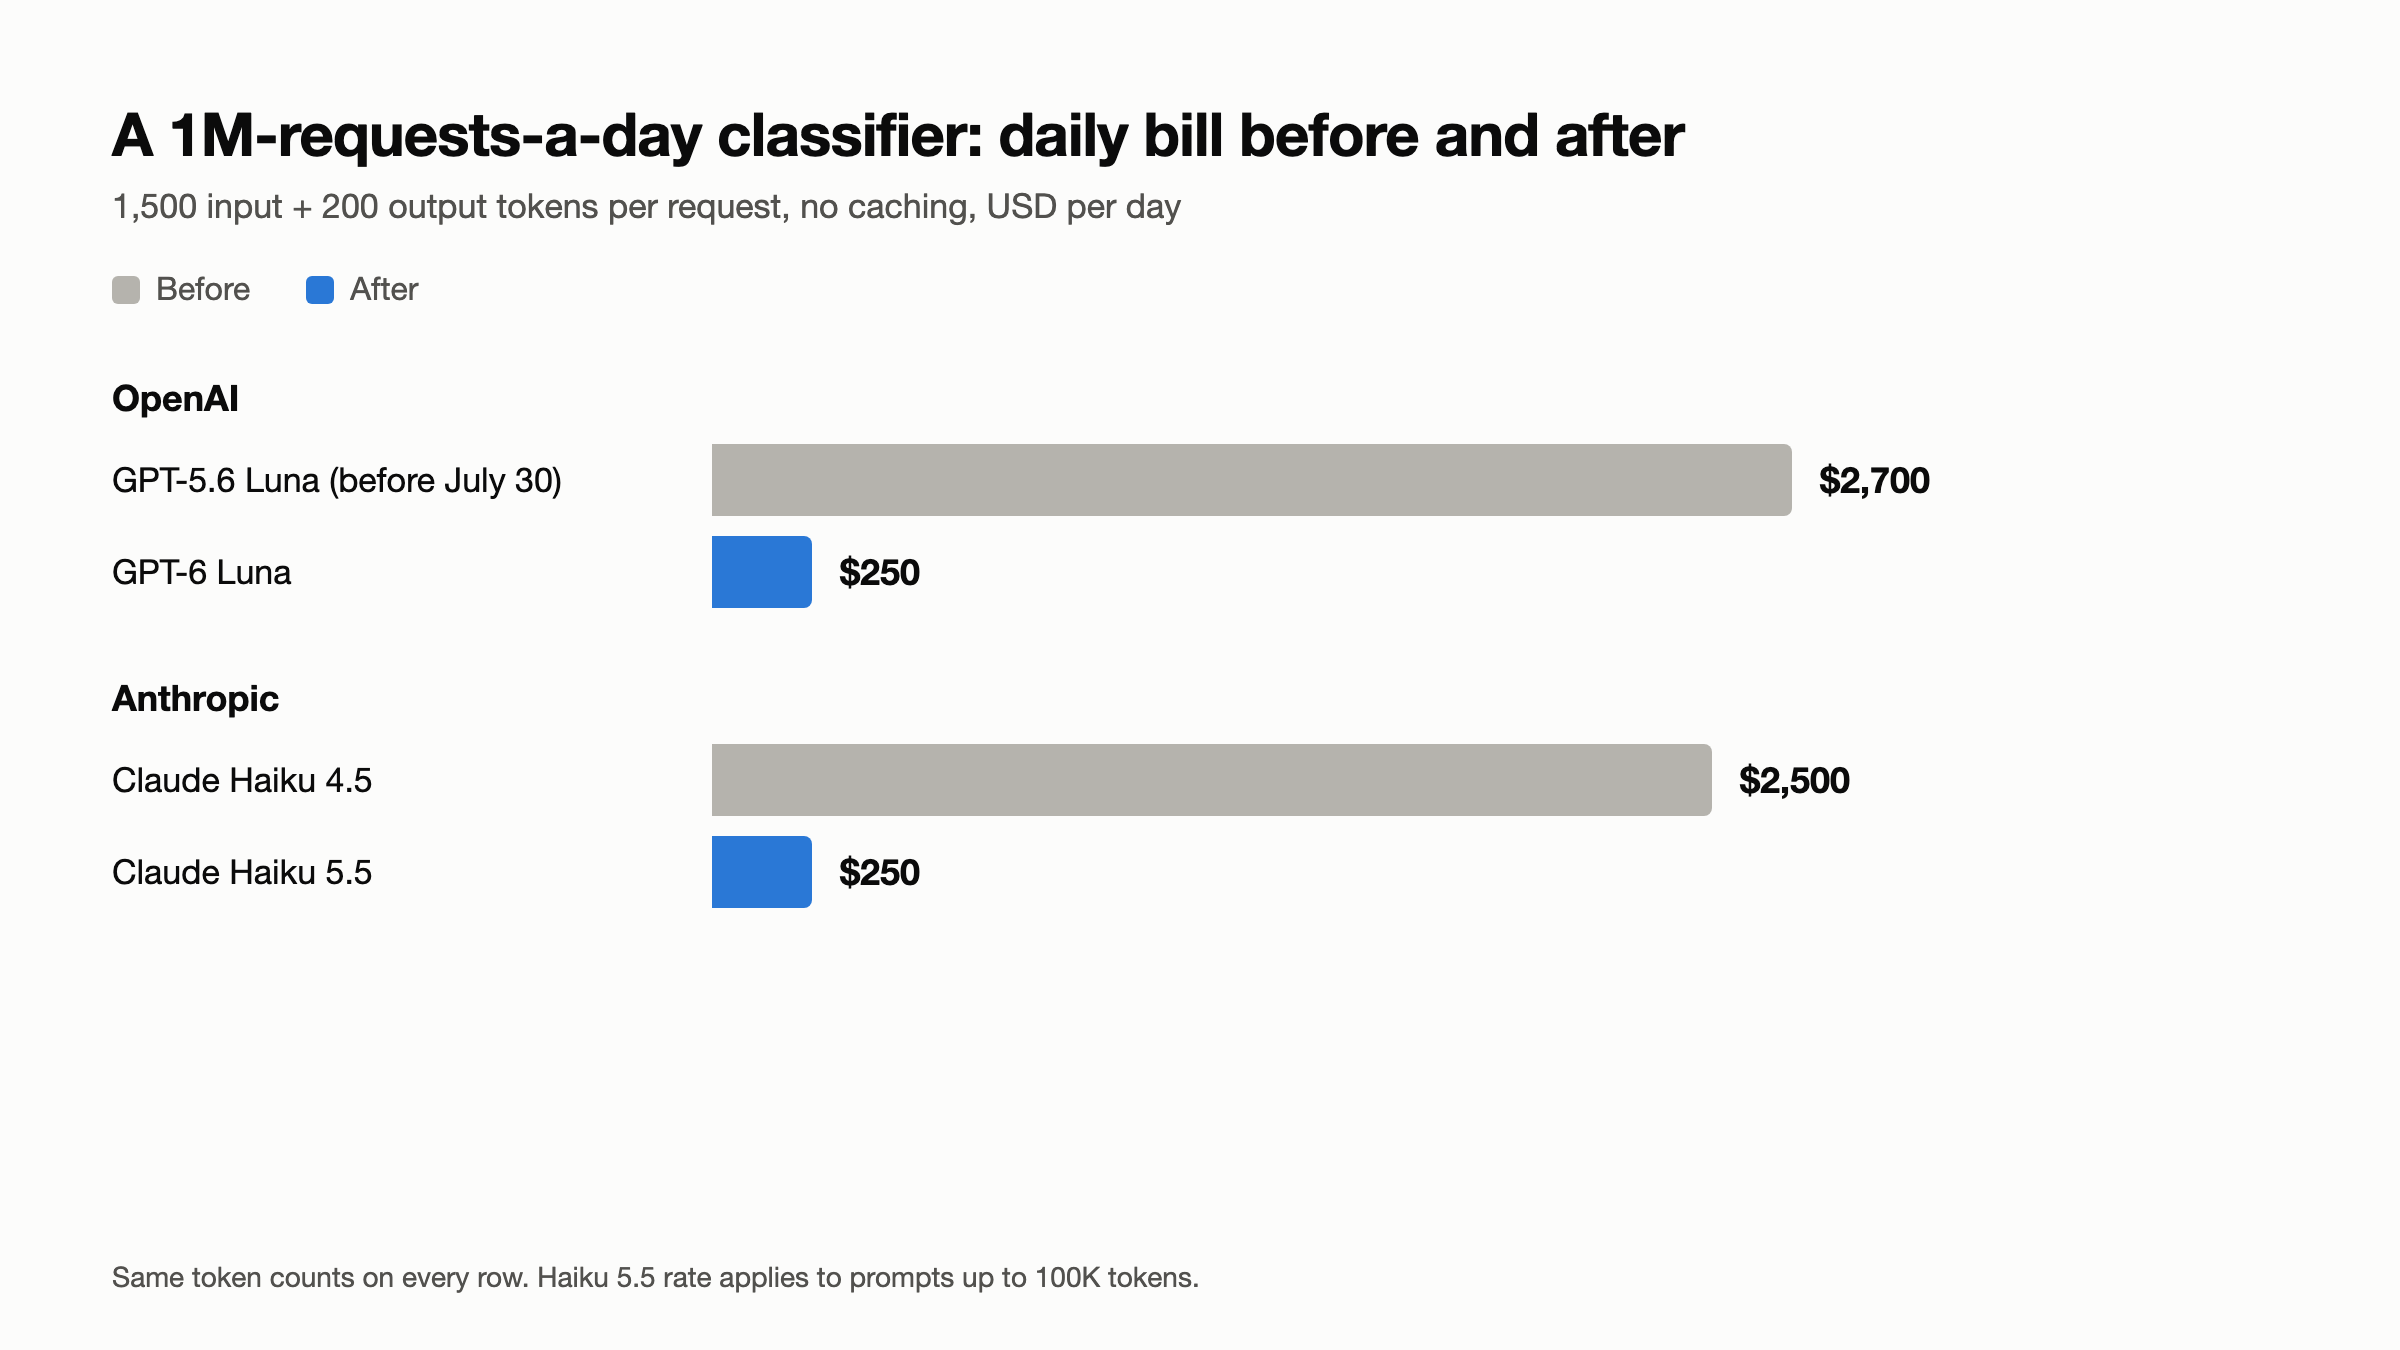
O que mudar: pare de enxugar prompts para modelos pequenos e teste se o tráfego de camada intermediária agora cabe em um pequeno. Execute primeiro seu conjunto de avaliação: o preço por token não diz nada sobre a precisão nos seus dados.
Batch: valores menores, mesma porcentagem
Ambas ainda dão 50% de desconto em trabalho assíncrono: a Batch API da Anthropic reduz pela metade entrada e saída, e a camada Flex/Batch da OpenAI reduz tudo pela metade, incluindo entrada em cache (GPT-6.1 Sol: $1 / $5 / $0,05). No classificador acima, o batch agora economiza $125 por dia. Para cargas de trabalho pequenas, isso pode já não justificar a infraestrutura extra de enfileiramento; para grandes, o guia da Batch API da OpenAI ainda se aplica.
As armadilhas que ainda inflam a fatura
Escritas de cache custam mais que a entrada. A Anthropic cobra 1,25x a entrada base por uma escrita de 5 minutos e 2x por uma escrita de 1 hora. A tabela da OpenAI também tem colunas de escrita: 1,25x por 30 minutos e 2,5x por 12 horas (GPT-6.1 Sol: $2,50 e $5 contra $2 de entrada). Um prefixo escrito e nunca lido custa de 25% a 150% mais do que nenhum cache. Com leituras a 5% da entrada, uma escrita curta se paga após uma leitura, uma longa após duas.
Multiplicadores de contexto longo. No GPT-6.1 Sol e GPT-6 Luna, as páginas de modelo da OpenAI dizem que prompts acima de 272K tokens de entrada são cobrados a 2x as taxas de entrada e cache e 1,5x a saída "para a requisição completa". O Claude Haiku 5.5 salta de $0,10/$0,50 para $0,50/$2,50 acima de 100.000 tokens de prompt, e a Anthropic conta leituras e escritas de cache nesse limiar. Outros modelos Claude 4.6 e posteriores cobram a janela completa de 1M a taxas padrão. Um único prompt superdimensionado em um caminho crítico pode apagar as economias.
Tokens de raciocínio são tokens de saída. O guia de raciocínio da OpenAI diz que tokens de raciocínio são "cobrados como tokens de saída" e os mostra em usage.output_tokens_details.reasoning_tokens. Uma resposta pode atingir max_output_tokens antes de qualquer saída visível, e você ainda paga. A documentação de custo do pensamento da Anthropic cobra todo o pensamento, não o resumo visível, relatado em usage.output_tokens_details.thinking_tokens. A saída é o lado caro de cada linha, então as configurações de esforço podem mover as faturas mais do que a escolha do modelo.
Aumentos regionais. A OpenAI adiciona 10% para processamento regional (residência de dados) em modelos lançados em ou após 5 de março de 2026, e 10% para endpoints FedRAMP. A Anthropic aplica um multiplicador de 1,1x quando você define inference_geo: "us", e endpoints regionais no Bedrock e no Google Cloud carregam um prêmio de 10% sobre os globais.
Tokenizadores e promoções. A documentação da Anthropic diz que modelos Claude 4.7 e posteriores usam um tokenizador que produz cerca de 30% mais tokens para o mesmo texto do que o Sonnet 4.6 e anteriores, então, no mesmo texto, a transição de Haiku 4.5 para Haiku 5.5 fica mais próxima de 87% do que de 90%. E se você fixou gpt-5.6-sol para manter a tarifa promocional, coloque 21 de novembro de 2026 no seu calendário.
Deixe seu agente de programação colocar asserções de custo nas suas chamadas de LLM com o Apidog CLI
Os preços mudam mensalmente; as contagens de tokens mudam sempre que alguém edita um prompt ou aumenta uma configuração de esforço. A solução duradoura é um teste que falha quando uma chamada ultrapassa o orçamento, executado em cada pull request. Deixe o Claude Code, Codex ou Cursor escrevê-lo com o Apidog CLI.
Instale o CLI e a skill do agente uma vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois dê ao seu agente um prompt:
In Apidog project <id>, create an environment "openai" with base URL https://api.openai.com
and an endpoint POST /v1/responses. Add a test case that sends our support-ticket summary
prompt to gpt-6.1-sol and asserts: HTTP 200, usage.output_tokens at most 1500 and
usage.output_tokens_details.reasoning_tokens at most 1000. Use an API key variable,
not a literal. Run it and summarize any failures.
O agente lê cada esquema de payload, valida antes de escrever e executa o caso:
apidog environment create openai --project <id> --base-url https://api.openai.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <id> --file endpoint.json
apidog test-case category --project <id>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Os orçamentos ficam nos postProcessors do caso como asserções em JSONPath, com comparações como isAtMost e isAtLeast do esquema test-case-create:
{
  "type": "assertion",
  "defaultEnable": true,
  "enable": true,
  "data": {
    "name": "output tokens under budget",
    "subject": "responseJson",
    "comparison": "isAtMost",
    "value": "1500",
    "path": "$.usage.output_tokens"
  }
}
Para o Claude, aponte o endpoint para /v1/messages e faça asserções em $.usage.output_tokens e $.usage.output_tokens_details.thinking_tokens. Então peça um cenário de teste que faça a mesma chamada duas vezes e verifique se o $.usage.input_tokens_details.cached_tokens da segunda resposta (OpenAI) ou $.usage.cache_read_input_tokens (Claude) é maior que zero: quando alguém quebrar o prefixo em cache, a build falha antes de a fatura chegar. Alimente prompts representativos com -d, passe a chave de API dos segredos do CI com --env-var e use -r junit no seu pipeline (guia de CI/CD). Apidog CLI no Claude Code cobre a configuração do agente.
Perguntas frequentes
A OpenAI e a Anthropic realmente cortaram os preços em 80%? Para um modelo, sim: o GPT-5.6 Luna passou de $1/$6 para $0,20/$1,20 em 30 de julho de 2026. A maioria das outras quedas vem de modelos sucessores mais baratos.
Os cortes se aplicam às assinaturas do Claude Code e do Codex? As páginas de preços cobrem a API. Woolf diz que as economias também chegam aos harnesses de assinatura, mas também relata que a OpenAI cortou pela metade a cota de uso na camada de $200 do Codex, então verifique os limites do seu plano.
O preço do GPT-5.6 Sol é permanente? Não. É promocional, pelo menos até 21 de novembro de 2026. O GPT-6.1 Sol é mais barato de qualquer forma.
Qual é a maneira mais barata de cortar a fatura de um agente agora? Aumente sua taxa de acerto de cache e reduza o esforço de raciocínio. As leituras de cache dominam sessões longas, e o raciocínio é cobrado à taxa de saída.
Próximo passo
Recalcule o custo das suas três chamadas de LLM mais movimentadas e faça seu agente adicionar um teste de orçamento de tokens para cada uma. Baixe o Apidog para começar.