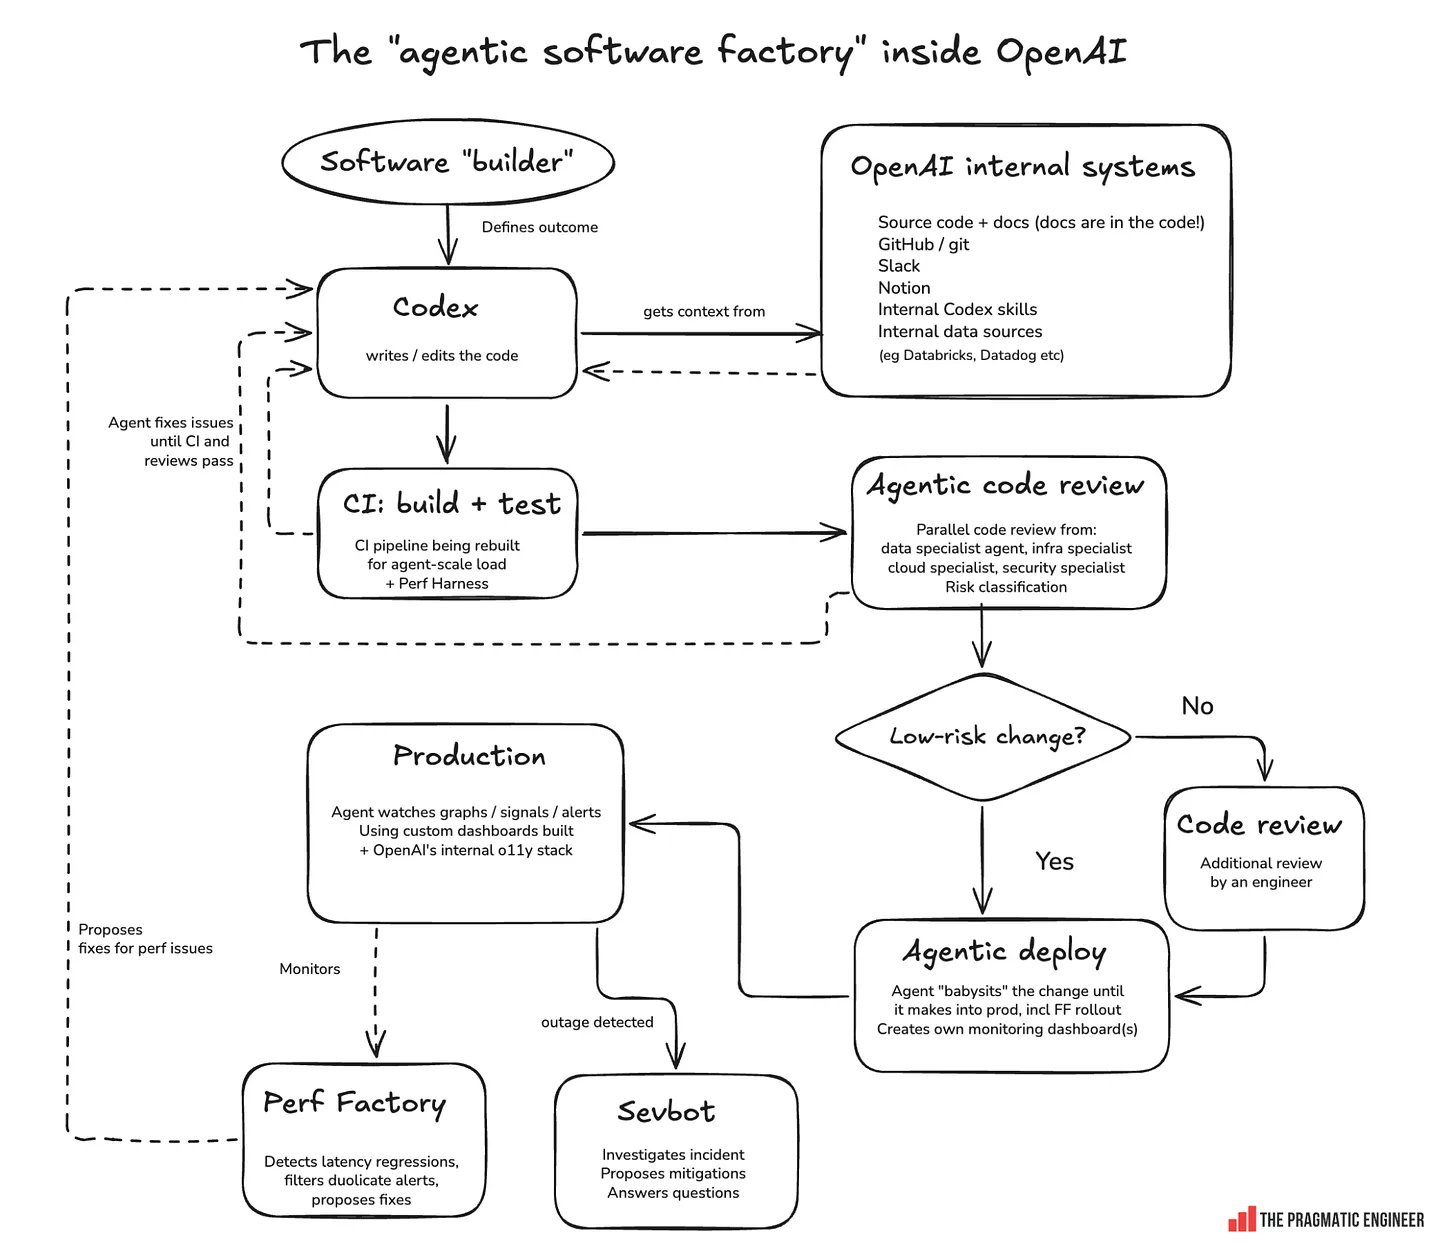
Um diagrama do pipeline de engenharia interna da OpenAI se tornou semi-viral no X esta semana. Ele mostrava dez caixas, desde "o desenvolvedor de software define o resultado" até um agente que monitora gráficos de produção e registra seus próprios relatórios de incidentes. A fonte é a newsletter de Gergely Orosz, The Pragmatic Engineer, em um artigo intitulado "OpenAI’s agentic software factory", e o próprio diagrama se espalhou rapidamente no X.
A maior parte da reação ignorou um detalhe importante: várias dessas dez caixas descrevem a configuração de engenharia interna da OpenAI, não o produto Codex que você pode instalar hoje. Confundir os dois é o erro mais comum na discussão em torno deste diagrama. Este artigo analisa caixa por caixa e para na etapa que as equipes externas podem realmente replicar: CI.
As dez etapas, em ordem
O diagrama lê da esquerda para a direita como um loop: um humano define uma meta, um agente escreve o código, portões automatizados o verificam, e o agente continua iterando até que esses portões passem. Aqui está a sequência completa com a linha interna-versus-lançada marcada para cada etapa.
| # | Etapa | O que acontece | Somente interno ou lançado no Codex |
|---|---|---|---|
| 1 | Construtor de software | Um engenheiro ou PM define o resultado | Etapa humana, não software |
| 2 | Codex escreve/edita código | Puxa contexto de fonte, docs, GitHub, Slack, Notion, habilidades internas e sistemas de dados como Databricks e Datadog | O Codex lançado escreve código; o grafo de contexto interno (Slack, Notion, dados internos) é apenas interno |
| 3 | CI: build + teste | Um pipeline sendo reconstruído para carga em escala de agente, além de um “Perf Harness” | Lançado (seu próprio CI); o trabalho específico de escalabilidade da OpenAI é interno |
| 4 | Revisão de código agêntica | Revisão paralela de agentes especialistas em dados, infraestrutura, nuvem e segurança, além de classificação de risco | Somente interno |
| 5 | Decisão de baixo risco | Mudanças de baixo risco prosseguem; mudanças de alto risco recebem uma revisão adicional de um engenheiro humano | Somente interno |
| 6 | Implantação agêntica | Um agente "supervisiona" a mudança na produção, incluindo lançamento com feature-flags, e constrói seus próprios dashboards | Somente interno |
| 7 | Monitoramento de produção | O agente monitora gráficos, sinais e alertas na pilha de observabilidade interna da OpenAI | Somente interno |
| 8 | Outage detectado -> Sevbot | Investiga o incidente, propõe mitigações, responde a perguntas | Somente interno |
| 9 | Fábrica de Performance | Filtra alertas duplicados, encontra regressões de latência, propõe correções | Somente interno |
| 10 | Loop de volta | O agente corrige problemas até que o CI e as revisões sejam aprovados, então o construtor recebe as correções propostas | Descreve o loop interno |
Exatamente uma etapa, a etapa de CI, além de uma fatia da etapa 2, é algo que uma equipe externa pode apontar e dizer "nós também temos isso". Tudo, desde a revisão agêntica até o Sevbot, é uma construção interna da OpenAI.
Essa coluna "somente interno" também é um problema de sourcing. As partes que a OpenAI mantém atrás de seu firewall, a orquestração, o portão de revisão, a aprovação humana, são exatamente a camada para a qual a maioria das equipes não tem nada. Sharkly é um local neutro para provedores para construí-lo: um construtor define o resultado como uma Tarefa, atribui-a a um Agente, e o Agente executa em um Computador usando qualquer Runtime que você já tenha, Claude Code ou Codex. "Pronto para Lançamento" é o status que um humano precisa mover antes que algo chegue a "Concluído", para que a aprovação continue sendo trabalho de uma pessoa, não do pipeline. Sharkly não substitui o Codex nem escreve código por si só; ele executa o Runtime pelo qual você já paga e dá ao loop circundante um lugar para viver.
Etapa 1-2: um humano ainda define a meta, o Codex ainda escreve o código
Um construtor de software, ou seja, um engenheiro ou um gerente de produto, define o resultado que deseja. O Codex então faz uma série de alterações de código até atingir esse objetivo e verifica se o resultado funciona. Esse loop de verificação é a parte do Codex que é lançada hoje: o aplicativo de desktop (Mac em fevereiro de 2026, Windows em março), a integração com o ChatGPT Work a partir de julho de 2026, plugins e habilidades baseados em funções, e o comando /goal para tarefas que se estendem por um longo período. Se você quiser a mecânica desse comando, abordamos o /goal para execuções de agentes autônomos separadamente.
O que não é lançado é o grafo de contexto que alimenta o Codex internamente: praticamente todos os sistemas da OpenAI, desde threads do Slack até dashboards do Databricks. O artigo de Orosz coloca diretamente: o Codex interno da OpenAI "é muito mais avançado do que sua contraparte externa porque está conectado a praticamente todos os sistemas da OpenAI". Essa lacuna entre o Codex interno e externo é a verdadeira tese do artigo.
Etapa 3: CI é onde o loop é realmente aplicado
Esta é a etapa que vale a pena desacelerar, porque é a única caixa em todo o pipeline que qualquer equipe, não apenas a OpenAI, já possui. O artigo observa que o CI na OpenAI está sendo reconstruído para um aumento de carga de aproximadamente 10 vezes em cerca de seis meses, porque os agentes agora enviam muito mais alterações através do pipeline do que os humanos sozinhos. Um "Perf Harness" roda ao lado para detectar regressões de desempenho antes que elas cheguem à revisão.
Aqui está a parte que é perdida: um agente que "corrige problemas até que o CI e as revisões sejam aprovados" é tão confiável quanto o que o CI realmente verifica. Se sua suíte de testes cobre a lógica da unidade, mas não o contrato da API, um agente pode entrar em um loop para um build verde que ainda envia uma mudança disruptiva. Códigos de status, formato do esquema, comportamento de autenticação e orçamentos de tempo de resposta sob carga são exatamente a classe de verificação na qual a maioria das equipes investe menos em relação aos testes de unidade. Esta é a caixa onde Apidog se encaixa: executar os cenários de teste do Apidog através da CLI do Apidog dentro da sua etapa de CI dá a um agente um portão mais difícil de satisfazer do que "o código compilou". Escrevemos sobre como configurar isso em Apidog CLI dentro do Codex. Esse é o único papel que o Apidog desempenha neste pipeline. Ele não é o agente, e não toca na implantação, revisão ou resposta a incidentes.
Etapa 4-5: agentes de revisão especialistas e a decisão de risco
Depois que o CI é aprovado, a configuração interna da OpenAI roteia a mudança através de uma revisão paralela de agentes especialistas em dados, infraestrutura, nuvem e segurança. Orosz descreve isso como "o equivalente a ter um especialista humano de domínio de cada equipe de infraestrutura relevante revisando cada mudança", o que é uma barra de revisão mais pesada do que a maioria das equipes humanas pode suportar para cada pull request. O recurso de revisão de código lançado do Codex é algo diferente e mais leve do que esses agentes especialistas internos; se você está decidindo o que um revisor agêntico de propósito geral pode fazer por sua própria pilha, nosso resumo das ferramentas de revisão de código de IA é um bom ponto de partida, e nosso artigo complementar sobre a revisão agêntica da OpenAI e o design do portão de risco aprofunda-se nesta caixa (irmão, confirme ao vivo antes de linkar).
A classificação de risco então decide o que acontece a seguir. Áreas de baixo risco da base de código podem permitir que um agente aprove automaticamente seus próprios PRs, eliminando a aprovação humana do loop inteiramente para essa classe de mudança. Mudanças de maior risco recebem mais passagens de revisão de IA, uma revisão humana obrigatória, ou ambos. A OpenAI não publicou a regra exata para o que conta como baixo risco, e não vamos adivinhar aqui. Uma ideia que generaliza além da configuração específica da OpenAI: uma mudança disruptiva em um contrato de API público nunca deve ser classificada como baixo risco, não importa quão pequena a diferença pareça. Ferramentas "spec-first" que mantêm sua definição OpenAPI e seus testes no mesmo lugar tornam essa distinção mais fácil de ser aplicada automaticamente, já que uma diferença de esquema é um sinal de risco muito mais claro do que uma diferença de contagem de linhas.
Etapa 6-8: implantar, monitorar e responder, sem um humano acionado primeiro
Se uma mudança for aprovada na revisão, um agente interno a "supervisiona" na produção, incluindo o lançamento com feature-flags, e constrói seus próprios dashboards de monitoramento para essa mudança específica. Uma vez ativa, o mesmo agente (ou um relacionado) monitora gráficos e alertas na pilha de observabilidade interna da OpenAI. Quando algo quebra, o Sevbot assume: ele investiga o incidente, propõe mitigações e responde a perguntas de desenvolvedores no Slack. Vale a pena ser preciso sobre o que o Sevbot não faz. Ele propõe; ele não executa. Um humano ainda autoriza a mitigação e ainda está de plantão. Como o artigo afirma claramente, "o plantão não é coisa do passado." Nenhuma das etapas de 6 a 8 existe no produto Codex que você pode comprar.
Etapa 9-10: regressões de desempenho e o retorno ao loop
A Fábrica de Performance fica ao lado do caminho do incidente. Ela filtra alertas e dashboards, elimina sinais duplicados, identifica regressões de latência reais e propõe correções, que então fluem de volta para o construtor original. Juntamente com o Sevbot, esta é a resposta da OpenAI à fadiga de alertas: em vez de um engenheiro de plantão triar cada ping, um agente pré-filtra e pré-diagnostica primeiro. O loop se fecha com a etapa 10: o agente continua revisando até que o CI e todas as camadas de revisão sejam aprovados.
Por que a linha interno/externo importa para sua equipe
Se você está avaliando se a engenharia agêntica "estilo OpenAI" é algo que sua equipe pode adotar neste trimestre, a resposta honesta é: você pode adotar as etapas 1 a 3 hoje, e as etapas 4 a 9 descrevem uma direção, não um recurso comprável. Isso não é uma crítica à OpenAI; ferramentas internas nessa escala levam anos. Um projeto de código aberto, orchflows, é uma tentativa pública de aproximar esse loop com um comando /software-factory para Claude Code e Codex; seu README é direto sobre o objetivo, argumentando que você só precisa de duas habilidades em vez de uma biblioteca delas. É um projeto inicial e não afiliado, não um lançamento da OpenAI, então trate-o como uma implementação de referência em vez de uma fábrica pronta para uso.
A adoção dentro da própria OpenAI se moveu rapidamente nas partes que não precisam de encanamento interno personalizado: o uso do Codex em equipes não-engenharia passou de aproximadamente 0% para 90% de adoção em quatro meses, de fevereiro a maio de 2026. Esse é um sinal mais claro do que o diagrama do pipeline sozinho, porque diz que a parte fácil (um agente que escreve código para uma meta declarada) já é normal na OpenAI, enquanto a parte difícil (implantação, revisão e resposta a incidentes agênticos conectados a todos os sistemas internos) ainda é personalizada.
O que permanece humano
O artigo é cuidadoso sobre o que não muda. Os construtores ainda definem resultados. Os humanos ainda aprovam mudanças de alto risco e autorizam mitigações de incidentes. Alguém ainda revisa o que o Sevbot fez depois do fato, e as escalas de plantão ainda existem. A frase com que o artigo termina capta a mudança melhor do que qualquer estatística: "Julgamento, priorização e bom gosto estão se tornando mais importantes." Duas ressalvas mantêm isso com os pés no chão também: a revisão da loja de aplicativos móveis ainda é um gargalo manual que nenhum agente pode contornar, e o dimensionamento da infraestrutura é uma batalha mensal, não um problema resolvido.
Se você está construindo sua própria versão das etapas 1 a 3 em vez de esperar que um fornecedor lance as etapas 4 a 9, comece com o portão que já existe em seu pipeline: o CI. Nosso artigo complementar sobre construir uma fábrica de software mais leve em torno do Codex detalha essa construção (irmão, confirme ao vivo antes de linkar), e o design do Sevbot/Perf Factory recebe seu próprio tratamento em nossa peça sobre a fábrica de performance da OpenAI e o Sevbot (irmão, confirme ao vivo antes de linkar). Um agente que entra em loop até que os testes passem é uma boa ideia apenas se os testes contra os quais ele está em loop realmente afirmarem algo. O Apidog mantém os testes de contrato da API próximos à especificação para que esse portão permaneça honesto à medida que os agentes, e não apenas os humanos, começam a enviar mudanças através dele.