
A NVIDIA lançou o modelo de fala para texto de pesos abertos mais preciso do Hugging Face Open ASR Leaderboard, e você pode usá-lo gratuitamente hoje mesmo. O Nemotron 3.5 Transcribe (nome completo NVIDIA-Nemotron-3.5-Transcribe-30B-A4B) chegou em 28 de outubro de 2026 sob a licença OpenMDW-1.1, que permite uso comercial. Isso significa três rotas a $0: o próprio Space de demonstração da NVIDIA, os pesos gratuitos na sua própria GPU e Spaces da comunidade que envolvem o mesmo checkpoint.
Este guia cobre cada rota gratuita, o que ela pode e não pode fazer, e o fallback pago mais barato quando o gratuito deixa de ser suficiente. Todo fato vem do model card oficial, do post de lançamento da NVIDIA no Hugging Face e do Open ASR Leaderboard, todos lidos em 29 de outubro de 2026.
Se você só precisa da API hospedada, pule para o nosso guia da API do Nemotron 3.5 Transcribe.
O Nemotron 3.5 Transcribe é gratuito?
Sim, de duas maneiras. Os pesos são gratuitos para baixar e a licença permite uso comercial e não comercial, então hospedar por conta própria custa apenas o hardware. A NVIDIA também mantém um Space de demonstração gratuito no Hugging Face, onde você pode experimentá-lo no navegador.
O que não é gratuito: as APIs hospedadas. A DeepInfra cobra $0,002 por minuto de áudio e a OpenRouter lista a $0,000033 por segundo. Nenhuma das duas mostra uma variante gratuita. E em 29 de outubro de 2026, o modelo não aparece em build.nvidia.com, onde muitos modelos da NVIDIA ganham uma API de teste gratuita. Uma busca por "transcribe" lá retornou um modelo de ASR em espanhol não relacionado.
Por que as pessoas o querem: os números
O Nemotron 3.5 Transcribe é um modelo de linguagem aumentado para fala. Um codificador ASR de 600M de parâmetros e um codificador de locutor alimentam um modelo de linguagem com mistura de especialistas híbrido de Mamba-2 e Transformer. Ele tem 34B de parâmetros no total, mas apenas cerca de 4,3B estão ativos por token, e é por isso que ele roda em uma única GPU.
O que ele faz em um único checkpoint:
- Transcrição em 40 idiomas, com 13 classificados como "líderes" (inglês, espanhol, francês, alemão, hindi, coreano, português e outros)
- Gravações de até uma hora em uma única requisição (contexto de 65.536 tokens)
- Atribuição de locutor com até oito locutores rotulados
- Timestamps em nível de palavra por meio de um cabeçote de alinhamento CTC
- Tradução de fala de e para o inglês em 31 idiomas
- Prompting de contexto: passe nomes e jargões para que ele os escreva corretamente
- Perguntas e respostas sobre áudio (somente em inglês)
No Open ASR Leaderboard, atualizado em 28 de outubro de 2026, ele pontua um WER médio de 5,33%. Isso o coloca em 9º de 61 modelos. Os oito acima dele (Otter, Zoom Scribe v2 Pro, ElevenLabs Scribe v2, Azure Speech e outros) são todos APIs fechadas e pagas. Entre os modelos que você pode baixar, nada tem classificação superior. O whisper-large-v3 da OpenAI está em 41º com 7,16%.
O próprio model card da NVIDIA reporta WER médio de 4,71% nos nove conjuntos públicos. Os 5,33% do leaderboard adicionam dois conjuntos privados, então ambos os números são honestos; eles medem misturas diferentes.
Um limite para saber antes de começar: é um modelo offline. Ele transcreve arquivos gravados, não um fluxo de microfone ao vivo.
Todas as rotas gratuitas e pagas comparadas
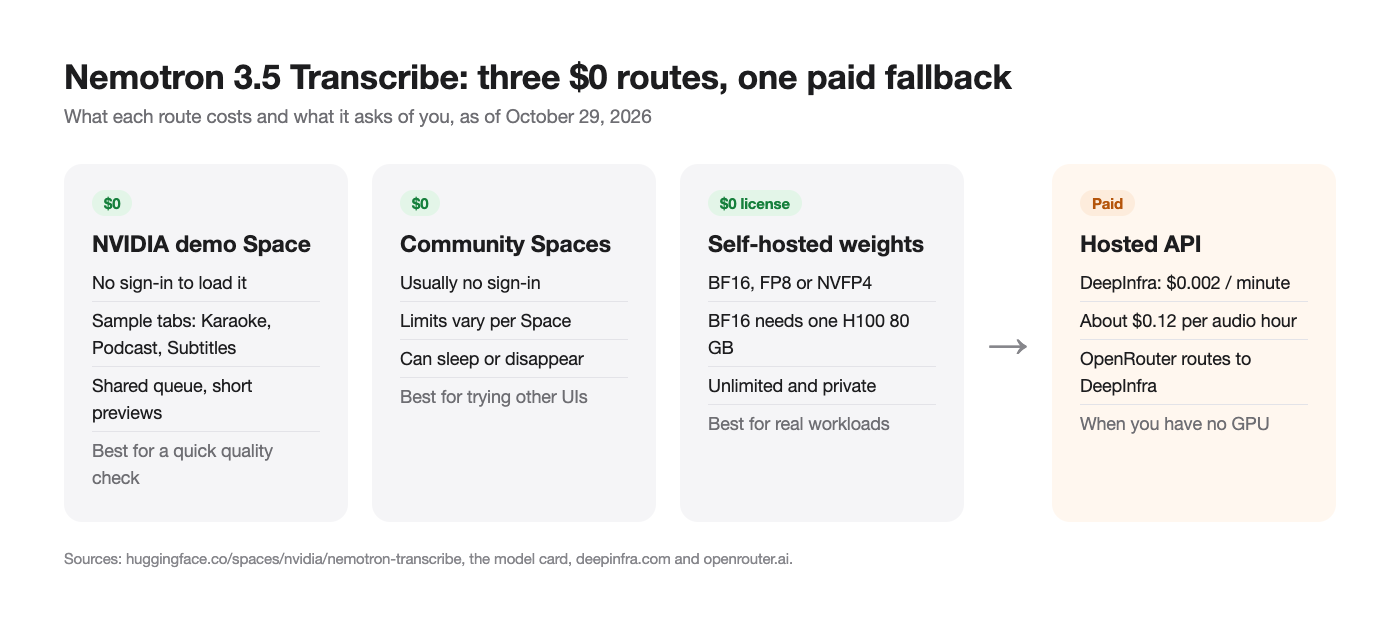
| Rota | Custo | Login | Limites | Ideal para |
|---|---|---|---|---|
Space de demonstração da NVIDIA (nvidia/nemotron-transcribe) |
$0 | Não | Prévia de 60 segundos nas abas de amostra; fila compartilhada | Uma verificação rápida de qualidade |
| Spaces da comunidade | $0 | Geralmente não | Varia por Space; pode dormir ou desaparecer | Experimentar outras interfaces |
| Pesos auto-hospedados (BF16, FP8, NVFP4) | $0 de licença, sua GPU | Conta no Hugging Face para baixar | Uma H100 80 GB para BF16; placas menores precisam de FP8 ou NVFP4 | Transcrição privada ilimitada |
| API da DeepInfra | $0,002 por minuto | Conta e chave de API | Uso pago | Produção sem GPUs |
| OpenRouter | $0,000033 por segundo | Conta e créditos | Roteado apenas para a DeepInfra | Uma chave para muitos modelos |
| build.nvidia.com | Ainda não listado | n/a | n/a | Fique de olho |
Apenas as três primeiras linhas não custam nada.
Rota gratuita 1: o Space de demonstração da NVIDIA
A maneira mais rápida de ouvir o que o modelo pode fazer é o Space oficial da NVIDIA em huggingface.co/spaces/nvidia/nemotron-transcribe.
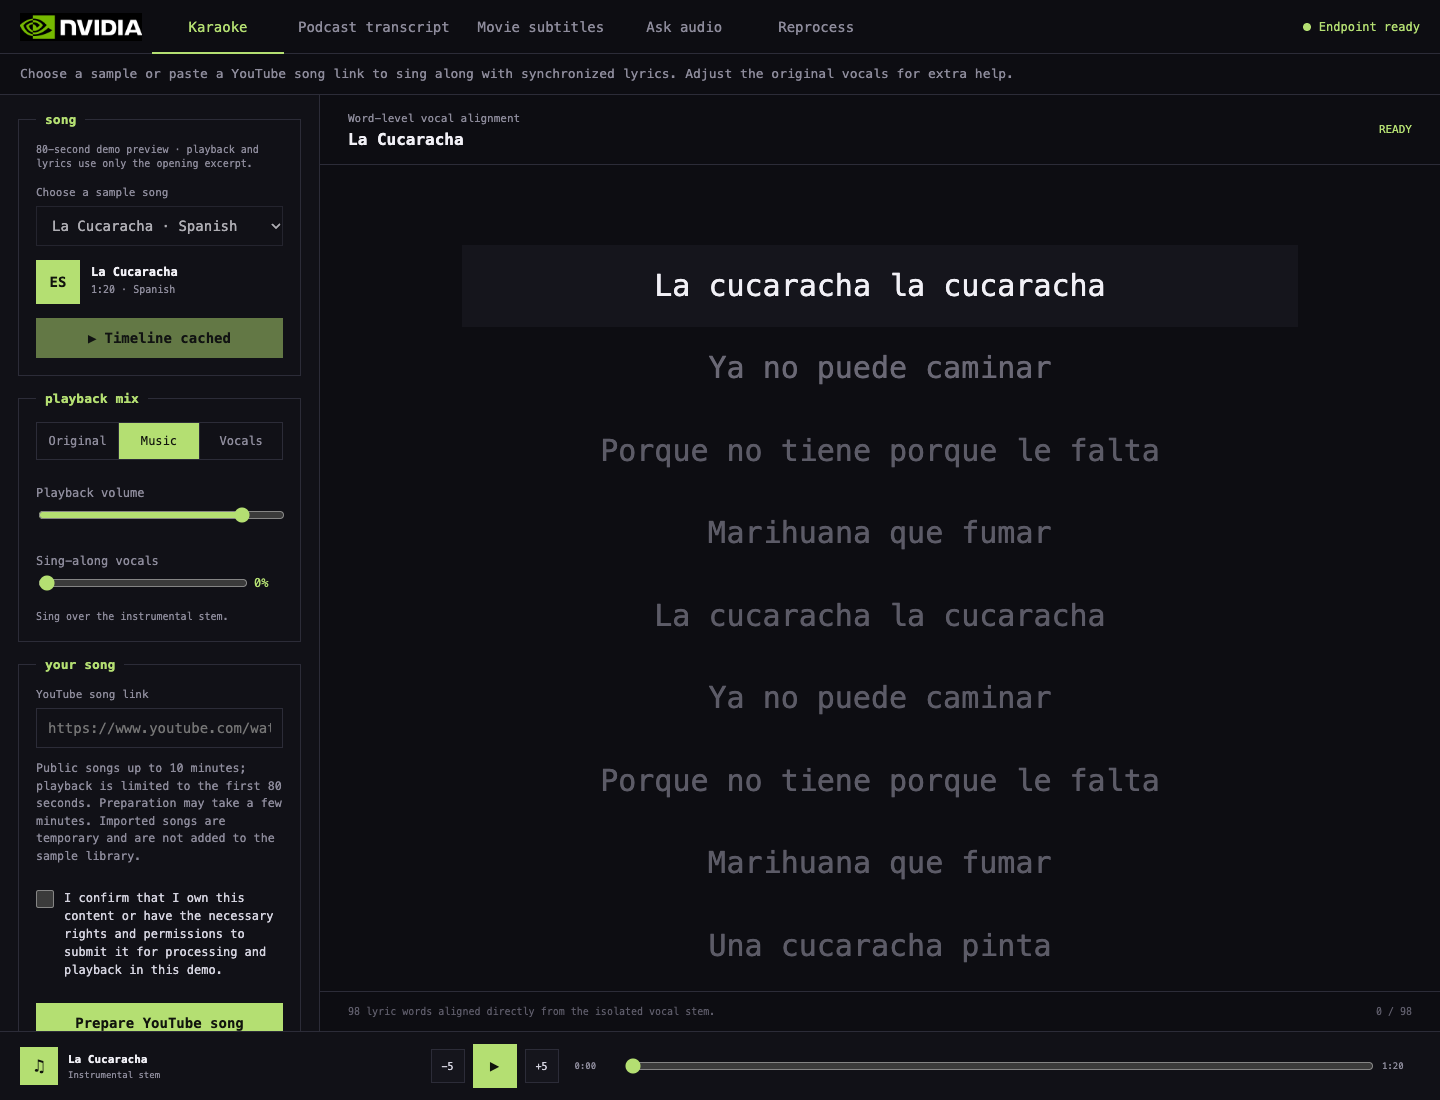
- Abra o Space no seu navegador. Nenhuma conta é necessária para carregá-lo.
- Escolha uma aba. Em 29 de outubro de 2026, o Space tinha três: Karaoke (letras com tempo por palavra), Podcast transcript (texto com atribuição de locutor) e Movie subtitles (legendas com tempo).
- Escolha uma amostra ou cole um link, conforme a aba permite. A aba Karaoke observa que sua prévia cobre os primeiros 60 segundos.
- Execute e leia a saída. A visualização do Karaoke destaca cada palavra conforme é cantada, o que mostra os timestamps por palavra.
Trate o Space como uma demonstração, não como uma API gratuita. Spaces públicos compartilham GPUs, enfileiram requisições e podem mudar sem aviso. Não construa um produto sobre um deles.
Rota gratuita 2: execute os pesos abertos você mesmo
Este é o verdadeiro nível gratuito: transcrição ilimitada no hardware que você já tem, sem nada sair da sua máquina. A licença (OpenMDW-1.1) permite uso comercial, então você pode distribuí-lo dentro de um produto.
O problema é o hardware. A configuração de referência da NVIDIA é uma H100 80 GB em BF16. A tabela de compatibilidade no model card lista:
- BF16: H100, H200, A100 80 GB, B200, GB200, DGX Spark
- FP8: H100, H200, L40S 48 GB
- Somente NVFP4: RTX 5090 (32 GB) e RTX PRO 6000 Blackwell
Então uma RTX 5090 de consumidor funciona, com o checkpoint NVFP4. Placas mais antigas de 24 GB como a RTX 4090 não estão na lista.
O teste mais rápido precisa apenas do Transformers instalado a partir do código-fonte:
pip install git+https://github.com/huggingface/transformers
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")

inputs = processor.apply_transcription_request("meeting.wav").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=1024)
print(processor.decode(outputs[:, inputs.input_ids.shape[1]:], skip_special_tokens=True))
Isso é suficiente para alguns arquivos. Para lotes, gravações longas e um endpoint compatível com OpenAI, sirva-o com vLLM 0.32.0 e o plugin NeMo Speech. Nosso guia passo a passo para executar o Nemotron 3.5 Transcribe localmente tem a instalação exata e o comando vllm serve do model card.
Sem GPU local? Alugar uma por hora é a rota "quase gratuita" mais barata para grandes acumulações. A NVIDIA diz que uma RTX PRO 6000 Blackwell pode processar 100 horas de áudio em menos de três minutos com a build NVFP4, embora esse número use otimizações de serving que ainda não são de código aberto.
Rota gratuita 3: Spaces da comunidade
A página do modelo lista vários Spaces da comunidade construídos sobre o mesmo checkpoint, incluindo hugging-apps/nemotron-3-5-transcribe e mrfakename/nemotron-3.5-transcribe. Eles são úteis quando a fila do Space da NVIDIA está longa ou você quer uma caixa de upload simples. Eles são administrados por indivíduos, então espere pausas, cotas e o eventual link morto.
Prompts que obtêm melhores resultados gratuitos
O Nemotron 3.5 Transcribe aceita instruções em linguagem natural. Estas vêm do model card e da listagem da DeepInfra. Mantenha o system prompt vazio para transcrição e use temperatura 0.
Texto limpo e legível:
Audio transcription. Language: as spoken. Wording: omit fillers and accidental repetitions; keep the remaining spoken wording unchanged. Formatting: punctuation and capitalization. Output: transcript only.
Quem disse o quê:
Transcribe verbatim, including fillers. Write numbers as spoken, without punctuation or capitalization. Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. Output only the speaker-tagged transcript.
Nomes de produtos e jargões:
Transcribe with punctuation and capitalization. Context terms: Apidog, OpenAPI, Kubernetes, gRPC.
Tradução:
Please translate the given speech to English.
Os termos de contexto importam mais do que você esperaria. No benchmark ContextASR da NVIDIA, o WER cai de 3,33% sem contexto para 1,71% com contexto refinado.
Quando o gratuito não é suficiente: a rota paga mais barata
Se você não tem uma GPU compatível e precisa de mais do que uma demonstração, a API hospedada é barata. A $0,002 por minuto da DeepInfra, uma gravação de uma hora custa $0,12, e 1.000 horas custam $120. Os $0,000033 por segundo da OpenRouter dão cerca de $0,119 por hora, roteados para o mesmo provedor.
Uma requisição mínima à DeepInfra, retirada da sua página de API:
curl -X POST \
  -H "Authorization: bearer $DEEPINFRA_API_KEY" \
  -F audio=@meeting.mp3 \
  'https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B'
A resposta inclui text, segments com horários de início e fim, words e o language detectado. Nosso guia da API percorre chaves, campos de resposta e custos em detalhes.
Deixe seu agente de codificação testar o endpoint com o Apidog CLI
Quer você auto-hospede ou use a DeepInfra, você quer uma verificação que falhe ruidosamente quando uma transcrição voltar vazia ou no idioma errado. Passe essa tarefa para o seu agente de codificação e o Apidog CLI em vez de olhar o JSON manualmente.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code, Codex, Cursor or OpenCode
Depois dê ao seu agente um prompt:
In Apidog project <id>, create a test case for POST {{baseUrl}}/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
that uploads samples/hello.mp3 as the "audio" form field, asserts status 200, a non-empty "text",
"language" equal to "en", and at least one item in "words", then run it against the
deepinfra environment and summarize any failures.
O agente lê o schema, valida seu payload, escreve o caso e o executa:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Troque o ambiente para apontar para o seu servidor local quando você migrar da API para a auto-hospedagem. O mesmo apidog run com -r junit entra no CI; veja executando o Apidog CLI em um pipeline de CI/CD e Apidog CLI no Claude Code para a configuração.
Limites para saber antes de confiar nele
- Somente offline. Ele não faz streaming. A NVIDIA aponta para um modelo separado, o Nemotron 3.5 ASR Streaming, para áudio ao vivo.
- Perguntas e respostas sobre áudio são somente em inglês. A transcrição cobre 40 idiomas, mas a compreensão de áudio e as instruções faladas foram avaliadas apenas em inglês.
- Rótulos de locutor não são identidades.
<spk:0>significa "a primeira voz", não uma pessoa nomeada. - Saídas longas precisam de espaço. Uma conversa densa de uma hora pode produzir cerca de 20.000 tokens de saída, então defina
max_new_tokensde acordo. - Ele pode alucinar. O card avisa que ele pode "gerar uma transcrição plausível" para áudio pouco claro. Revise qualquer coisa jurídica ou médica.
FAQ
O Nemotron 3.5 Transcribe é gratuito para uso comercial? Sim. A licença OpenMDW-1.1 permite uso comercial e não comercial dos pesos. As APIs hospedadas cobram pela computação.
Existe uma chave de API gratuita do Nemotron 3.5 Transcribe? Nenhuma que encontramos em 29 de outubro de 2026. A DeepInfra e a OpenRouter são pagas, e ele ainda não está em build.nvidia.com. Compare isso com a API gratuita da NVIDIA para o Nemotron Nano 12B v2 VL, que recebeu um endpoint de teste gratuito.
Posso executá-lo em um Mac? Não pela lista oficial. Os runtimes suportados visam GPUs NVIDIA em Linux ou Windows (WSL2). O suporte a GGML está listado apenas para RTX 5090 e RTX PRO 6000.
Como ele se compara ao Whisper? No leaderboard de 28 de outubro, ele tem média de 5,33% de WER contra 7,16% do whisper-large-v3. Veja nosso guia da API do Whisper para a opção hospedada da OpenAI e nosso ranking dos melhores modelos de fala para texto de código aberto para o campo completo.
Ele suporta MP3? Sim. Ele aceita WAV, FLAC, MP3, OGG ou qualquer coisa que decodifique para PCM mono de 16 kHz. Use o FFmpeg para converter outros formatos.
A conclusão
O Nemotron 3.5 Transcribe é gratuito onde importa: os pesos, a licença e a demonstração da NVIDIA. Experimente o Space para uma verificação de qualidade, auto-hospede em uma H100, L40S ou RTX 5090 para uso privado ilimitado, e recorra à DeepInfra a $0,12 por hora quando você não tiver o hardware. Qualquer que seja a rota escolhida, deixe seu agente executar verificações do Apidog no endpoint para que uma transcrição ruim nunca chegue à produção.