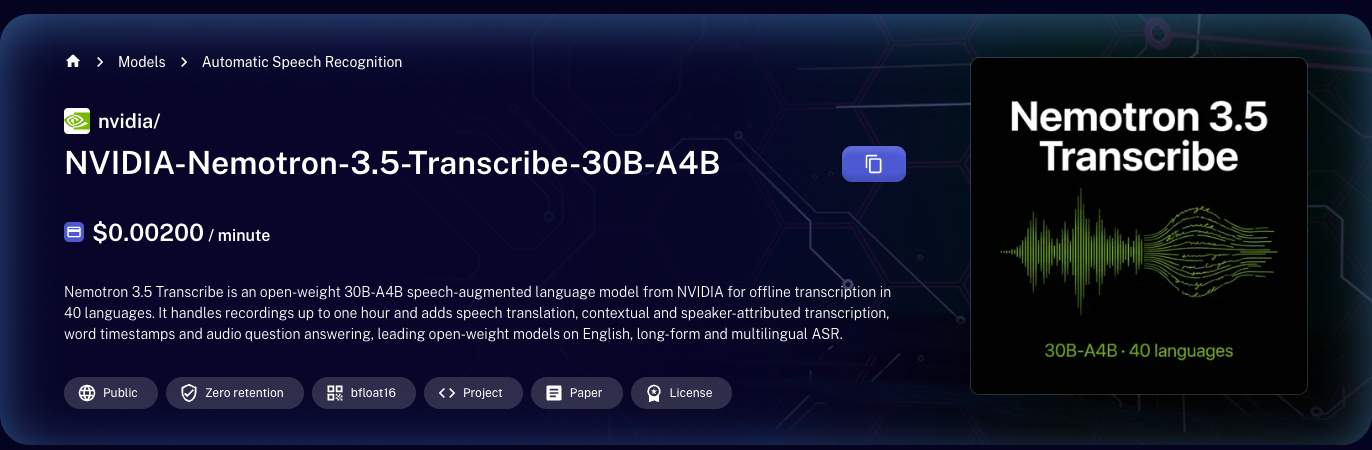
Transcrever uma gravação de uma hora com a nova API Nemotron 3.5 Transcribe da NVIDIA custa 12 centavos. Esse é o preço da DeepInfra de $0.002 por minuto para o principal modelo de pesos abertos no Hugging Face Open ASR Leaderboard, um modelo que também retorna carimbos de data/hora de palavras, rótulos de falante e o idioma detectado na mesma chamada.
Este guia mostra como obter uma chave de API, enviar sua primeira solicitação, ler a resposta, escrever prompts para rótulos de falante e jargões, e manter os custos previsíveis. Tudo abaixo foi verificado em 29 de outubro de 2026 na página do modelo DeepInfra, na listagem do OpenRouter e no cartão de modelo oficial.
Procurando uma rota de $0? Leia como usar o Nemotron 3.5 Transcribe gratuitamente.
O que a API Nemotron 3.5 Transcribe oferece a você
A NVIDIA lançou o Nemotron 3.5 Transcribe (NVIDIA-Nemotron-3.5-Transcribe-30B-A4B) em 28 de outubro de 2026. É um modelo de fala de pesos abertos com 34B de parâmetros totais e cerca de 4,3B ativos, construído sobre um modelo de linguagem híbrido Mamba-2 e Transformer de mistura de especialistas com um codificador ASR e um codificador de falante acoplados.
De um único endpoint você obtém:
- Transcrição em 40 idiomas
- Arquivos de até uma hora de duração
- Carimbos de data/hora de palavras e carimbos de data/hora de segmentos
- Transcrições com atribuição de falante com até oito falantes
- Tradução de fala entre 31 idiomas de e para o inglês
- Prompting de contexto para nomes, produtos e jargões
- Identificação de idioma
No Open ASR Leaderboard (atualizado em 28 de outubro de 2026), ele tem média de 5,33% de WER, 9º de 61 modelos e primeiro entre modelos com pesos públicos. Os oito modelos acima dele são APIs comerciais fechadas.
É um modelo offline. Envie arquivos gravados, não um fluxo ao vivo.
Onde chamá-lo e quanto custa
Com essas tarifas, 1.000 horas de áudio custam cerca de $120. Para comparação, a API OpenAI Whisper historicamente cobrou $0.006 por minuto, três vezes o preço da DeepInfra, e whisper-large-v3 ocupa a 41ª posição no mesmo leaderboard com 7,16% de WER.
Passo 1: obtenha uma chave de API da DeepInfra
- Crie uma conta em deepinfra.com.
- Abra o painel e crie uma chave de API.
- Adicione um método de pagamento ou créditos. A página do modelo exige login até para a demonstração no navegador.
- Exporte a chave no seu shell:
export DEEPINFRA_API_KEY="your_key_here"
Mantenha a chave fora do controle de versão. Se você trabalha com um agente de codificação, coloque-a no ambiente do agente, não em um prompt.
Passo 2: transcreva seu primeiro arquivo
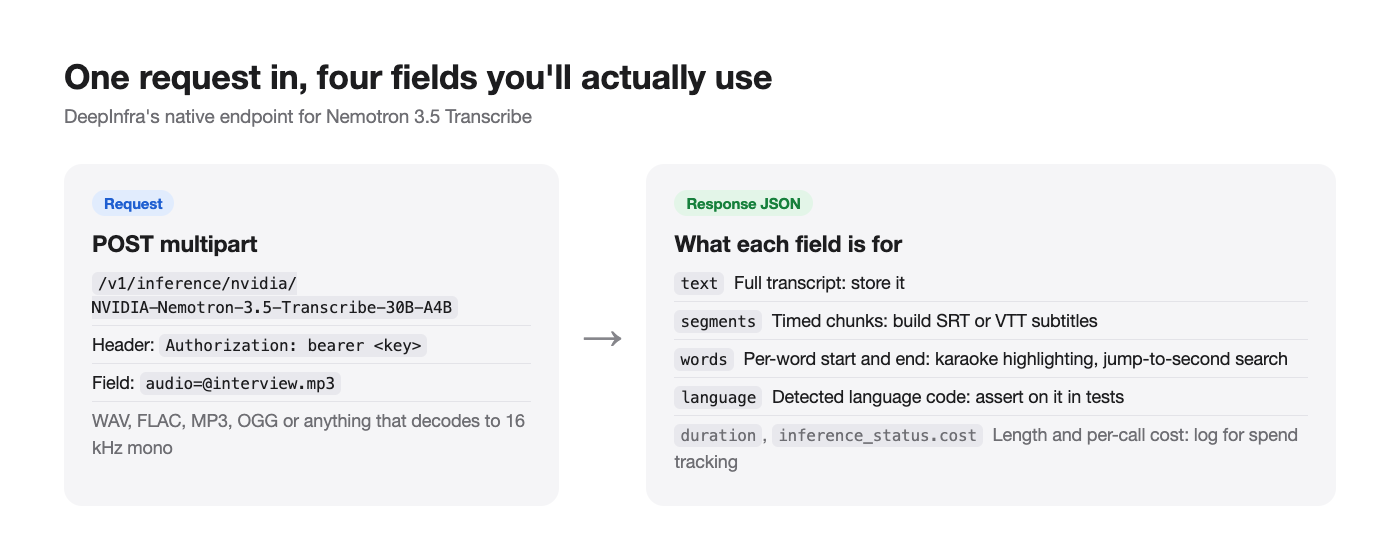
O endpoint de inferência nativo da DeepInfra aceita um upload multipart com um campo audio. Esta é a forma exata da requisição da página da API:
curl -X POST \
  -H "Authorization: bearer $DEEPINFRA_API_KEY" \
  -F audio=@interview.mp3 \
  'https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B'
O modelo aceita WAV, FLAC, MP3, OGG ou qualquer formato que decodifique para PCM mono de 16 kHz. Se você tem arquivos M4A ou de vídeo, converta-os com FFmpeg primeiro:
ffmpeg -i call.m4a -ar 16000 -ac 1 call.wav
Passo 3: leia a resposta
A DeepInfra documenta este formato de resposta (os valores abaixo são ilustrativos):
{
  "text": "Hello World",
  "segments": [
    { "id": 0, "start": 0.0, "end": 1.0, "text": "Hello" },
    { "id": 1, "start": 4.0, "end": 5.0, "text": "World" }
  ],
  "language": "en",
  "words": [
    { "start": 0.0, "end": 1.0, "text": "Hello" },
    { "start": 4.0, "end": 5.0, "text": "World" }
  ],
  "duration": 5.0,
  "inference_status": { "status": "succeeded", "runtime_ms": 0, "cost": 0.0 }
}
Para que serve cada campo:
texté a transcrição completa. Armazene isto.segmentsfornece blocos com tempo. Use-os para legendas (SRT ou VTT).wordsfornece o tempo por palavra. Use-o para destaque estilo karaokê ou busca que salta para o segundo exato.languageé o código do idioma detectado. Faça asserções sobre ele nos testes; um idioma errado é uma falha comum em clipes curtos.inference_status.costinforma quanto custou a chamada. Registre-o para acompanhar os gastos por arquivo.
Passo 4: chame-o do Python
import os
import requests

URL = "https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"

def transcribe(path: str) -> dict:
    with open(path, "rb") as f:
        r = requests.post(
            URL,
            headers={"Authorization": f"bearer {os.environ['DEEPINFRA_API_KEY']}"},
            files={"audio": f},
            timeout=600,
        )
    r.raise_for_status()
    return r.json()

result = transcribe("interview.mp3")
print(result["language"], len(result["words"]), "words")
print(result["text"][:500])
Defina um timeout longo. Uma hora completa de fala densa pode gerar cerca de 20.000 tokens de saída, e o cartão do modelo avisa que trabalhos longos levam tempo.
A DeepInfra também lista uma aba “OpenAI Speech-to-Text” para o modelo, então código do SDK da OpenAI que chama audio.transcriptions provavelmente pode apontar para a URL base compatível com OpenAI da DeepInfra. Verifique essa aba para obter a URL base exata antes de mudar o código de produção.
Prompts: literal, limpo, falantes, jargão
O que diferencia o Nemotron 3.5 Transcribe das APIs ASR mais antigas é que ele aceita instruções. Os prompts recomendados pela NVIDIA, conforme listados na página da DeepInfra:
| Você quer | Instrução |
|---|---|
| Palavras literais | Audio transcription. Language: as spoken. Wording: verbatim, including fillers and repetitions. Formatting: punctuation and capitalization. Output: transcript only. |
| Texto legível | Audio transcription. Language: as spoken. Wording: omit fillers and accidental repetitions; keep the remaining spoken wording unchanged. Formatting: punctuation and capitalization. Output: transcript only. |
| Vocabulário de domínio | Transcribe with punctuation and capitalization. Context terms: <names and terms>. |
| Quem disse o quê | Transcribe verbatim, including fillers. ... Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. |
| Tradução | Please translate the given speech to <target language>. |
Use temperatura 0 com raciocínio desativado para transcrição, tradução e identificação de idioma, e mantenha o prompt do sistema vazio.
Termos de contexto valem a pena. A NVIDIA relata que o WER do ContextASR-Bench cai de 3,33% sem contexto para 1,71% com contexto refinado, e o Earnings22 contextual de 12,54% para 9,58%. Para uma chamada de resultados, passe os nomes das empresas, tickers e nomes dos executivos.
Verifique a aba de esquema de entrada da DeepInfra para o campo que carrega a instrução no endpoint nativo. Em um servidor auto-hospedado, a instrução vai na mensagem de chat ao lado do áudio, como mostrado em nosso guia de configuração local.
Usando OpenRouter em vez disso
Se você já usa o OpenRouter para LLMs, pode manter uma chave e uma fatura. O ID do modelo é nvidia/nemotron-3.5-transcribe, com preço de $0.000033 por segundo, com a DeepInfra como único provedor listado em 29 de outubro de 2026 (100% de uptime, cerca de um segundo de latência naquele momento). Copie o formato da requisição da aba de API do modelo no OpenRouter, já que endpoints de áudio diferem de conclusões de chat.
A desvantagem: o OpenRouter adiciona um salto de rede, e hoje não há failover de provedor porque apenas um provedor atende o modelo.
Mantenha os custos previsíveis
- Corte o silêncio primeiro. Você paga por minuto de áudio, não por minuto de fala. Cortar o silêncio das gravações reduz a conta.
- Faça downmix e reamostragem. 16 kHz mono é o que o modelo usa de qualquer forma; enviar estéreo 48 kHz só adiciona tempo de upload.
- Agrupe por arquivo, não por bloco. O modelo lida com uma hora em uma requisição. Dividir um arquivo em pedaços de 30 segundos quebra os rótulos de falante e o contexto.
- Registre
inference_status.cost. Some por cliente ou por trabalho. - Auto-hospede acima de volume constante. O NIM otimizado da NVIDIA processa até 2.238 segundos de áudio por segundo em uma RTX PRO 6000 Blackwell. Se você transcreve milhares de horas por mês, uma GPU alugada supera o preço por minuto. Observe que o caminho de código aberto vLLM deve ser cerca de duas vezes mais lento que esse número do NIM.
Deixe seu agente de codificação testá-lo com o Apidog CLI
APIs de transcrição falham silenciosamente: um 200 com text vazio, um clipe em espanhol detectado como português, ou words ausente após uma atualização do provedor. Em vez de verificar o JSON manualmente, deixe seu agente de codificação escrever e executar as verificações com o Apidog CLI.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Então dê ao seu agente um prompt:
In Apidog project <id>, add the DeepInfra endpoint POST
https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
with a multipart "audio" field and a bearer token from {{DEEPINFRA_API_KEY}}.
Create a test case per file in samples/ (en.mp3, es.mp3, two-speakers.wav) asserting
status 200, non-empty "text", the expected "language", and "words" length > 0.
Run them against the prod environment and report failures with the response body.
O agente lê o esquema, valida seu payload, escreve os casos e os executa:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Adicione -r junit e o mesmo comando se torna um portão de CI. Veja Apidog CLI em um pipeline de CI/CD e Apidog CLI no Claude Code para a configuração completa.
Perguntas frequentes
Qual é o preço da API Nemotron 3.5 Transcribe? $0.002 por minuto na DeepInfra e $0.000033 por segundo no OpenRouter, em 29 de outubro de 2026. Isso dá cerca de $0.12 por hora de áudio em qualquer um dos dois.
Existe uma chave de API gratuita? Não encontramos uma. O modelo ainda não está em build.nvidia.com. As rotas gratuitas são o Space de demonstração da NVIDIA e a auto-hospedagem; veja o guia gratuito.
Qual é o comprimento máximo do arquivo? Uma hora por requisição, com um contexto de 65.536 tokens.
A API transmite resultados? Não. É um modelo offline que retorna a transcrição quando o arquivo termina.
Quais idiomas são suportados? 40, classificados em três níveis. Os 13 idiomas “líderes” incluem inglês, espanhol, francês, alemão, italiano, português, hindi, coreano, russo e polonês. Japonês, turco e ucraniano são “prontos para produção”. Mandarim chinês e árabe são “suportados”.
Como ele se compara a outras APIs de fala? Veja nosso ranking de melhores modelos de fala para texto de código aberto e a compilação mais antiga de principais APIs de texto para fala e fala para texto.
Comece a transcrever
Obtenha uma chave da DeepInfra, envie um curl com um MP3, e você receberá de volta texto com marcação de tempo e idioma por $0.002 por minuto. Adicione termos de contexto para seu domínio, use o prompt de falante para reuniões, e faça seu agente executar verificações do Apidog a cada lançamento para que uma regressão silenciosa nunca seja lançada.