
A Mistral esteve quieta no topo por um tempo. O Mistral Large 3 foi lançado em dezembro de 2025 e, desde então, a conversa sobre modelos de fronteira de pesos abertos tem sido sobre Kimi, DeepSeek, GLM e Qwen. Em 6 de outubro de 2026, a Mistral respondeu com o Mistral Large 4, um modelo de 1 trilhão de parâmetros que a equipe chama de “Le Chonk”.
O número de destaque é um benchmark de segurança cibernética onde o Large 4 atinge 82%, enquanto o Claude Opus 5.5 e o GPT-6 Astra marcam perto de zero. Isso é verdade, está na página de lançamento da Mistral, e precisa de uma frase de contexto antes que você o compartilhe. Este artigo fornece esse contexto, as especificações, o preço real e onde o Large 4 ainda perde.
TL;DR
- O que é: um modelo de mistura de especialistas com 1,05T parâmetros, com 49B parâmetros ativos, um codificador de visão de 1,6B, entrada de texto e imagem, e uma janela de contexto de 1M tokens.
- Onde obtê-lo: prévia pública na API da Mistral hoje como
mistral-large-4. Pesos “até o final do mês”, ou seja, por volta de 27 de outubro. - Preço: $1,36 entrada / $4,18 saída por milhão de tokens no preço de tabela, atualmente mostrado como **$0,68 / $2,09** durante a prévia. Entrada em cache é $0,07.
- A vitória cibernética: 82% no teste de reprodução de vulnerabilidades do AA Cyber Index. Opus 5.5 e Astra marcam perto de zero **porque recusam a tarefa**, não porque falham nela.
- A verdadeira perda: na codificação avaliada por humanos, Claude Opus 5 marcou 4,22 e Large 4 marcou 3,74.
Por que “Mistral está de volta” é justo
Durante a maior parte de 2026, os modelos de pesos abertos mais fortes vieram da China. A Mistral continuou lançando, com o Medium 3.5, Devstral 2 e Small 4, mas nada que competisse com os modelos fechados de fronteira em seu próprio território.
O Large 4 muda o cenário. A Mistral afirma que ele “supera significativamente qualquer modelo de pesos abertos desenvolvido nos EUA ou na Europa”, e ela sustenta isso com uma história de treinamento construída para o público da soberania da UE. O modelo foi treinado do zero em 3.800 GPUs NVIDIA Grace Blackwell nos próprios datacenters europeus da Mistral, cobre mais de 160 idiomas, incluindo todos os idiomas oficiais da UE, e chega semanas após uma rodada da Série D de €3 bilhões que a Mistral chama de a maior rodada de capital já levantada por uma empresa de tecnologia europeia.
O timing também importa. O Large 4 chegou logo depois que a Reflection revelou seu modelo de pesos abertos Beam, então a corrida de modelos abertos EUA-vs-China agora tem um terceiro participante sério.
O destaque cibernético e a pegadinha
Aqui está o resultado que todos estão tirando prints. O Artificial Analysis Cyber Index inclui um teste que pede a um modelo para reproduzir uma vulnerabilidade real em software de código aberto e depois corrigi-la. A Mistral diz que o Large 4 atinge **82%, o mais alto de qualquer modelo**.
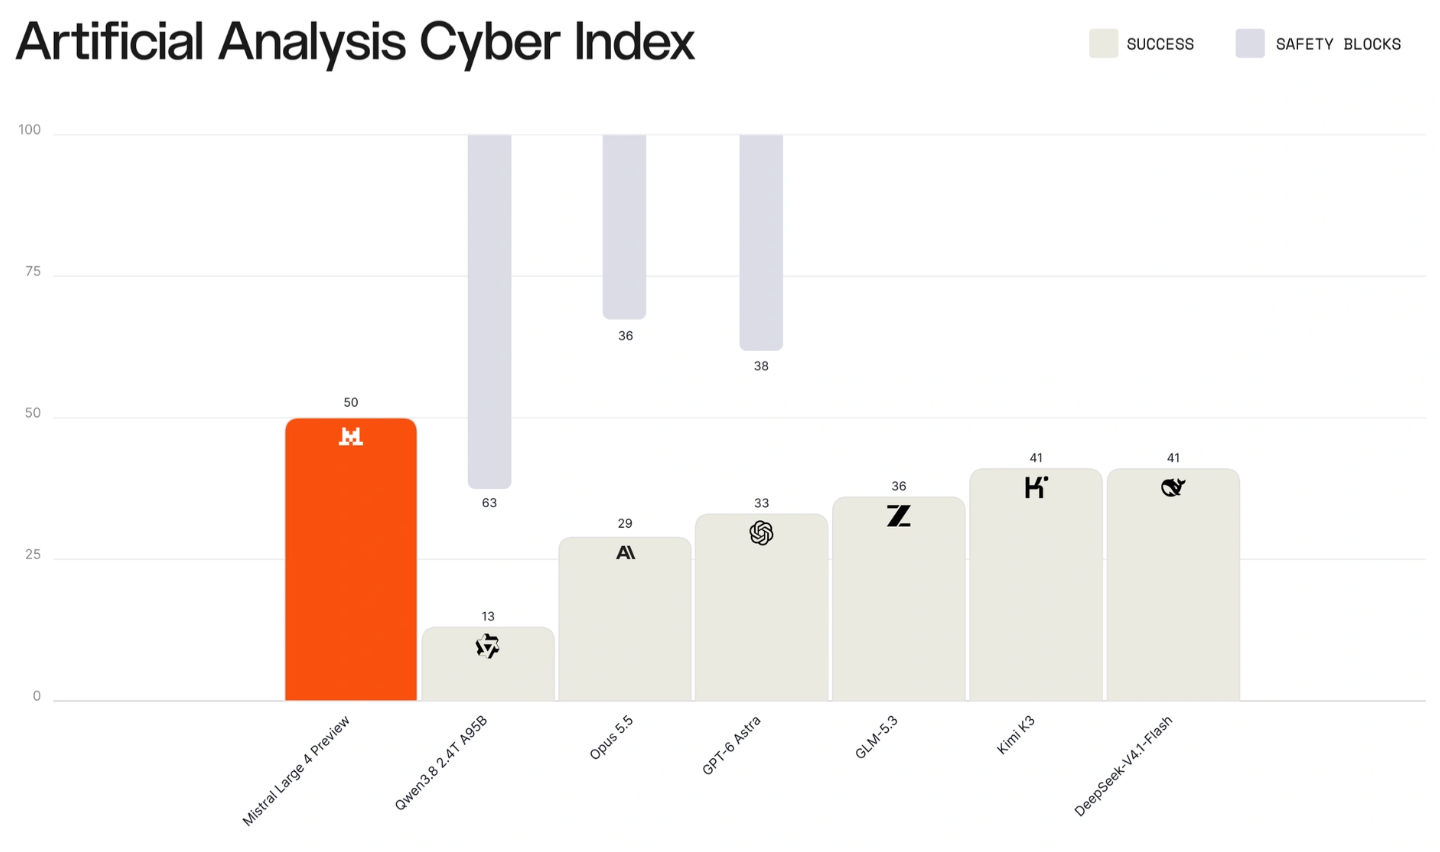
Então a pegadinha, nas próprias palavras da Mistral: “Vários modelos fechados líderes, incluindo Claude Opus 5.5 e GPT-6 Astra, marcam perto de zero no mesmo teste porque se recusam a executar a tarefa.”
Então leia assim:
| Afirmação | O que realmente significa |
|---|---|
| “Large 4 supera Astra e Opus 5.5 em segurança cibernética” | Neste teste, os modelos fechados se recusam a responder. O Large 4 responde e geralmente tem sucesso. |
| “Large 4 é o melhor modelo de hacking” | Não estabelecido. Uma recusa é uma escolha de política, não um teto de capacidade. |
| “Large 4 é inseguro” | Também não estabelecido. A Mistral relata que sua taxa média de recusa em prompts cibernéticos de JailbreakBench, StrongREJECT e AgentHarm é maior do que qualquer outro modelo de pesos abertos. |
Há uma capacidade real por trás da manchete. O Large 4 também resolve 93% do Cybench, um conjunto de 40 exercícios de captura de bandeira, que a Mistral chama de uma das pontuações mais altas relatadas para um modelo de pesos abertos. No B3 Agent Security Benchmark, ele resiste a 93,3% dos ataques.
Para equipes de segurança, essa combinação é a história real: um modelo que você pode hospedar em seu próprio servidor que ajudará a reproduzir e corrigir um CVE em seu próprio código, enquanto ainda recusa a maioria das solicitações claramente prejudiciais. Para equipes de API, essa é uma ferramenta útil para ter em seu próprio hardware, em vez de por trás do filtro de política de outra pessoa.
Onde o Large 4 supera o GPT-6 Astra fora da segurança cibernética
O resultado cibernético é o mais chamativo. Duas outras vitórias contra o Astra são mais discretas e significativas, porque ambos os modelos realmente tentaram a tarefa:
| Benchmark | Mistral Large 4 | GPT-6 Astra | Notas |
|---|---|---|---|
| Dense 200 (fundamentação visual) | 42% | 41% | Liderança de um ponto. Real, mas estreita. |
| Finance Agent v2 (vals.ai) | À frente | Atrás | A Mistral relata o ranking, não as pontuações. |
| Harvey Legal Agent Benchmark | Melhor modelo aberto | Listado | Nenhum número de confronto direto publicado. |
Contra outros modelos abertos, a diferença é maior:
| Benchmark | Mistral Large 4 | Quem ele supera |
|---|---|---|
| AutomationBench (657 workflows) | 59,9% | Kimi K3, DeepSeek V4 Pro |
| AA-Briefcase (trabalho de conhecimento) | 1.393 Elo | DeepSeek V4 Pro |
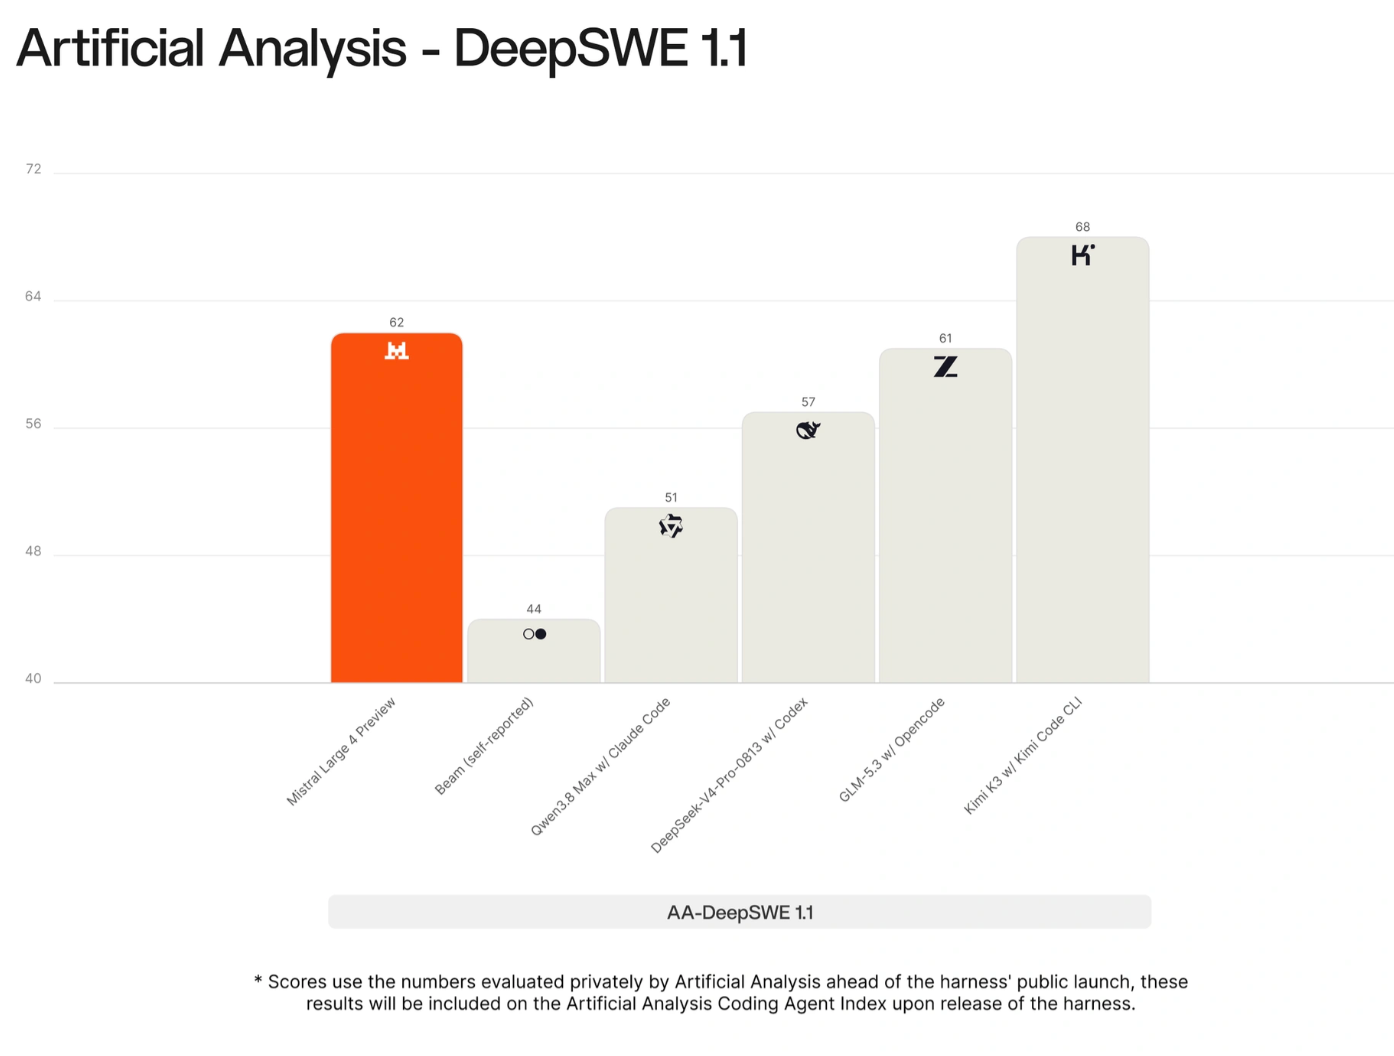
| DeepSWE v1.1 (codificação) | 61,7% | Lidera modelos de pesos abertos |
| SWE-Atlas-QnA | 59,4% | |
| Terminal-Bench 4.0 | 28,3% |
Todos esses são números relatados pela Mistral, de modelos de prévia. Nenhum laboratório independente os reexecutou ainda, e a Euronews relata que o aprendizado por reforço ainda estava sendo finalizado no lançamento. Trate-os como um forte sinal, não um veredito.
Onde ele ainda perde
A Mistral publicou um resultado onde um modelo fechado claramente vence. Em uma avaliação humana de qualidade de código executada pela Surge AI em cinco modelos, o Large 4 Preview ficou em segundo lugar:
| Modelo | Pontuação de codificação humana (de 5) |
|---|---|
| Claude Opus 5 | 4,22 |
| Mistral Large 4 Preview | 3,74 |
| GLM-5.3 | 3,60 |
| Kimi K3 | 3,59 |
| GLM-5.2 | 3,40 |
Essa é uma vitória clara sobre os melhores modelos abertos chineses, e uma diferença de meio ponto atrás de Claude. A própria fraseologia da Mistral é que o Large 4 está “diminuindo a lacuna” com os modelos de fronteira em codificação, o que é uma leitura honesta.
Também ausente: não há comparação com o Claude Fable 5.1 ou GPT-6 Sol em nenhum lugar nos materiais de lançamento. Se alguém lhe disser que o Large 4 supera o Fable, peça o benchmark.
Especificações em um relance
| Especificação | Mistral Large 4 |
|---|---|
| ID do modelo de API | mistral-large-4 (alias mistral-large-4-0) |
| Versão | 26.10, prévia pública |
| Arquitetura | Mistura de especialistas, instrução híbrida + raciocínio |
| Parâmetros | 1.05T total, 49B ativos, codificador de visão de 1.6B |
| Janela de contexto | 1M tokens |
| Entrada | Texto, imagens |
| Raciocínio | Parâmetro reasoning_effort ("high" ou "none") |
| Ferramentas | Chamada de função, saídas estruturadas, ferramentas de agente integradas |
| Endpoints | /v1/chat/completions, /v1/conversations, /v1/agents, /v1/batch |
| Pesos | Abertos, até o final de outubro de 2026; licença ainda não publicada |
Preço: o modelo de classe de fronteira mais barato que você pode chamar hoje
Esta é a parte que deve fazer as equipes de API prestarem atenção. A página de preços da Mistral lista o Large 4 pela metade do preço de tabela durante a prévia:
| Modelo | Entrada / 1M | Saída / 1M | Pesos abertos |
|---|---|---|---|
| Mistral Large 4 (preço de prévia) | $0,68 | $2,09 | Sim, final de outubro |
| Mistral Large 4 (preço de tabela) | $1,36 | $4,18 | Sim, final de outubro |
| Claude Opus 5.5 | $4,00 | $20,00 | Não |
| GPT-6 Astra | $10,00 | $50,00 | Não |
No preço de prévia, a saída do Large 4 custa aproximadamente um vinte e quatro avos do preço do Astra. Mesmo no preço de tabela, é cerca de 12 vezes mais barato na saída. A entrada em cache cai para $0,07 por milhão, o que é importante para agentes que reenviam o mesmo prompt de sistema e definições de ferramentas a cada turno.
A Mistral não informou quando o desconto da prévia termina, então faça o orçamento com base no preço de tabela.
Você deve mudar?
- Experimente agora se:
- Você executa fluxos de trabalho agentivos ou automação de trabalho de conhecimento e paga preços de fronteira. AutomationBench e AA-Briefcase sugerem que o Large 4 é competitivo aqui por uma fração do custo.
- Você precisa de saída multilíngue em idiomas da UE ou inferência hospedada na UE para conformidade.
- Você faz trabalho de segurança defensiva e continua encontrando recusas na reprodução legítima de vulnerabilidades.
- Você quer um modelo de classe de fronteira que poderá hospedar em seu próprio servidor em algumas semanas.
- Espere se:
- A qualidade do código é sua principal métrica. Claude ainda lidera na codificação avaliada por humanos.
- Você precisa de números que possa defender em uma revisão. Espere por benchmarks independentes após o lançamento dos pesos.
- Você usa o Large 3 em produção. A prévia ainda pode mudar, e a Mistral ainda não publicou um ID versionado estável.
Como testar o Large 4 em suas próprias APIs no Apidog
Benchmarks dizem como um modelo se sai nas tarefas de outras pessoas. A maneira mais rápida de decidir é executar o Large 4 em seus próprios prompts e compará-lo com o modelo pelo qual você paga hoje. O Apidog faz isso sem uma linha de código extra:
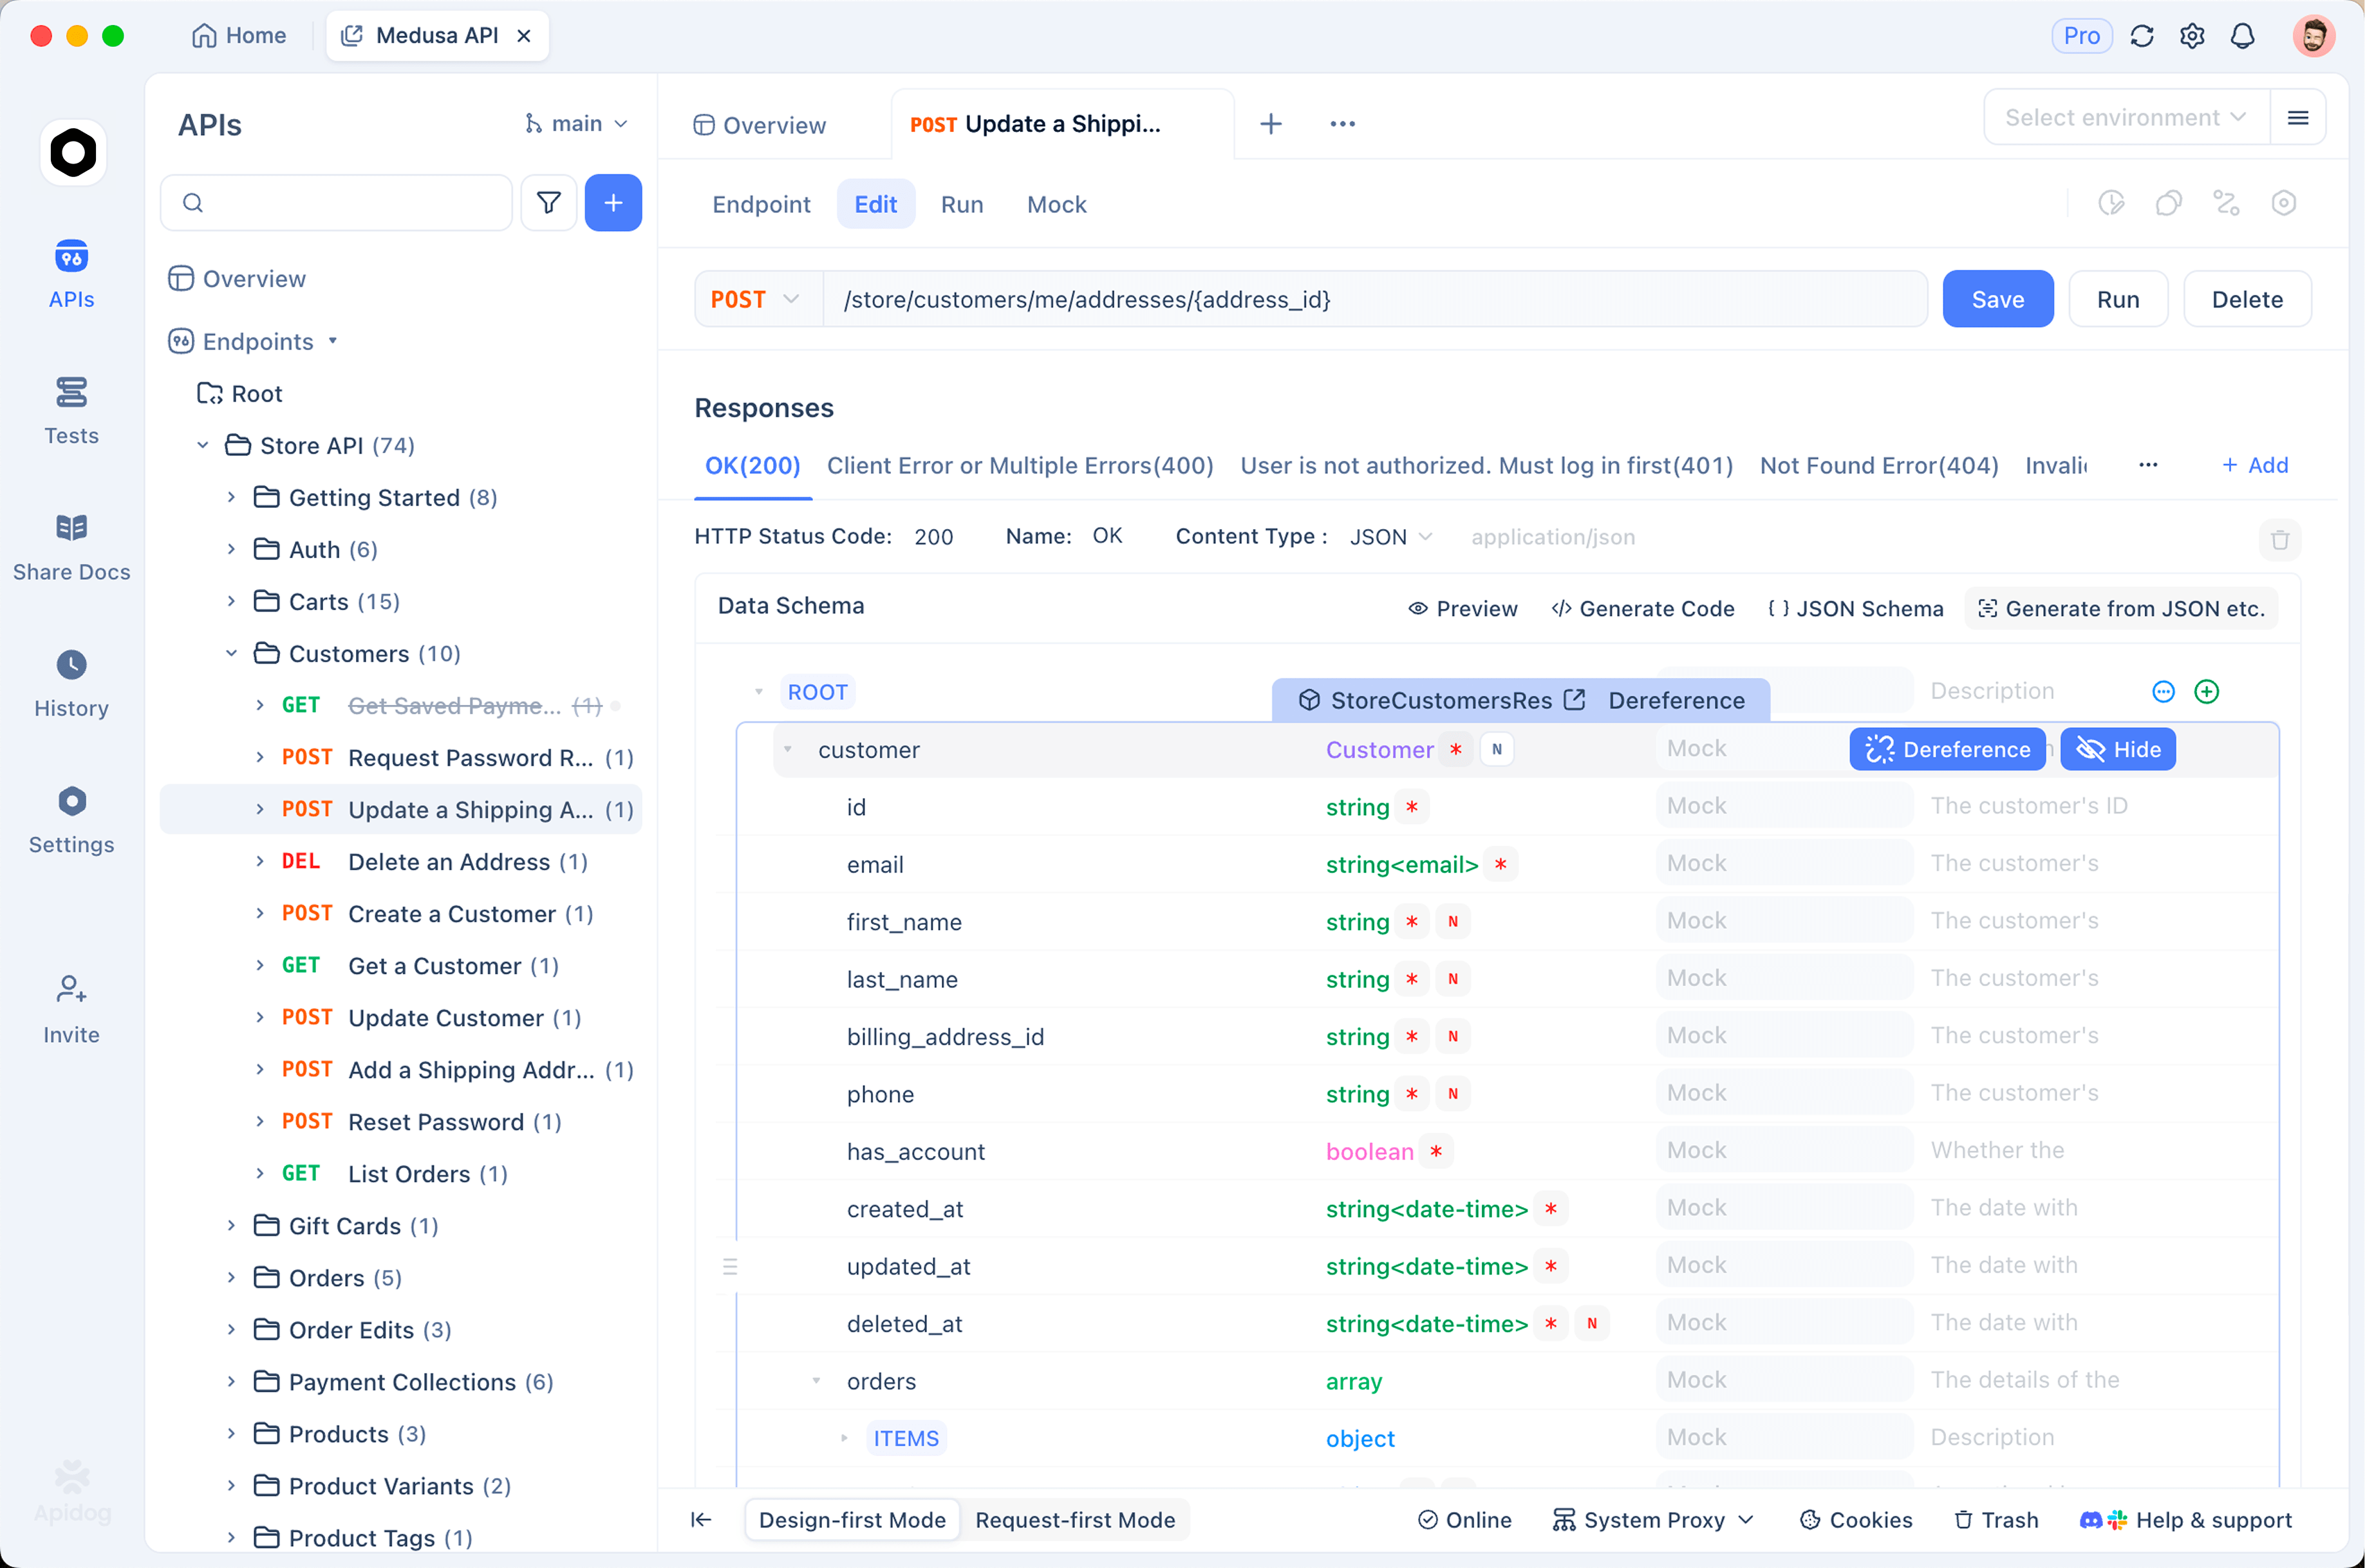
- Salve a solicitação uma vez. Crie
POST https://api.mistral.ai/v1/chat/completions, armazene sua chave como uma variável de ambiente e definaAuthorization: Bearer {{MISTRAL_API_KEY}}. - Clone-o por modelo. Duplique a solicitação, altere apenas o campo
model(mistral-large-4vs. seu modelo atual) e envie ambos. O Apidog mostra a resposta, status, latência e tamanho lado a lado, e o blocousagefornece a contagem de tokens para uma comparação de custo. - Adicione asserções. Verifique um status
200, uma resposta não vazia e uma correspondência de JSON Schema se você solicitar saída estruturada. Isso transforma um experimento único em um teste de regressão. - Reexecute-o a cada atualização do modelo. Agrupe as solicitações em um cenário de teste e reexecute-o quando a Mistral atualizar a prévia ou lançar os pesos. Você verá se a qualidade diminuiu antes que seus usuários o façam.
Duas forças do Large 4 se encaixam naturalmente no trabalho de API. Seus resultados de segurança o tornam um bom segundo revisor para testes de segurança de API, por exemplo, quando você reproduz um desvio de autenticação em sua própria API de staging. Sua chamada de função e saídas estruturadas permitem que você transforme uma especificação OpenAPI projetada no Apidog em definições de ferramentas que um agente pode chamar.
Para o passo a passo completo do código, incluindo chaves, blocos de raciocínio, imagens, chamada de função e cálculo de custo, consulte nosso guia da API Mistral Large 4. Vem de um modelo Mistral mais antigo? Os fundamentos da API Mistral AI e o guia da API Mistral Medium 3.5 ainda se aplicam: mesma URL base, mesma autenticação, novo ID de modelo.
Perguntas Frequentes
- O Mistral Large 4 é de código aberto? Ele é de pesos abertos. A Mistral diz que os pesos serão lançados até o final de outubro de 2026. A licença ainda não foi publicada, então não presuma que ela corresponda à Apache 2.0 do Large 3.
- O Mistral Large 4 realmente supera o GPT-6 Astra? Em fundamentação visual (42% vs 41%) e no Finance Agent v2, sim, pelos números da Mistral. No teste de vulnerabilidade cibernética, o Astra marca perto de zero porque se recusa, então essa não é uma vitória comparável.
- Ele supera o Claude? Não na codificação. Claude Opus 5 lidera a avaliação de codificação humana de 4,22 a 3,74. Claude Opus 5.5 também recusa a tarefa de reprodução cibernética, e é por isso que marca perto de zero lá.
- O que significa “Le Chonk”? É o apelido não oficial da Mistral para o modelo, uma piada sobre seu tamanho. O nome oficial é Mistral Large 4, ou ML4.
- Posso usá-lo gratuitamente? O plano gratuito da Mistral inclui $10 por mês em créditos de API e acesso aos seus modelos mais recentes no Le Chat e Vibe. No preço de prévia, $10 compram aproximadamente 4,8 milhões de tokens de saída no Large 4.
Conclusão
A Mistral está de volta à conversa de fronteira. O Large 4 é o modelo de pesos abertos mais forte de fora da China, pelos números da Mistral, custa uma fração do Astra ou Opus 5.5, e rodará em seu próprio hardware em semanas. A frase “supera Astra e Claude em segurança cibernética” é real, mas vem de recusas, e o veredito honesto de codificação é “segundo lugar para Claude”. Teste-o em suas próprias APIs no Apidog agora enquanto o preço de prévia durar, e adie sua decisão de produção até que benchmarks independentes cheguem após 27 de outubro.