
Os pesos abertos do Mistral Large 4 foram publicados no Hugging Face em 29 de outubro de 2026. Você recebe o mesmo modelo de 1,05T de parâmetros que a Mistral serve em sua API, sob uma licença MIT modificada, em checkpoints FP8 e NVFP4, além de quants GGUF da comunidade. Você pode baixá-lo sem etapa de aprovação, servi-lo em 8 GPUs de datacenter com vLLM ou SGLang, ou pular o hardware e chamar mistral-large-4 na API da Mistral por US$ 0,70 por milhão de tokens de entrada.
Abaixo: o que mudou desde a prévia de 6 de outubro, tamanhos de download, hardware por rota e a licença. Para a visão geral do modelo, leia nosso detalhamento do lançamento do Mistral Large 4; para formatos de requisição e código do SDK, consulte o guia da API do Mistral Large 4.
O que são os pesos abertos do Mistral Large 4?
Os pesos abertos do Mistral Large 4 são os checkpoints baixáveis do modelo principal da Mistral, apelidado de “Le Chonk”. É um modelo multimodal de mistura de especialistas com cerca de 1,05T de parâmetros totais, cerca de 49B ativos por token (52B contando embeddings e camadas de saída), um codificador de visão de 1,6B e uma janela de contexto de 1M de tokens, lançado sob a Mistral Ecosystem Open-Weight License.
O model card oficial lista 72 camadas de texto e 128 especialistas roteados, com 4 escolhidos por token mais 1 especialista compartilhado.
O lançamento não é uma cópia congelada da prévia. O anúncio dos pesos abertos da Mistral diz que o modelo recebeu mais três semanas de aprendizado por reforço focado em programação e cibersegurança antes de os pesos serem publicados.
O que mudou desde a prévia de 6 de outubro
Se você testou o Large 4 durante a prévia, quatro coisas estão diferentes agora.
| Área | Prévia de 6 de outubro | Lançamento aberto de 29 de outubro |
|---|---|---|
| Pesos | Somente API, pesos prometidos para depois | FP8 e NVFP4 no Hugging Face, sem restrições |
| Modos de raciocínio | high ou none |
low, medium, high (padrão high); low substitui none |
| Terminal-Bench 4.0 (relatado pela Mistral) | 28% | 41%, com cerca de 30% menos tokens de saída |
| Resistência a ataques do B3 Agent Security (relatado pela Mistral) | 93,3% | 97,1% |
| Preço da API por 1M de tokens | Mostrado com desconto de prévia | US$ 0,70 de entrada, US$ 0,07 de entrada em cache, US$ 2,10 de saída |
A mudança no raciocínio quebra código. Se sua integração de prévia envia reasoning_effort: "none", troque para "low": o post de lançamento do Hugging Face observa que o Transformers executa none como high, então uma configuração desatualizada consome tokens em vez de falhar.
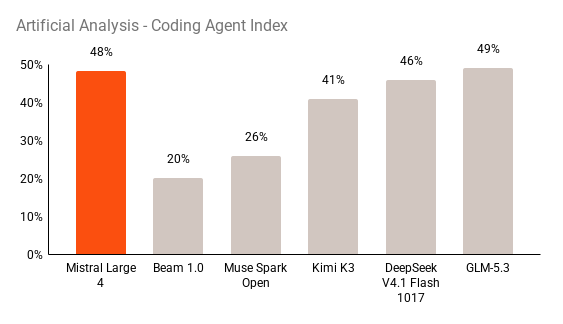
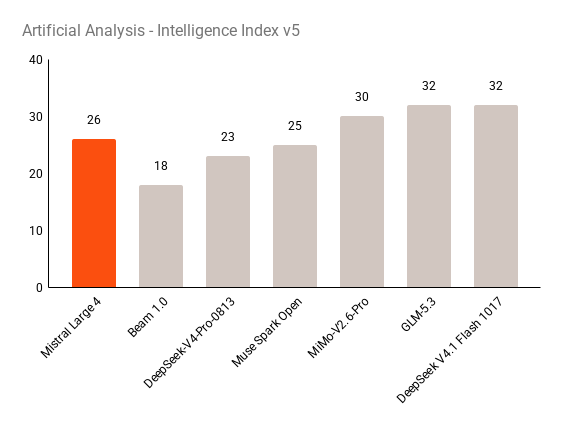
Todos os números de benchmark neste post são relatados pelo fornecedor. A Mistral também afirma 19,7% no benchmark privado FrontierCode 2.0 da Cognition, a maior pontuação entre pesos abertos em seu gráfico, e 48% no Artificial Analysis Coding Agent Index, aproximadamente empatado com o GLM-5.3. A replicação independente ainda estava pendente quando verificamos em 2 de novembro.
Três maneiras de executar o Mistral Large 4
Você tem três rotas, e a certa depende de quanto hardware você controla.
- Chame a API da Mistral. ID do modelo
mistral-large-4, US$ 0,70 de entrada, US$ 0,07 de entrada em cache e US$ 2,10 de saída por milhão de tokens. Sem GPUs. - Use um provedor hospedado. A Mistral lista OpenRouter, endpoints hospedados pela NVIDIA e um contêiner NIM, e o Microsoft Foundry, que também oferece implantações privadas no Azure.
- Auto-hospede os pesos. Baixe do Hugging Face e sirva com vLLM, SGLang, Transformers ou llama.cpp nas suas próprias máquinas.
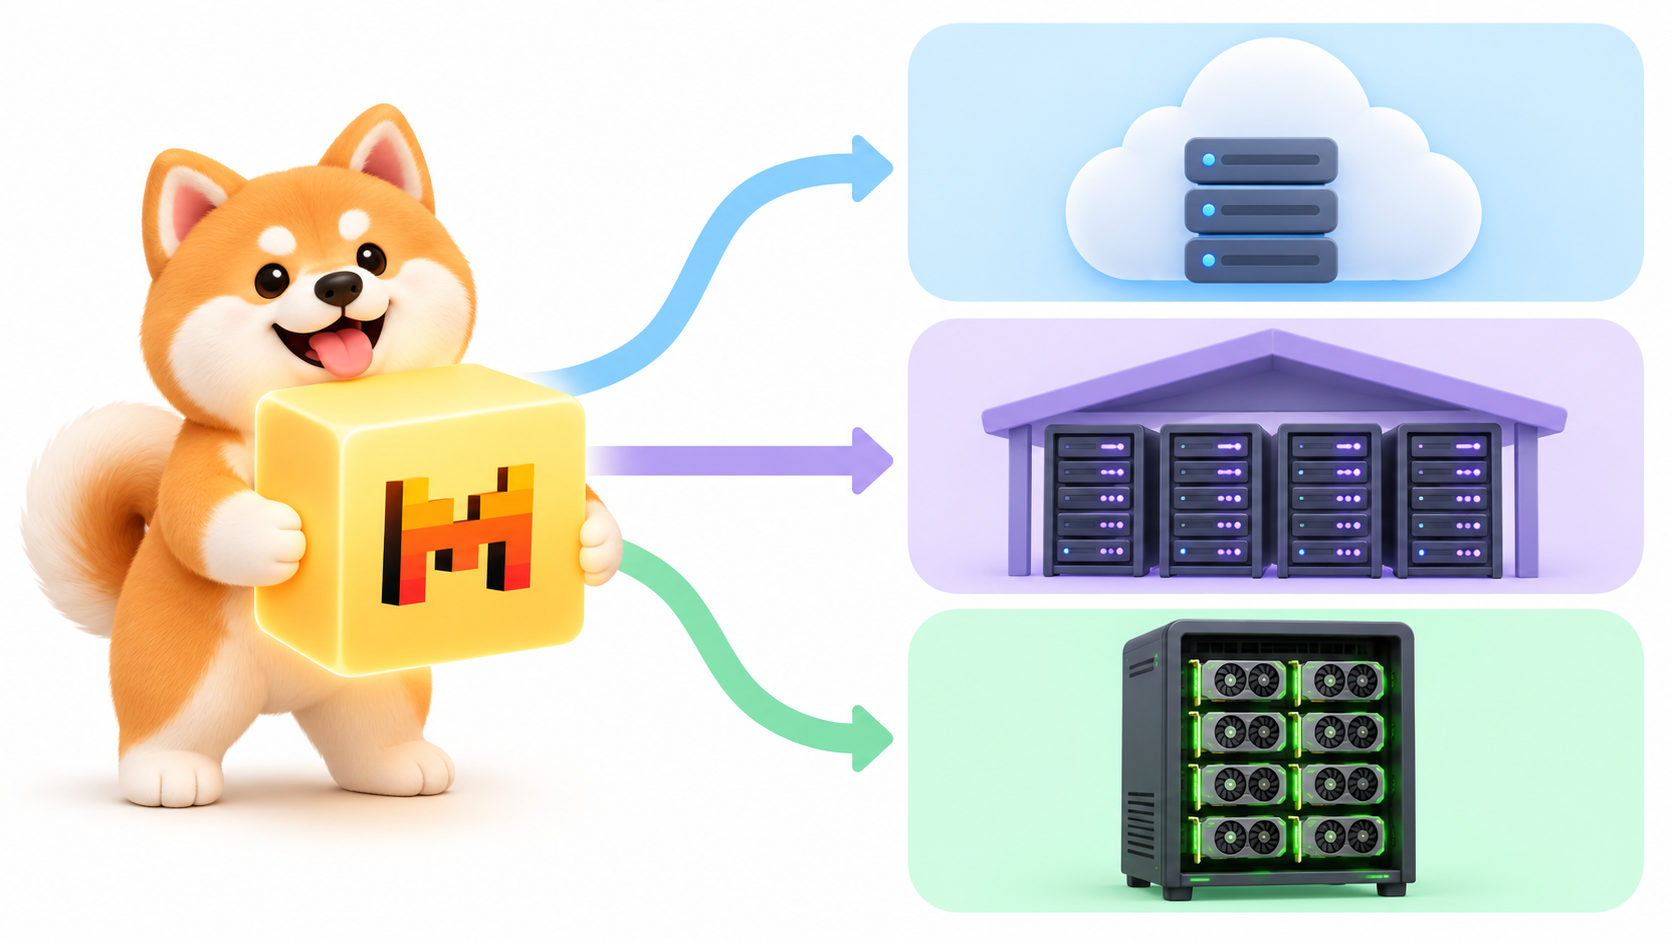
Comece pela rota 1 ou 2. Migre para a rota 3 por um motivo concreto: dados que não podem sair da sua rede, um ajuste fino que você precisa possuir, ou volume que mantém um nó de 8 GPUs ocupado.
Como baixar o Mistral Large 4
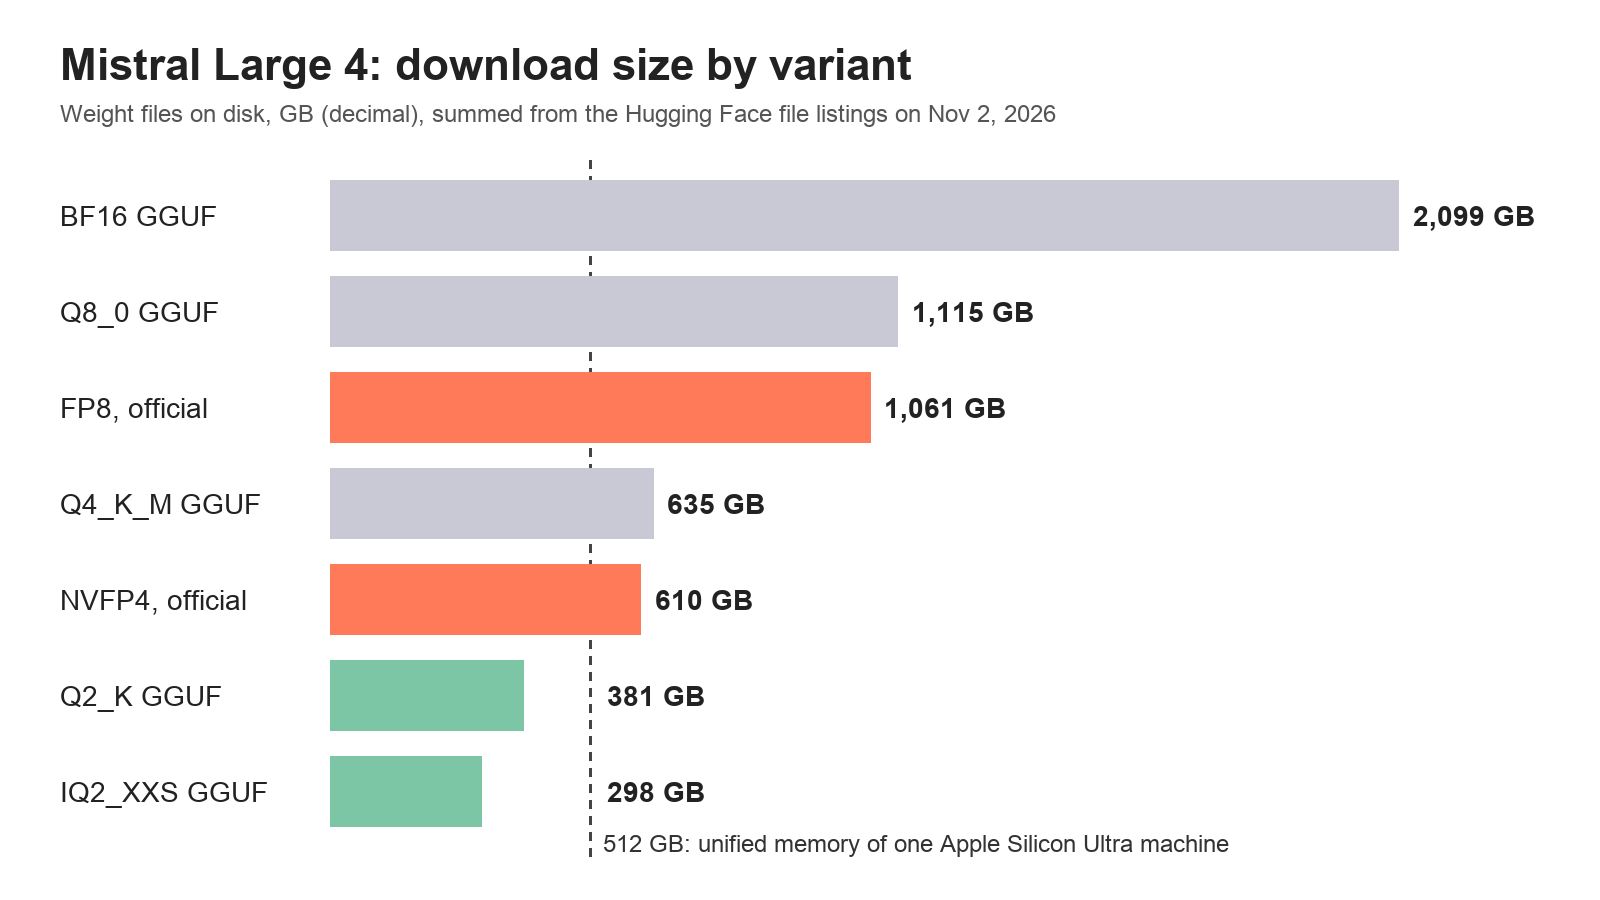
Os repositórios oficiais não têm restrição de acesso (a API do Hugging Face reporta gated: false para ambos), então qualquer conta ou cliente anônimo pode baixá-los. O tamanho é a verdadeira barreira.
| Repositório | Formato | Tamanho em disco |
|---|---|---|
mistralai/Mistral-Large-4-1T-A52B |
FP8, oficial | cerca de 1.061 GB |
mistralai/Mistral-Large-4-1T-A52B-NVFP4 |
NVFP4, oficial | cerca de 610 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q8_0 | cerca de 1.115 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q4_K_M | cerca de 635 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q2_K | cerca de 381 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
IQ2_XXS | cerca de 298 GB |
Somamos esses valores a partir da listagem de arquivos de cada repositório em 2 de novembro de 2026. A Unsloth também publica quants GGUF em unsloth/Mistral-Large-4-1T-A52B-GGUF.
Baixe apenas os arquivos de que precisa com a CLI do Hugging Face:
pip install -U huggingface_hub
hf download mistralai/Mistral-Large-4-1T-A52B-NVFP4 \
  --local-dir ./mistral-large-4-nvfp4
O download do FP8 leva um pouco mais de duas horas a 1 Gbps sustentado.
Como auto-hospedar o Mistral Large 4
Todo exemplo oficial de serving assume um nó com 8 GPUs e paralelismo de tensor de 8. Aqui está o que cada engine espera.
| Engine | Checkpoint | Hardware nos exemplos oficiais |
|---|---|---|
| vLLM | FP8 | 8 GPUs, --tensor-parallel-size 8; os Hugging Face Inference Endpoints usam 8x H200 |
| vLLM | NVFP4 | 8 GPUs NVIDIA Blackwell |
| SGLang | FP8 | 8 GPUs, --tp-size 8 |
| Transformers | FP8 | 8 GPUs via torchrun |
| llama.cpp | Q2_K GGUF | Uma máquina Apple Silicon Ultra com 512 GB de memória unificada |
vLLM
O model card recomenda vLLM e fornece uma imagem Docker dedicada:
docker run --runtime nvidia --gpus all \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -p 8000:8000 \
  --ipc=host \
  vllm/vllm-openai:mistral-large-4 \
  --model mistralai/Mistral-Large-4-1T-A52B \
  --tensor-parallel-size 8 \
  --tool-call-parser mistral \
  --reasoning-parser mistral \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.85
Mantenha ambas as flags de parser, ou o texto de raciocínio cai em content e as chamadas de ferramenta chegam como texto bruto. Para decodificação mais rápida, o card documenta um decodificador especulativo DSpark opcional: adicione --speculative-config '{"method": "dspark", "num_speculative_tokens": 3}'.
Em 8x H200 com esse drafter, o Hugging Face mediu cerca de 65 tokens por segundo para uma requisição e cerca de 480 tokens por segundo no total em 1.000 conversas ShareGPT sob carga.
O SGLang também funciona: o exemplo sglang serve do model card usa --tp-size 8, --speculative-algorithm DSPARK e parsers auto de raciocínio e chamada de ferramenta.
llama.cpp em um Mac
A equipe do llama.cpp entregou suporte no dia 0. O quant Q2_K (381 GB) cabe em uma máquina Apple Silicon Ultra com 512 GB de memória unificada:
curl -LsSf https://llama.app/install.sh | sh
llama serve -hf ggml-org/Mistral-Large-4-1T-A52B-GGUF:Q2_K
O Hugging Face relata cerca de 90 tokens por segundo de prefill e 15 de geração em um M3 Ultra: bom para experimentos privados, lento para um loop de agente. Um quant de 2 bits também perde qualidade, então teste nas suas próprias tarefas primeiro.
A amostragem recomendada pela Mistral é temperature=1.0 e top_p=0.95 em todos os níveis de raciocínio.
Chamando seu modelo auto-hospedado
vLLM e SGLang expõem um servidor compatível com OpenAI, então a requisição parece a mesma de qualquer chat completion:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistralai/Mistral-Large-4-1T-A52B",
    "messages": [{"role": "user", "content": "Summarize RFC 9110 section 9 in 5 bullets."}],
    "reasoning_effort": "medium",
    "temperature": 1.0,
    "top_p": 0.95
  }'
Na API hospedada, envie o mesmo corpo para https://api.mistral.ai/v1/chat/completions com "model": "mistral-large-4" e uma chave Bearer. A documentação do servidor compatível com OpenAI do vLLM lista os campos aceitos.
Deixe o Claude Code testar ambos os endpoints com o Apidog CLI
Um modelo auto-hospedado falha silenciosamente: uma flag de parser ausente vaza raciocínio para content, ou uma chamada de ferramenta volta como texto simples. Deixe seu agente de programação verificar ambas as rotas com o Apidog CLI em vez de colar comandos curl manualmente.
Configure uma vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code when prompted
Depois dê ao Claude Code um prompt:
In Apidog project <id>, create two environments: "ml4-self-hosted" with base URL
http://localhost:8000 and "ml4-mistral-api" with base URL https://api.mistral.ai.
Add a POST /v1/chat/completions endpoint and a test case that sends a tool-calling
request with reasoning_effort "low", then asserts status 200, that choices[0].message
has a tool_calls array, and that message.content holds no thinking text.
Run it against both environments and tell me where they differ.
O agente lê cada schema, valida seu payload e executa o caso:
apidog environment create ml4-self-hosted --project <id> --base-url http://localhost:8000
apidog environment create ml4-mistral-api --project <id> --base-url https://api.mistral.ai
apidog cli-schema get endpoint-create
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <selfHostedEnvId> -r cli,json
apidog run --test-case <caseId> --project <id> -e <apiEnvId> -r cli,json
Adicione --upload-report para ver a execução no app Apidog, ou coloque a mesma linha apidog run ... -r junit no CI para que uma atualização do vLLM não seja entregue com chamadas de ferramenta quebradas. Nosso guia do Apidog CLI no Claude Code cobre a configuração em mais detalhes. O plano Free do Apidog cobre até 4 usuários.
A licença: o que você pode e não pode fazer
A Mistral Ecosystem Open-Weight License é MIT com uma condição adicional.
Você pode: executar, implantar, ajustar finamente e modificar o modelo e seus derivados, para uso comercial e não comercial, desde que mantenha o aviso de copyright e permissão nas cópias.
Você precisa de uma licença comercial separada da Mistral se: executá-lo como um “Model as a Service”, que a licença define como dar a um terceiro acesso ao modelo ou seus derivados para inferência ou pós-treinamento.
Essa condição não se aplica a: uso interno, produtos de usuário final em que o modelo fica dentro de recursos ou harnesses específicos, simplesmente repassar requisições para um modelo hospedado por outra pessoa, e uso por meio dos próprios produtos da Mistral.
Um assistente de programação interno ou um recurso de produto construído sobre o modelo é permitido; revender inferência bruta exige um acordo. Isto é um resumo, não é aconselhamento jurídico.
Para um passo a passo semelhante em outro modelo de pesos abertos, consulte nosso guia de auto-hospedagem do GLM-5.3.
Você deve auto-hospedar ou chamar a API?
Chame a API quando seu volume for modesto, você quiser o contexto de 1M sem ajustar limites de servidor, ou você ainda não opera nós de 8 GPUs. A US$ 0,70 de entrada e US$ 2,10 de saída por milhão de tokens, 100 milhões de tokens de entrada mais 20 milhões de tokens de saída por mês chegam a US$ 112, antes de qualquer desconto de cache.
Auto-hospede quando seus dados não podem sair da sua rede, quando você quer possuir um ajuste fino (o Hugging Face mostra treinamento LoRA com TRL em um nó 8x B300), ou quando um volume constante mantém um nó ocupado. O serviço Forge da Mistral é a opção gerenciada para ajuste nos seus próprios dados.
Perguntas frequentes
Os pesos abertos do Mistral Large 4 são gratuitos para baixar?
Sim. Ambos os repositórios oficiais no Hugging Face não têm restrição de acesso, então você pode baixá-los sem solicitar acesso. Executá-los é o custo: o checkpoint FP8 oficial tem cerca de 1.061 GB e os exemplos de serving usam 8 GPUs de datacenter.
Posso executar o Mistral Large 4 em uma única GPU?
Nenhuma receita oficial cobre uma GPU. Todo exemplo de vLLM, SGLang e Transformers usa 8 GPUs com paralelismo de tensor. A menor configuração documentada é o llama.cpp com o quant Q2_K de 381 GB em uma máquina Apple Silicon Ultra com 512 GB de memória unificada.
O Mistral Large 4 é open source?
É de pesos abertos, não open source no sentido da OSI. Você recebe os pesos sob uma licença MIT modificada que permite uso comercial, mas oferecer o modelo a terceiros como serviço de inferência ou pós-treinamento exige uma licença comercial separada da Mistral.
O modelo de pesos abertos é o mesmo que o modelo da API?
A Mistral diz que o checkpoint lançado recebeu mais três semanas de aprendizado por reforço após a prévia de 6 de outubro, e a API serve o modelo atualizado como mistral-large-4. Os modos de raciocínio também mudaram: use low, medium ou high.
Quanto custa a API do Mistral Large 4?
A Mistral lista US$ 0,70 por milhão de tokens de entrada, US$ 0,07 por milhão de tokens de entrada em cache e US$ 2,10 por milhão de tokens de saída, em 2 de novembro de 2026.